

fileAI
fileAI трансформирует неструктурированные данные в структурированные выходы для LLM и AI-агентов. Решает задачи парсинга, извлечения и валидации данных.
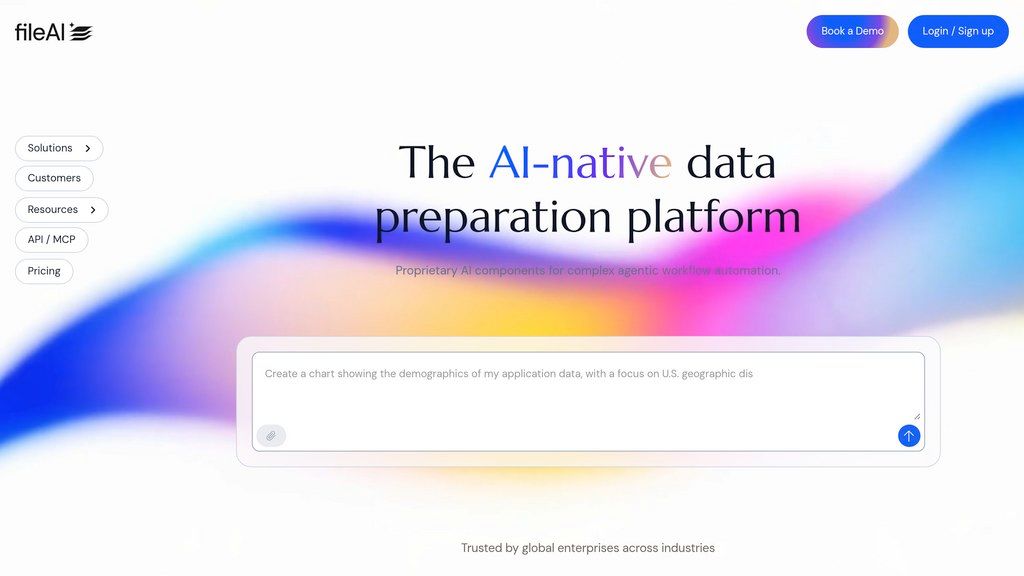
Обзор fileAI
fileAI — это платформа для интеллектуальной обработки данных, разработанная для решения задач работы с неструктурированной информацией в больших объемах. Используя мультимодальный ИИ и продвинутые механизмы рассуждений, сервис автоматически извлекает, классифицирует и проверяет данные из любых типов файлов, форматов и языков. Результатом работы являются структурированные данные, готовые для использования в больших языковых моделях (LLM) и агентных системах, что превращает подготовку данных из рутинной задачи в конкурентное преимущество. Платформа решает критическую проблему обработки огромных массивов неструктурированных данных. Она избавляет от необходимости ручного парсинга и преобразования информации, автоматизируя процесс извлечения ценных сведений из документов любой сложности. Это позволяет организациям ускорить аналитику, повысить точность данных и высвободить ресурсы для более стратегических задач.
Главные функции
Структурированные выходы
Генерирует данные в формате, оптимизированном для LLM и агентов, с помощью настраиваемых схем, устраняя необходимость в сложной постобработке.
Интеллектуальная валидация
Автоматически выявляет несоответствия и аномалии в документах, обеспечивая точность и соответствие стандартам.
Кросс-документный анализ
Сравнивает данные между различными файлами и источниками, обнаруживая вариации и аномалии для комплаенс-процедур.
Запросы на естественном языке
Позволяет задавать вопросы и извлекать инсайты из множества документов, используя обычный язык.
Интеграция и автоматизация
Напрямую передает структурированные данные в AI-агенты и системы с более чем 100 готовыми интеграциями.
Плюсы и минусы
Преимущества
- Обработка любых типов файлов, форматов и языков.
- Высокая степень автоматизации и интеграции с другими системами.
- Обеспечение безопасности и соответствия корпоративным стандартам.
Недостатки
- Зависимость от качества исходных данных и точности промптов.
- Требует настройки для специфических задач и схем данных.
- Стоимость для крупномасштабного корпоративного использования.
Для кого и как использовать?
Финансовый аналитик
Автоматически извлекать и структурировать финансовые данные из счетов, отчетов и договоров для последующего анализа и отчетности.
Юрист
Быстро находить и сравнивать ключевые условия в больших объемах юридических документов, выявляя риски и несоответствия.
Специалист по комплаенсу
Проверять соответствие документов нормативным требованиям, выявлять аномалии и обеспечивать целостность данных в соответствии с политиками компании.
Частые вопросы
Похожие нейросети и аналоги
Смотреть все
ZooData
НовоеZooData — слой данных для AI-агентов в e-commerce. Забудьте про парсинг HTML, получайте чистый JSON для анализа рынков и товаров 24/7.

Webhound
НовоеWebhound — это поисковый движок для ваших ИИ-агентов, который проводит глубокие исследования с заданным бюджетом.

Web Search Agents by Nimble
НовоеАвтономные агенты для глубокого веб-поиска и сбора данных. Учатся на ваших задачах, экономят токены и выдают точные результаты.

Supernova
НовоеSupernova превращает разрозненные данные из Stripe, HubSpot и Postgres в единую базу для Claude и Codex.

SereneDB
НовоеSereneDB — это реактивная база данных для поиска и аналитики, которая объединяет SQL, векторный и полнотекстовый поиск в одном движке.

Proxy Tester by ScrapeOps
НовоеСервис для сравнения прокси-провайдеров в боевых условиях. Узнай, кто реально тянет твой таргет, а кто просто берет деньги.