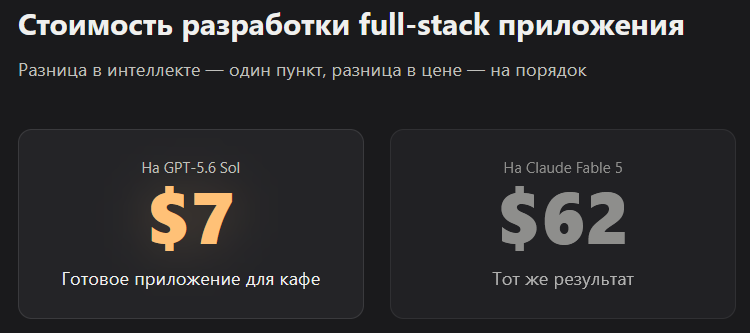
GPT-5.6 Sol вышел 9 июля 2026 года и стал самой дорогой по возможностям, но при этом одной из самых дешёвых по цене моделью на рынке: $5 за 1M входных токенов и $30 за выходные, против $10/$50 у Claude Fable 5. Разница в интеллекте между ними — один пункт по индексу Artificial Analysis, а разница в цене реального проекта — на порядок: разработчик собрал приложение для кафе за $7 на Sol и за $62 на Fable 5. Ниже — 20 промптов, которые реально работают с этой моделью, с указанием, какой reasoning effort ставить и что получите на выходе.
В 2026 году восемь из десяти жалоб на GPT-5.6 Sol сводятся к одному: люди пишут промпты как для GPT-5.5, расписывая каждый шаг. Sol работает по-другому — ему нужен результат и границы, а не инструкция на 20 пунктов. В статье: 20 промптов по категориям, готовых к копированию, с уровнем reasoning effort под каждую задачу.
Что вообще изменилось в промптинге для GPT-5.6 Sol?
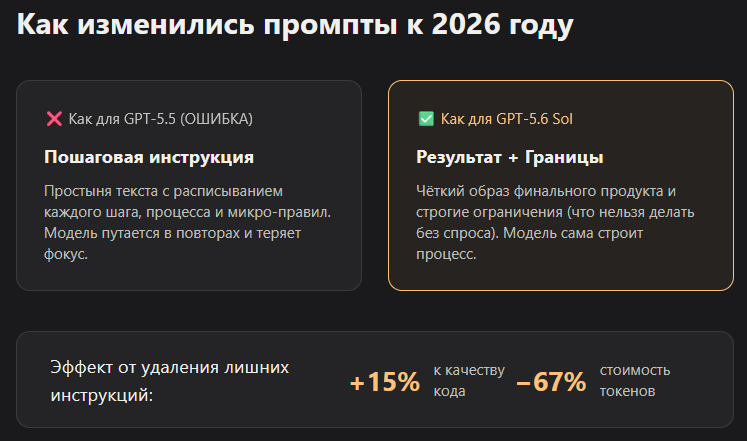
Sol лучше понимает, ЧТО нужно сделать, а не КАК. OpenAI обнаружила, что удаление лишних инструкций из системного промпта поднимает качество на 10-15%, одновременно снижая стоимость на 33-67%.
Модель сама решает, когда делегировать работу суб-агентам, и сама выбирает глубину анализа под задачу. GPT-5.5 просто имел доступ к этой возможности, но использовал её редко. Раньше промпт разрастался до простыни с процессом на каждый шаг. Теперь такая простыня режет качество: Sol спотыкается на повторах и теряет фокус на главном критерии успеха.
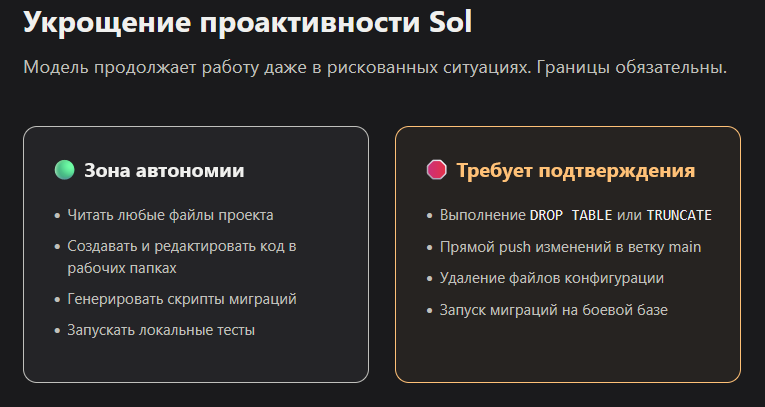
Есть нюанс, о котором молчат многие гайды: Sol продолжает работу даже когда это рискованно. Claude Fable 5 в похожей ситуации остановится и спросит. Поэтому каждый серьёзный промпт для Sol должен явно описывать границы: что можно делать без подтверждения, а что требует паузы.
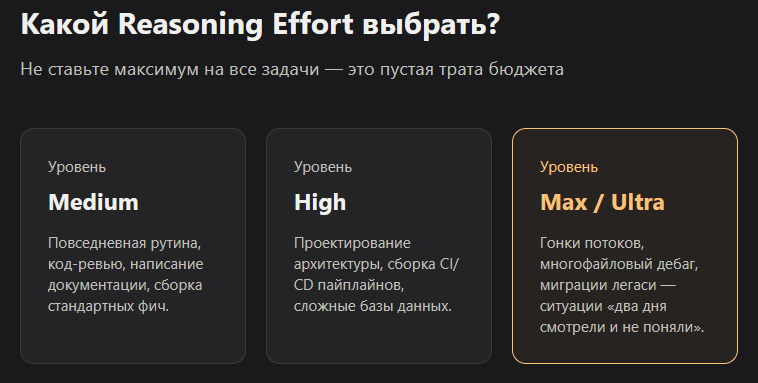
Шесть уровней reasoning effort — none, low, medium, high, xhigh, max — это отдельный рычаг управления. Переименование переменных не требует max, а гонка потоков в многофайловом легаси-проекте требует именно его. Ставить везде максимум — потратить бюджет впустую, ставить везде минимум — получить поверхностный результат.
Full-stack приложение одним промптом: как это работает?
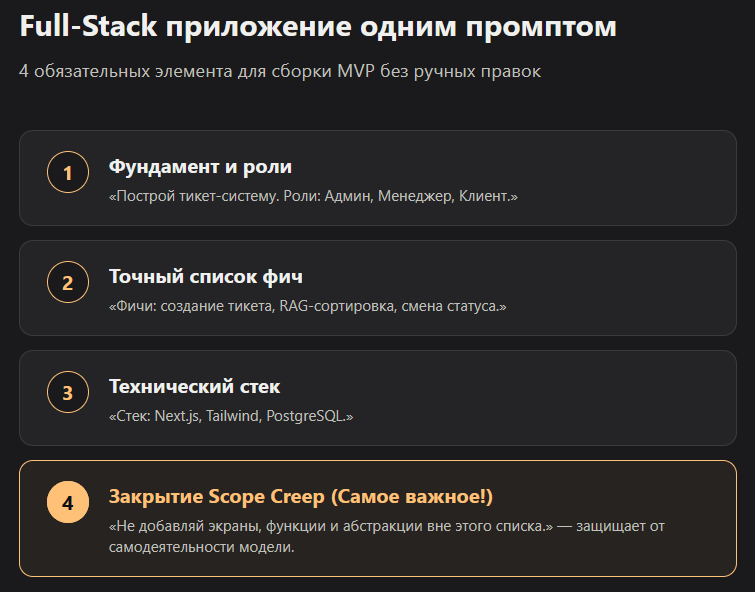
Sol строит фронт, бэк и базу данных из одного точного промпта с ролями и списком фич. Ключевое условие — закрыть скоуп фразой «не добавляй лишнего», иначе модель дофантазирует функции.
Reasoning effort: high. Разработчик, который тестировал это на тикет-системе, получил рабочий MVP с четырьмя ролями и RAG-триажем за один запуск, без правок архитектуры вручную.
Промпт 1. Full-stack приложение
Построй [тип приложения] с именем [Имя].
Роли: [список].
Фичи: [список].
Стек: [фреймворки].
База: [БД].
Не добавляй функции вне списка.
Зачем нужен: закрывает главную дыру Sol — склонность добавлять «полезные» фичи, которых не просили. Явный запрет в последней строке снижает scope creep почти до нуля.
Ожидаемый результат: рабочее приложение с указанными ролями, без лишних экранов и абстракций, которые придётся потом вычищать.
Промпт 2. Автономный агент с границами
Reasoning effort: medium-high, в зависимости от размера репозитория.
РАЗРЕШЕНО: читать файлы, создавать/редактировать в [папка], запускать тесты, создавать ветки.
ТРЕБУЕТ ПОДТВЕРЖДЕНИЯ: push в main, удаление файлов, изменение конфигов.
СТОП: все тесты прошли, PR готов.
Зачем нужен: без явной границы Sol может закоммитить прямо в main или удалить файл, который счёл лишним, — модель проактивна и не переспрашивает лишний раз.
Ожидаемый результат: агент работает автономно внутри песочницы, но останавливается перед необратимыми действиями и присылает готовый PR вместо самовольного мержа.
Промпт 3. CI/CD pipeline
Reasoning effort: high.
Собери CI/CD pipeline для [стек проекта].
Этапы: lint → тесты → сборка → деплой на [окружение].
Откат при падении любого этапа — обязателен.
Формат: [GitHub Actions / GitLab CI].
Не меняй существующие workflow-файлы, создай новый.
Зачем нужен: пайплайны — многошаговая последовательная задача, где Sol должен держать в голове зависимости между этапами. Явный запрет трогать существующие файлы бережёт от случайной поломки продакшена.
Ожидаемый результат: готовый workflow-файл с откатом и понятными логами на каждом этапе.
Промпт 4. Рефакторинг на dependency injection
Reasoning effort: xhigh, если модуль большой и на нём завязано много тестов.
Проведи рефакторинг [компонент/модуль] на dependency injection.
Задача параллелится:
Агент 1: основной модуль
Агент 2: все зависимые тесты
Агент 3: документация
Агент 4: проверка обратной совместимости
Верни единый PR со всеми изменениями.
Зачем нужен: это ровно тот тип задачи, где раскрывается Ultra mode — четыре параллельных агента поднимают Terminal-Bench с 88.8% до 91.9%, потому что подзадачи не зависят друг от друга последовательно.
Ожидаемый результат: один консолидированный PR с разбитой на модули логикой без поломанной обратной совместимости.
Промпт 5. Дебаг с hypothesis-first
Reasoning effort: max. Это как раз тот случай «два дня смотрели и не поняли», под который создан верхний уровень effort.
В коде [файл/модуль] воспроизводится баг: [описание симптома].
Сформулируй 3-4 гипотезы причины до того, как менять код.
Для каждой гипотезы: как проверить, не трогая продакшен-логику.
Проверь гипотезы по очереди, начиная с самой вероятной.
Правь код только после подтверждения гипотезы.
Зачем нужен: без явного требования сначала выдвинуть гипотезы модель обычно бросается чинить симптом наугад, особенно на гонках потоков и утечках памяти.
Ожидаемый результат: список проверенных и отклонённых версий причины плюс точечный фикс, а не веерная правка «на всякий случай».
Аудит кода и безопасность: какой промпт выбрать?
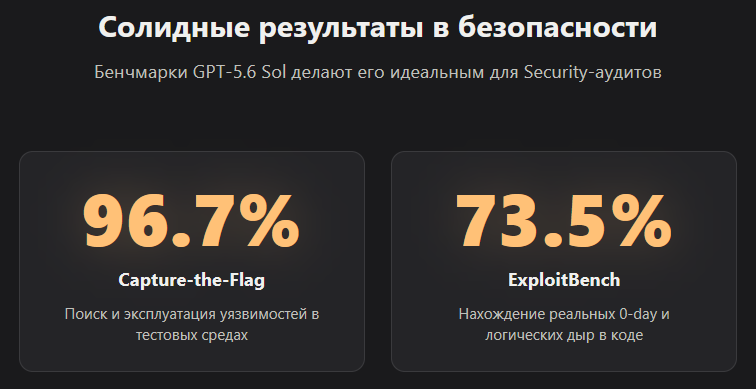
Для аудита Sol особенно силён: ExploitBench 73.5% и Capture-the-Flag 96.7% — одни из лучших результатов среди frontier-моделей на момент июля 2026 года. Но без чёткой структуры отчёта аудит превращается в список абстрактных советов.
Три вещи в промпте для аудита обязательны: критерии оценки, формат вывода на каждое замечание, приоритизация находок.
Промпт 6. Код-ревью PR
Reasoning effort: medium для PR среднего размера, high для 2000+ строк.
PR-ревью: безопасность, производительность, архитектура, тесты, код-стиль.
Для каждого замечания: файл, строка, проблема, предложение.
Зачем нужен: короткая структура вынуждает модель давать конкретику вместо общих слов «код выглядит неплохо».
Ожидаемый результат: список замечаний, который можно сразу превратить в задачи в трекере — без лишнего парафраза.
Промпт 7. Threat modeling
Reasoning effort: high.
Проведи threat modeling для [система/сервис].
Используй STRIDE: Spoofing, Tampering, Repudiation, Information disclosure, DoS, Elevation of privilege.
Для каждой угрозы: вероятность, влияние, готовая мера защиты.
Выведи топ-5 угроз, требующих внимания в первую очередь.
Зачем нужен: без готовой методологии в промпте (STRIDE) модель часто перечисляет общие риски вместо системного разбора конкретной архитектуры.
Ожидаемый результат: приоритизированная таблица угроз, а не эссе про важность безопасности.
Промпт 8. Security audit по OWASP
Reasoning effort: high, при работе с 1M-контекстом на весь репозиторий — xhigh.
Проведи security-аудит [репозиторий/эндпоинт] по OWASP Top 10 2025.
Для каждой найденной уязвимости: категория OWASP, критичность (Critical/High/Medium/Low), пример эксплуатации, фикс.
Не сообщай о теоретических рисках без конкретного места в коде.
Зачем нужен: последняя строка отсекает главную боль AI-аудитов — общие предупреждения без привязки к строке кода.
Ожидаемый результат: отчёт, который выглядит как отчёт от живого security-инженера, а не сгенерированный чеклист.
Промпт 9. SEO-аудит сайта
Reasoning effort: medium, использует computer use для реального захода на сайт.
Открой [URL] и проведи технический SEO-аудит.
Проверь: скорость загрузки, мета-теги, структуру заголовков, наличие sitemap.xml и robots.txt, битые ссылки.
Формат вывода: проблема → её вес по важности → как исправить.
Зачем нужен: Sol может реально открыть сайт через computer use и проверить, что видит браузер, а не гадать по описанию.
Ожидаемый результат: приоритизированный список технических проблем с конкретными шагами фикса, применимый сразу.
Данные и бэкенд: как оптимизировать без риска для продакшена?
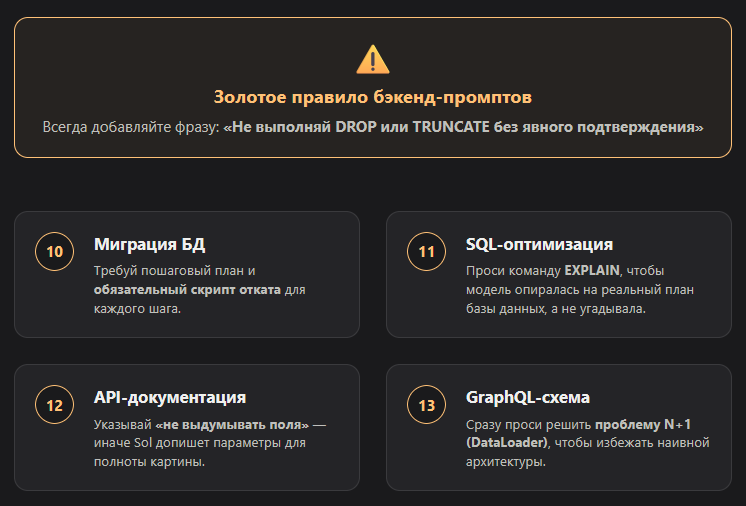
Для задач с базами данных и API главный риск не в качестве кода, а в необратимости. Миграции и оптимизация SQL требуют явного запрета необратимых операций без подтверждения — иначе Sol может выполнить DROP TABLE, посчитав это частью «уборки».
Промпт 10. Миграция базы данных
Reasoning effort: high.
Спроектируй миграцию базы данных с [текущая схема] на [целевая схема].
Дай пошаговый план: какие таблицы создаются, изменяются, удаляются.
Приложи скрипт отката для каждого шага.
Не выполняй DROP или TRUNCATE без явного подтверждения.
Зачем нужен: явный запрет на разрушительные операции — обязательная строка для любой задачи с БД, независимо от модели.
Ожидаемый результат: пошаговый план с готовым откатом на каждом этапе, который можно провести на проде без нервов.
Промпт 11. Оптимизация SQL-запросов
Reasoning effort: medium.
Проанализируй запрос: [SQL].
Покажи план выполнения (EXPLAIN).
Предложи 2-3 варианта оптимизации с ожидаемым приростом скорости.
Укажи, какие индексы нужно добавить и почему.
Зачем нужен: конкретная просьба показать EXPLAIN заставляет модель опираться на реальный план, а не на общие рекомендации «добавьте индекс».
Ожидаемый результат: сравнение вариантов с обоснованием, а не единственный совет без альтернатив.
Промпт 12. API-документация
Reasoning effort: low-medium — механическая, но объёмная задача.
Сгенерируй документацию для API [эндпоинты/файл роутов] в формате OpenAPI 3.1.
Для каждого эндпоинта: метод, параметры, коды ответов, пример запроса и ответа.
Синхронизируй с реальной сигнатурой функций, не выдумывай поля.
Зачем нужен: без последней строки модель нередко дописывает параметры «для полноты картины», которых нет в коде.
Ожидаемый результат: готовый OpenAPI-файл, который можно сразу подключить к Swagger UI.
Промпт 13. GraphQL-схема
Reasoning effort: medium.
Спроектируй GraphQL-схему для [домен: например, каталог курсов].
Учти: типы, связи между ними, мутации для CRUD-операций, пагинацию.
Избегай N+1 проблем — предложи, где нужен DataLoader.
Зачем нужен: явное упоминание N+1 экономит цикл правок — без этого Sol нередко выдаёт наивную схему без батчинга.
Ожидаемый результат: схема с продуманными связями и готовыми точками для оптимизации запросов.
Дизайн, инфраструктура и инструменты: что выбрать под задачу?
Sol заметно прокачался в дизайне по сравнению с GPT-5.5: следует брендгайдам, может сам инспектировать свой рендер через computer use и чинить визуальные баги. Для лендингов лучше ставить максимальный reasoning effort — сложные 3D-анимации требуют глубины.
Промпт 14. Лендинг с 3D-анимациями
Reasoning effort: xhigh.
Создай одностраничный сайт для [продукт].
Концепция: [атмосфера].
Технически: 3D-скролл-анимации, hero с [эффект], адаптивность, самостоятельный HTML/CSS/JS.
Опубликуй через Sites.
Зачем нужен: конкретная концепция атмосферы («тёмный luxury», «минимализм для B2B») задаёт направление, без которого дизайн сваливается в шаблонный вид.
Ожидаемый результат: готовый к публикации сайт с фирменной анимацией, а не типовой лендинг-конструктор.
Промпт 15. Computer use — проверка сайта в браузере
Reasoning effort: medium.
Открой браузер. Зайди на [URL].
Проверь: работает ли регистрация, верстка на mobile 375px, все ссылки в футере.
Найди баги → опиши → предложи фикс.
Зачем нужен: Sol лидирует в OSWorld 2.0 (62.6% против 54.8% у ближайших конкурентов) — это единственный тип промпта, который реально нельзя выполнить без живого захода на страницу.
Ожидаемый результат: список конкретных багов с шагами воспроизведения, а не предположения по скриншоту.
Промпт 16. Dockerfile
Reasoning effort: low-medium.
Напиши Dockerfile для [стек: например, Next.js standalone].
Используй multi-stage build, минимизируй размер финального образа.
Не запускай контейнер от root.
Добавь healthcheck.
Зачем нужен: без явного упоминания multi-stage и non-root модель нередко выдаёт «рабочий, но небезопасный» Dockerfile из учебника пятилетней давности.
Ожидаемый результат: продакшен-готовый Dockerfile с меньшим весом образа и базовой защитой от запуска от root.
Промпт 17. Создание SDK
Reasoning effort: high.
Создай SDK на [язык] для API [описание/OpenAPI-спека].
Структура: клиент с авторизацией, типизированные модели данных, обработка ошибок с retry-логикой.
Добавь README с примером использования за 5 строк кода.
Зачем нужен: требование «5 строк кода» в примере — простой, но действенный способ заставить модель думать о developer experience, а не только о покрытии эндпоинтов.
Ожидаемый результат: SDK, который реально можно подключить за один вечер, а не голый набор функций без документации.
Исследования и контроль качества: как получить проверяемый результат?
Для исследований и тестов ключевая проблема Sol — не качество, а самодостаточность вывода. Без структуры отчёт превращается в стену текста без источников, которую невозможно процитировать или проверить.
Промпт 18. Глубокое исследование темы
Reasoning effort: xhigh-max, особенно при подключении веб-поиска и документов.
Исследуй [тема].
Используй поиск + документы.
Структура: Executive Summary / Тренды и цифры / Ключевые игроки / Инсайты / Источники.
Зачем нужен: раздел «Источники» отдельной строкой — без него Sol иногда приводит цифры без ссылки на то, откуда они взялись.
Ожидаемый результат: отчёт, каждый блок которого можно проверить и процитировать отдельно, без привязки к остальному тексту.
Промпт 19. Генерация тест-кейсов
Reasoning effort: medium.
Сгенерируй тест-кейсы для [функция/модуль].
Покрой: happy path, граничные значения, некорректный ввод, конкурентный доступ.
Формат: Given/When/Then.
Не дублируй кейсы, которые уже покрыты в [существующий тестовый файл].
Зачем нужен: указание на существующий тестовый файл экономит время ревью — без него модель нередко пишет тесты, дублирующие уже написанные.
Ожидаемый результат: набор тестов, закрывающий реальные пробелы в покрытии, а не переписанные старые проверки.
Промпт 20. Performance profiling
Reasoning effort: high.
Проанализируй производительность [приложение/эндпоинт] по логам и метрикам: [вставить данные].
Найди топ-3 узких места.
Для каждого: причина, ожидаемый прирост после фикса, сложность внедрения (низкая/средняя/высокая).
Зачем нужен: приоритизация по сложности внедрения помогает не тратить спринт на фикс с приростом в 2%, когда рядом есть фикс с приростом в 40% за час работы.
Ожидаемый результат: приоритизированный список узких мест, готовый для планирования спринта.
Sol или Fable 5: какую модель выбрать под конкретную задачу?
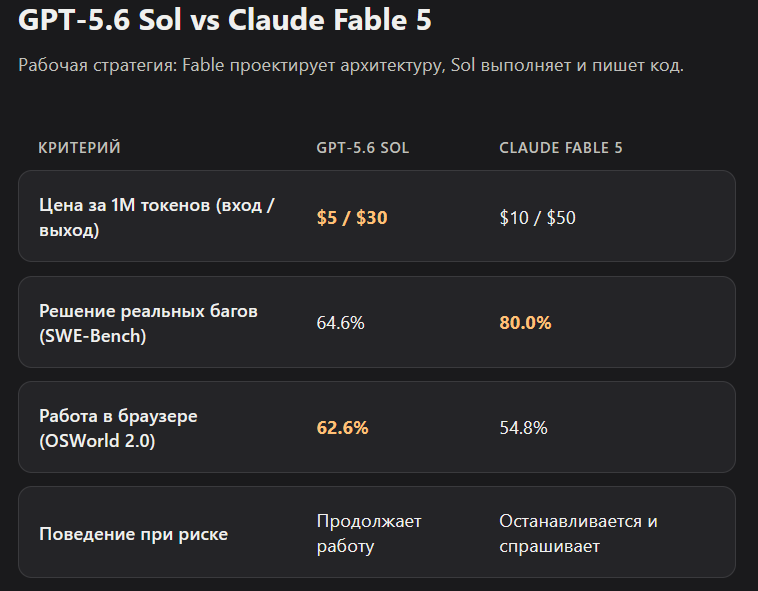
Sol выигрывает в цене, терминальных операциях и браузинге. Fable 5 выигрывает в реальных GitHub-багах: SWE-Bench Pro у него 80% против 64.6% у Sol — разрыв в 15.4 пункта, самый большой во всех сравнениях моделей.
| Критерий | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|
| Цена (вход/выход за 1M) | $5 / $30 | $10 / $50 |
| Контекст | 1.05M | 1M |
| Terminal-Bench 2.1 | 88.8% | 83.1% |
| SWE-Bench Pro | 64.6% | 80% |
| Browsing (BrowseComp) | 90.4% | 84.3% |
| Реальный кейс (кафе-приложение) | $7 | $62 |
| Поведение при риске | продолжает работу | останавливается и спрашивает |
Рабочая стратегия многих команд в 2026 году — использовать обе модели по ролям: Fable 5 проектирует архитектуру и принимает решения, Sol выполняет, кодит и проверяет. Sol достаточно дёшев, чтобы запускать его вторым проверяющим слоем поверх вывода Fable 5.
Максим: «Веб-версию GoBanana собрали за 3 часа после выхода новой модели. Суммарно на продукт, который принёс 12 миллионов рублей, ушло 6-8 часов. Прикол в том, что чем точнее промпт с границами, тем меньше приходится потом переделывать руками.»
Частые вопросы про промпты для GPT-5.6 Sol
Чем промпты для Sol отличаются от промптов для GPT-5.5?
Sol требует меньше пошаговых инструкций и больше конкретики про итоговый результат и границы допустимых действий. Лишние повторяющиеся правила в системном промпте снижают качество, а не повышают его.
Какой reasoning effort ставить по умолчанию?
Medium — для большинства повседневных задач: код-ревью, документация, стандартные фичи. High и выше — только для многофайловой отладки, миграций и сложной архитектуры.
Нужно ли всегда указывать границы для агентских промптов?
Да. Sol в отличие от Fable 5 склонен продолжать работу даже в рискованных ситуациях, поэтому явный список разрешённых и требующих подтверждения действий обязателен.
Ultra mode подходит для любой задачи?
Нет. Он хорош для параллелящихся задач: массовых рефакторов, миграций с одинаковыми паттернами, отладки с несколькими гипотезами. Для задач с жёсткой последовательной зависимостью шагов прирост будет минимальным при тройном расходе токенов.
Что дешевле для рутинных задач — Sol или Terra?
Terra в два раза дешевле Sol ($2.50/$15 против $5/$30) и почти не уступает ему на большинстве повседневных задач. Sol стоит подключать для терминальных операций, кибербезопасности и сложной агентской работы.
Можно ли использовать Sol и Claude Fable 5 в одном проекте?
Да, и многие команды так и делают: Fable 5 для архитектурных решений и сложных GitHub-багов, Sol — для выполнения, кодинга и проверки результата за счёт более низкой цены.
Стоит ли переписывать старые промпты под Sol?
Стоит, если промпт написан как подробная инструкция «шаг за шагом». Уберите повторы и процессные детали, оставьте критерии успеха и границы — по данным OpenAI, это поднимает качество на 10-15% при снижении токенов на 41-66%.
Полный каталог AI-инструментов и разборов IDE — на vibecoderz.ru/ide. Если нужна помощь с промптами или архитектурой конкретного проекта, запишитесь на консультацию к Максиму.
Обновлено: октябрь 2026