AI агент для парсинга сайтов через Playwright MCP умеет сам открывать страницы, читать актуальные цены и структуру сайта, а затем решать, что делать с этими данными, без ручного копирования ссылок в чат. Ниже разберём, какие лимиты ставит сама технология, где проходит граница между легальным мониторингом конкурентов и нарушением закона, и как настроить агента так, чтобы его не забанили на третий день.
AI агент для парсинга сайтов на Playwright MCP заменяет ручной сбор данных: агент сам заходит на страницы, извлекает цены и характеристики, сравнивает со снапшотом. Playwright MCP бесплатен, но лимиты по скорости и юридические риски по ФЗ-152 остаются на стороне разработчика.
Что вообще такое ai агент для парсинга сайтов
AI агент для парсинга сайтов - это связка модели вроде Claude с браузерным инструментом, где модель сама решает какие страницы открыть и что извлечь, а не выполняет заранее написанный скрипт.
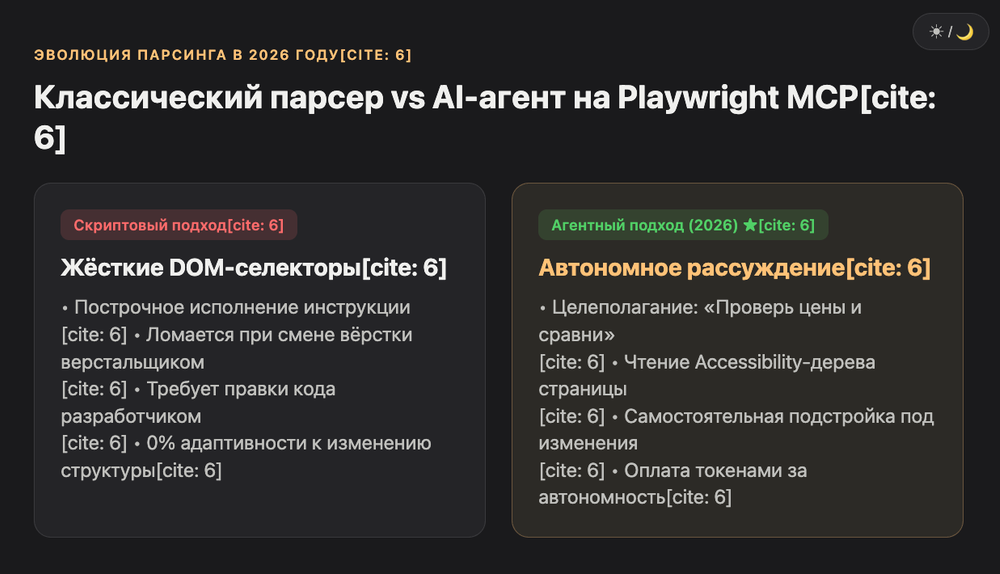
Классический парсер - это код, который построчно описывает: зайди по этому адресу, найди элемент с таким селектором, забери текст. AI агент работает иначе: ему дают цель вроде "проверь цены на этих трёх страницах и сравни с прошлой неделей", а дальше он сам решает, куда кликнуть и что записать. Это принципиальное отличие меняет и риски, и лимиты.
Такой агент собирают из трёх частей. Модель (Claude, GPT или Gemini) отвечает за рассуждение. Браузерный слой - обычно Playwright - реально открывает страницы и кликает. А протокол MCP (Model Context Protocol) связывает их между собой, передавая модели структуру страницы и получая обратно команды. На YouTube-канале Code With Mo в июле 2026 показывали ровно такую сборку: агент сам создаёт файл целей, забирает данные о товарах Amazon и пишет отчёт об изменениях цены. Без единой строчки ручного кода на стороне пользователя, только промпты в Claude Code.
Разница между "парсингом" и "агентным парсингом" не только техническая. Обычный скрипт не меняет поведение при изменении вёрстки сайта, его нужно чинить руками. Агент читает структуру страницы заново при каждом запуске и подстраивается сам, но за это платит токенами и непредсказуемостью действий. Как раз вторая часть и создаёт большинство юридических вопросов, потому что агент может кликнуть там, где не планировали.
Как работает Playwright MCP в связке с Claude Code
Playwright MCP - это сервер от Microsoft, который открывает браузер и отдаёт модели снимок страницы вместо скриншота. Модель читает структуру, а не картинку, поэтому точнее находит нужные элементы и стоит дешевле по токенам, чем чистое computer use.
Playwright MCP (пакет @playwright/mcp, версия 0.0.76 на июнь 2026) распространяется бесплатно по лицензии Apache-2.0 и поддерживается Microsoft. Никакой платной подписки и лимита запросов на уровне самого сервера нет: он просто запускает Chromium локально через npx и требует Node.js 18+.
На практике это выглядит так. В Claude Code или Cursor подключается MCP-сервер, агент получает набор инструментов: открыть страницу, кликнуть, заполнить поле, извлечь текст по схеме. Вместо скриншота, как в Anthropic Computer Use, агент видит accessibility-дерево страницы - список элементов с ролями и текстом. По бенчмарку Playwright команды типовая задача через MCP тратит около 114 000 токенов, а через CLI-вариант с сохранением снапшотов на диск - около 27 000. Разница почти в четыре раза, и именно снапшоты старых страниц, которые агент таскает в контексте, съедают токены.
Лиза: «Раньше я вручную разбирала 15-20 видео на одну статью, часа четыре уходило. Написала скрипт, который сам забирает ссылки, транскрибирует и раскладывает по 15 критериям. Сейчас это 5,5 минуты. Вот такие пироги.»
Похожая логика работает и в парсинге: агент, которому один раз объяснили правило анализа, дальше применяет его к десяткам страниц без участия человека. Разница только в том, что вместо транскриптов YouTube на входе - HTML живого сайта, а значит появляется вторая сторона, у которой есть свои правила игры.
Какие лимиты ставит сама технология
Сам Playwright MCP не ограничивает число запросов, но лимиты всё равно есть: со стороны LLM-провайдера по токенам, со стороны целевого сайта по rate limiting и IP, и со стороны контекстного окна модели при долгих сессиях.
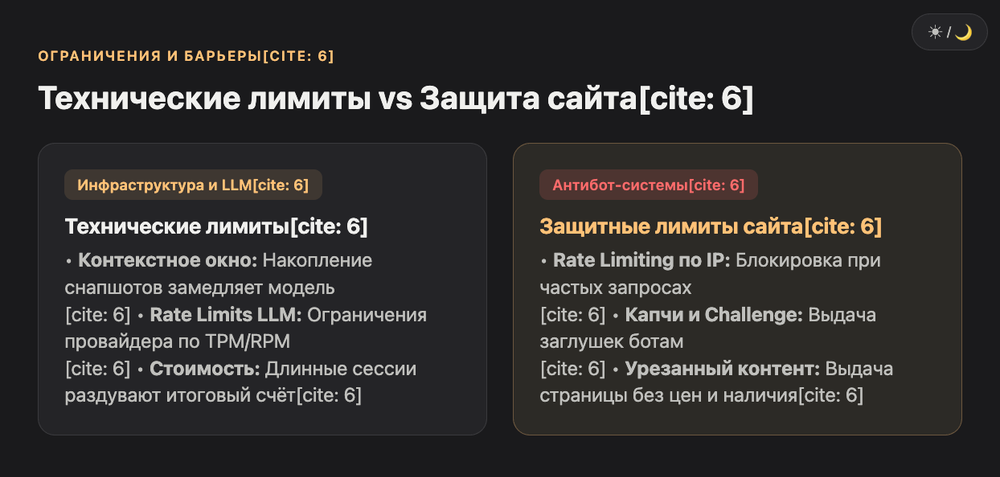
Важно разделять два типа лимитов. Первый - технический, его ставит инфраструктура. Второй - защитный, его ставит сайт, который не хочет, чтобы его грузили ботом. Путать их не стоит, потому что решения разные.
С технической стороны у самого сервера Playwright MCP нет ни платного плана, ни счётчика запросов. Но в issue-трекере проекта на GitHub разработчики отдельно фиксировали проблему: у долгих агентных сессий накапливаются снапшоты старых страниц в истории диалога, и модель начинает "тормозить" и дороже отвечать просто из-за раздутого контекста. Обсуждение в репозитории microsoft/playwright-mcp в марте 2026 прямо указывало на отсутствие встроенных ограничений на количество браузерных действий - разработчики сами предлагали добавить гайд по rate limiting для агентных сценариев.
Со стороны сайта работает совсем другая логика: rate limiting по IP, капча после N запросов в минуту, блокировка User-Agent без "человеческих" заголовков. В видео про сборку скрапера через Decodo MCP показан наглядный пример - обычный Python-запрос к странице Amazon получил только заголовок товара, без цены и наличия, потому что сайт распознал бот и отдал урезанную версию страницы. Решить это в лоб добавлением residential-прокси можно, но тут вступает в игру третий тип лимита - юридический, о котором ниже.
Какие инструменты для парсинга через агента реально работают в 2026 году
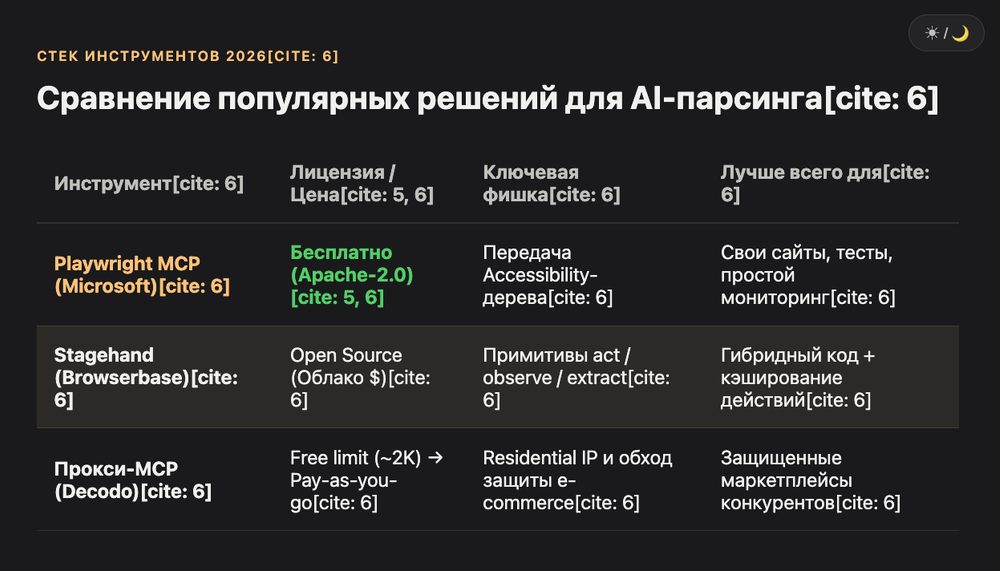
Playwright MCP от Microsoft бесплатен и подходит для собственных сайтов и тестов. Для парсинга чужих защищённых сайтов вайбкодеры чаще берут связку с прокси-сервисом вроде Decodo или библиотеку Stagehand поверх Playwright, где агент и детерминированный код работают вместе.
Три подхода закрывают разные задачи, и путать их - частая ошибка новичков.
| Инструмент | Что делает | Цена | Когда брать |
|---|---|---|---|
| Playwright MCP (Microsoft) | Открывает браузер, отдаёт модели снимок страницы | Бесплатно, Apache-2.0 | Свои сайты, тестирование, простой мониторинг без защиты от ботов |
| Stagehand (Browserbase) | Смешивает детерминированный Playwright-код с act/extract/observe на естественном языке | Open source, облачный запуск браузера платный | Когда нужна повторяемость и кэш действий агента |
| Прокси-MCP (например Decodo) | Даёт residential-IP и готовые инструменты под e-commerce, соцсети, поиск | Бесплатный лимит около 2000 запросов, дальше pay-as-you-go | Мониторинг маркетплейсов и защищённых сайтов конкурентов |
Stagehand стоит отдельного слова: репозиторий собрал больше 22 000 звёзд на GitHub и построен поверх Playwright, но добавляет четыре примитива - act, observe, extract и agent. Идея простая: там, где страница предсказуема, пишется обычный код, а там, где вёрстка "плывёт", модель сама решает, куда кликнуть. Разработчики инструмента прямо советуют не начинать сразу с полностью автономного agent-режима, а сперва проверять связку на observe и extract, и только потом добавлять действия.
Что нарушает ToS сайта а что можно собирать легально
Открытые цены, каталоги и описания товаров собирать можно. Нарушением считается обход технической защиты, игнорирование robots.txt, перегрузка сервера частыми запросами и сбор персональных данных без согласия.
Российская судебная практика по парсингу за последний год стала заметно конкретнее. Основной критерий, который используют суды - не сам факт автоматического сбора, а последствия: был ли обход защиты, пострадал ли сайт от нагрузки, затронуты ли персональные данные людей.
Показательный прецедент - дело о парсинге резюме с рекрутингового портала, где суд признал действия компании неправомерными сразу по трём причинам: игнорирование ограничений в robots.txt, сбор персональных данных без согласия и использование этих данных для рекламных рассылок. В другом деле, которое разбирал Хабр, компания собирала цены конкурентов с высокой частотой запросов, что замедляло работу сайта - и это само по себе стало основанием для претензии, без всякого вопроса про персональные данные.
Отдельно стоит вопрос соцсетей. Позиция Роскомнадзора и российских судов здесь строже, чем может показаться: публичный профиль пользователя в соцсети не приравнивается к общедоступному источнику персональных данных, и парсить такие профили без согласия нельзя, даже если страница технически открыта любому посетителю.
Показательный кейс из США - дело hiQ Labs против LinkedIn, растянувшееся на шесть лет. Девятый апелляционный суд в 2019 году встал на сторону hiQ и разрешил парсинг публичных данных, но в 2022 году стороны заключили мировое соглашение на 500 000 долларов не по CFAA, а именно по нарушению пользовательского соглашения - hiQ создавала фейковые аккаунты для доступа к закрытым данным. Вывод из этой истории простой: даже там, где сам факт скрапинга формально законен, договор с сайтом (ToS) остаётся отдельным риском.
Что можно собирать без проблем:
- цены, наличие товара, характеристики из открытого каталога
- публичные новости и статьи без копирования на конкурирующую площадку
- открытые прайс-листы и условия обслуживания
Что создаёт риск:
- персональные данные людей, даже формально открытые в соцсетях
- обход капчи, антибот-защиты и авторизации
- частота запросов, которая заметно грузит сервер
- использование данных конкурента для прямого копирования на своём сайте
Как настроить агента чтобы не получить бан или иск
Настройка сводится к четырём шагам: проверить robots.txt и пользовательское соглашение, ограничить частоту запросов, честно назвать себя в User-Agent и исключить сбор персональных данных из целей парсинга.
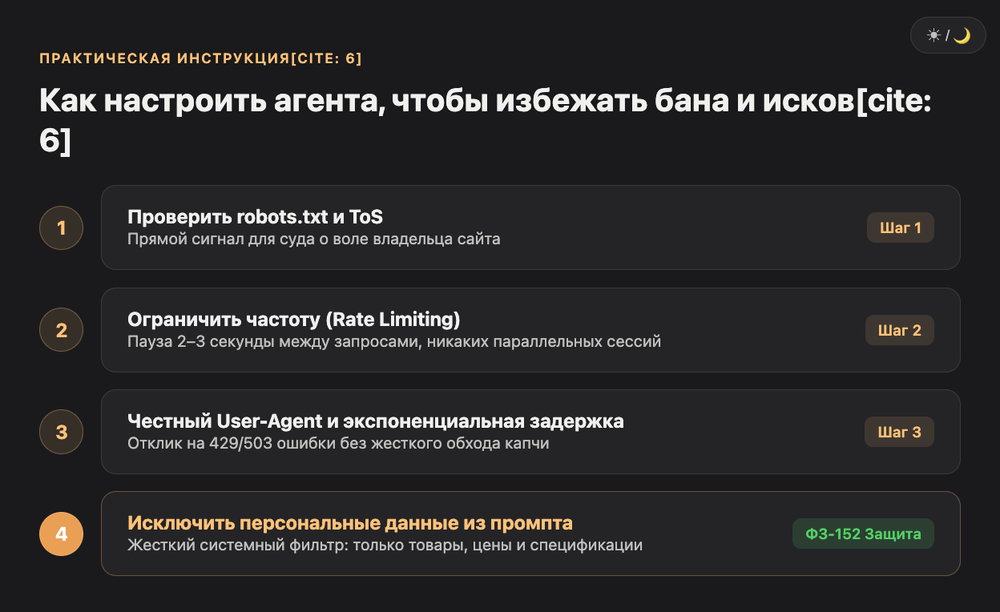
Шаг 1. Проверить robots.txt и ToS
Перед первым запуском агента откройте /robots.txt целевого сайта и его пользовательское соглашение. Если раздел явно закрыт для ботов - это не просто рекомендация, а прямой сигнал суду в случае спора, что владелец сайта выразил свою волю.
Шаг 2. Ограничить частоту запросов
Задайте агенту паузу между обращениями к одному домену не короче 2-3 секунд и запретите параллельные сессии на один хост. Это и снижает шанс блокировки, и убирает главный аргумент против вас в возможном споре - перегрузку сервера.
Шаг 3. Настроить User-Agent и повторные попытки
Указывайте честный User-Agent вместо маскировки под браузер, и добавьте экспоненциальную задержку при ответах 429 и 503. Автоматический обход капчи технически возможен на некоторых связках, но именно это действие суды чаще всего трактуют как обход защиты - то есть прямое нарушение ToS.
Шаг 4. Исключить персональные данные из целей
Даже если агент случайно наткнётся на страницу с email или телефоном пользователя, у него не должно быть инструкции это сохранять. Правило проще всего зашить в системный промпт агента: собирать только данные о товарах, ценах и характеристиках, игнорировать любые персональные данные людей.
Сколько стоит парсинг конкурентов через ai агента
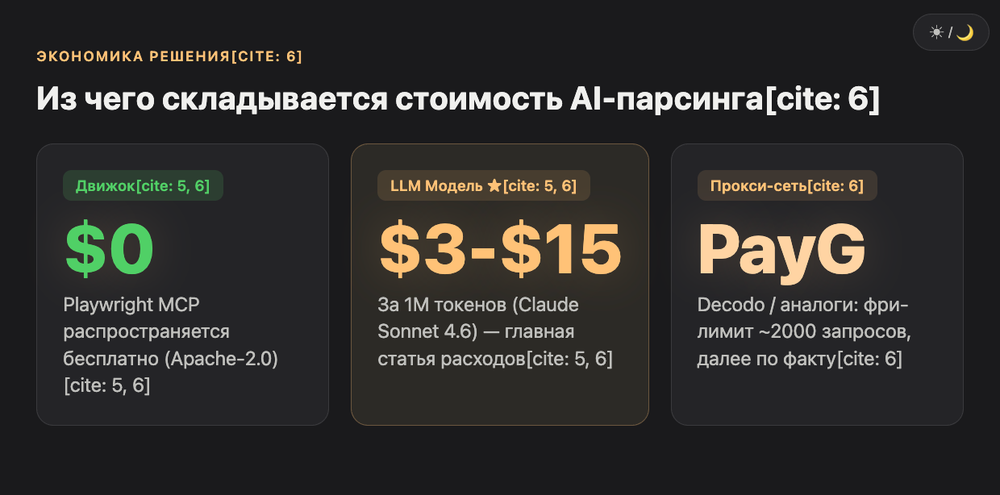
Сам Playwright MCP бесплатен, платить приходится за токены модели и опционально за прокси-сервис. Бесплатных лимитов обычно хватает на пилотный проект из нескольких страниц, для мониторинга маркетплейсов в промышленных масштабах нужен платный тариф.
| Статья расходов | Примерная цена | Комментарий |
|---|---|---|
| Playwright MCP | $0 | Open source, нет платного плана и метеринга |
| Модель (Claude Sonnet 4.6) | $3 / $15 за 1M токенов | Основная статья расходов при частых запусках |
| Прокси-сервис (Decodo и аналоги) | Free до ~2000 запросов, дальше pay-as-you-go | Нужен для защищённых сайтов и маркетплейсов |
| Browserbase (облачный Playwright) | Платный тариф за облачные сессии | Актуален при масштабировании и параллельных запусках |
По факту самая частая расходная статья - не инфраструктура, а сама модель, особенно на длинных сессиях. Мониторинг накопительно тянет старые снапшоты в контекст, и если сессия слишком длинная, счёт за токены растёт быстрее, чем за прокси.
Кому реально подходит парсинг сайтов через ai агента
Три сценария закрывают почти всю практическую пользу этой технологии.
Мониторинг цен конкурентов. Агент раз в день или час проверяет заданные страницы и сравнивает со снапшотом, присылая отчёт только при реальном изменении. Подходит для e-commerce и SaaS с публичными тарифами.
Сбор данных для контентной SEO-машины. Открытые каталоги, обзоры, спецификации - хороший источник для программатик-контента, если не копировать формулировки один в один и не выдавать чужой текст за свой.
Проверка собственного сайта. Тот же агент отлично находит битые ссылки, устаревшие цены и несоответствия на своих страницах - здесь вообще нет юридического риска, потому что это ваш сайт.
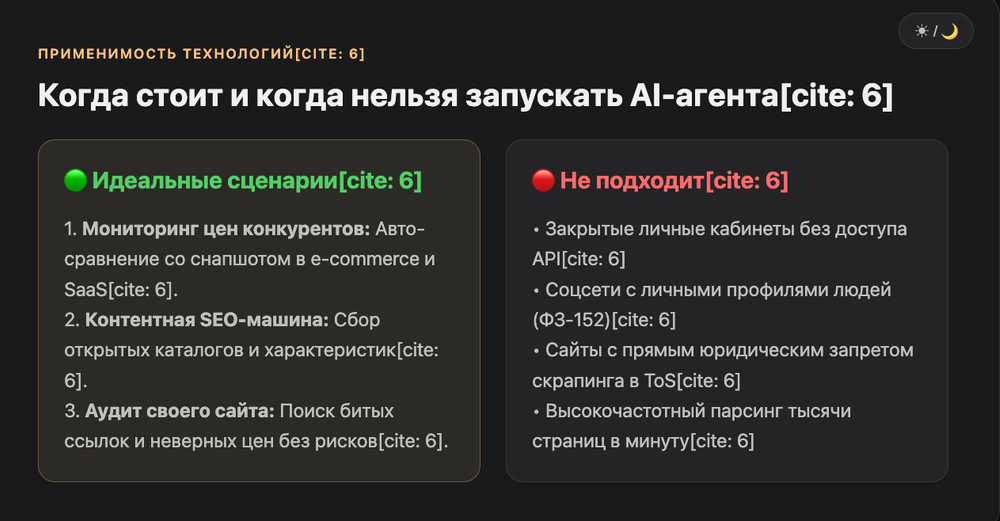
Не подходит парсинг через AI агента там, где нужен доступ к закрытым личным кабинетам, соцсетям с персональными профилями или сайтам, прямо запрещающим автоматический сбор данных в ToS без исключений.
Часто задаваемые вопросы
Законно ли парсить сайты в России в 2026 году? Да, если собираются общедоступные данные без обхода защиты и без вреда серверу. Риск появляется при сборе персональных данных, игнорировании robots.txt или перегрузке сайта частыми запросами.
Playwright MCP это то же самое что обычный Playwright? Нет. Playwright MCP - сервер, который даёт AI агенту доступ к тем же браузерным функциям через протокол MCP, а решения о действиях принимает модель, а не заранее написанный скрипт.
Может ли AI агент обходить капчу? Технически некоторые связки это умеют, но автоматический обход капчи и антибот-защиты почти всегда прямое нарушение пользовательского соглашения сайта.
Что будет если сайт заблокирует агента по IP? Обычно это временная блокировка или капча при следующих заходах. Постоянный бан и претензия по ToS случаются при систематическом обходе лимитов после предупреждений.
Нужен ли прокси для парсинга через Claude Code? Для одного-двух сайтов с редкими запросами прокси не обязателен. Для мониторинга десятков страниц или маркетплейсов прокси и ротация IP заметно снижают шанс блокировки.
Можно ли парсить личные данные пользователей из соцсетей? Российская практика и позиция Роскомнадзора здесь однозначны: публичный профиль в соцсети не считается общедоступным источником персональных данных, собирать такие данные без согласия нельзя.
Сколько стоит защита от бана при парсинге конкурентов? Playwright MCP бесплатный и open source, платить приходится за токены модели и опционально за прокси-инфраструктуру, у части сервисов есть бесплатный лимит около 2000 запросов в месяц.
Итог стоит ли строить agent для парсинга самому
Строить стоит, но с оговоркой: технология уже дешёвая и доступная, а вот юридическая граница - самая частая причина проблем, а не техническая сложность. Playwright MCP и его аналоги решают инженерную часть задачи за пару вечеров в Claude Code. Куда больше времени стоит потратить на проверку robots.txt, честный User-Agent и фильтр персональных данных - именно эти три вещи отделяют рабочий инструмент мониторинга от потенциального иска.
Если нужен готовый каталог инструментов для сборки такого агента - смотрите каталог AI-инструментов на VibeCoderz. А если хочется обсудить конкретный кейс мониторинга конкурентов под свой проект - запишитесь на консультацию к Максиму.
Обновлено: октябрь 2026.