Автоматическая проверка кода в 2026 году строится не на одном инструменте, а на трех слоях, которые ловят разные типы проблем: линтер следит за стилем и синтаксисом, статический анализ ищет уязвимости и логические ошибки, AI-ревью оценивает архитектуру и смысл изменений. Разберем, чем каждый уровень отличается от других, в каком порядке их запускать в CI и какие инструменты реально стоят своих денег.
Три уровня проверки кода экономят часы отладки: линтер ловит опечатки и неиспользуемые переменные за секунды, статический анализ находит SQL-инъекции и логические баги до релиза, AI-ревью объясняет, почему пул-реквест ломает соседний модуль. В статье: порядок запуска в CI, таблица инструментов на 2026 год и разбор цен.
Что такое три уровня проверки кода?
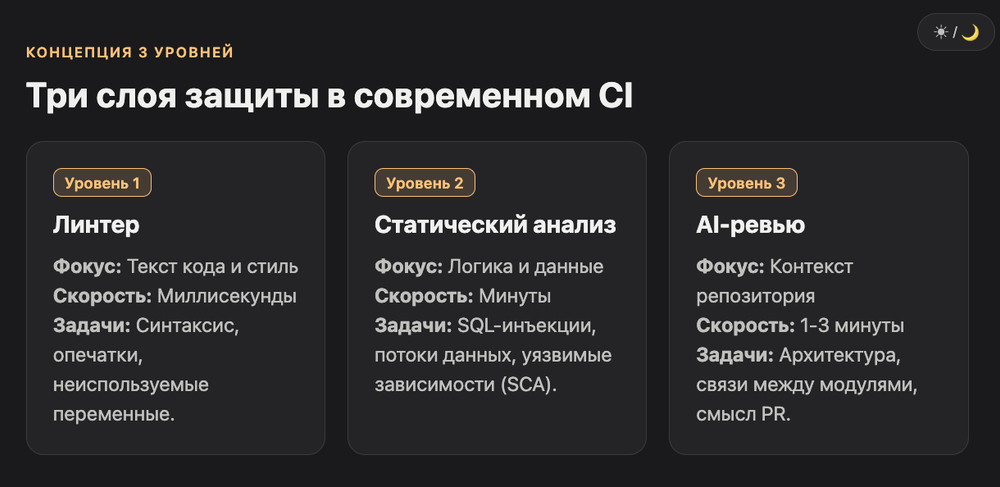
Три уровня, это линтер (стиль и синтаксис), статический анализ (SAST, уязвимости и логика) и AI-ревью (архитектура и смысл изменений). Каждый уровень видит то, что остальные пропускают.
Линтер работает с текстом кода. Статический анализ понимает поток данных внутри функции. AI-ревью держит в контексте весь репозиторий и историю пул-реквеста. Три инструмента, три разные модели понимания кода, и ни одна не заменяет другую полностью.
Путать эти три уровня, самая частая ошибка. Команда ставит ESLint, видит зеленый CI и решает, что код в безопасности. А ESLint физически не умеет находить SQL-инъекцию: он не смотрит, куда уходит переменная после присвоения. Для этого нужен статический анализ, который прослеживает поток данных от ввода до использования. Раздел по DevSecOps на конференции по безопасной разработке разбирал ровно этот случай: два параметра, один проверяется по значению, второй, по названию строки, и линтер такую подмену не заметит никогда. Три уровня закрывают три разные зоны риска, и именно поэтому их держат вместе, а не выбирают один вместо другого.
Чем линтер отличается от статического анализа?
Линтер проверяет стиль и синтаксис за миллисекунды на сохранении файла. Статический анализ смотрит логику и потоки данных, работает на пуше или в CI и занимает минуты, а не секунды.
Линтер, это первая линия обороны. ESLint, Biome или Oxlint разбирают файл в дерево токенов и сверяют его с набором правил: неиспользуемая переменная, забытый console.log, несоответствие форматированию. Работает моментально, на каждое сохранение файла в редакторе.
Статический анализ идет глубже. Он строит граф выполнения и отслеживает, куда движутся данные: из пользовательского ввода в SQL-запрос, из параметра функции в проверку авторизации. Именно так находят уязвимости вроде небезопасной десериализации или инъекций, которые линтер физически не видит, потому что не анализирует логику между строками.
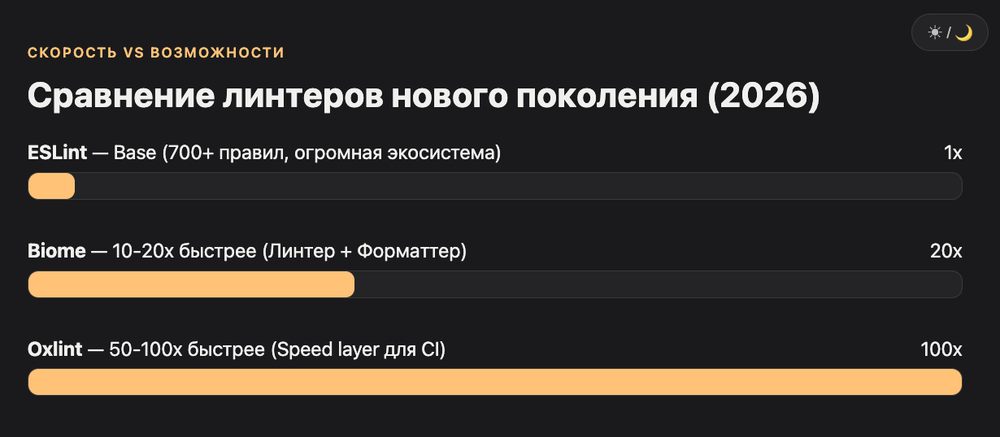
В VibeCoderz мы держим Biome вместо связки ESLint и Prettier: конфиг короче, а проверка отрабатывает почти мгновенно даже на большом монорепозитории. По данным сравнения линтеров за 2026 год, Biome обрабатывает файлы в 10-20 раз быстрее ESLint, а Oxlint, чисто линтинговый инструмент без автофикса, быстрее в 50-100 раз, но при этом у ESLint остается 4000+ плагинов и 700+ правил, которых нет ни у одной альтернативы.
| Инструмент | Скорость относительно ESLint | Правил | Плюс |
|---|---|---|---|
| ESLint | база | 700+ | огромная экосистема плагинов |
| Biome | 10-20x быстрее | 423+ | линтер и форматтер в одном бинарнике |
| Oxlint | 50-100x быстрее | ~300 | лучший вариант для CI speed layer |
Что проверяет SAST и почему одного линтера мало?
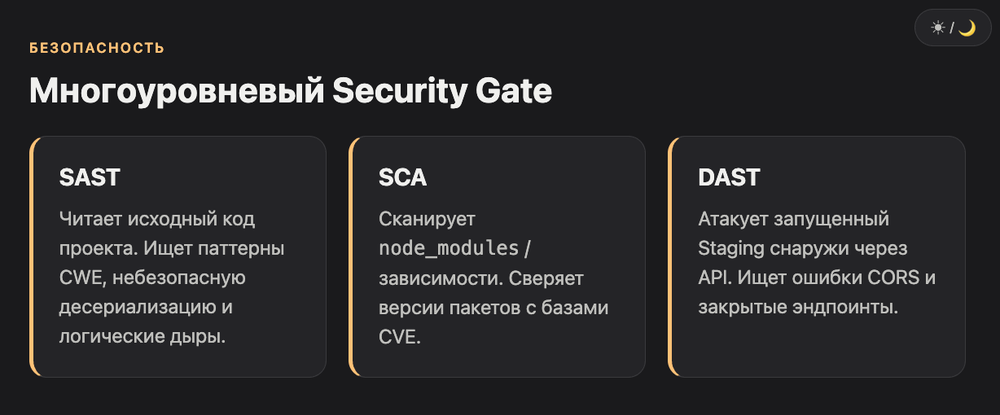
SAST ищет уязвимости внутри кода без его запуска: SQL-инъекции, небезопасные проверки, утечки секретов. Дополняет его SCA, который проверяет уязвимости в сторонних библиотеках, а не в вашем коде.
Statical Application Security Testing (SAST) читает исходники и ищет паттерны из базы CWE, известных шаблонов ошибок, которые превращаются в уязвимости. Хрестоматийный пример из доклада по SAST: функция проверяет три параметра, но для одного из них сравнивает не значение, а буквальное слово "пароль" в строке. Тесты это не ловят, потому что код компилируется и формально работает. SAST ловит, потому что видит логику проверки целиком.
Отдельная часть головоломки, зависимости. Средний проект тянет пару десятков пакетов напрямую, а вместе с транзитивными зависимостями это превращается в тысячи чужих файлов в node_modules. Software Composition Analysis (SCA) сканирует именно эту цепочку и сверяет версии пакетов с базами CVE. Инструменты вроде pip-audit для Python или Semgrep для JavaScript и TypeScript встраиваются прямо в GitHub Actions или GitLab CI как отдельный шаг пайплайна.
Третий вид проверки, DAST, атакует уже запущенное приложение снаружи, как настоящий взломщик: шлет тысячи запросов, ищет неправильные заголовки CORS и открытые эндпоинты. DAST не видит исходный код вообще, только то, что торчит наружу через API. Слои SAST, SCA и DAST вместе называют многоуровневым security gate, и именно эта связка используется в реальных пайплайнах DevSecOps.
Зачем нужен AI-ревью, если уже есть линтер и SAST?
AI-ревью видит контекст всего репозитория: как изменение в одном файле повлияет на функции в других модулях. Ни линтер, ни статический анализатор так далеко не заглядывают, они работают в границах одного файла или одной функции.
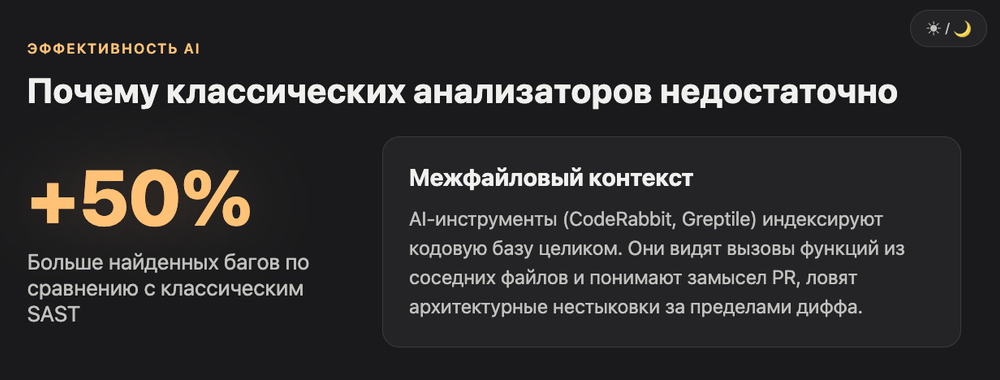
Линтер и SAST, детерминированные инструменты. Они сверяют код с фиксированным набором правил и почти никогда не ошибаются в том, что находят, зато совершенно не понимают замысел изменения. AI-ревью работает иначе: модель индексирует кодовую базу целиком и оценивает пул-реквест в контексте вызывающего кода, смежных модулей и предыдущих коммитов.
Разница заметна на практике. По независимому бенчмарку точности обнаружения багов CodeRabbit и Greptile ловят на 50% больше проблем, чем классические статические анализаторы, потому что учитывают вызовы из соседних файлов и предположения, лежащие за пределами самого диффа. Cursor BugBot встроен в редактор и полезен, только если команда пишет именно в Cursor. Anthropic выпустил собственную многоагентную систему код-ревью в марте 2026, и по независимым оценкам она уже опережает часть конкурентов по точности находок.
Но у AI-ревью есть обратная сторона: чем глубже контекст, тем больше шанс ложного срабатывания. Greptile ловит больше багов, но и шумит сильнее, чем CodeRabbit с его акцентом на диф-аннотации. Здесь нет универсального победителя, есть баланс между полнотой и количеством ложных тревог, который каждая команда настраивает под себя.
Какой порядок проверок правильный в CI-пайплайне?
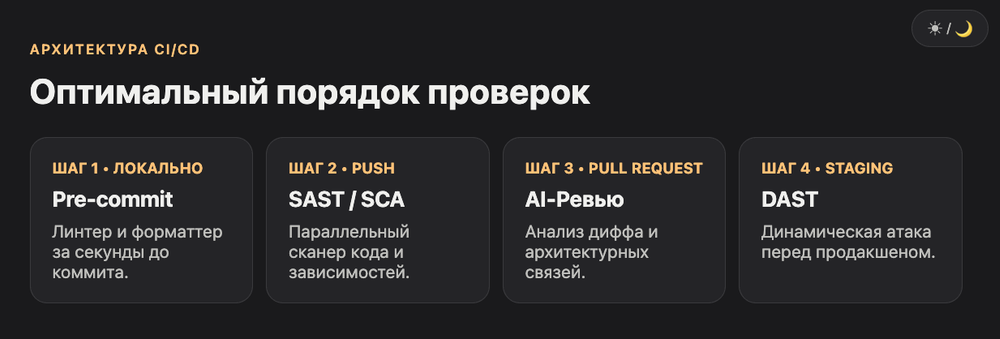
Правильный порядок: pre-commit hook на локальной машине, затем линтер и SAST/SCA параллельно на пуше, AI-ревью на пул-реквесте, DAST на staging перед продакшеном. Каждый следующий шаг дороже и медленнее предыдущего.
Порядок строится по принципу "дешево и быстро сначала, дорого и медленно потом". Незачем гонять AI-ревью на коде с забытым console.log, линтер отловит это за секунду и бесплатно.
Практическая последовательность выглядит так:
- Pre-commit hook на компьютере разработчика: линтер и форматтер, коммит блокируется, если код не проходит.
- Push в ветку: CI параллельно запускает SAST на исходном коде и SCA на зависимостях из package.json или requirements.txt.
- Открытие пул-реквеста: AI-ревью анализирует диф в контексте всей кодовой базы и оставляет комментарии.
- Деплой на staging: DAST атакует уже поднятое приложение перед тем, как оно попадет в продакшен.
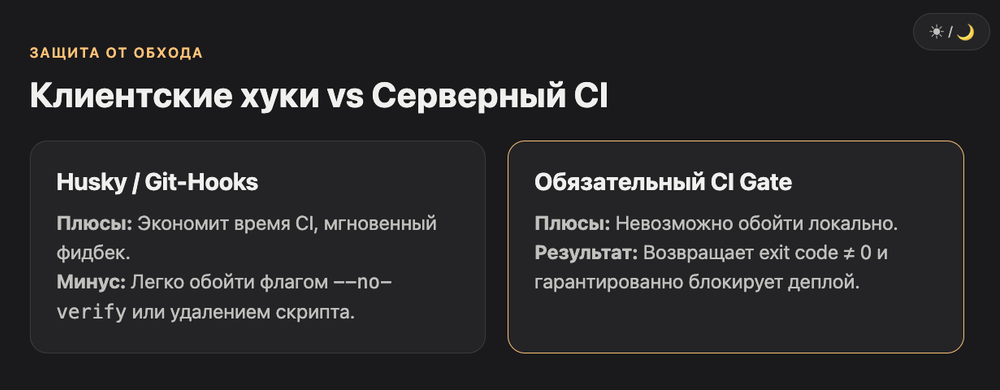
Каждый шаг генерирует стандартный код завершения процесса: 0 значит успех, любое другое число блокирует пайплайн и не дает билду доехать до продакшена. Именно так критическая уязвимость останавливает деплой автоматически, без человека, который должен был заметить проблему вручную и не заметил.
Как настроить pre-commit hook, чтобы разработчик не мог его обойти?
Git-хуки лежат в папке .git/hooks и не версионируются в репозитории, поэтому их синхронизируют через Husky и lint-staged. Финальную проверку все равно нужно дублировать в CI, потому что клиентский хук можно обойти флагом --no-verify.
Git hooks, исполняемые файлы в .git/hooks, которые запускаются на определенных событиях: pre-commit перед коммитом, pre-push перед отправкой на сервер, commit-msg для проверки формата сообщения. Проблема в том, что папка .git/hooks не попадает в git по умолчанию, и просто раздать команде инструкцию "скопируйте файл руками" работает плохо.
Husky решает это, хранит конфигурацию хуков в package.json и подставляет ее при установке зависимостей. Вместе с lint-staged хук запускает линтер только на измененных файлах, а не на всем репозитории, что экономит время на большом проекте. Практичный лайфхак: выставить max-warnings: 0 в конфиге lint-staged, тогда любое предупреждение ESLint превращается в ошибку и блокирует коммит целиком, вместо того чтобы тихо накапливаться месяцами.
Честная оговорка: разработчик всегда может обойти локальный хук флагом --no-verify или вовсе удалить файл хука. Поэтому финальная линия обороны, это сервер, а не клиент. Все три уровня проверки обязаны дублироваться в CI, независимо от того, что происходит на компьютере разработчика.
Какую модель выбрать для AI-ревью кода в 2026 году?
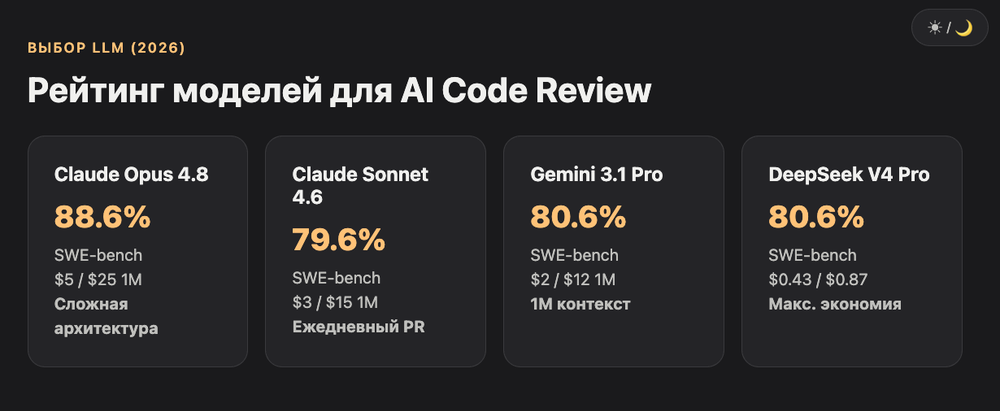
Для архитектурных решений и сложных багов подходит Claude Opus 4.8, для ежедневного ревью пул-реквестов, Claude Sonnet 4.6 как лучший баланс цены и качества. Для больших монорепозиториев выигрывает Gemini 3.1 Pro за счет контекста в 1M токенов.
AI-ревью работает на базе больших языковых моделей, и выбор модели напрямую влияет на глубину находок и счет за токены. По данным свежего рейтинга OpenRouter на июнь 2026 года, для code review имеет смысл смотреть не только на бенчмарк SWE-bench, но и на цену за миллион токенов, потому что AI-ревью гоняет модель на каждый пул-реквест.
| Модель | SWE-bench Verified | Цена (input/output за 1M) | Лучше всего для |
|---|---|---|---|
| Claude Opus 4.8 | 88.6% | $5 / $25 | сложные архитектурные ревью, поиск скрытых багов |
| Claude Sonnet 4.6 | 79.6% | $3 / $15 | ежедневное ревью пул-реквестов |
| Gemini 3.1 Pro | 80.6% | $2 / $12 | большие монорепозитории, контекст 1M токенов |
| DeepSeek V4 Pro Max | 80.6% | $0.435 / $0.87 | самостоятельный хостинг, экономия на объеме |
| Qwen3.7 Max | 80.4% | $1.25 / $3.75 | бюджетная альтернатива Opus за 1/6 цены |
Для команды, которая только собирает первый пайплайн, Sonnet 4.6 закрывает 90% сценариев: он достаточно точен для типового ревью и не разоряет бюджет на токены. Opus имеет смысл подключать точечно, на пул-реквесты с пометкой "архитектурное изменение" или перед крупным релизом, где цена ошибки выше, чем цена токенов.
Сколько стоит собрать три уровня проверки кода?
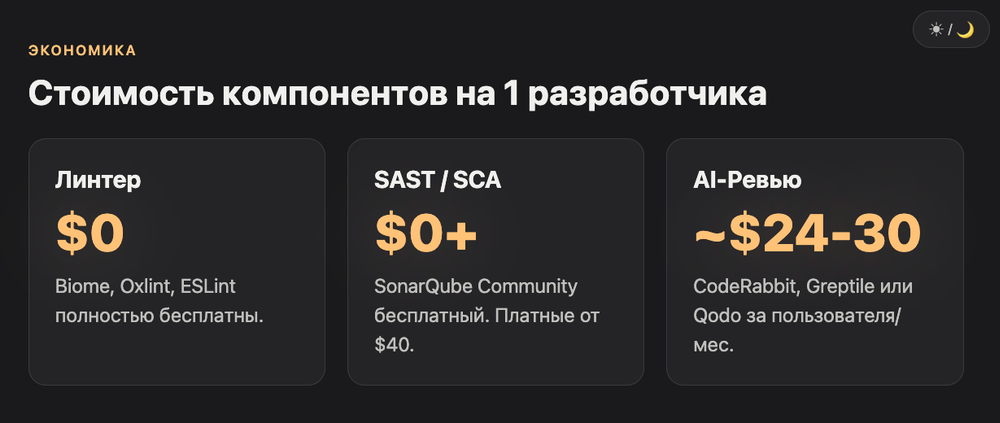
По ценам на июнь 2026 года: линтер бесплатный, статический анализ от бесплатного community-тира до нескольких тысяч рублей за большую команду, AI-ревью, самая дорогая часть, от 10 до 40 долларов за разработчика в месяц.
Линтеры вроде ESLint, Biome и Oxlint бесплатны и открыты, здесь платить не за что, кроме времени на настройку. SonarQube Community Edition тоже бесплатен для базового статического анализа, платная версия нужна только для сложных проверок на большой кодовой базе.
AI-ревью, статья расходов, которую стоит планировать заранее. По обзору цен на середину 2026 года, CodeRabbit Pro стоит около 24 долларов на разработчика в месяц при годовой оплате, Greptile 30 долларов за место с 50 ревью в комплекте, Qodo Teams 30 долларов за пользователя, Semgrep около 40 долларов за контрибьютора, а GitHub Copilot идет диапазоном от 10 до 39 долларов с доплатой за объем использования.
| Инструмент | Цена (июнь 2026) | Что получаете |
|---|---|---|
| CodeRabbit Pro | ~$24/разработчик/мес | быстрая настройка, низкий процент шума |
| Greptile | ~$30/место, 50 ревью включено | контекст всей кодовой базы |
| Qodo Teams | ~$30/пользователь | ревью плюс генерация тестов |
| Semgrep | ~$40/контрибьютор | сильнейший security-фокус |
| GitHub Copilot | $10-39/пользователь | ревью встроено в уже оплаченную подписку |
Для команды из трех-пяти человек связка "бесплатный Biome + бесплатный SonarQube Community + Sonnet 4.6 напрямую через API" закрывает три уровня почти без затрат. Полноценные вендорские инструменты имеет смысл подключать, когда команда растет и нужны отчетность, интеграции и governance-функции.
Кому вообще нужен такой пайплайн: новичку или зрелой команде?
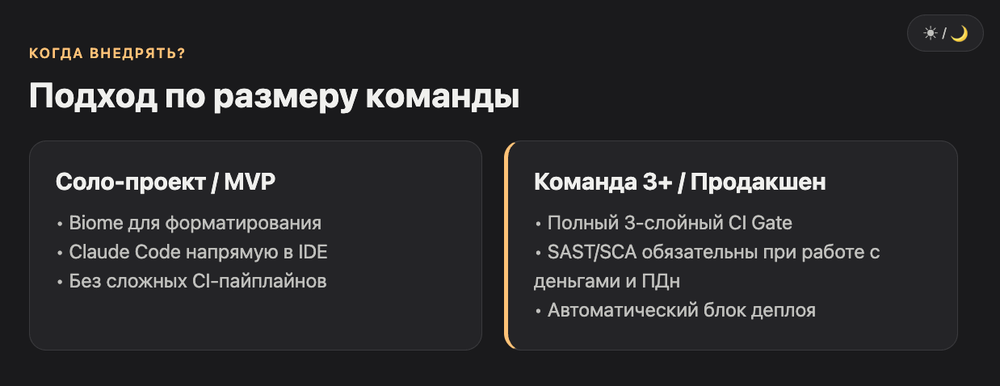
Полная трехуровневая схема нужна командам от трех разработчиков и выше или проектам с платежными данными. Соло-вайбкодеру на старте хватит линтера и одного AI-ревью прямо в редакторе.
Здесь важна пропорция затрат и риска. Если продукт, это MVP на выходных без реальных пользователей, три уровня проверки, избыточная инженерия. Достаточно Biome для стиля и Claude Code, который уже сам умеет комментировать пул-реквесты, без отдельного вендора.
Ситуация меняется, как только в проекте появляются деньги пользователей, персональные данные или команда больше одного человека. Тогда SAST и SCA перестают быть опцией: одна пропущенная SQL-инъекция или уязвимая зависимость обходится дороже, чем годовая подписка на весь набор инструментов. Разработчику под AI-агентами (вайбкодинг-стек часто зовет такого специалиста DevOps-инженером) стоит закладывать эту связку сразу в архитектуру, а не пристраивать задним числом. Если в команде нет человека с этой экспертизой, каталог агентов VibeCoderz для DevOps-задач помогает закрыть конкретные шаги настройки без найма отдельного специалиста.
Максим: «Мог просто засесть до пяти ночи и просто там править одну какую-то функцию, которая не работала. Если бы не терпение, в моменте я уже испотел и хотел все это закрыть. Но я понимал, что это можно решить и нужно решить, чтобы идти дальше.»
Почему исправлять ошибки на раннем этапе дешевле?
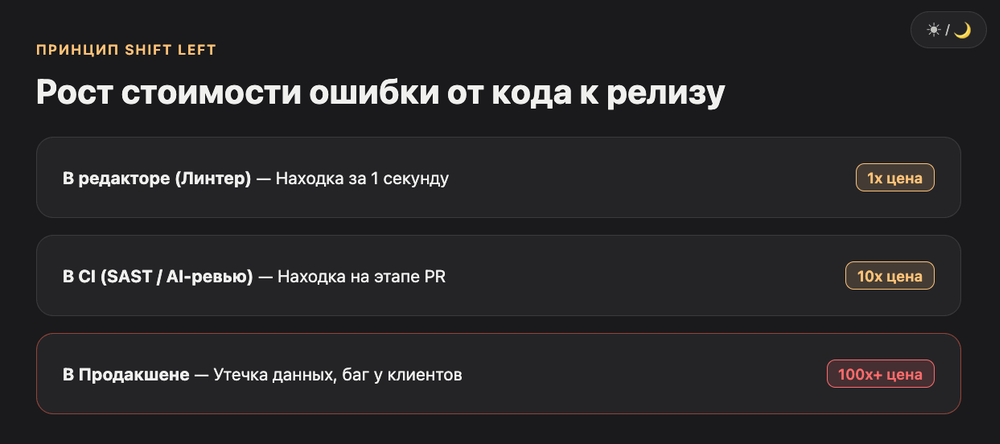
Стоимость исправления бага растет на каждом следующем этапе разработки. Ошибка, найденная на этапе проектирования, стоит в десятки раз дешевле той же ошибки, пойманной уже в продакшене.
Принцип называется Shift Left: сдвигать тестирование как можно левее по временной шкале, ближе к моменту написания кода, а не к моменту релиза. Исследование Института SEI, на которое ссылаются в докладах по безопасной разработке, показывает: если баг остается незамеченным от этапа разработки до релиза, стоимость его исправления вырастает в десятки раз, а иногда и в сотни.
Три уровня проверки кода реализуют этот принцип буквально. Линтер ловит проблему за секунду до коммита. SAST ловит ее на пуше, до код-ревью человеком. AI-ревью ловит архитектурную нестыковку до слияния в основную ветку. Каждый уровень, это еще один рубеж, отодвинутый влево, и именно поэтому три слоя работают лучше, чем один самый мощный инструмент, поставленный в конце пайплайна.
FAQ по трем уровням автоматической проверки кода
Нужен ли AI-ревью, если уже настроен статический анализ? Да, потому что это разные типы проверки. SAST находит уязвимости по фиксированным паттернам, а AI-ревью оценивает логику изменения в контексте всего репозитория и объясняет решение человеческим языком.
Сколько стоит собрать три уровня проверки для маленькой команды? Практически бесплатно на старте: Biome и SonarQube Community Edition не стоят ничего, а AI-ревью через прямой доступ к Sonnet 4.6 обойдется в единицы долларов на команду в месяц при разумном объеме пул-реквестов.
Можно ли обойтись без AI-ревью на старте проекта? Можно, если проект без реальных пользователей и платежей. Как только появляются деньги или персональные данные, риск пропущенной уязвимости перевешивает стоимость инструмента.
Что делать, если статический анализатор выдает тысячи предупреждений на старом проекте? Подавить существующие предупреждения через baseline-файл и отправить их в технический долг, а новый код проверять полностью. Так анализ не блокирует работу, но не дает добавлять новые проблемы.
Замедляет ли тройная проверка деплой? Линтер и SAST на пуше добавляют секунды, редко больше минуты. AI-ревью на пул-реквесте не блокирует деплой напрямую, он работает параллельно с человеческим ревью, а не вместо CI-пайплайна.
Какой линтер выбрать в 2026 году, ESLint или Biome? Для нового проекта, Biome: один бинарник вместо связки ESLint и Prettier, конфиг короче, скорость выше в 10-20 раз. Для старого проекта с кастомными плагинами ESLint миграция может не окупиться.
Можно ли использовать Claude Code для ревью пул-реквестов бесплатно? У Claude Code есть встроенный режим код-ревью, доступный по обычной подписке Claude, без отдельного вендора вроде CodeRabbit. Для команд, которые уже платят за Claude, это способ закрыть AI-уровень без лишних расходов.
Три уровня проверки кода не конкурируют друг с другом, они закрывают разные зоны риска: линтер экономит время на код-ревью, SAST и SCA закрывают безопасность, AI-ревью ловит то, что видит только человек с полной картиной проекта в голове, только быстрее и без усталости к пятнице. Обзоры конкретных инструментов из этого пайплайна собраны в каталоге AI-инструментов VibeCoderz, включая карточки Claude Code, Cursor и GitHub Copilot с актуальными ценами.
Если нужно собрать такой пайплайн под конкретный проект и не переплатить за лишние инструменты, можно обсудить это на консультации с Максимом.
Обновлено: октябрь 2026.