
Edge AI это искусственный интеллект, который считает прямо на вашем устройстве: в телефоне, камере, машине или часах. Данные не улетают на сервер и не ждут ответа из облака. Именно поэтому смартфон узнает лицо даже в авиарежиме. Ниже разберем, чем ИИ на устройстве отличается от облачного и что такое NPU. А еще при чем тут Google AI Edge с рантаймом LiteRT и когда выигрывает гибридная схема.
TL;DR: Edge AI запускает нейросеть на самом устройстве, поэтому ответ приходит за миллисекунды, а данные остаются у владельца. Считает специальный чип NPU, помогают малые модели вроде Gemma 4 и рантайм LiteRT. Тяжелые задачи уходят в облако. Внутри: отличия от облачного ИИ, примеры, таблицы и способ попробовать за вечер.
Что такое Edge AI простыми словами?
Edge AI это нейросеть, которая работает на самом устройстве, а не на удаленном сервере. Слово edge переводится как «край»: край сети, где рождаются данные.
Edge AI, или ИИ на устройстве, это искусственный интеллект, запущенный на смартфоне, камере, автомобиле или датчике. Он обрабатывает данные там же, где они появились, и не отправляет их в облако целиком. Главную проблему он решает такую: дорога до сервера и обратно занимает сотни миллисекунд, а автомобилю нужны единицы.
Представьте два ресторана. В первом заказ везут на кухню через весь город и обратно, зато там работает целая бригада. Во втором повар стоит у вас дома и готовит сразу. Первый ресторан это облачный ИИ, второй это Edge AI.
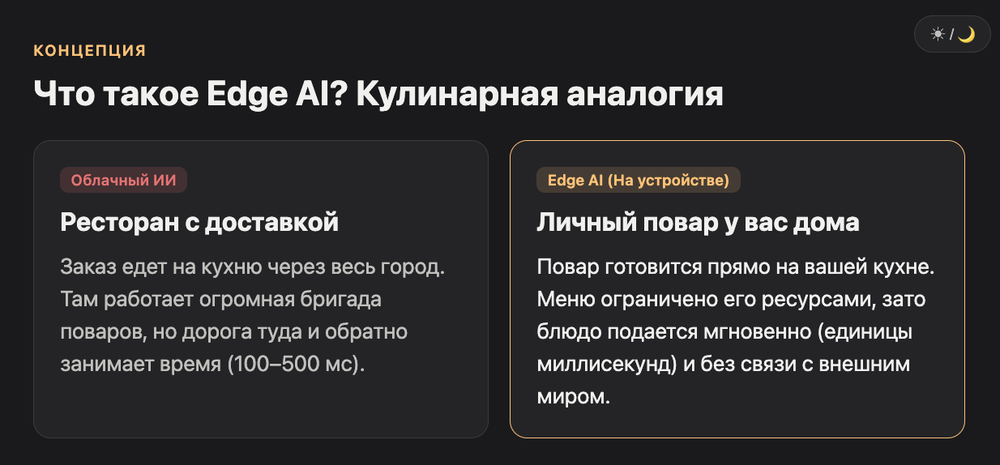
Краем считается любое устройство, где создаются данные: смартфон, планшет, дрон, фитнес-браслет, камера, машина. Модель работает внутри него и делает инференс, то есть выдает ответ на запрос без обращения к серверу. Паузу между запросом и ответом инженеры называют латентностью, или задержкой. Ее Edge AI и убирает.
Чем Edge AI отличается от облачного ИИ?
Облачный ИИ считает в дата-центре и требует интернет. Edge AI считает на устройстве и работает офлайн, но упирается в его память и мощность.
Главная разница в месте вычислений. Облачный ИИ тащит данные к мощному серверу, Edge AI приносит модель к данным. Облако дает размер и точность, устройство дает скорость и приватность. Оба подхода живут вместе и делят задачи между собой.
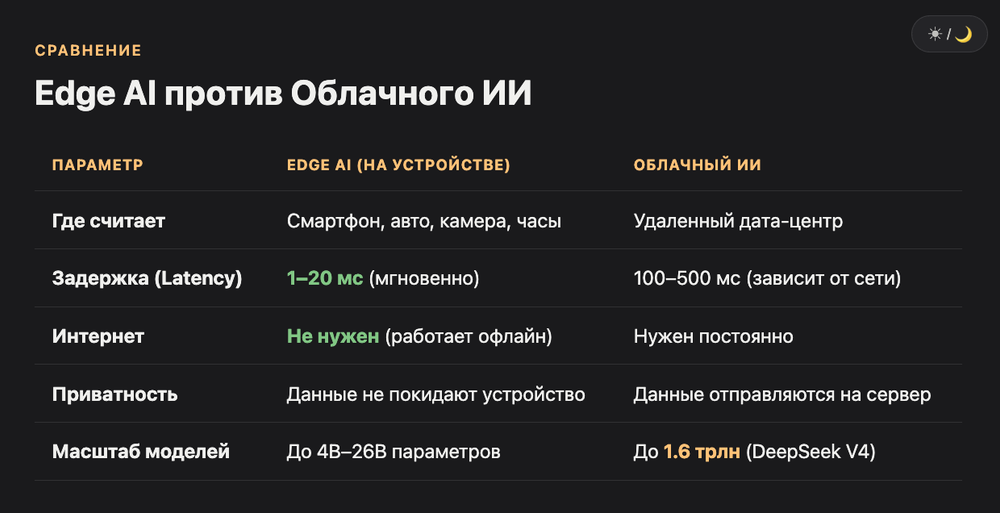
| Параметр | Edge AI | Облачный ИИ |
|---|---|---|
| Где считает | Смартфон, камера, авто, датчик | Сервер в дата-центре |
| Интернет | Не нужен после загрузки модели | Нужен постоянно |
| Задержка | Единицы и десятки миллисекунд | 100-500 мс на дорогу туда и обратно |
| Приватность | Данные остаются на устройстве | Данные уходят к провайдеру |
| Цена запроса | Нулевая, платите батареей | Оплата за токены или запросы |
| Размер модели | Ограничен памятью, обычно от сотен МБ до нескольких ГБ | До 1,6 трлн параметров у DeepSeek V4 Pro Max |
| Обновление | Нужно доставить на каждое устройство | Один раз на сервере |
Цифра про 1,6 триллиона параметров взята из каталога моделей OpenRouter на июнь 2026. У DeepSeek V4 Pro Max архитектура MoE, где одновременно активны 49 млрд параметров. Разрыв в масштабе огромный. Поэтому на телефоне вы получаете быстрого помощника, а замену самой большой облачной модели не получаете.
Есть и разница в цене сбоя. Если упадет облако, остановятся все клиенты сразу. Если сломается модель на одном телефоне, пострадает один владелец.
Какие плюсы у ИИ на устройстве и где он проигрывает?
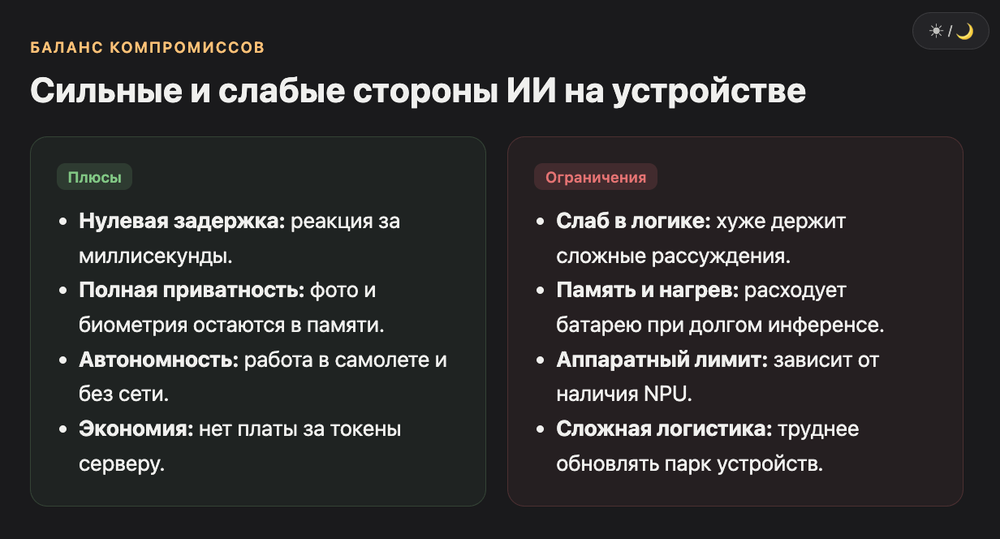
Плюсы Edge AI: скорость, приватность, работа без сети и нулевая цена запроса. Минусы: слабее модели, нагрев, расход батареи и сложные обновления на сотнях устройств.
Четыре плюса ИИ на устройстве: низкая задержка, данные остаются у владельца, работа без интернета и отсутствие платы за каждый запрос. Минус по сути один, зато весомый: ограниченная мощность. Модель на телефоне проще облачной и хуже держит сложные рассуждения.
Сильные стороны Edge AI
Скорость видна сразу. Автомобиль тормозит по сигналу собственной камеры и не ждет ответа сервера, а телефон переводит речь в самолете. Приватность работает так же просто: снимки и записи остаются в памяти устройства, что важно для медицинских браслетов, которые ищут аритмию. По оценке из видеообзора LiteRT.js, облачный запрос добавляет 100-500 мс, а на устройстве отклик укладывается в единицы миллисекунд.
Еще один плюс это экономия трафика. Умная камера присылает тревогу о человеке в кадре, а не круглосуточный видеопоток. И каждый локальный запуск после загрузки модели обходится без платы за токены.
Слабые стороны Edge AI
Память и мощность устройства задают потолок. Локальная модель проще облачной, хуже держит длинные цепочки рассуждений и не знает свежих новостей, пока вы не подключите поиск. Долгая нагрузка греет корпус и садит батарею, хотя NPU тратит заметно меньше энергии, чем процессор.
Есть и логистика. Доставить модель на тысячи устройств и надежно обновлять ее сложнее, чем поправить один сервер. Инженеры в обзорах Edge AI называют это главной трудностью, а для управления парком устройств существуют отдельные сервисы вроде Esper.
NPU что это такое и чем он отличается от CPU и GPU?
NPU это нейропроцессор, чип под матричные вычисления нейросетей. На таких задачах он быстрее и экономнее CPU и GPU, но больше ничего делать не умеет.
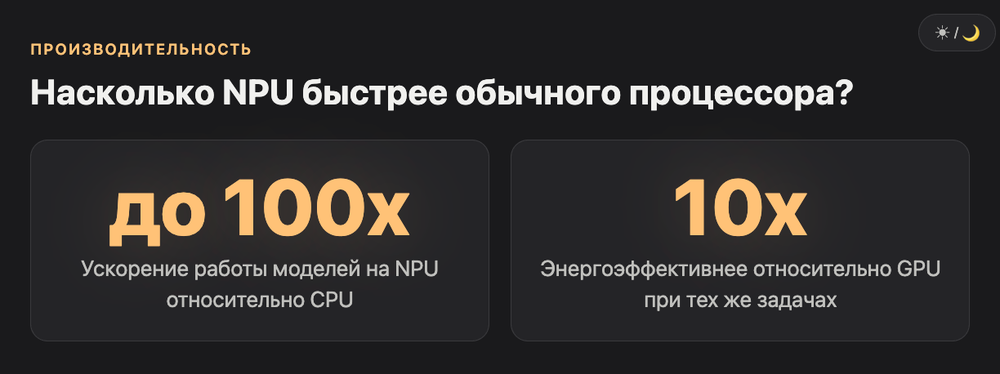
NPU (Neural Processing Unit) выполняет операции нейросети в низкой точности, чаще всего int8, и расходует в разы меньше энергии, чем процессор. По данным Google от ноября 2025, NPU Qualcomm с LiteRT ускоряет подходящие модели до 100 раз относительно CPU и примерно в 10 раз относительно GPU.
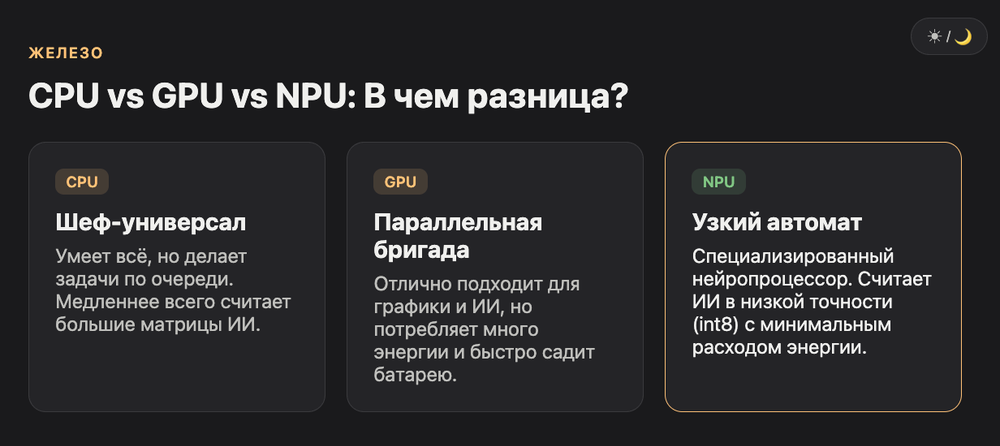
Проще всего объяснить на кухне. CPU это шеф, который умеет все, но готовит по одному блюду. GPU это бригада, которая режет овощи одновременно. NPU это станок под одну операцию: он делает ее в разы быстрее и почти без электричества.
| Чип | Сильная сторона | Слабая сторона | Что делает в телефоне |
|---|---|---|---|
| CPU | Универсальность | Медленный на больших матрицах | Система, приложения, логика |
| GPU | Массовый параллелизм | Прожорлив | Графика, игры, часть ИИ |
| NPU | Скорость и экономия на нейросетях | Узкая специализация, нужна поддержка в софте | Разблокировка по лицу, ночная съемка, перевод, диктовка |
Первые NPU в потребительских телефонах появились в 2017 году: Apple Neural Engine и Huawei Kirin 970. У Google похожий чип называется TPU, функция та же. По данным Google, NPU есть более чем в 80% свежих чипов Qualcomm.
Почему малые модели сделали Edge AI реальным?
Раньше нейросеть на телефоне мешал запустить размер модели. Квантизация и компактные архитектуры вроде Gemma 4 E2B уложили ее в память обычного смартфона.
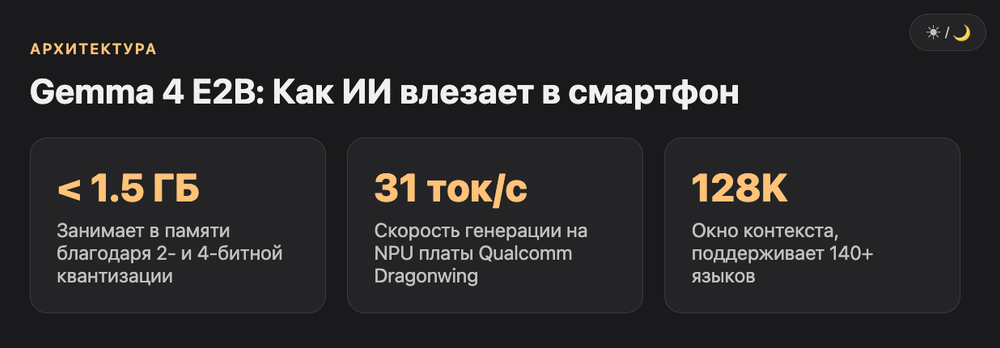
Gemma 4 E2B и E4B от Google DeepMind вышли под лицензией Apache 2.0, понимают более 140 языков и держат контекст 128K токенов. По данным Google, E2B в некоторых конфигурациях умещается меньше чем в 1,5 ГБ памяти благодаря 2- и 4-битным весам.
Как большая модель влезает в телефон
Квантизация это округление весов модели до меньшей точности, примерно как сжатие фотографии в JPEG. Файл худеет в разы, а качество падает слабо. Скорость зависит от железа. По данным Google, Gemma 4 выдает 7,6 токена в секунду на процессоре Raspberry Pi 5. На NPU платы Qualcomm Dragonwing IQ8 она выдает 31 токен.
Какие малые модели есть кроме Gemma
Линейка растет. У Mistral есть Ministral 3 на 3, 8 и 14 млрд параметров, у NVIDIA Nemotron 3 Nano, где из 30 млрд параметров активны только 3. Эти данные из нашего июньского обзора моделей OpenRouter.
На ноутбуке правило простое. При 8 ГБ оперативной памяти блогеры советуют брать версии 2B или 4B, при 16-24 ГБ подходит 26B. Вариант Q4 формата GGUF дает лучший баланс скорости и качества.
Что такое Google AI Edge и LiteRT?
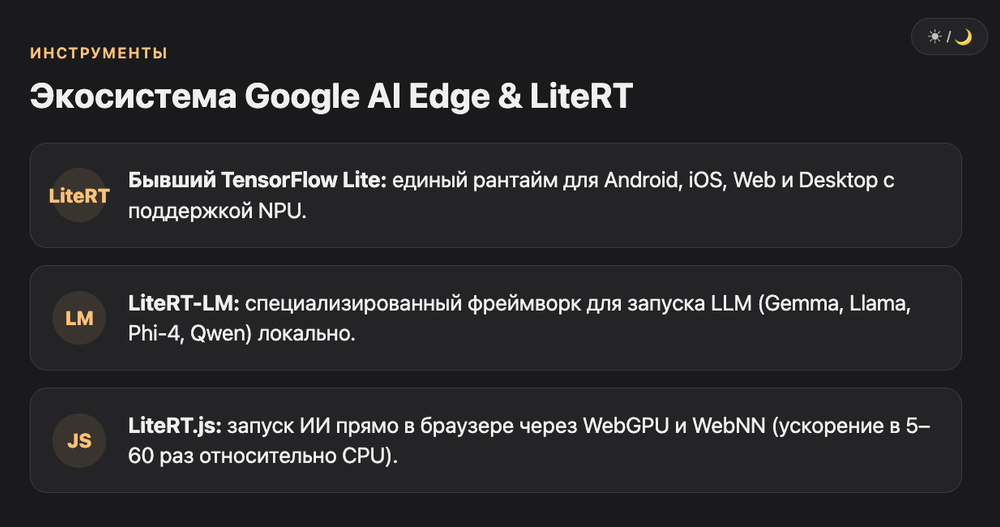
Google AI Edge это набор инструментов для запуска ИИ на устройстве. LiteRT, бывший TensorFlow Lite, служит его рантаймом, а LiteRT-LM отвечает за большие языковые модели.
LiteRT это среда выполнения моделей на устройстве, ранее известная как TensorFlow Lite. Один формат модели и один рантайм работают на Android, iOS, десктопе и в браузере. Ускорение на NPU поддерживают чипы Google Tensor, Qualcomm, MediaTek, Intel и Samsung Exynos.
LiteRT и ускорение на NPU
Google добавила в LiteRT единый интерфейс для NPU, поэтому разработчику не нужно возиться с фирменным SDK каждого производителя. Модель можно подготовить под конкретный чип заранее (режим AOT) или собрать на устройстве при первом запуске (режим JIT). Первый вариант быстрее стартует, второй проще раздавать. Подробности есть в документации LiteRT.
На платформах Qualcomm 64 из 72 проверенных моделей ушли на NPU целиком. На Snapdragon 8 Elite Gen 5 более 56 моделей отвечают быстрее 5 мс. Кэш компиляции срезал подготовку модели на NPU с 7,5 секунды до 0,2, а память с 1,5 ГБ до 355 МБ. Это замеры Google на тестовых устройствах.
LiteRT-LM и Google AI Edge Gallery
LiteRT-LM добавляет к рантайму работу с языковыми моделями. Фреймворк с открытым кодом на GitHubзапускает Gemma, Llama, Phi-4 и Qwen на CPU, GPU и NPU. Платформы: Android, iOS, веб, десктоп и Raspberry Pi.
Google AI Edge Gallery это готовое приложение, где Gemma 4 отвечает на телефоне без сети. В апреле 2026 туда добавили NPU для части моделей Gemma. Как скачать приложение безопасно, мы разобрали в отдельной статье.
LiteRT.js запускает модели в браузере
Google анонсировала LiteRT.js 9 июля 2026. Это тот же рантайм, собранный в WebAssembly и доступный из JavaScript. Бэкенда три: CPU, WebGPU и экспериментальный WebNN для NPU. По данным Google, WebGPU и WebNN ускоряют вычисления в 5-60 раз относительно CPU.
В демо из видеообзора кадры выросли с 38 до 120 в секунду. Оговорка: WebNN пока экспериментальный, а поддержка WebGPU в браузерах различается.
Где применяется Edge AI в 2026 году?
Edge AI работает в смартфонах, автомобилях, носимых устройствах, промышленных датчиках и камерах. Он нужен там, где важны мгновенный ответ, приватность или работа без сети.
В апреле 2026 Google Meet перевел на NPU модель сегментации в 25 раз крупнее прежней без роста энергопотребления. Приложение Epic Games Live Link Face получило до 30 кадров в секунду для анимации лица на Android. Оба примера описаны в блоге Google о LiteRT и NPU.
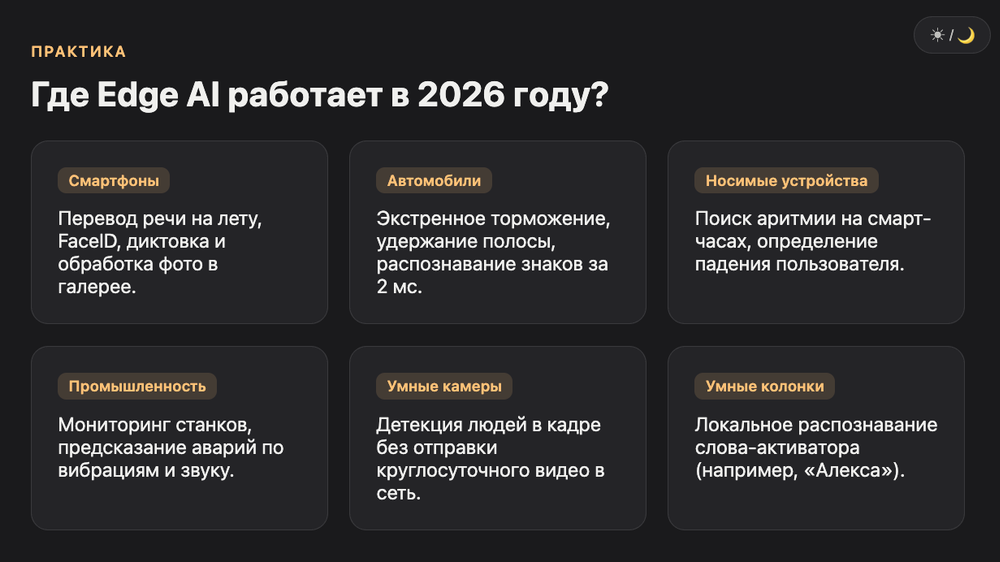
| Сфера | Что считает устройство | Что уходит в облако |
|---|---|---|
| Смартфон | Разблокировка по лицу, диктовка, перевод, ночная съемка | Синхронизация, тяжелые запросы |
| Автомобиль | Распознавание препятствий, удержание полосы, предотвращение столкновений | Обновление карт, аналитика парка |
| Носимые устройства | Поиск аритмии, определение падения | Долгая статистика |
| Промышленность | Предсказание поломок по датчикам станков, аномалии на линиях электропередач | Отчеты, переобучение модели |
| Камеры | Поиск людей в кадре | Только тревоги без видеопотока |
| Умные колонки | Распознавание слова-активатора | Ответ на сложный вопрос |
Ускорение измеряют и на реальных продуктах. Argmax Pro SDK получил больше чем двукратный прирост при переходе с GPU на NPU в живой транскрибации, о чем писал Google.
Отдельная история это умные колонки вроде Alexa. Слово-активатор там узнает крошечная модель прямо в колонке, и только после него запрос едет дальше. Тем, кто строит собственные Edge-приложения, пригодится платформа Edge Impulse.
Когда лучше гибридная схема, а когда хватит устройства?
Простое и приватное считайте на устройстве, тяжелое и редкое отправляйте в облако. Гибрид выигрывает, когда нужны и скорость, и мощная модель.
Гибридная схема делит работу: устройство обрабатывает сигнал за миллисекунды, облако решает сложные задачи. По данным OpenRouter на 10 июня 2026, Claude Opus 4.8 стоит 5 долларов за миллион входных токенов и 25 за выходные. У Gemini 3.1 Flash Lite это около 0,10 и 0,40.
Пример из жизни: телефон диктует и чистит текст локально, а сложный анализ длинного документа уходит в большую модель. Так вы платите за токены только там, где без облака не обойтись. Цены меняются быстро, перед расчетами сверяйтесь с OpenRouter.
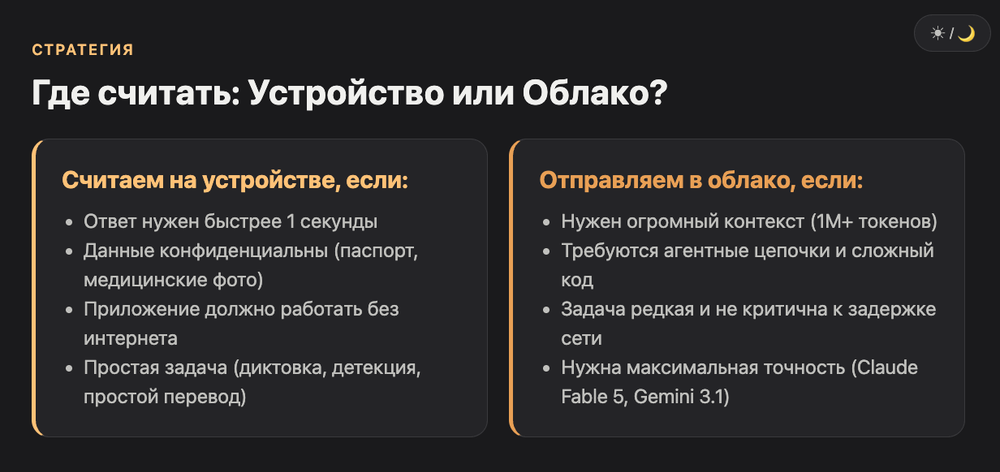
Рабочее правило простое. Если ответ нужен быстрее секунды или данные нельзя выпускать наружу, считайте на устройстве. Если задача редкая и сложная, платите облаку.
| Задача | Где считать | Почему |
|---|---|---|
| Разблокировка, ночной режим, распознавание в кадре | Устройство | Миллисекунды и приватность |
| Диктовка и перевод без сети | Устройство | Работает в самолете |
| Разбор большой кодовой базы | Облако | Нужен контекст 1M токенов, как у Gemini 3.1 Pro |
| Агентные цепочки и сложный код | Облако | Лидер точности Claude Fable 5, 95,0% на SWE-bench Verified |
| Личные данные и простой ответ | Устройство | Данные не покидают телефон |
| Черновик и финальная правка | Гибрид | Экономия токенов при хорошем качестве |
Как попробовать ИИ на устройстве за один вечер?
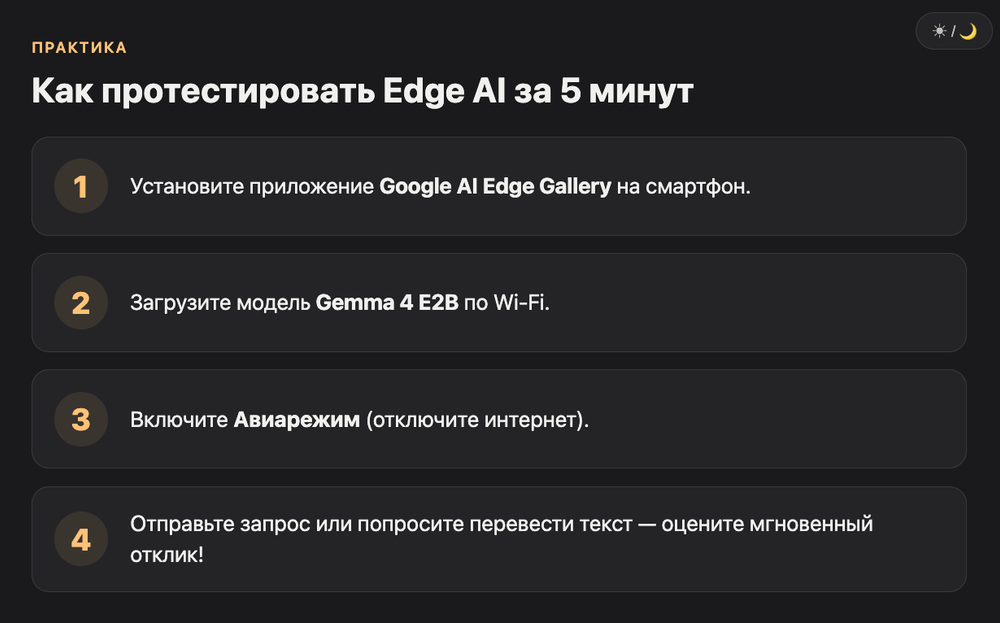
Поставьте Google AI Edge Gallery, скачайте Gemma 4 E2B, включите авиарежим и задайте вопрос. Если ответ пришел, вы запустили Edge AI сами.
Самый короткий путь: приложение Google AI Edge Gallery плюс модель Gemma 4 E2B. После скачивания файла интернет не нужен. Разработчикам подойдет LiteRT-LM с командной строкой на Linux, macOS и Raspberry Pi, а для веба пакет LiteRT.js на npm.
- Установите Google AI Edge Gallery по нашей инструкции.
- Выберите самую маленькую модель, если телефон не новый.
- Скачайте файл модели по Wi-Fi.
- Включите авиарежим и попросите перевести фразу или описать фото.
- Сравните скорость с облачным чатом.
На ноутбуке проще взять LM Studio с моделью в формате GGUF, для 2B и 4B хватает окна контекста около 32K. А вайбкодеру достаточно попросить Claude Code или Cursor собрать прототип на LiteRT.js, например распознавание объектов с камеры прямо во вкладке браузера.
Максим: «Первым продуктом у меня в Аргентине было приложение на MacBook: голос в текст через Whisper. Одна задача, одна функция, я перекидывал его Лизе zip-файлом. Ребят, это работает, и именно такие узкие штуки лучше всего живут на самом устройстве. Им не нужен большой мозг из облака.»
Итог: кому Edge AI нужен уже сейчас
Edge AI пригодится тем, кому важны скорость, приватность или офлайн. Для сложных задач оставляйте облако и соединяйте оба подхода.
Edge AI в 2026 уже не эксперимент. NPU стоит в свежих чипах Qualcomm, Gemma 4 E2B местами укладывается в 1,5 ГБ памяти, а LiteRT работает на телефоне, ноутбуке и в браузере. Лучший результат дает гибрид: устройство отвечает быстро, облако помогает в сложных случаях.
Есть честная оговорка. От телефона не стоит ждать уровня Claude Fable 5 или Gemini 3.1 Pro. Малая модель хороша в узких задачах вроде диктовки, перевода и разбора фото. Для длинных рассуждений и больших проектов она пока слабее.
| Кто вы | Что взять |
|---|---|
| Хочу просто попробовать | Google AI Edge Gallery и Gemma 4 E2B |
| Строю приложение с камерой или голосом | LiteRT и NPU-ускорение |
| Пишу веб-сервис без бэкенда | LiteRT.js и WebGPU |
| Нужна максимальная точность | Облачная модель, лучше в гибриде с устройством |
Что еще спрашивают про Edge AI?
Edge AI это то же самое, что локальная нейросеть? Почти да. Локальной нейросетью обычно называют модель, которую вы сами запускаете на своем компьютере или телефоне. Edge AI шире: сюда входят и камеры, датчики, автомобили, где ИИ встроен в устройство и вы его не настраиваете.
NPU есть в каждом телефоне? Нет. В свежих флагманах он почти всегда есть, в бюджетных моделях и старых аппаратах его может не быть. По данным Google, NPU присутствует более чем в 80% недавних чипов Qualcomm. Без него нейросеть считает на CPU или GPU, только медленнее.
Работает ли ИИ на устройстве без интернета? Да. Сеть нужна один раз, чтобы скачать приложение и файл модели. Дальше можно включить авиарежим. Исключение: функции, которым нужны свежие данные, например новости или курсы валют. Их локальная модель без поиска не знает.
Edge AI безопаснее облачного для личных данных? Обычно да, потому что данные остаются в памяти устройства. Но проверьте само приложение: некоторые все равно отправляют часть данных на сервер. Простой тест: включите авиарежим и посмотрите, продолжает ли функция работать.
Чем LiteRT отличается от TensorFlow Lite? LiteRT это новое название TensorFlow Lite и его развитие. Формат моделей .tflite остался, поэтому старые модели с Kaggle и Hugging Face продолжают работать. Добавились единый интерфейс для NPU, LiteRT-LM для языковых моделей и версия для браузера.
Может ли Edge AI заменить ChatGPT или Claude? Пока нет. Малые модели быстрее и приватнее, но слабее в сложных рассуждениях и длинном контексте. Практичнее гибрид: простые и личные задачи считает устройство, тяжелые уходят в большую облачную модель.
Можно ли запустить нейросеть в браузере без сервера? Да, через LiteRT.js. Он запускает модели на CPU, WebGPU и экспериментальном WebNN. Языковые модели в браузере пока в раннем превью: работает текстовая Gemma 4 E2B и E4B. Нужен браузер с поддержкой WebGPU.
Что делать дальше
Посмотрите обзоры инструментов в каталоге AI-инструментов VibeCoderz и подберите помощника под свою задачу в каталоге ИИ-агентов. Если хотите собрать продукт на Edge AI или гибридной схеме и не знаете, с какого конца взяться, запишитесь на консультацию к Максиму.
Обновлено: октябрь 2026