
Crawl4AI - open source Python-библиотека, которая забирает HTML с сайта и отдает чистый markdown, готовый для LLM. В отличие от Firecrawl у нее нет облачной версии с оплатой по кредитам: весь функционал бесплатен, платите только за свою инфраструктуру. Разбираем, как установить crawl4ai, что внутри у библиотеки и когда она реально выгоднее Firecrawl, а когда нет.
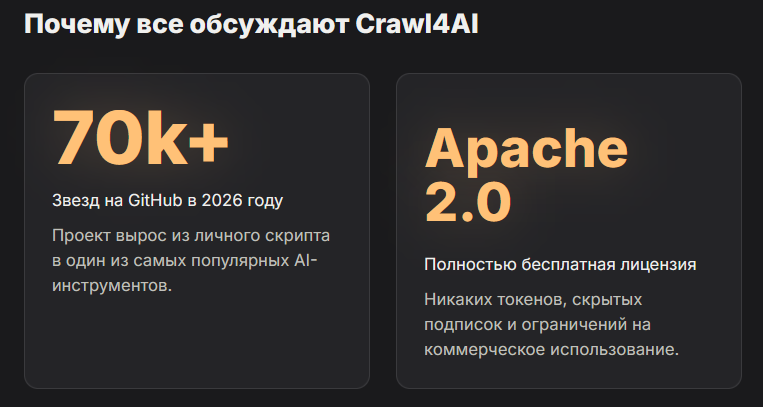
Это полностью бесплатная альтернатива Firecrawl с лицензией Apache 2.0, на GitHub у проекта больше 70 000 звезд. В статье: что под капотом у библиотеки, установка и первый краулинг с кодом, честное сравнение с Firecrawl по деньгам и антибот-защите, рекомендация под два типа проектов.
Что такое Crawl4AI и почему все обсуждают именно ее?
Crawl4AI - открытая библиотека для краулинга сайтов, которая с 2023 года выросла из личного проекта разработчика в один из самых обсуждаемых scraping-инструментов на GitHub. Работает поверх Playwright и не требует ни аккаунта, ни API-ключа для базового использования.
Автор библиотеки начал делать ее, когда искал краулер под свой проект и наткнулся на сервис, который называл себя open source, но требовал регистрацию и брал деньги за токены. Итог - за несколько дней появилась своя версия, и она разошлась по GitHub быстрее, чем ожидал автор. Сейчас проект держит статус одного из самых активно поддерживаемых в нише: релизы выходят регулярно, а не раз в полгода.
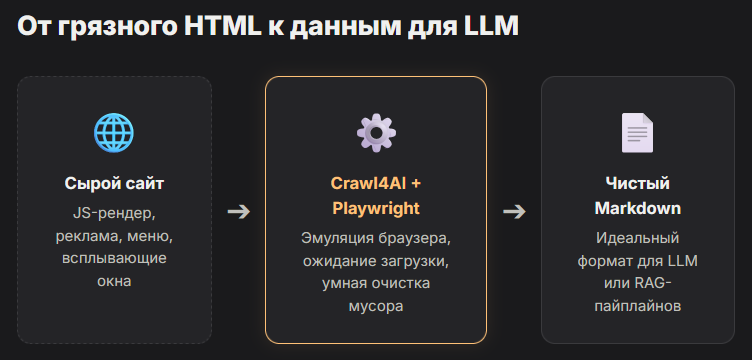
Библиотека решает одну конкретную задачу. Она берет HTML страницы, чистит его от навигации, рекламы и прочего мусора, и отдает результат в виде markdown, который можно сразу скормить модели. Есть и второй режим - структурированное извлечение через LLM или через CSS/XPath-селекторы, когда нужны не текст целиком, а конкретные поля вроде цены или названия товара.
Crawl4AI и Playwright: как это работает под капотом?
Crawl4AI использует Playwright для рендеринга JavaScript-контента - того же движка браузерной автоматизации, который применяется для тестирования сайтов и заполнения форм. Библиотека берет управление браузером на себя и добавляет слой очистки и конвертации в markdown.
Если Playwright уже разбирали на VibeCoderz как инструмент браузерной автоматизации для вайбкодера, то здесь та же технология работает по-другому: не кликает по кнопкам и не заполняет формы, а просто дожидается полной загрузки страницы и снимает с нее чистый контент. Это и есть разница между автоматизацией действий и автоматизацией сбора данных.
Разработчики держат конфигурацию рендера отдельно от логики извлечения. Через browser_config включается headless-режим, чтобы браузер не открывался визуально при каждом запуске. Через run_config задается стратегия извлечения - обычная markdown-выгрузка или структурированное извлечение через LLM.
Как установить Crawl4AI и запустить первый краулинг?
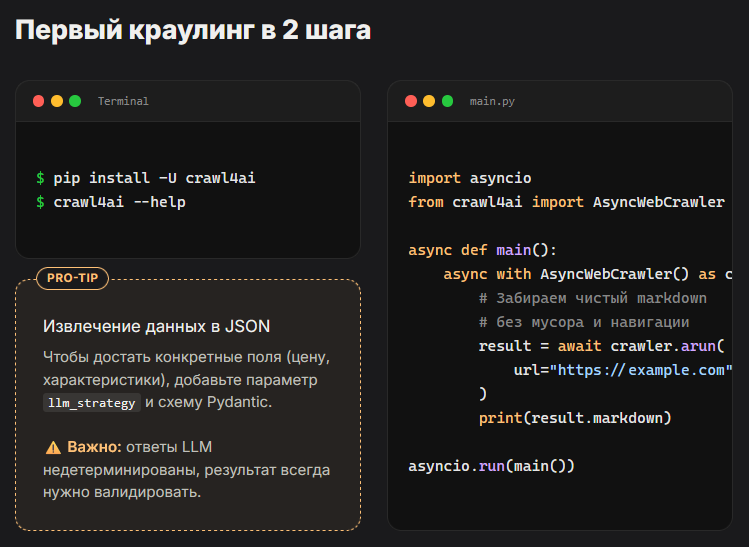
Установка занимает одну команду в терминале, первый запуск - еще одну строку кода. Минимальный путь: pip install -U crawl4ai, проверка через crawl4ai --help, и уже можно забирать markdown с любого сайта.
Ставится библиотека стандартно через pip, без танцев с виртуальными окружениями, хотя они и рекомендуются для чистоты проекта:
pip install -U crawl4ai
crawl4ai --help
Вторая команда - это проверка, что все встало нормально. Она должна вернуть список доступных опций без ошибок. Дальше можно сразу забирать контент с сайта одной строкой в терминале или через код:
import asyncio
from crawl4ai import AsyncWebCrawler

async def main():
    async with AsyncWebCrawler() as crawler:
        result = await crawler.arun(url="https://example.com")
        print(result.markdown)

asyncio.run(main())
На выходе - чистый markdown страницы, без header'ов навигации и подвала сайта. Для структурированного извлечения (например, вытащить название, цену и характеристики товара) добавляется extraction_strategy='llm_strategy' и pydantic-схема с описанием нужных полей. Тут есть нюанс: результат LLM-извлечения недетерминирован, один и тот же запрос может вернуть чуть разные данные. Проверять выход всегда придется вручную или через отдельную модель-судью.
Crawl4AI или Firecrawl - что реально выбрать?
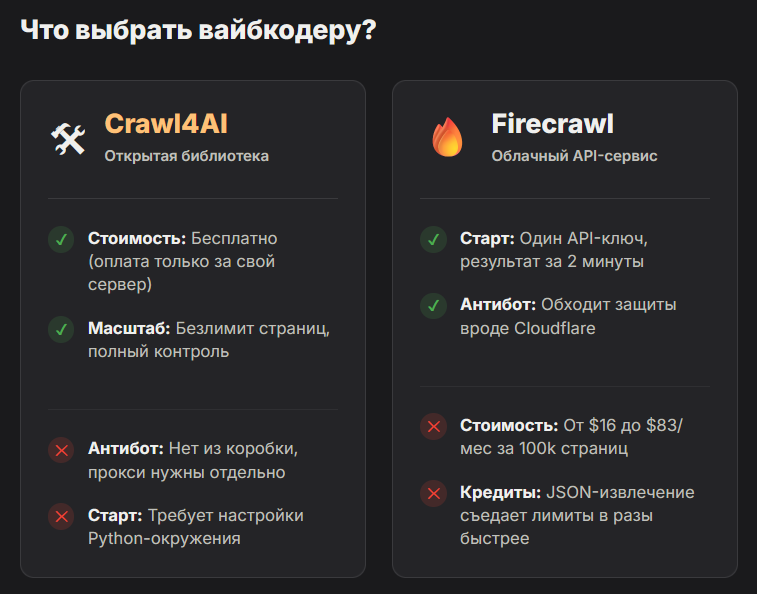
Firecrawl - платный облачный API с готовой антибот-защитой Fire-engine, Crawl4AI - бесплатная библиотека, которую нужно разворачивать и обслуживать самому. Выбор сводится к вопросу: платить за удобство или вкладывать время в свою инфраструктуру.
Firecrawl берет на себя всю грязную работу: прокси, обход блокировок, масштабирование под нагрузку. Один запрос к API - и через пару секунд на выходе чистый markdown, даже если сайт закрыт Cloudflare. Открытая библиотека дает тот же результат по markdown на обычных сайтах, но за антибот-защиту отвечает уже разработчик - через собственные прокси, ротацию user-agent или дополнительные инструменты поверх нее.
По трем практическим осям картина такая:
| Критерий | Crawl4AI | Firecrawl |
|---|---|---|
| Стоимость | Бесплатно, платите за свою инфраструктуру | От $16/мес (Hobby), $83/мес за 100 000 страниц (Standard) |
| Готовность к антибот-защите | Нет встроенного аналога Fire-engine, нужна ручная настройка | Fire-engine из коробки, страницы со stealth-режимом дороже в 5 раз по кредитам |
| Скорость старта проекта | Своя установка, Python-окружение, обслуживание при изменении верстки сайтов | Один API-ключ, первый запрос за пару минут |
Firecrawl работает по кредитной модели: 1 кредит - это примерно одна обычная страница, но включение JSON-извлечения или защищенного режима резко поднимает расход кредитов на страницу. Открытая библиотека этой математики не знает вообще - сколько запусков ни делай, счет не растет, растут только расходы на сервер и время на поддержку кода.
Сколько стоит Crawl4AI на самом деле?
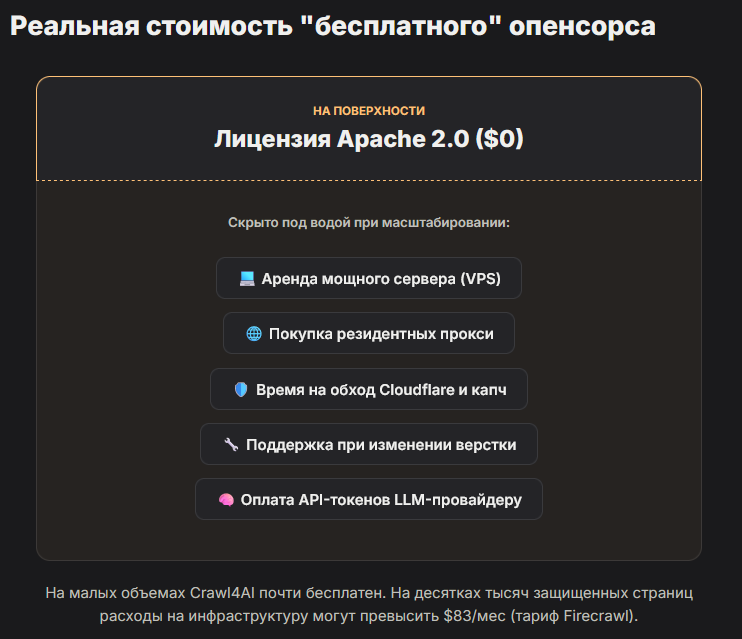
Сама библиотека Crawl4AI бесплатна полностью - лицензия Apache 2.0 без ограничений на коммерческое использование. Реальные расходы - это сервер для запуска и, опционально, токены LLM-провайдера, если включено AI-извлечение данных.
Здесь и кроется главная ловушка при сравнении "бесплатно" и "платно". Firecrawl на тарифе Standard стоит $83 в месяц за 100 000 страниц - это около $0,0008 за страницу, и туда уже включена вся инфраструктура. Crawl4AI формально бесплатен, но если краулить в больших объемах, понадобится сервер помощнее, возможно прокси для устойчивого доступа, и время разработчика на то, чтобы поддерживать пайплайн при изменении верстки целевых сайтов.
На небольших и средних объемах она обычно выходит дешевле - особенно если сервер и так есть под другие задачи. На десятках тысяч страниц в месяц с защищенных сайтов разница чаще схлопывается: время на настройку антибот-обхода стоит не меньше, чем подписка на Firecrawl.
Кому подходит Crawl4AI, а кому лучше взять Firecrawl?
Crawl4AI подходит тем, у кого есть время на настройку и много простых, незащищенных сайтов для краулинга. Firecrawl - выбор для быстрого старта без технической возни, особенно если бюджет на подписку заложен изначально.
Если проект - это сбор данных для LLM-агента с сотен обычных страниц, каталогов или документации без агрессивной защиты, Crawl4AI дает полный контроль и нулевую стоимость на масштабе. Разработчики, уже работающие с Python и Playwright, ставят библиотеку за пять минут и получают именно тот пайплайн, который нужен под задачу - без лишних полей в ответе API.
Если нужен результат сегодня, без установки окружения, и часть целевых сайтов закрыта Cloudflare или похожей защитой - разумнее взять Firecrawl. Платите за то, что кто-то другой держит прокси и антибот-слой в рабочем состоянии, пока вы занимаетесь самим продуктом.
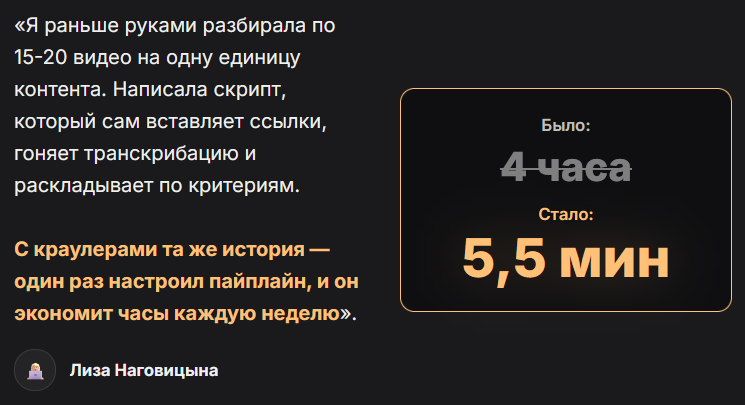
Лиза: «Я раньше руками разбирала по 15-20 видео на одну единицу контента. Написала скрипт, который сам вставляет ссылки, гоняет транскрибацию и раскладывает по критериям. Было 4 часа, стало 5,5 минут. С краулерами та же история - один раз настроил пайплайн, и он экономит часы каждую неделю».
Частые вопросы про Crawl4AI
Crawl4AI бесплатен полностью или есть скрытые платежи?
Сама библиотека бесплатна по лицензии Apache 2.0 без ограничений. Платить придется только за сервер, на котором она работает, и за токены LLM, если включено AI-извлечение данных.
Нужно ли знать Python, чтобы пользоваться Crawl4AI?
Да, базовый Python нужен - это библиотека, а не готовый сервис с интерфейсом. Минимальный скрипт краулинга занимает пять-шесть строк кода, асинхронность в примерах уже прописана заранее.
Crawl4AI обходит Cloudflare и другую антибот-защиту?
Встроенного аналога Fire-engine у нее нет. Обход сложной защиты потребует своих прокси и дополнительной настройки поверх базовой библиотеки.
Чем Crawl4AI отличается от обычного парсинга через BeautifulSoup?
BeautifulSoup отдает сырой HTML, который нужно чистить и структурировать самому. Эта библиотека сразу возвращает готовый markdown и умеет опционально извлекать данные через LLM.
Можно ли использовать Crawl4AI в коммерческом проекте?
Да, лицензия Apache 2.0 это разрешает без ограничений и без обязательной оплаты.
Что делать, если LLM-извлечение вернуло неточные данные?
Прописывать в схему подробные описания полей и обязательно проверять результат - LLM недетерминирована, один и тот же запрос иногда дает разные ответы. Для больших проверок можно использовать вторую модель как судью.
Crawl4AI подходит для сбора данных под RAG-пайплайн?
Да, это одна из основных задач библиотеки - чистый markdown без мусора идет в векторную базу заметно эффективнее, чем сырой HTML, и экономит токены на этапе индексации.
Обновлено: октябрь 2026.
Источники: репозиторий Crawl4AI на GitHub, официальная документация Crawl4AI по установке и API.
Хотите разобраться, какой инструмент под конкретную задачу выбрать - Crawl4AI, Firecrawl или что-то еще? Смотрите каталог AI-инструментов на VibeCoderz или запишитесь на консультацию к Максиму.