AI агент галлюцинирует, когда придумывает несуществующий факт, вызывает несуществующий инструмент или уверенно цитирует документ, которого не читал. Проблема не в глупости модели, а в архитектуре: чем увереннее агент рассуждает, тем чаще он ошибается с апломбом. Разберем пять рабочих методов контроля, которые применяют в продакшене прямо сейчас: RAG с цитатами, confidence score, верификация через второго агента, явные источники и ограничение области знаний.
AI агент выдумывает факты не из-за плохих данных, а из-за самой архитектуры reasoning-моделей. Пять методов контроля: RAG с обязательными цитатами, confidence score по логарифмам вероятности, агент-аудитор на дешевой модели, требование явных источников в промпте, ограничение домена через семантический роутер.
Почему AI агент вообще выдумывает факты?
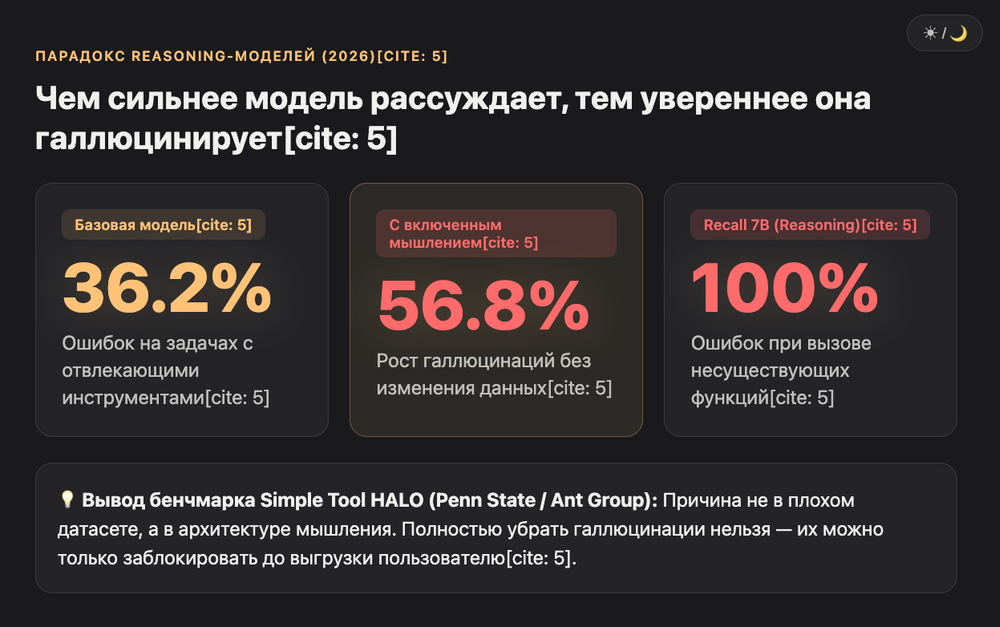
Чем сильнее модель рассуждает, тем увереннее и опаснее становятся ее галлюцинации. Это доказано экспериментально, а не предположительно.
Исследователи Penn State и Ant Group в 2026 году протестировали связь между reasoning-обучением и галлюцинациями инструментов на бенчмарке Simple Tool HALO. Результат: базовая модель ошибалась на 36,2% задач с отвлекающим инструментом. Та же модель с включенным мышлением, без единого изменения в данных, ошибалась уже на 56,8%. Модель Recall 7B, специально обученная рассуждать про инструменты, дошла до 100% галлюцинаций на той же задаче.
Причина не в качестве датасета. Когда модель дообучили на чистой математике, вообще без вызовов инструментов, склонность выдумывать несуществующие функции тоже выросла. Это архитектурная проблема, а не баг обучающей выборки. Разработчику агента важно принять факт: полностью убрать галлюцинации нельзя. Можно только выстроить систему, в которой ошибка не долетает до пользователя.
Лиза: «Для одной ниши через Codex собрала 90 листов Excel, полтора миллиона ключей. Он реально собирает частотность, находит запросы, до которых я бы вручную никогда не додумалась. На 30 минут можно отойти, он справляется сам, но я все равно выборочно сверяю цифры с Wordstat вручную».
Даже когда AI агент работает отлично, привычка проверять критичные цифры экономит нервы. Дальше пять методов, которые превращают эту привычку в код.
Как RAG с цитируемыми источниками останавливает выдумывание фактов?
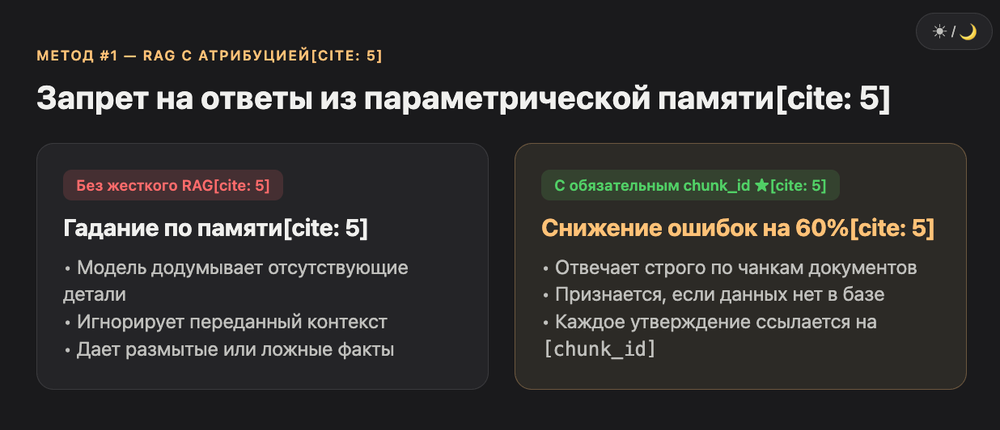
RAG снижает частоту галлюцинаций до 60% по сравнению с обычным вызовом модели без контекста. Работает это только при жестком требовании отвечать исключительно по найденным документам.
RAG (Retrieval Augmented Generation) не спрашивает модель "что ты знаешь", а подсовывает ей нужные фрагменты текста прямо в промпт и требует отвечать только по ним. Разница принципиальная: без RAG модель гадает по параметрической памяти, с RAG она пересказывает конкретный документ. По данным отраслевого обзора 2026 года, продакшн-агенты с грамотно настроенным RAG снижают частоту галлюцинаций примерно на 60% против baseline-вызова без контекста.
Ключевая деталь, о которой часто забывают: сам факт наличия RAG ничего не гарантирует. Модель может проигнорировать найденный контекст и все равно сочинить ответ из головы, если в промпте нет жесткого запрета.
SYSTEM_PROMPT = """
Отвечай ТОЛЬКО на основе предоставленного контекста ниже.
Если ответа нет в контексте, скажи "Не нашел информации в базе знаний"
и не пытайся угадать.

Для каждого факта в ответе указывай источник в формате [источник: chunk_id].
"""

def answer_with_rag(query: str, retriever, llm):
    chunks = retriever.search(query, top_k=5)
    context = "\n\n".join(
        f"[chunk_id: {c.id}]\n{c.text}" for c in chunks
    )
    response = llm.generate(
        system=SYSTEM_PROMPT,
        user=f"Контекст:\n{context}\n\nВопрос: {query}"
    )
    return response, chunks
Отдельно стоит проверять, что цитируемый chunk_id реально существует среди найденных чанков. Это займет пять строк кода, но отсекает ситуацию, когда модель ссылается на источник, которого не было в выдаче поиска.
Что такое confidence score и как его посчитать на практике?
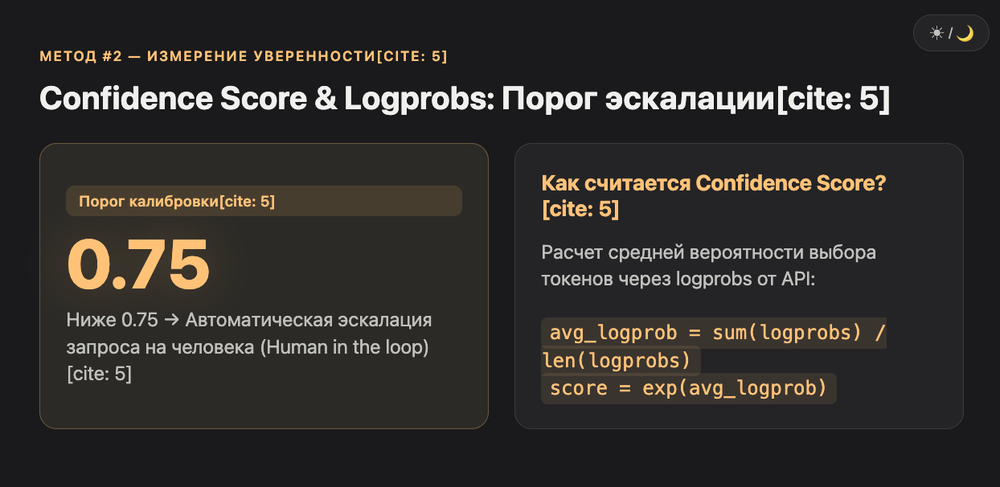
Confidence score показывает, насколько модель "уверена" в собственном ответе, через логарифмы вероятности токенов. Низкий score, ниже порога в 0,7 to 0,8, сигнал для эскалации на человека.
Confidence score, если не усложнять, это средняя вероятность, с которой модель выбирала каждый следующий токен ответа. Большинство API (OpenAI, совместимые с OpenRouter эндпоинты) отдают logprobs по запросу, и на них строится простая метрика: чем ниже средняя вероятность токенов, тем менее уверена модель в собственных словах.
import math

def confidence_score(response_logprobs: list[float]) -> float:
    """
    response_logprobs — логарифмы вероятности каждого токена ответа,
    приходят от API при include_logprobs=True
    """
    avg_logprob = sum(response_logprobs) / len(response_logprobs)
    return math.exp(avg_logprob)  # переводим лог обратно в вероятность 0-1

def should_escalate(score: float, threshold: float = 0.75) -> bool:
    return score < threshold
На практике порог 0,75 работает как стартовая точка, но его нужно калибровать на собственных данных: собрать сотню реальных ответов, разметить вручную "правда/выдумка" и посмотреть, на каком пороге ошибки отсекаются лучше всего. Без калибровки метрика превращается в красивую цифру без смысла.
Есть и более грубый, но бесплатный вариант без доступа к logprobs: self-consistency. Задать один вопрос модели три раза с temperature выше нуля и посмотреть, совпадают ли ответы. Если модель каждый раз выдает разные факты, это уже сигнал не доверять ни одному из них.
Зачем нужен второй агент-аудитор для проверки ответов?
Один AI создает черновик ответа, второй, на более дешевой модели, проверяет его на соответствие базе знаний. Расхождение блокирует автоответ и передает случай человеку.
Идея простая до банальности: не доверяй модели проверку самой себя в одном вызове. Агент-аудитор получает исходный вопрос, найденные документы и черновик ответа первого агента, и его единственная задача, сверить черновик с фактами. Для этой роли не нужна дорогая модель: узкая задача сравнения хорошо решается на Claude Haiku 4.5 или GPT-5.4 Mini, что снижает стоимость аудита в разы.
AUDITOR_PROMPT = """
Ты аудитор фактов. Тебе дан вопрос, найденные документы и черновик ответа.
Проверь каждое утверждение в черновике на соответствие документам.

Верни JSON:
{
  "verdict": "approved" | "rejected",
  "unsupported_claims": ["список утверждений без подтверждения"],
  "explanation": "краткое объяснение"
}
"""

def audit_response(query, context, draft_answer, cheap_llm):
    result = cheap_llm.generate(
        system=AUDITOR_PROMPT,
        user=f"Вопрос: {query}\nДокументы: {context}\nЧерновик: {draft_answer}",
        response_format="json"
    )
    if result["verdict"] == "rejected":
        return route_to_human(query, draft_answer, result["unsupported_claims"])
    return draft_answer
Для задач с высокой ценой ошибки, юридические тексты, медицинские консультации, финансовые обещания, схема расширяется до трех уровней: состязательный аудитор, RAG-проверка источников, и финальный human in the loop для утверждения. В продажах, например, именно такая трехуровневая архитектура закрывает сценарий, когда бот обещает клиенту скидку, которой не существует.
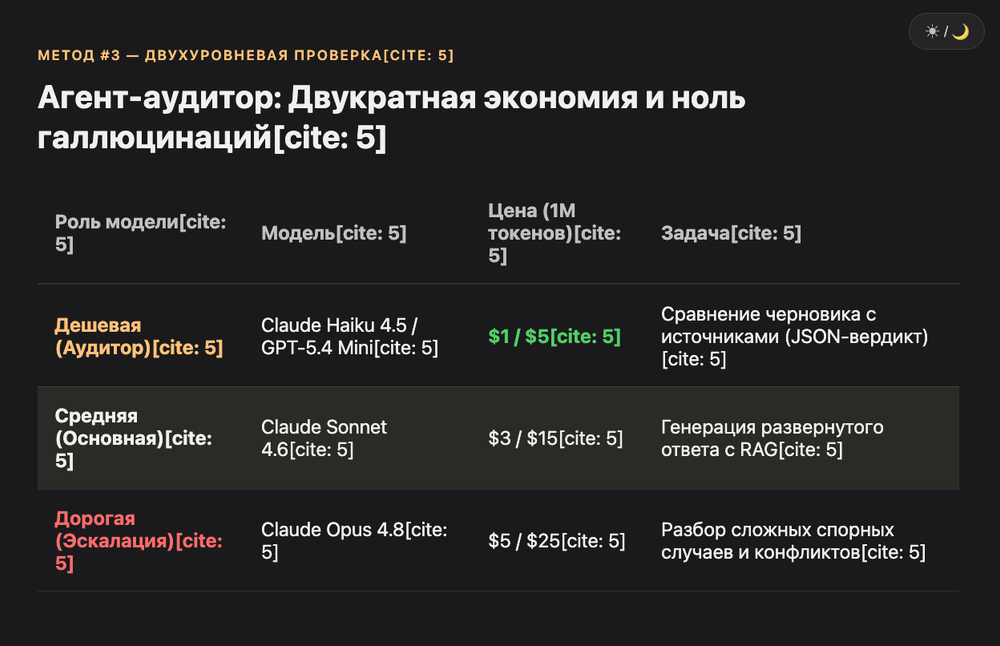
| Уровень модели | Пример | Цена (вход/выход за 1M токенов) | Задача |
|---|---|---|---|
| Дешевая (аудитор) | Claude Haiku 4.5 | $1 / $5 | Сравнить черновик с фактами |
| Средняя (основной агент) | Claude Sonnet 4.6 | $3 / $15 | Генерация ответа с RAG |
| Дорогая (эскалация) | Claude Opus 4.8 | $5 / $25 | Сложные спорные случаи |
Как заставить агента явно указывать источники в каждом ответе?
Требование явной атрибуции источника прямо в структуре вывода снижает "пустословие" и заставляет модель либо находить подтверждение, либо честно признавать пробел.
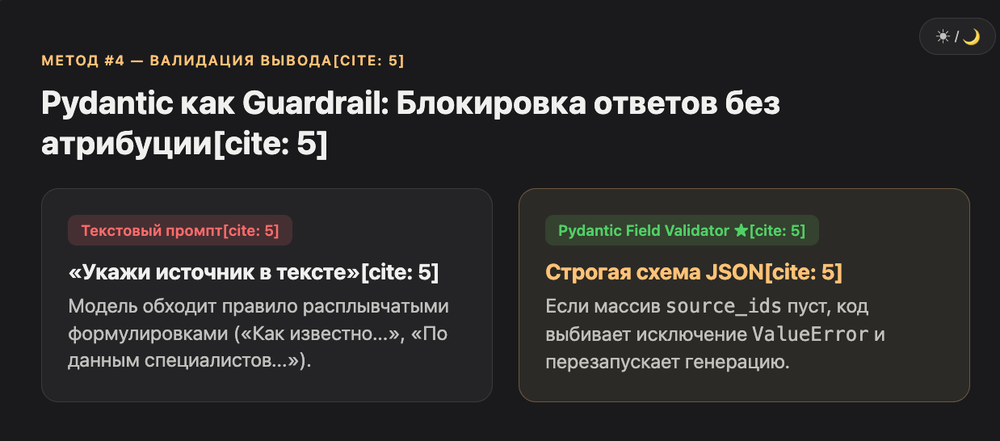
Разница между "ответь с указанием источника где-то в тексте" и "верни JSON с полем source_id, обязательным для заполнения" огромная. Первый вариант модель обходит расплывчатыми фразами. Второй вариант физически не дает пройти валидацию схемы, если поле пустое.
from pydantic import BaseModel, field_validator

class GroundedAnswer(BaseModel):
    answer: str
    source_ids: list[str]
    confidence: float

    @field_validator("source_ids")
    @classmethod
    def must_have_source(cls, v):
        if not v:
            raise ValueError("Ответ без источника недопустим, верни отказ")
        return v
Pydantic здесь работает как guardrail: если модель попытается вернуть ответ без source_ids, валидация упадет, и код перезапустит генерацию с более жестким промптом или сразу передаст запрос человеку. Это дешевле, чем ловить проблему постфактум на стороне пользователя.
Полезная деталь: используйте негативные ограничения прямо в системном промпте, "не угадывай числа", "не придумывай даты, если их нет в контексте". Формулировки от противного работают на моделях лучше, чем общие призывы "будь точным".
Как ограничение области знаний снижает количество галлюцинаций?
Семантический роутер отсекает запросы вне разрешенной темы до того, как они долетят до основной модели. Гибридный подход, семантика плюс term matching, точнее чистой векторной классификации.
Чем шире область, в которой агенту разрешено отвечать, тем больше шансов, что он вылезет за пределы своей компетенции и начнет фантазировать. Ограничение домена работает как фильтр на входе: запрос сначала проходит через маршрутизатор, и только релевантные темы попадают к основному агенту.
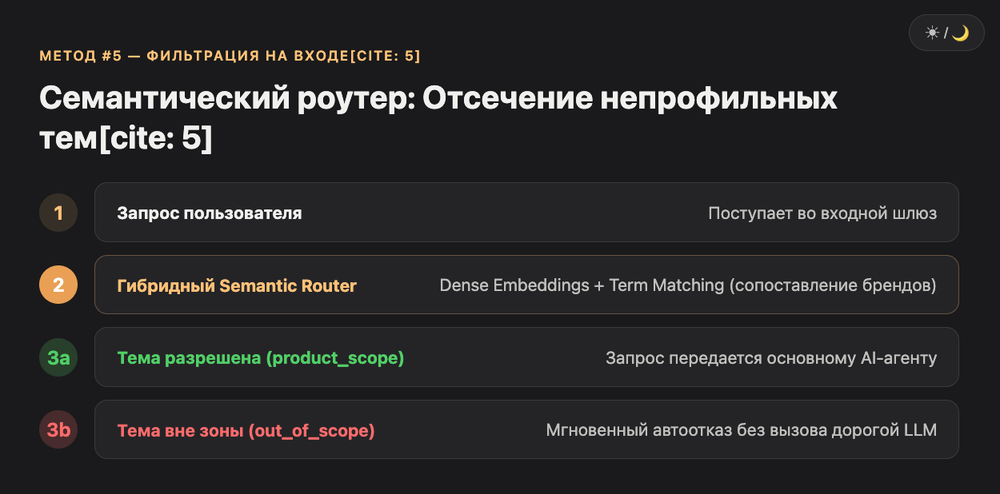
Простой пример из практики: чат-бот производителя электромобилей должен свободно обсуждать свой продукт, но блокировать вопросы про конкурентов. Чистая семантическая маршрутизация (dense embeddings) иногда путает похожие по смыслу бренды между собой. Гибридный подход, который добавляет term matching поверх embeddings, точнее ловит конкретные названия.
from semantic_router import Route, RouteLayer
from semantic_router.encoders import OpenAIEncoder

allowed_topics = Route(
    name="product_scope",
    utterances=[
        "какие тарифы у вашего продукта",
        "как настроить интеграцию",
        "сколько стоит подписка"
    ]
)

blocked_topics = Route(
    name="out_of_scope",
    utterances=[
        "что думаешь про конкурента X",
        "напиши код на другую тему",
        "расскажи анекдот"
    ]
)

router = RouteLayer(
    encoder=OpenAIEncoder(),
    routes=[allowed_topics, blocked_topics]
)

def handle_query(query: str):
    route = router(query)
    if route.name != "product_scope":
        return "Я отвечаю только по вопросам продукта, для остального обратитесь в поддержку"
    return run_agent(query)
Важный нюанс: пороги сходства (similarity threshold) нужно тестировать на реальных запросах пользователей, а не на придуманных примерах. Слишком низкий порог пропускает лишнее, слишком высокий блокирует легитимные вопросы.
Какой метод выбрать под свою задачу?
Пять методов решают разные проблемы и хорошо комбинируются друг с другом. Для критичных сценариев, продажи, финансы, медицина, нужны минимум три слоя одновременно.
Ни один из методов не работает как серебряная пуля в одиночку. RAG останавливает выдумывание фактов из ниоткуда, но не спасает, если модель проигнорирует найденный контекст. Confidence score ловит неуверенность модели, но требует калибровки под конкретные данные. Ниже сводная карта выбора.
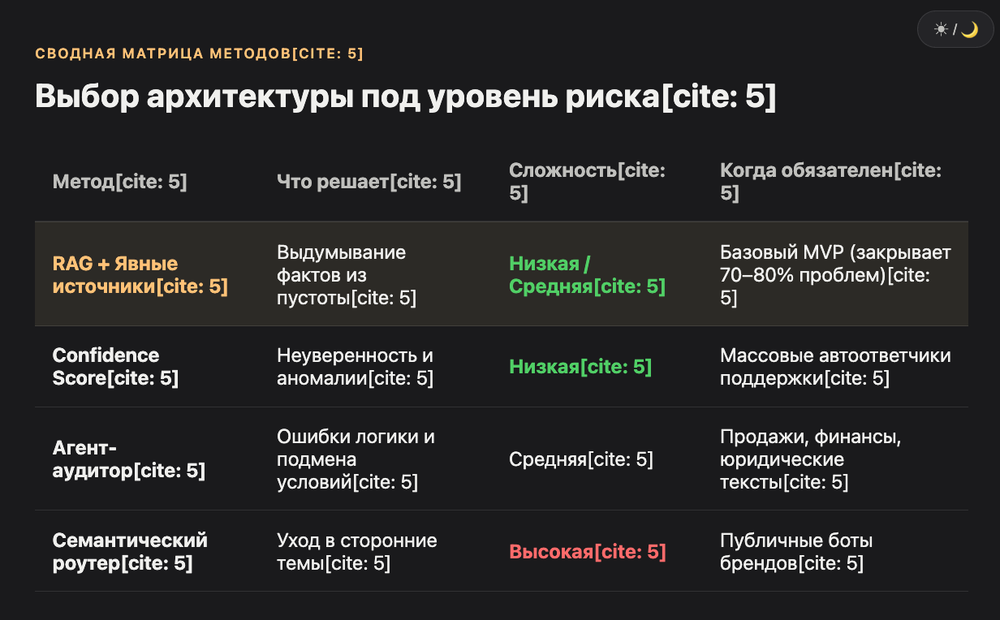
| Метод | Что решает | Сложность внедрения | Когда обязателен |
|---|---|---|---|
| RAG с цитатами | Выдумывание фактов из пустоты | Средняя | Всегда для factual-задач |
| Confidence score | Неуверенные, но опасные ответы | Низкая | Массовые автоответы |
| Агент-аудитор | Проверка перед публикацией | Средняя | Продажи, поддержка |
| Явные источники | Атрибуция и трассируемость | Низкая | Юридически значимые ответы |
| Ограничение домена | Уход агента за пределы темы | Высокая | Публичные чат-боты |
Для стартового MVP чат-бота на сайте достаточно RAG плюс явные источники: это закрывает 70-80% проблемы за пару дней работы. Для сценариев с деньгами или юридической ответственностью нужны все пять слоев сразу, включая агента-аудитора и человека в цикле для финального утверждения.
С чего начать внедрение контроля галлюцинаций?
Начинать стоит с малого: замерить текущий уровень галлюцинаций на 50-100 реальных запросах, потом добавлять RAG, потом остальные слои.
Первый шаг, не архитектурный, а измерительный. Соберите 50-100 реальных вопросов, прогоните через текущего агента без изменений и вручную разметьте, где ответ придуман, а где правдив. Без этой базовой метрики любое улучшение невозможно оценить объективно.
Дальше порядок внедрения такой: RAG с жестким промптом "отвечай только по контексту" закрывает основную массу проблем за один спринт. Confidence score добавляется следующим слоем, он почти не требует инфраструктуры, если API уже отдает logprobs. Агент-аудитор и ограничение домена, самые ресурсоемкие части, добавляются, когда трафик и цена ошибки это оправдывают.
На старте важно не пытаться закрыть все сразу. Один слой контроля, внедренный и измеренный, полезнее пяти слоев, добавленных без проверки эффекта.
Каталог инструментов для сборки таких агентов, включая Claude Code и Cursor, собран в каталоге AI-инструментов на VibeCoderz. Там же есть карточки по агентным фреймворкам для тех, кто строит RAG-пайплайн с нуля.
Частые вопросы про контроль галлюцинаций AI агента
Можно ли полностью убрать галлюцинации у AI агента? Нет, полностью убрать нельзя, это архитектурная особенность языковых моделей. Реалистичная цель, снизить частоту до долей процента через многослойный контроль: RAG, confidence score, аудит.
Какой метод внедрить первым, если ресурсов мало? RAG с жестким требованием отвечать только по контексту. Он закрывает большую часть проблемы за минимальные трудозатраты и не требует отдельной инфраструктуры под аудит.
Confidence score работает на любой модели? Нужен доступ к logprobs API, есть не у всех провайдеров. Если logprobs недоступны, используйте self-consistency: несколько прогонов одного запроса и сравнение ответов между собой.
Зачем брать дешевую модель для агента-аудитора, а не ту же самую? Задача аудитора узкая, сравнить текст с документами, а не творческая генерация. Дешевая модель справляется не хуже, а стоимость проверки падает в разы.
Реально ли обучение на рассуждениях увеличивает галлюцинации? Да, это подтверждено экспериментально на бенчмарке Simple Tool HALO Bench в 2026 году: включение режима мышления у одной и той же модели повышало частоту ошибок с инструментами почти вдвое.
Guardrails и RAG, это одно и то же? Нет. RAG отвечает за то, откуда модель берет факты. Guardrails, более широкое понятие: любые ограничения на вход и выход агента, включая проверку тем, формата ответа и токсичности.
Нужен ли human in the loop, если уже есть агент-аудитор? Для низкорисковых сценариев, нет, аудитора достаточно. Для решений с юридическими или финансовыми последствиями финальное утверждение стоит оставлять за человеком.
Если строите AI агента для своего проекта и хотите заложить контроль галлюцинаций с самого начала, а не чинить постфактум, обзоры инструментов и агентных фреймворков собраны в каталоге VibeCoderz. Для разбора конкретной архитектуры можно записаться на консультацию к Максиму.
Обновлено: октябрь 2026