
Uncensored в названии GGUF-модели на Hugging Face не означает "убрали фильтр сверху". Это конкретная техническая операция дообучения, которая меняет веса модели так же, как их менял alignment на предыдущем этапе. В статье разбираем механику простыми словами: что такое alignment, как устроен обратный процесс, зачем люди вообще выбирают такие модели и какая честная оговорка тут обязательна.
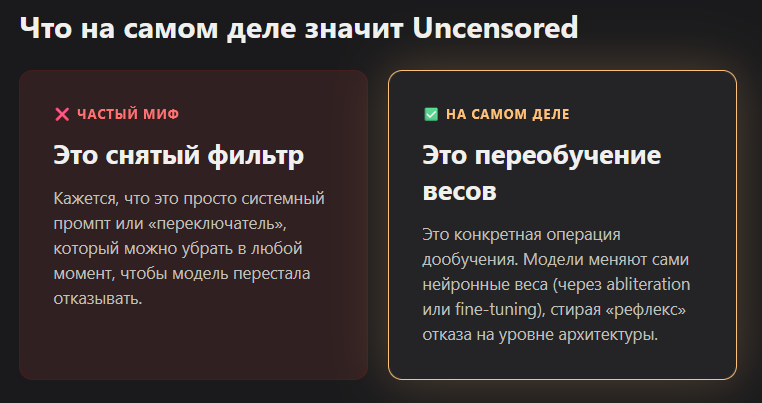
Uncensored-версия модели создается тем же методом дообучения, что и alignment, только в обратную сторону: вместо того чтобы учить модель отказывать, ее учат не делать этого рефлекторно. Знаний у модели при этом не прибавляется, меняется только готовность отвечать.
Что вообще означает alignment простыми словами?
Alignment - это дополнительный этап обучения после основной тренировки модели, на котором ее учат отказывать на определенные классы запросов независимо от контекста.
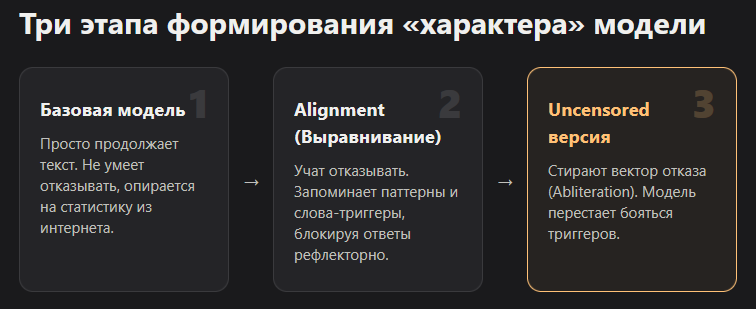
Базовая языковая модель после предобучения на текстах интернета не умеет "отказывать" сама по себе. Она просто продолжает текст статистически правдоподобным образом. Отказы появляются позже, на отдельном этапе дообучения (часто это RLHF или похожие методы supervised fine-tuning), где модель показывают тысячи пар "запрос, правильный отказ" и веса перестраиваются под эту реакцию.
Разработчик решает, где проходит граница. Иногда она проходит по делу, иногда с запасом. Модель после этого этапа реагирует не столько на реальный смысл запроса, сколько на паттерн: определенные слова и формулировки триггерят отказ, даже если контекст безобиден. Врач обсуждает дозировку препарата для пациента, писатель прописывает мрачную сцену в романе, юрист разбирает формулировку из уголовного дела. Механизм отказа не различает эти случаи от реально опасных запросов, он просто узнает паттерн.
Как устроен обратный процесс: что делают с моделью для uncensored-версии?
Uncensored-версию делают тем же инструментом, что и alignment: дообучением. Но датасет собирают наоборот, на нем модель учат не отказывать по паттерну, а отвечать по существу вопроса.
Здесь стоит зафиксировать главное: это не переключатель и не системный промпт, который можно снять. Исследователи, стоящие за техникой, которую в сообществе называют abliteration, показали, что склонность к отказу кодируется в модели как конкретное направление в пространстве активаций. Метод вычисляет разницу между средней активацией модели на "опасных" и "безобидных" промптах на каждом слое, находит направление, которое сильнее всего связано с отказом, а затем убирает его из матриц весов через математическую проекцию, собрав активации модели на двух наборах промптов: тех, что вызывают отказ, и тех, что не вызывают.
По сути происходит операция над конкретным геометрическим признаком в весах, а не над правилами модерации в привычном смысле. Безопасное поведение, полученное через RLHF и инструктивное дообучение, оказывается не сложной сетью ограничений, а одним вычислимым вектором в промежуточных слоях модели. Убираешь вектор, рефлекторные отказы пропадают, остальные способности модели остаются почти нетронутыми.
Есть и более простой путь без операций над активациями: обычное supervised fine-tuning на датасете, где на прежде отказные запросы даны прямые содержательные ответы. Метод грубее, но результат похож: модель перестает рефлекторно блокировать формулировку.
Почему люди вообще выбирают модели без цензуры?
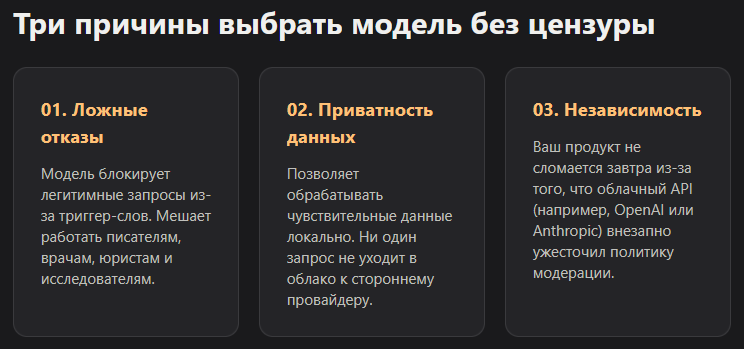
Три честные причины: ложные срабатывания фильтра на легитимных задачах, желание держать данные и историю запросов локально, и исследовательский интерес к границам возможностей модели.
Причины перечисляются без оценочных суждений, каждая встречается на практике у разных категорий пользователей локальных моделей.
| Причина | Кто сталкивается | Пример ситуации |
|---|---|---|
| Ложные отказы на безобидных задачах | Писатели, врачи, юристы, сценаристы | Модель блокирует запрос из-за триггер-слова, хотя контекст легитимный |
| Приватность и локальный запуск | Пользователи, работающие с чувствительными данными | Запрос не уходит в облако стороннего провайдера |
| Независимость от политики модерации | Разработчики продуктов на базе LLM | Продукт не должен зависеть от смены правил облачного API |
| Исследовательский интерес | ML-инженеры, red team | Изучение пределов способностей модели без искусственных барьеров |
Разработчики продуктов особенно чувствительны к третьему пункту. Облачный провайдер может в любой момент ужесточить политику, и фича, которая вчера работала, сегодня перестает отвечать. На локальной модели такого риска нет, поведение зафиксировано в весах, которые лежат у тебя на диске.
Максим: «Мы в VibeCoderz строим продукты так, чтобы не зависеть от чужой инфраструктуры. GoBanana изначально делали под российский рынок: без VPN, без зарубежных карт, платишь сколько нужно. Тот же принцип работает и с локальными моделями, ты не зависишь от того, что облачный сервис решит завтра запретить».
Кстати, этот же принцип независимости объясняет, почему интерес к локальному запуску моделей вообще растет. Чем больше продукт завязан на внешний API с меняющейся политикой, тем выше риск для бизнеса.
Uncensored-модель отвечает буквально на все?
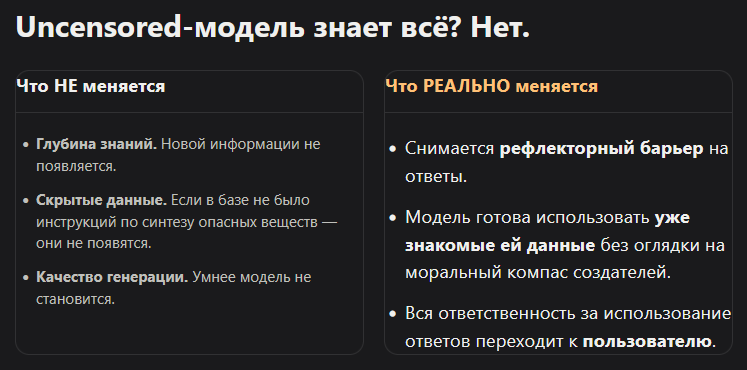
Нет. Снятие рефлекторных отказов не добавляет модели новых знаний, которых не было изначально, оно меняет только готовность отвечать по уже существующим знаниям базовой модели.
Вот здесь важна честная оговорка, без нее статья была бы неполной. Качество и глубина знаний модели остаются теми же, что были у базовой версии до дообучения. Если базовая модель никогда не видела в обучающих данных достоверной информации о синтезе опасных веществ, оружия или других категориях реального вреда, uncensored-дообучение не создаст эти знания из воздуха. Оно снимает рефлекторный барьер, а не открывает новый источник данных.
Дополнительно abliteration не гарантирует стопроцентного результата: направление отказа диффузно, поэтому даже правильно проведенная процедура не означает, что модель никогда не откажет ни при каких условиях. На практике часть рефлекторных отказов может частично сохраняться, особенно на редких формулировках, которых не было в обучающем датасете для снятия отказа.
Ответственность за то, как используется полученная информация, лежит полностью на человеке, который запускает такую модель локально на своем железе. Это не техническая деталь, а прямое следствие того, что происходит: снимается фильтр реакции, а не появляется новый источник знаний или инструкций.
Как это связано с форматом GGUF?
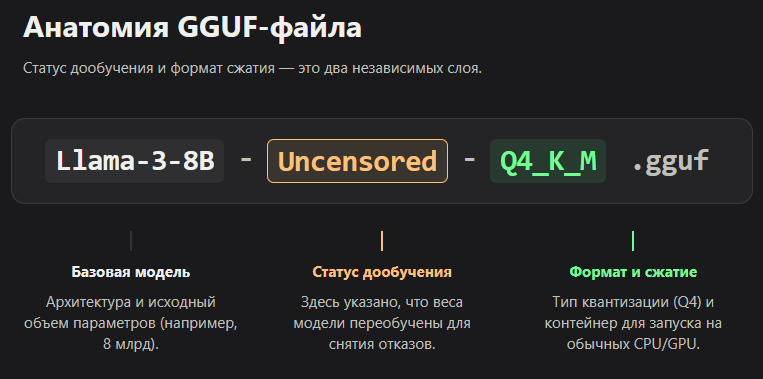
GGUF - это формат хранения весов для локального инференса, он не имеет отношения к тому, прошла модель uncensored-дообучение или нет. Формат просто определяет, как быстро и на каком железе модель запустится.
GGUF описывает квантизацию и упаковку весов под движки вроде llama.cpp, чтобы модель поместилась в оперативную память обычного компьютера, а не датацентра. Uncensored-статус модели закладывается на этапе дообучения, задолго до конвертации в GGUF. Одну и ту же базовую модель можно квантовать в GGUF как в обычном виде, так и после дообучения без рефлекторных отказов, формат от этого не меняется.
Именно поэтому в названиях на Hugging Face часто встречается связка вида "модель-uncensored-Q4_K_M.gguf": первая часть названия про то, как модель обучена, вторая про то, как она упакована для локального запуска. Это два независимых слоя, и путать их не стоит.
Стоит ли разбираться в этой теме, если вы делаете продукт на локальных моделях
Если продукт строится на локальном инференсе, разница между alignment и uncensored-дообучением напрямую влияет на выбор базовой модели и на ответственность за то, что она выдает пользователю.
Для вайбкодера, который собирает продукт поверх открытой модели, разница практична, а не теоретическая. Модель со стандартным alignment безопаснее по умолчанию, но может ложно отказывать в легитимных сценариях продукта, например в чат-боте техподдержки, который иногда обсуждает деликатные темы клиента. Модель без рефлекторных отказов гибче, но ответственность за модерацию выхода целиком переходит на разработчика продукта.
На практике многие команды выбирают средний путь: берут модель с ослабленным, но не полностью снятым alignment, и добавляют свой слой модерации поверх выхода модели уже на уровне продукта. Это дает контроль без зависимости от чужих решений о том, где проходит граница дозволенного.
Часто задаваемые вопросы
Uncensored означает, что модель отвечает вообще на любой запрос?
Нет, это означает снижение рефлекторных отказов по паттерну. Знания модели остаются теми же, что у базовой версии, глубина ответа на реально опасные темы не увеличивается.
Это то же самое, что снять системный промпт с ограничениями?
Нет. Системный промпт можно поменять на лету, он не трогает веса модели. Uncensored-дообучение меняет сами веса на этапе подготовки модели, до того как она попадет к пользователю.
Можно ли вернуть отказы обратно после uncensored-дообучения?
Технически да, если делать дообучение заново с обратным датасетом, но обычно проще взять исходную выровненную версию модели, чем пытаться восстановить снятое поведение.
Uncensored-модель работает хуже по качеству ответов?
Зависит от качества самого дообучения. При аккуратной работе с датасетом остальные способности модели затрагиваются минимально, но грубое дообучение может просадить качество на несвязанных задачах.
Почему в облачных сервисах вроде Claude или ChatGPT нельзя получить uncensored-версию?
Потому что дообучение весов делают локально на файле модели, у пользователя облачного API нет доступа к весам, только к API поверх зафиксированной версии модели с ее alignment.
GGUF-версия и uncensored-версия это разные файлы одной модели?
Обычно да. Сначала кто-то проводит дообучение без рефлекторных отказов на полной модели, затем отдельно конвертирует результат в GGUF под конкретный размер квантизации.
Законно ли скачивать и запускать такие модели?
Сам факт локального запуска модели без рефлекторных отказов не является чем-то запрещенным в большинстве юрисдикций, ответственность возникает за конкретные действия с полученной информацией, а не за наличие модели на диске.
Разобраться в архитектуре стека для локального запуска моделей поможет статья про локальный AI стек для вайбкодинга. Полный каталог AI-инструментов и IDE для вайбкодинга собран в каталоге на VibeCoderz. Если нужна консультация по выбору стека под конкретный продукт, запишитесь на консультацию к Максиму.
Обновлено: октябрь 2026.