
Helicone — это прокси-сервис для наблюдаемости LLM-запросов: он встает между вашим приложением и OpenAI, Anthropic, Google или Azure, логирует каждый вызов и показывает его стоимость. Подключение не требует SDK и переписывания кода: меняется одна строка — base URL клиента. Ниже разберем архитектуру, пошаговую интеграцию с n8n и Make.com, что показывает дашборд из коробки и честное ограничение, о котором стоит знать до старта.
Helicone — прокси-инструмент для наблюдаемости LLM: подключается через заголовок авторизации без SDK, логирует стоимость и латентность каждого запроса. В статье: архитектура, интеграция с n8n и Make.com, разбор дашборда, сравнение с Langfuse и честный список ограничений.
Что такое Helicone и как он работает?
Helicone — прокси-сервер между вашим приложением и провайдером LLM: запрос идет не напрямую в OpenAI, а через Helicone, который пересылает его дальше и параллельно логирует.
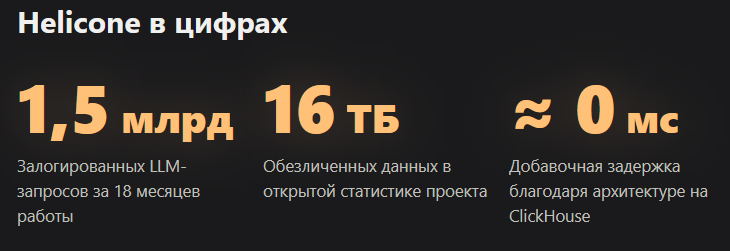
Helicone построен на ClickHouse и обрабатывает миллиарды запросов с ответом за миллисекунды, а команда сервиса за 18 месяцев работы залогировала 1,5 миллиарда LLM-запросов — это 16 терабайт обезличенных данных, доступных публично в открытой статистике проекта.
Идея простая: вместо прямого вызова api.openai.com приложение стучится в oai.helicone.ai, добавив заголовок с ключом Helicone. Прокси прозрачно пересылает запрос настоящему провайдеру, а на обратном пути записывает всё, что через него прошло: промпт, ответ, токены, стоимость, задержку. Никакой обертки вызовов, никакого SDK — меняется только адрес.
За счет такой схемы Helicone одинаково легко подключается и к Python-бэкенду, и к no-code инструментам вроде n8n или Make.com, где нативных SDK для трассировки попросту нет. Об этом — в следующем разделе.
Чем Helicone отличается от Langfuse и LangSmith?
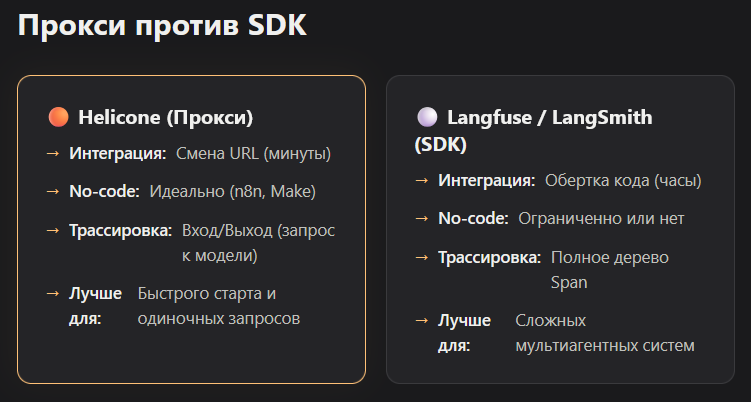
Langfuse и LangSmith требуют интеграции через свой SDK с оборачиванием каждого вызова модели в декораторы. Helicone работает как прокси: меняется base URL, код вызовов не трогается вообще.
Разница архитектурная, а не косметическая: SDK-подход даёт более глубокое дерево вложенных трассировок (span), прокси-подход — минимальное время до первого результата, буквально несколько минут даже в большом legacy-проекте.
Для команды, которая пишет собственный бэкенд на Python или TypeScript и строит сложного мультиагентного бота с десятками вложенных шагов, SDK Langfuse даст более полную картину: видно, какой именно под-агент вызвал какой инструмент и на каком шаге пайплайна что пошло не так. Для проекта попроще, где вызовы модели преимущественно одиночные, а не вложенная цепочка, разница почти не ощущается — зато время подключения отличается кардинально.
| Критерий | Helicone | Langfuse | LangSmith |
|---|---|---|---|
| Способ подключения | Прокси, смена base URL | SDK, обертка вызовов | SDK, обертка вызовов |
| Время на первую интеграцию | Минуты | Часы | Часы |
| Глубина трассировки | Запрос-ответ | Полное дерево span | Полное дерево span |
| Подходит для no-code (n8n, Make) | Да, через HTTP-запрос | Ограниченно | Ограниченно |
| Self-hosted опция | Да, Apache-2.0 | Да | Нет |
Разница в глубине трассировки — не недостаток, а следствие выбранной архитектуры, и об этом честно стоит сказать заранее, чем разочароваться после подключения.
Как подключить Helicone к n8n и Make.com?
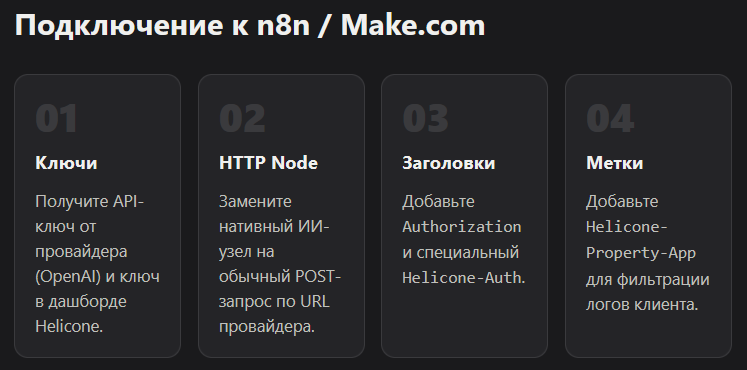
В n8n и Make.com нативных узлов для LLM-провайдеров с поддержкой Helicone нет, поэтому вызов модели делается через обычный HTTP-запрос с дополнительными заголовками Helicone.
Разработчик, который тестировал связку на реальном воркфлоу, отмечал: подключение занимает те же пару минут, что и в коде, разница только в том, что вместо строки конфигурации редактируются поля HTTP-модуля.
Порядок действий одинаковый что в n8n, что в Make.com:
- Получите два ключа: свой ключ провайдера (например, OpenAI) и API-ключ Helicone из настроек организации.
- Добавьте HTTP-модуль вместо нативного узла ChatGPT или Claude — прямой вызов через ноду провайдера прокси не подхватит.
- Укажите URL по формату провайдера (для OpenAI это
/v1/chat/completions), метод POST. - В заголовках передайте
Authorization: Bearer <ключ провайдера>,Content-Type: application/json,Helicone-Auth: Bearer <ключ Helicone>иHelicone-Cache-Enabled: trueдля кэширования повторяющихся запросов. - Добавьте заголовок
Helicone-Property-Appсо значением-меткой — по нему в дашборде фильтруются запросы конкретного клиента или воркфлоу. - В теле запроса передайте JSON с моделью, системным промптом и сообщением пользователя — как в обычном вызове API.
Ключи из соображений безопасности лучше хранить не в самом теле запроса, а в generic credential с типом Header Auth — тогда при экспорте воркфлоу секрет не утечет в открытом виде.
Что показывает дашборд Helicone из коробки?
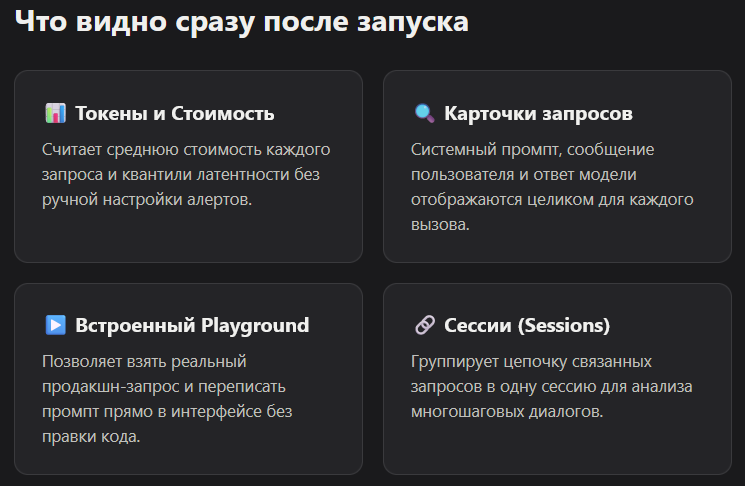
Сразу после подключения Helicone открывает дашборд с топ-моделями, количеством токенов, средней стоимостью запроса и задержкой — без дополнительной настройки.
Дашборд построен на ClickHouse и держит квантили латентности, стоимость по времени, число уникальных пользователей и количество обнаруженных угроз безопасности — все метрики доступны из коробки, без ручной настройки алертов.
Каждый залогированный запрос открывается как отдельная карточка: виден системный промпт, сообщение пользователя и ответ модели целиком. Есть Playground прямо внутри дашборда — можно взять реальный продакшн-запрос, поменять формулировку промпта и сразу увидеть новый ответ, не трогая код приложения. Отдельно работает функция Sessions: она группирует цепочку связанных запросов в одну сессию, что критично для AI-агентов, где один пользовательский запрос превращается в десяток вызовов модели подряд.
Для сервисов по модели «сделано под ключ» это дает практический бонус: можно посмотреть, как конкретный клиент использует приложение, и подсказать ему, что промпт слишком общий и стоит его углубить — без доступа к его переписке с моделью напрямую, только по метаданным тега.
Максим: «У Нейроскрайба ждали от разработчика неделю-две-три. У Нейроштата целая команда работала — ждали целую фичу месяцами. Получили — и разочаровались, потому что время реализации критично.»
Именно поэтому связка «прокси вместо SDK» экономит не только время разработчика, но и нервы: наблюдаемость нужна в моменте, а не через три недели спринта.
Сколько стоит Helicone и есть ли бесплатный тариф?
Helicone открытый по лицензии Apache-2.0 и бесплатен для личного использования, self-hosted версию можно развернуть самостоятельно. Платные облачные тарифы стартуют в диапазоне $20–200 в месяц в зависимости от объема запросов.
По данным каталога AlternativeTo, Helicone распространяется по открытой лицензии Apache-2.0 и бесплатен для личного использования, а платная облачная подписка находится в диапазоне примерно от 20 до 200 долларов в месяц в зависимости от объема. Сама команда сервиса на релизе описывала базовый функционал так: логирование всех запросов к провайдеру в удобном UI, кэширование, кастомные лимиты и повторные попытки, а каждый залогированный запрос доступен как отдельный плейграунд для итерации промптов.
Для небольшого проекта или личного пет-проекта бесплатного тарифа и self-hosted варианта чаще всего достаточно. Команде с продакшн-нагрузкой в тысячи запросов в день имеет смысл сразу смотреть облачный платный план — цена привязана к объему логов, а не к числу пользователей дашборда.
Какие ограничения у Helicone стоит учитывать?
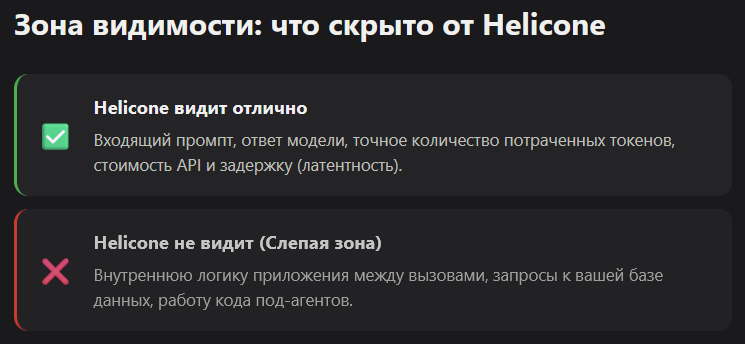
Прокси-архитектура не строит полное дерево вложенных трассировок с иерархией span, как это делает Langfuse — для сложного мультиагентного пайплайна такой детализации может не хватить.
Это честное ограничение, а не недоработка: Helicone видит вызов модели на входе и выходе, но не видит внутреннюю логику приложения между вызовами. Если агент дергает модель пять раз подряд с промежуточной обработкой между вызовами, Sessions покажет всю цепочку, но не покажет, что происходило в коде между шагами.
Для приложения с преимущественно одиночными вызовами модели — чат-бот, генератор текста, суммаризатор — этого более чем достаточно. Для сложного мультиагентного пайплайна с вложенными под-агентами и условной логикой более структурированную картину даст подход Langfuse с его деревом span. Разумный вариант — начать с Helicone из-за скорости подключения, а к SDK-инструменту перейти, когда пайплайн реально усложнится.
Кому подходит Helicone больше всего?
Helicone лучше всего подходит командам, которым нужна видимость стоимости и логов LLM-запросов быстро и без переписывания кода: фрилансерам на n8n/Make, small-командам и стартапам с несложным пайплайном вызовов.
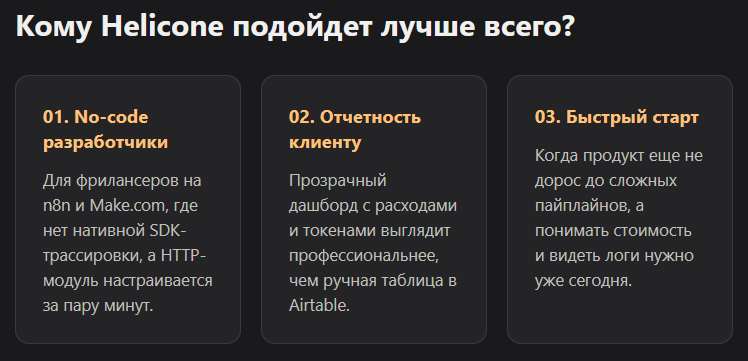
Три сценария, где прокси-подход выигрывает у SDK-интеграции:
- No-code автоматизация. В n8n и Make.com нет нативной SDK-трассировки, а HTTP-модуль с парой дополнительных заголовков подключается за минуты.
- Отчетность перед клиентом. Дашборд с графиками стоимости и топ-моделей выглядит профессиональнее, чем таблица токенов в Airtable, когда нужно показать клиенту расход на LLM.
- Быстрый старт без архитектурных решений. Когда проект еще не дорос до сложного мультиагентного пайплайна, лишняя сложность SDK-трассировки не окупается — а прокси уже сегодня показывает цифры.
Если задача — оптимизировать сами расходы на модель, а не только увидеть их, у портала есть отдельный разбор про оптимизацию стоимости AI-вызовов через роутинг и кэш — Helicone дает данные, а решение о роутинге и кэшировании принимается уже на их основе.
Частые вопросы про Helicone
Нужно ли менять код приложения для подключения Helicone?
Нет, для большинства случаев достаточно поменять base URL клиента на адрес прокси Helicone и добавить заголовок авторизации. Логика вызовов модели остается прежней.
Работает ли Helicone с Claude и Gemini, а не только с OpenAI?
Да, прокси поддерживает OpenAI, Anthropic Claude, Azure OpenAI и Google Gemini — маршрут строится под конкретного провайдера через соответствующий URL.
Можно ли использовать Helicone бесплатно?
Да, есть открытая self-hosted версия под лицензией Apache-2.0 и бесплатный тариф для личного использования. Платные облачные планы нужны при продакшн-нагрузке.
Чем Helicone отличается от простого логирования токенов в Airtable?
Airtable покажет только цифры, которые вы сами туда занесли. Helicone логирует каждый запрос и ответ автоматически, считает стоимость и латентность и строит дашборд без ручной работы.
Подходит ли Helicone для мультиагентных пайплайнов?
Частично. Функция Sessions группирует связанные запросы агента в одну цепочку, но полного дерева вложенных span, как у Langfuse, прокси-архитектура не строит.
Нужен ли отдельный API-ключ Helicone, если уже есть ключ OpenAI?
Да, потребуются оба ключа: ключ провайдера передается в заголовке авторизации, а ключ Helicone — в отдельном заголовке Helicone-Auth.
Как включить кэширование повторяющихся запросов?
Достаточно добавить заголовок Helicone-Cache-Enabled: true — кэш работает на уровне прокси, реализовывать его в коде приложения не нужно.
Helicone решает конкретную задачу: увидеть, сколько стоят LLM-вызовы и что в них происходит, без недели на интеграцию SDK. Если задача шире — построить полноценную многошаговую трассировку агента — стоит сразу смотреть в сторону Langfuse или разобраться, что такое observability для LLM и зачем нужна трассировка, в целом.
Больше разборов инструментов для вайбкодинга — в каталоге AI-инструментов VibeCoderz. Если нужна помощь с выбором стека под конкретный продукт, запишитесь на консультацию к Максиму.
Обновлено: октябрь 2026.