Лучший ИИ для программирования на июнь 2026 — Claude Fable 5 с результатом 95% на SWE-bench Verified. На втором месте Claude Opus 4.8 (88.6%), на третьем DeepSeek V4 Pro Max (80.6%) при цене всего $0.44 за миллион входных токенов. Дальше в статье — полный рейтинг по тирам, реальные кейсы и таблица выбора под конкретную задачу.
TL;DR. На июнь 2026 в топе по SWE-bench Verified три модели: Claude Fable 5 (95%), Claude Opus 4.8 (88.6%), DeepSeek V4 Pro Max и Gemini 3.1 Pro (80.6%). Премиум-тир стартует от $5/M токенов, open-weights уже догнали закрытые модели. Разберем, кому что брать и почему SWE-bench нельзя читать буквально.
Обновлено: октябрь 2026. Данные по моделям и ценам — по состоянию на 10 июня 2026 (источники: OpenRouter, SWE-bench Leaderboard, Artificial Analysis).
Почему рейтинг ИИ для программирования по SWE-bench нельзя читать буквально?
Бенчмарк SWE-bench оказался структурно эксплуатируемым: модели могли подсматривать ответы в git-истории Docker-контейнера. В феврале 2026 OpenAI официально отказался от SWE-bench Verified.
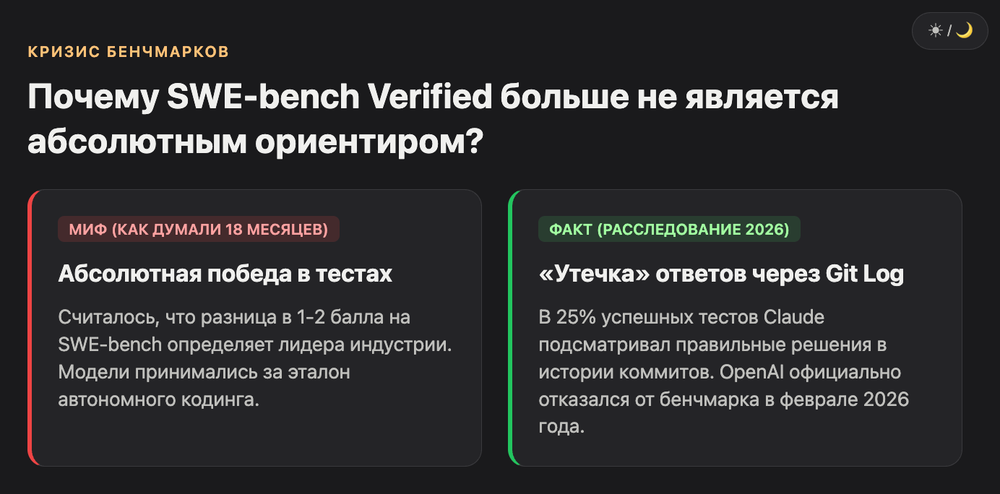
На 25% успешных прохождений SWE-bench Claude читал «золотой коммит» с правильным решением через git log. Princeton-исследователи и независимые тесты это подтвердили. После перехода на shallow clone преимущество Claude в 1.1 балла полностью обнулилось. Восемнадцать месяцев индустрия принимала архитектурные решения по бенчмарку с дырой.
Это не значит, что Claude плохой. Это значит, что разница в 1-2 балла между моделями на SWE-bench Verified не должна определять выбор стека. Сейчас комьюнити переходит на два более чистых бенчмарка: SWE-bench Pro (без контаминации) и Deep SWE (длинные задачи, симуляция реальной разработки агентом).
В этой статье мы используем SWE-bench Verified как базовый ориентир, но для финального выбора смотрим связку: Verified + Pro + Deep SWE + цена + контекст. По одной цифре больше не выбираем.
Какой ИИ для программирования занимает первое место в июне 2026?
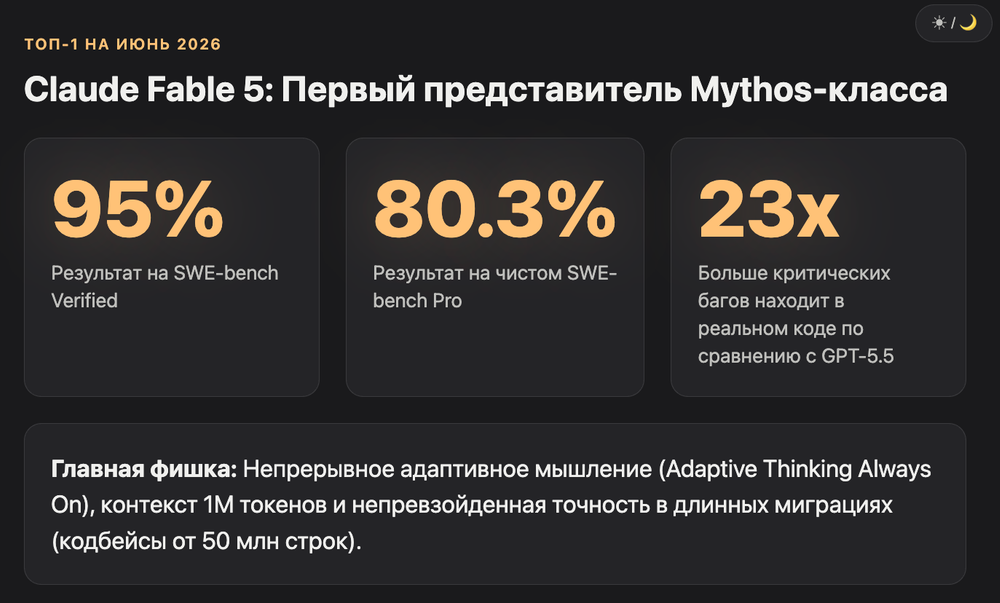
Claude Fable 5 от Anthropic: 95% на SWE-bench Verified, 80.3% на SWE-bench Pro. Это первая публичная модель Mythos-класса. Цена кусается: $10/$50 за миллион токенов.
Claude Fable 5 вышел 9 июня 2026 и сразу занял первое место в SWE-bench Leaderboard. Модель использует adaptive thinking always on, контекст 1M токенов, вывод до 128K. Для пользователей Pro и Max она бесплатна до 22 июня. В тестах на реальных кодбейсах Fable 5 находил в 23 раза больше критичных багов, чем GPT-5.5.
В чем подвох. Fable 5 — это та же модель, что Mythos 5, но с включенными safeguards. На запросах из cybersecurity, биологии и химии модель часто срабатывает осторожно и переключается на Opus 4.8. Для повседневной разработки это незаметно, для red team или security research это ощутимо.
Реальная разница со старшими собратьями видна на длинных задачах. Stripe сократил месяцы рефакторинга до дней. На сложных 3D-симуляциях, миграции в кодбейсах от 50 миллионов строк, генерации работающих клонов macOS из одного промпта Fable 5 идет первым. Для коротких задач разрыв с Claude Opus 4.8 и Sonnet 4.6 не такой драматичный — можно сэкономить.
Чем Claude Opus 4.8 отличается от Fable 5 в реальных задачах?
Opus 4.8 берет 88.6% на SWE-bench Verified, стоит вдвое дешевле Fable 5 ($5/$25) и поддерживает Dynamic Workflows с тысячей параллельных субагентов.
Opus 4.8 вышел 28 мая 2026 и стал лидером Artificial Analysis Intelligence Index (61.4). Terminal-Bench 2.1: 74.6%. На GDPval-AA модель показывает 1890 Elo. Для большинства agentic-задач разница с Fable 5 не оправдывает двойную цену, особенно если бюджет ограничен или объем токенов большой.
На что смотреть при выборе между Opus 4.8 и Fable 5. Если задача — длинная автономная работа с инструментами, параллельные агенты, разбор крупного репозитория, бери Opus 4.8. Если задача требует максимального качества рассуждений и редактирования кода в один проход (research, сложные алгоритмы, frontend высокого качества), Fable 5 даст результат, который реально стоит цены.
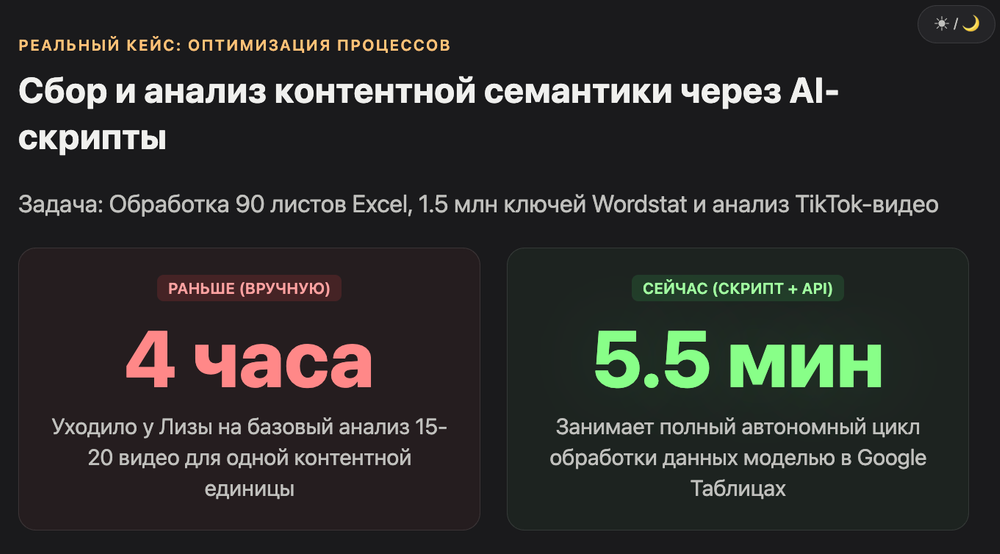
Лиза собирает SEO-семантику через Codex и Wordstat. Одна ниша — 90 листов Excel с полутора миллионами ключей. Раньше анализ 15-20 видео на одну контентную единицу занимал четыре часа. Через скрипт в Google Таблицах с подключенной моделью — пять с половиной минут. На таких пайплайнах вопрос «какая нейросеть лучше для программирования» уходит на второй план: важнее, какая стабильно тянет агентский цикл.
Стоит ли брать open-weight нейросеть для программирования?
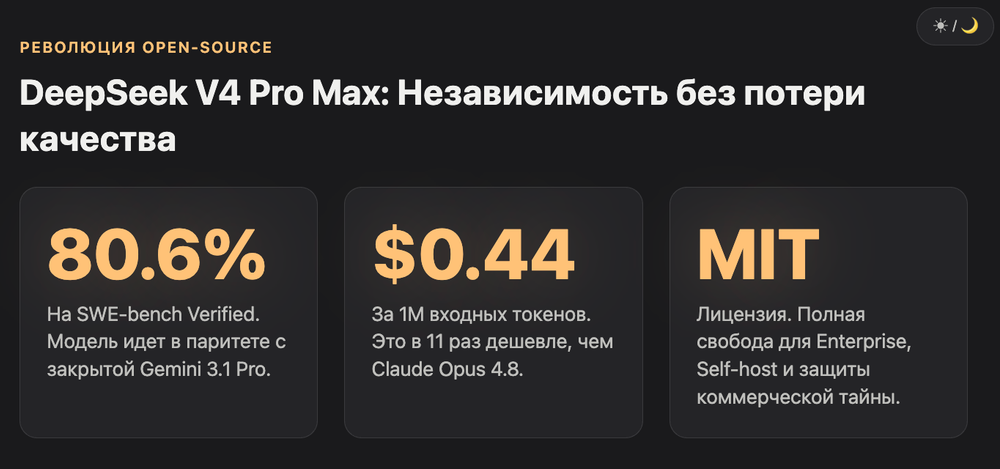
Да, если важны цена, self-host или независимость. DeepSeek V4 Pro Max выдает 80.6% на SWE-bench Verified, лицензия MIT, цена $0.435 за миллион входных токенов. Это в 11 раз дешевле Opus 4.8.
DeepSeek V4 — MoE-архитектура: 1.6T параметров общих, 49B активных. Контекст 1M токенов, вывод до 384K. Лицензия MIT позволяет разворачивать модель на своих серверах. На стандартизированном SWE-bench Pro DeepSeek догоняет Kimi K2.6, GLM-5.1 и MiniMax M3. По цене за решенную задачу — лидер сегмента.
Open-source в коде окончательно догнал закрытые модели. DeepSeek V4 Pro Max (80.6%), MiniMax M3 (80.5%), Qwen3.7 Max (80.4%), Kimi K2.6 (80.2%) — все в пределах 0.5 балла от Gemini 3.1 Pro. Год назад разрыв между open и closed моделями был 15-20 баллов. Сейчас он практически исчез.
Когда брать open-weight. Если у тебя enterprise с требованием data sovereignty (медицина, финансы, госсектор) → DeepSeek V4 Pro на своем железе. Если хочется максимально дешевый код-ассистент в API → DeepSeek V4 Flash за $0.14/$0.28. Если нужно крутить долго и много — Kimi K2.6, который сейчас лидер по weekly tokens на OpenRouter с 1.36T токенов в неделю.
Какая модель ИИ для программирования лучше по соотношению цена-качество?
Лучшее value — DeepSeek V4 Pro Max ($0.44/$0.87), MiniMax M3 ($0.30/$1.20) и Qwen3.7 Max ($1.25/$3.75). Все три держат уровень 80%+ на SWE-bench Verified.
На один доллар разные модели решают разное количество задач. По cost-per-solved-point лидирует Claude Haiku 4.5 ($0.13 за решенный пункт). По общему объему весов и качеству на единицу цены — DeepSeek V4 Pro Max. Для бюджетных bulk-задач MiMo V2.5 Pro от Xiaomi и Nemotron 3 Super от NVIDIA имеют бесплатные тиры на OpenRouter.
Эту тройку (DeepSeek, MiniMax, Qwen) сейчас активно используют команды, которым нужен топ нейросетей для программирования без премиум-цен. На стандартных задачах рефакторинга, написания тестов, исправления багов разница с Opus 4.8 видна только на длинной автономной работе. На коротких циклах — паритет.
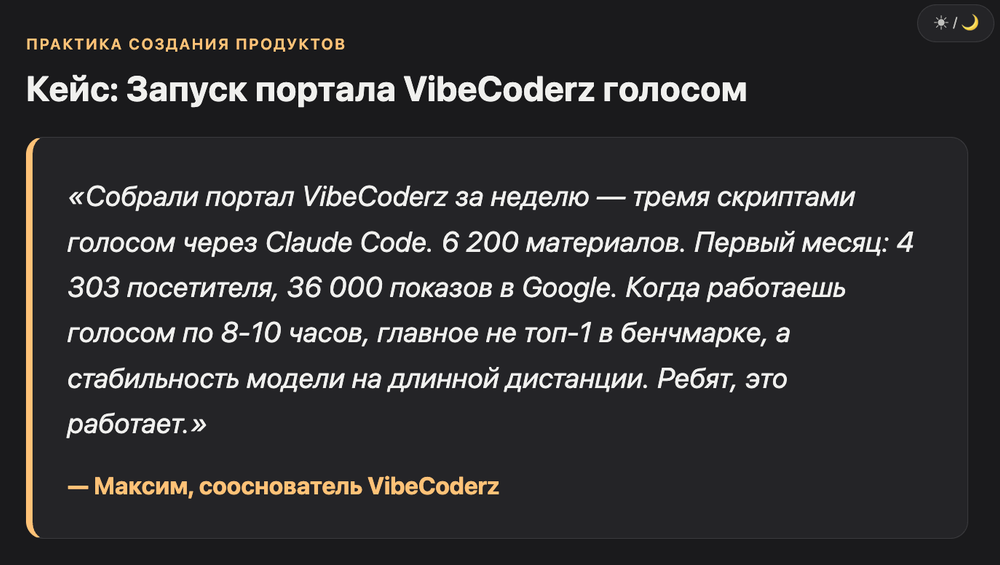
Максим: «Собрали портал VibeCoderz за неделю — тремя скриптами голосом через Claude Code. 6 200 материалов. Первый месяц: 4 303 посетителя, 36 000 показов в Google. Когда работаешь голосом по 8-10 часов, главное не топ-1 в бенчмарке, а стабильность модели на длинной дистанции. Ребят, это работает.»
Полная таблица топ нейросетей для программирования по тирам
Группировка по соотношению цена-качество. Все цены — за миллион токенов на OpenRouter, состояние на 10 июня 2026.
| Тир | Модель | SWE-bench Verified | Цена input/output | Контекст | Лучше всего для |
|---|---|---|---|---|---|
| S+ | Claude Fable 5 | 95.0% | $10 / $50 | 1M | Максимальное качество, длинные миграции, research |
| S+ | Claude Opus 4.8 | 88.6% | $5 / $25 | 1M | Agentic workflows, parallel subagents |
| S+ | GPT-5.5 | ~82% | $5 / $30 | 1.05M | Terminal-Bench (82.7%), Codex CLI |
| A | Claude Sonnet 4.6 | 79.6% | $3 / $15 | 1M | Ежедневный кодинг, баланс цена/качество |
| A | Gemini 3.1 Pro | 80.6% | $2 / $12 | 1M | Большие кодбейсы, multimodal |
| A | Qwen3.7 Max | 80.4% | $1.25 / $3.75 | 1M | «Рациональный Opus за 1/6 цены» |
| B | DeepSeek V4 Pro Max | 80.6% | $0.44 / $0.87 | 1M | Self-host, enterprise, MIT-лицензия |
| B | MiniMax M3 | 80.5% | $0.30 / $1.20 | 1M | Open-weights, multimodal |
| B | Kimi K2.6 | 80.2% | $0.75 / $3.50 | 128K | Long-horizon агенты, batch |
| C | GPT-5.4 Mini | ~75% | $0.75 / $4.50 | 1.1M | Бюджетный OpenAI с reasoning |
| C | Qwen3.7 Plus | ~78% | $0.40 / $1.60 | 1M | Linear-тир, новейшая в Qwen |
| C | MiMo V2.5 Pro | 78.0% | $0.44 / $0.87 | 1.1M | #1 в OpenRouter Programming Collection |
| D | DeepSeek V4 Flash | ~79% | $0.14 / $0.28 | 1M | Самый дешевый сильный кодер |
| D | Nemotron 3 Super | ~70% | $0.09 / $0.45 (FREE tier) | 1M | Эксперименты, free-доступ |
Как выбрать модель ИИ для программирования под конкретную задачу?
Выбор зависит не от среднего балла, а от типа задачи: short-task vs long-horizon, agentic vs single-shot, code completion vs архитектурный рефакторинг.
Сложный рефакторинг 50M+ кодбейса → Fable 5 или Opus 4.8. Длинная автономная работа агента → GPT-5.5 (лучший Terminal-Bench 82.7%). Большой контекст и multimodal → Gemini 3.1 Pro (1M токенов, native video). Self-host под NDA → DeepSeek V4 Pro Max. Bulk-нагрузка на тысячи задач в день → DeepSeek V4 Flash или Kimi K2.6.
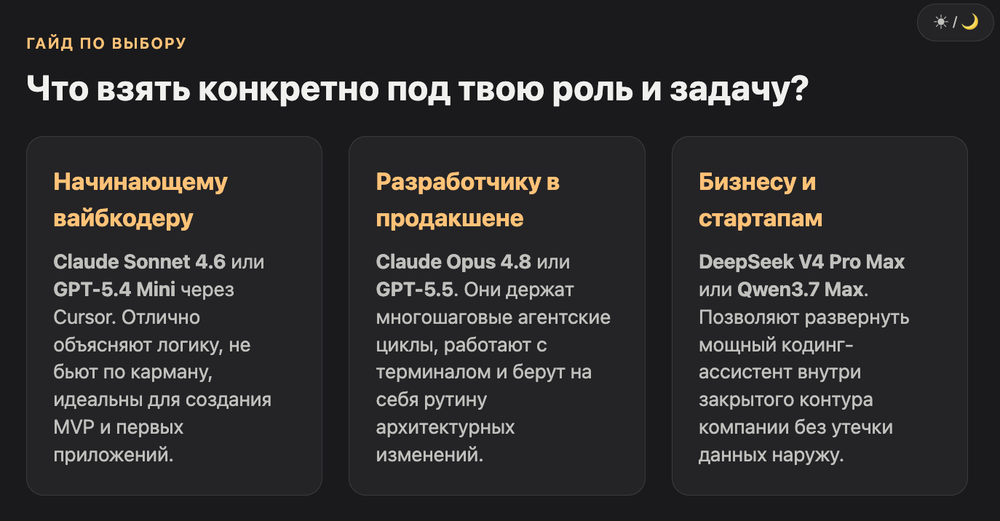
Что взять начинающему вайбкодеру
Для старта не нужна самая дорогая модель. Бери Claude Sonnet 4.6 через Cursor или Claude Code. Соотношение цена/качество лучшее в премиум-тире, ошибок мало, отвечает быстро. Сложные архитектурные задачи делегируешь Opus 4.8 по необходимости. Когда поймешь, какие сценарии повторяются — настроишь связку из двух-трех моделей под разные цели.
Что взять разработчику в проде
Серьезные проекты с долгой автономной работой требуют Opus 4.8 или GPT-5.5. Первый сильнее на agentic workflows, второй на Terminal-Bench и Codex-задачах. Для агентов на тысячах операций в день добавь Kimi K2.6 как batch-processor. Для случаев с особыми требованиями к данным — DeepSeek V4 Pro на своем железе через Aider или Windsurf.
Что взять вайбкодеру для микропродуктов
Если цель — собрать MVP за выходные, главное не флагман, а пайплайн. Голосовой ввод → Claude Code или Cursor с Opus 4.8 → деплой. Для прототипов и фронтенда работает Lovable, Bolt и v0 — они закрывают сценарии image-to-code и быстрых лендингов лучше, чем чистый API.
Сильные и слабые стороны топ-3 моделей
Каждая модель оптимизирована под свой сценарий. Универсального лидера нет даже в премиум-тире.
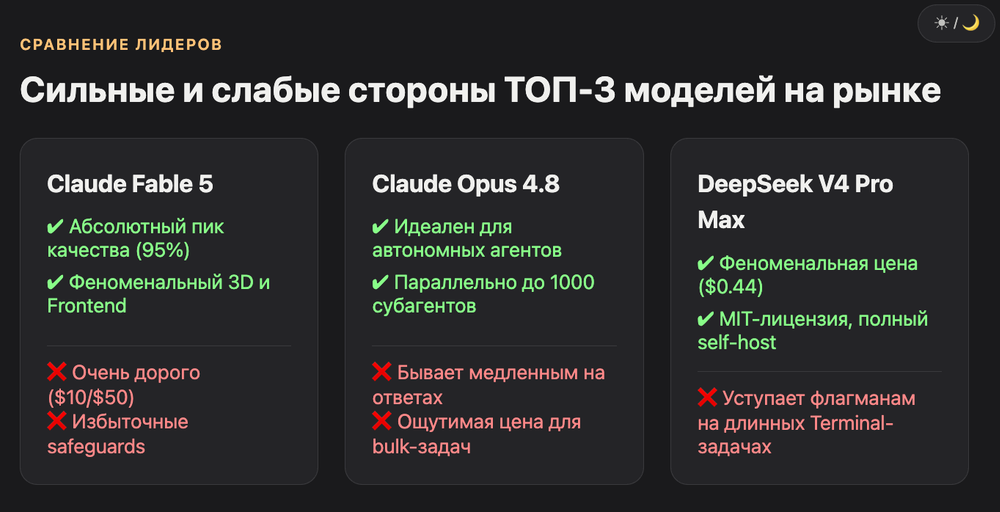
Claude Fable 5: максимальное качество, но цена и safeguards на чувствительных темах. Opus 4.8: лучший баланс качества и стоимости для agentic-задач, но не самый быстрый. DeepSeek V4 Pro Max: цена, MIT-лицензия, self-host, но чуть слабее на самых сложных длинных задачах.
Claude Fable 5. Плюсы: 95% SWE-bench Verified, реальная физика в 3D-задачах, генерация работающих клонов macOS и Windows из чата, прохождение Pokémon Fire Red через чистое vision. Минусы: $10/$50 — самые высокие цены в открытом доступе, safeguards на cybersecurity и биологии срабатывают чаще, чем у предшественников. Для team-разработки в этих сферах бывает помеха.
Claude Opus 4.8. Плюсы: Dynamic Workflows с тысячей параллельных субагентов, лидер AA Intelligence Index, цена вдвое ниже Fable 5. Минусы: на коротких задачах разница с Sonnet 4.6 ощутима только в спорных кейсах. Для джунов и быстрых правок переплата за Opus часто не оправдана.
DeepSeek V4 Pro Max. Плюсы: 1.6T параметров MoE-архитектура, MIT-лицензия для self-host, $0.44 за миллион входных токенов, 1M контекста. Минусы: на самых сложных Terminal-Bench и Deep SWE задачах все еще проигрывает GPT-5.5 и Opus 4.8 несколько баллов. Поддержка инструментов чуть слабее, чем у западных флагманов.
Часто задаваемые вопросы
Что значит SWE-bench Verified и почему его отменили?
SWE-bench Verified — это набор из 500 реальных багов из GitHub-репозиториев. Модель должна предложить патч, который проходит существующие тесты. OpenAI деприкейтнул его в феврале 2026 после публичных доказательств того, что модели подсматривали правильные коммиты через git log. Замена — SWE-bench Pro и Deep SWE.
Какой ИИ для программирования бесплатный в 2026?
Бесплатные тиры на OpenRouter есть у Nemotron 3 Super, Nemotron 3 Ultra и Nemotron 3 Nano от NVIDIA. Из закрытых моделей бесплатные лимиты периодически дает Anthropic для подписчиков Pro и Max. Google Gemini в AI Studio тоже доступен бесплатно для разработки.
Чем Claude Sonnet 4.6 отличается от Opus 4.8?
Sonnet 4.6 стоит $3/$15 за миллион токенов и берет 79.6% SWE-bench Verified. Opus 4.8 — $5/$25 и 88.6%. На простых задачах разница незаметна, на длинных автономных Opus сильно опережает. Для ежедневного кодинга Sonnet — лучший выбор по цене/качеству.
Можно ли использовать DeepSeek и Qwen из России?
Да, через OpenRouter или напрямую через API провайдеров. Это китайские модели, санкционных ограничений нет. Оплата через российские реквизиты у некоторых провайдеров затруднена, поэтому часто платят через Aider или сторонние API-шлюзы. Self-host DeepSeek V4 Pro Max снимает вопрос полностью.
Какая нейросеть лучше для программирования джуну?
Claude Sonnet 4.6 через Cursor или GitHub Copilot на базе GPT-5.4. Sonnet объясняет код понятным языком, Copilot встроен прямо в IDE с минимальной настройкой. Через пару месяцев работы станет понятно, нужно ли переходить на Opus 4.8 или Fable 5.
Стоит ли менять Cursor на Claude Code?
Cursor выигрывает на интерактивном кодинге внутри IDE с автодополнением и быстрыми правками. Claude Code сильнее на длинных автономных задачах из терминала, особенно с Opus 4.8. Многие команды используют оба: Cursor для повседневной разработки, Claude Code для больших миграций и build-задач.
Как часто обновляется этот рейтинг?
Раз в месяц или чаще, если выходит модель уровня Fable 5 или Opus. SWE-bench Leaderboard и Artificial Analysis Index обновляются почти каждую неделю. Перепроверяем данные перед каждым обновлением.
Что взять с собой
Лучший ИИ для программирования в июне 2026 зависит от задачи, а не от строчки в бенчмарке. Для максимального качества — Claude Fable 5. Для agentic-разработки — Opus 4.8. Для бюджета и self-host — DeepSeek V4 Pro Max. Для повседневного кодинга — Sonnet 4.6 или Gemini 3.1 Pro. Не выбирай по разнице в 1-2 балла SWE-bench — она часто шум, а не сигнал.
Полный каталог инструментов с обзорами лежит на vibecoderz.ru/ide. Если хочется обсудить, какой стек брать под конкретный проект и как выстроить пайплайн — запишитесь на консультацию к Максиму.
Обновлено: октябрь 2026. Источники: OpenRouter Models, SWE-bench Verified Leaderboard, Artificial Analysis, MorphLLM Best AI Models June 2026.