
Img2img (image-to-image) - режим, в котором нейросеть для генерации изображений по фото берет за основу вашу фотографию, а не пустой холст. Алгоритм сохраняет композицию, позу или черты лица, но перерисовывает стиль, фон и детали под текстовый запрос. Ниже разберем, как работает img2img внутри диффузионной модели, чем он отличается от генерации с нуля и какие сервисы в 2026 году делают аватары и стилизации по фото лучше всего.
Img2img - технология, при которой нейросеть меняет загруженное фото вместо генерации с нуля: сохраняет форму и позу, но заменяет стиль, фон или одежду. Ключевой параметр - denoising strength, сила изменений от 0 до 1. В статье: как это устроено, таблица сервисов на 2026 год и пошаговый гайд по созданию аватара.
Что такое img2img простыми словами?
Img2img - функция нейросети, которая редактирует загруженную фотографию по текстовому описанию, а не рисует картинку из ничего. Работает как продвинутый фоторедактор, только вместо кистей и слоев - слова в промте.
Технология стоит на диффузионных моделях вроде Stable Diffusion, известных с 2022 года. Массовой она стала после выхода Nano Banana Pro от Google в ноябре 2025 года: модель удерживает лицо человека на фото и понимает запросы на обычном русском языке без сложных технических промтов (разбор на sostav.ru).
Представьте, что вы отдаете фотографу не пустой холст, а готовый портрет и просите: позу оставь, куртку замени на смокинг, а фон сделай закатным. Примерно так работает img2img. Нейросеть смотрит на исходник как на подсказку, а не как на чистый лист.
Дальше разберем механику подробнее - какой процесс превращает вашу фотографию в новое изображение.
Как работает img2img технология внутри нейросети?
Нейросеть добавляет к фото контролируемый шум, а затем убирает его заново, ориентируясь на ваш промт. Чем больше шума добавили, тем сильнее итоговая картинка отличается от оригинала.
В основе img2img лежит диффузионная модель: ее обучили превращать случайный шум в изображение. Загруженное фото становится стартовой точкой вместо шума. Параметр denoising strength определяет, сколько шума добавить перед тем как начать перерисовывать - при 0.1 модель почти не трогает фото, при 0.9 создает практически новую картинку.
По факту это управляемая версия того же процесса, что рисует картинки с нуля. Только точка старта - не пустота, а пиксели вашей фотографии. Продвинутые сборки Stable Diffusion добавляют слой ControlNet: он строит карту контуров, глубины или позы с исходника и заставляет модель держаться этой структуры, даже если denoising strength высокий. Такой подход детально разобран в открытых видеогайдах по img2img в Stable Diffusion.
Технически сложно, а на практике - один ползунок. Дальше о том, чем эта механика отличается от привычной генерации с нуля.
Чем img2img отличается от генерации с нуля?
Text2img рисует картинку по описанию с чистого листа, img2img отталкивается от вашего фото. Первый вариант дает больше творческой свободы, второй - точный контроль над композицией и лицом.
Разница простая: в text2img нейросеть видит только текст, в img2img - текст плюс изображение. Из-за этого результат в img2img предсказуемее, но менее оригинальный: модель не сочиняет сцену, а видоизменяет то, что уже есть.
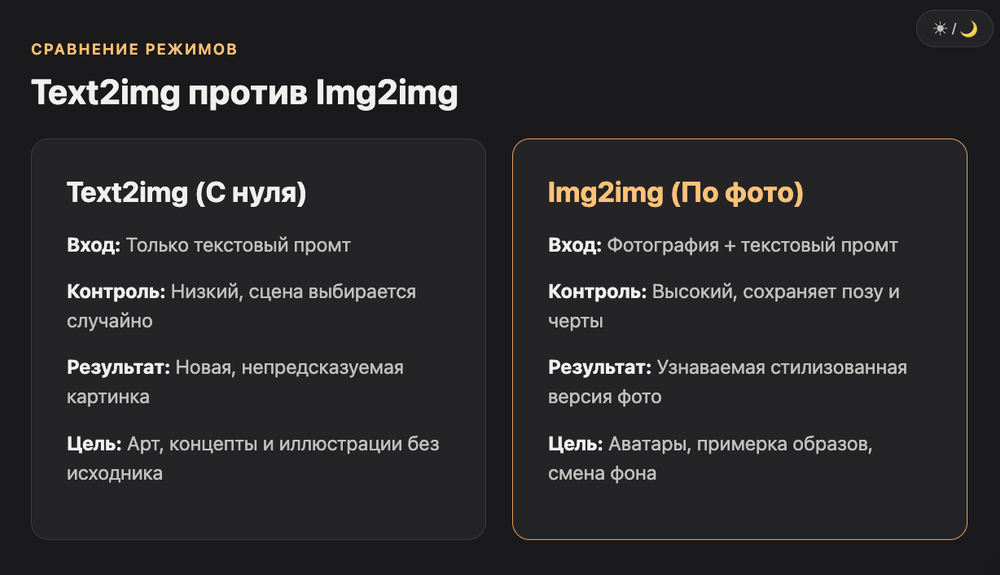
| Параметр | Text2img | Img2img |
|---|---|---|
| Вход | только текстовый промт | фото + текстовый промт |
| Контроль композиции | низкий, во многом случайный | высокий, сохраняет позу и структуру |
| Похожесть на исходник | не применимо | регулируется denoising strength |
| Типичный результат | новая непредсказуемая картинка | узнаваемая версия вашего фото |
| Для чего чаще используют | арт и иллюстрации с нуля | аватары, стилизация, замена деталей |
Для большинства задач с личным фото - аватар, обложка, смена образа - нужен именно img2img. Text2img проще, когда исходника вообще нет.
Для чего нужен img2img - какие задачи он решает?
Img2img закрывает задачи, где важно узнаваемое лицо или конкретная композиция: аватары, замена образа, смена фона, стилизация под жанр. Генерация с нуля этого не гарантирует.
Судя по практике сервисов вроде Crea AI и Playground, три сценария встречаются чаще остальных: персональный аватар, смена стиля фотографии и точечное редактирование одной детали без перерисовки всего кадра.
Конкретные примеры использования:
- Аватар для соцсетей или блога. Загружаете 10-15 своих фото, модель обучается на лице и генерирует вас в новых образах без фотографа.
- Замена лица в сцене. Берете референс из Pinterest или любую позу, накладываете свое лицо через сервис вроде Crea AI.
- Стилизация под жанр. Стимпанк, постапокалипсис, акварель - фон и одежда меняются, лицо остается узнаваемым.
- Локальное редактирование через inpainting. Закрашиваете маской только нужную зону - платье, фон, аксессуар - и просите нейросеть перерисовать именно ее.
- Карта персонажа для видео. Несколько ракурсов одного лица собирают в единый референс, чтобы модель не путала внешность в следующих генерациях.
Маркетологам и авторам контента это особенно полезно: креативы для рекламы, обложки для YouTube и посты в соцсети собираются без фотосессии. Если вы как раз строите такие процессы, посмотрите каталог ИИ-агентов для маркетолога - там есть готовые сценарии под контент-задачи.
Как настроить denoising strength для нужного результата?
Denoising strength - главный ползунок img2img, от 0 до 1. Низкое значение сохраняет фото почти без изменений, высокое - превращает его в новую картинку.
Практика тестов на реальных фото показывает четкую закономерность: результат меняется не линейно, а скачками. На низких значениях модель правит текстуры, на высоких - придумывает заново. Вот ориентир по диапазонам.
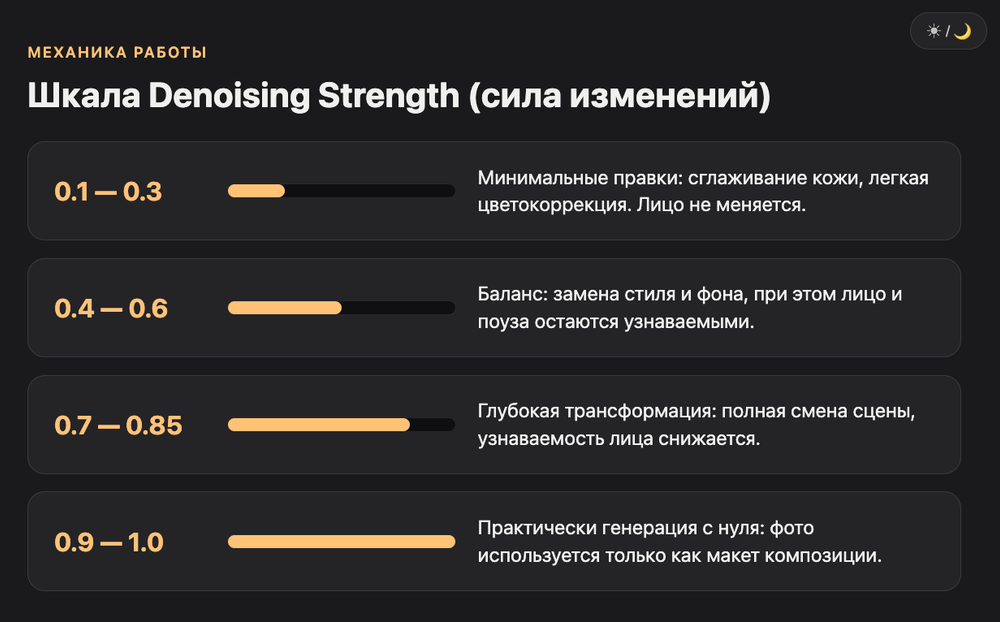
| Denoising strength | Что происходит с фото |
|---|---|
| 0.1-0.3 | Минимальные правки: сглаживание кожи, легкая цветокоррекция, лицо и фон почти не меняются |
| 0.4-0.6 | Заметные изменения стиля, композиция и лицо еще узнаваемы - хороший диапазон для стилизации портрета |
| 0.7-0.85 | Сильная трансформация, узнаваемость снижается, годится для смены сцены целиком |
| 0.9-1.0 | Почти полная генерация заново, фото служит лишь подсказкой по композиции |
Прикинь: чаще всего разочарование от результата связано не с нейросетью, а с одним неверно выставленным ползунком. Для аватара с сохранением лица большинство сервисов держат значение в районе 0.3-0.5, а для полной смены образа поднимают выше 0.7.
Какие нейросети лучше всего справляются с img2img в 2026 году?
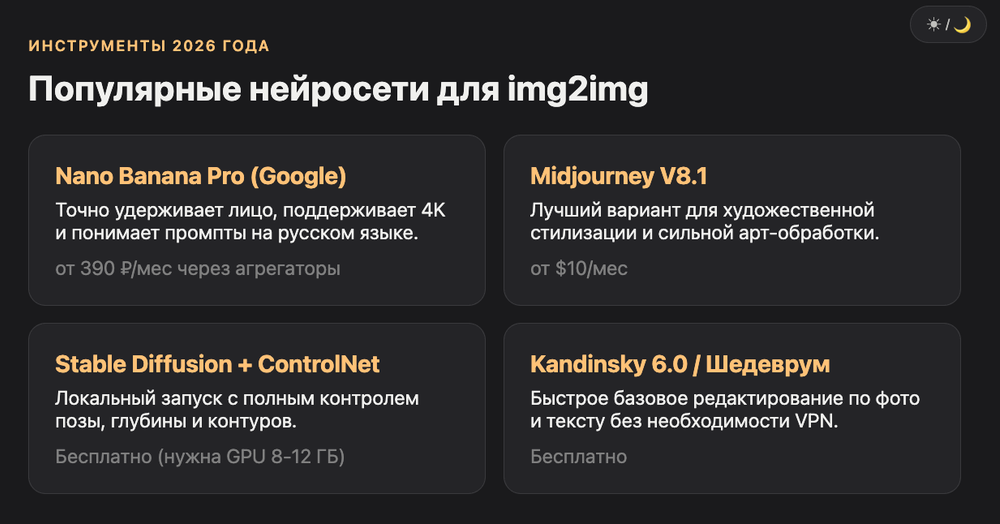
Для точного сохранения лица в 2026 году лидируют Nano Banana Pro и Crea AI, для художественной стилизации - Midjourney и Stable Diffusion с ControlNet, для бесплатного старта - Kandinsky и Шедеврум.
Выбор сервиса зависит от задачи: сохранить лицо, получить художественный стиль или сэкономить и работать без VPN.
| Сервис | Что умеет | Цена (сентябрь 2026) |
|---|---|---|
| Nano Banana Pro (Google, Gemini 3 Pro Image) | Редактирование по фото, держит лицо, 4K, понимает русский | доступ из РФ через агрегаторы, от 390 руб/мес (данные DTF) |
| Midjourney (модель V8.1) | Стилизация по image prompt, сильная художественность | от $10/мес, тариф Basic |
| Stable Diffusion + ControlNet | Локальный запуск, полный контроль параметров, бесплатно | бесплатно, нужна видеокарта от 8-12 ГБ |
| Crea AI | Замена лица по референсу, обучение на 10-15 фото | зависит от тарифа, есть бесплатные генерации |
| Kandinsky 6.0 / Шедеврум | Базовое редактирование по фото и тексту, работает без VPN | бесплатно |
Стабильность результата важнее бренда. Мы в VibeCoderz для быстрых личных аватаров чаще берем связку Nano Banana Pro плюс агрегатор без VPN, а для художественных проектов - Stable Diffusion локально, где можно выкрутить каждый параметр вручную.
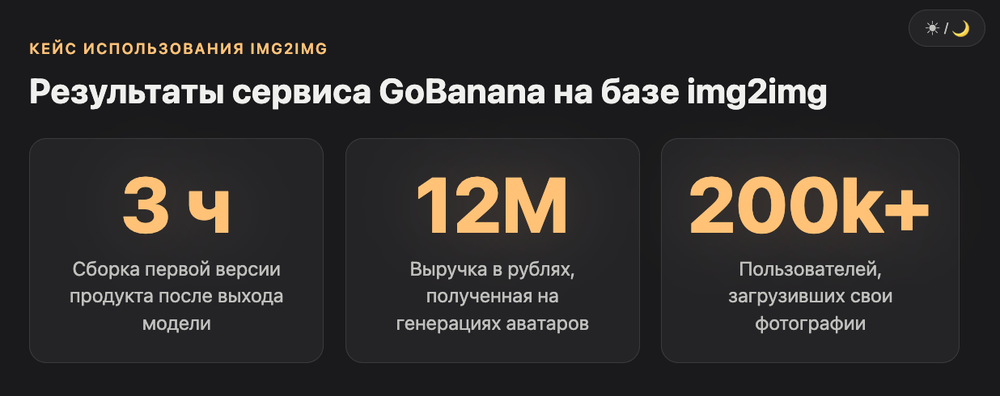
Максим: «GoBanana мы собрали за 3 часа после выхода новой модели, 6-8 часов ушло в сумме на весь продукт. Это принесло 12 миллионов рублей и 200 000+ пользователей. Мы просто дали людям загружать свое фото и получать себя в разных образах через img2img. Сделал - получил цифру.»
Как сделать аватар по фото через img2img - пошагово?
Чтобы получить свой аватар: соберите 10-15 фото с одного сета, загрузите в сервис с поддержкой img2img, напишите промт с описанием образа и выставите denoising strength 0.3-0.5.
Практика показывает, что аккуратная подготовка исходников дает больше, чем идеальный промт.
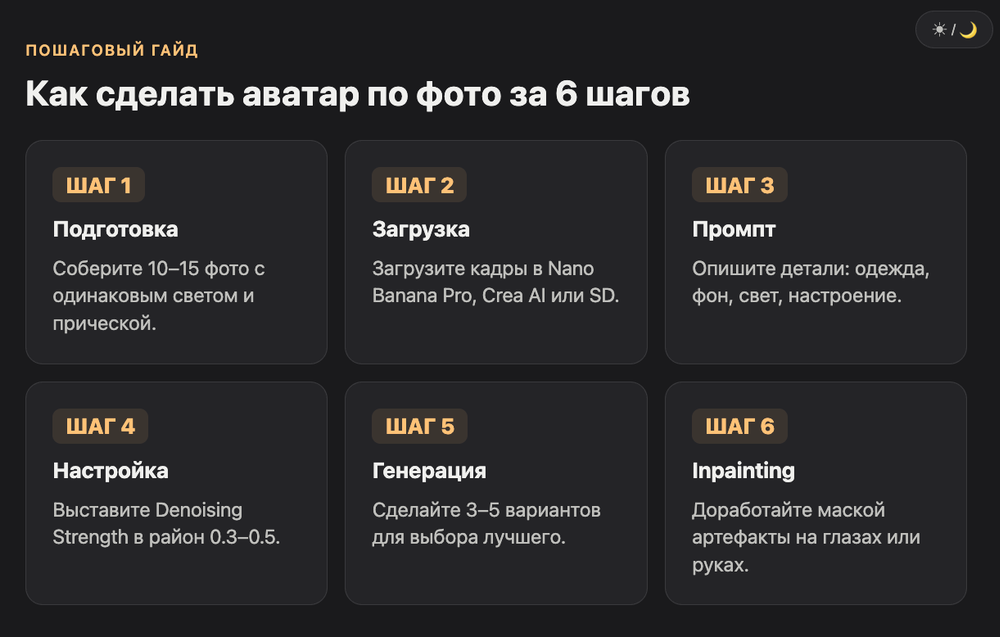
Шаг 1. Соберите фото. Нужно 10-15 снимков с одинаковым светом, одеждой и прической - это поможет модели точнее выучить лицо, а не гадать по одному кадру.
Шаг 2. Загрузите фото в сервис. Подойдет Nano Banana Pro, Crea AI или локальный Stable Diffusion во вкладке img2img.
Шаг 3. Опишите нужный образ. Пишите конкретно: одежда, фон, свет, настроение. Общие фразы вроде «сделай красиво» дают случайный результат.
Шаг 4. Настройте силу изменений. Для сохранения лица держите denoising strength около 0.3-0.5, для смены образа целиком - выше 0.7.
Шаг 5. Сгенерируйте несколько вариантов. Одна попытка редко дает идеальный кадр - обычно нужно 3-5 генераций, прежде чем менять подход.
Шаг 6. Доработайте детали. Через inpainting закрасьте маской неудачную зону - глаза, руки, аксессуар - и перерисуйте только ее, не трогая остальное фото.
Сильные и слабые стороны img2img
Технология не идеальна, и честный разбор ограничений экономит время лучше любого лайфхака.
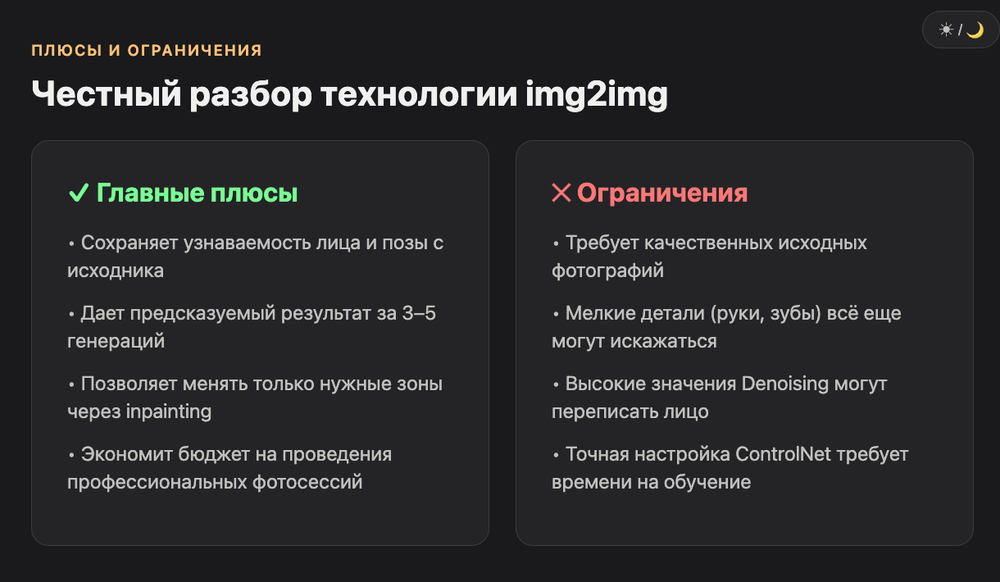
Сильные стороны:
- Сохраняет узнаваемость лица и позы, в отличие от генерации с нуля
- Дает предсказуемый результат за 3-5 попыток вместо десятков
- Работает точечно через inpainting - можно менять только одну деталь
- Есть бесплатные варианты: Kandinsky, Шедеврум, локальный Stable Diffusion
Слабые стороны:
- Требует качественных исходников - размытое или темное фото ухудшает результат
- Руки, зубы и мелкие детали до сих пор искажаются чаще остального
- Высокий denoising strength может полностью изменить лицо, если переборщить
- Локальный Stable Diffusion требует видеокарты и разбирается не с первого раза
Это не готовый рецепт без правок. Честнее сказать так: img2img экономит время фотографа, но не отменяет несколько попыток и ручную докрутку деталей.
Кому подходит img2img и когда выбрать другой инструмент?
Img2img подходит, когда важно сохранить лицо, позу или конкретный объект на фото. Для полностью нового изображения без ограничений эффективнее генерация с нуля.
Новичкам стоит начать с облачных сервисов вроде Nano Banana Pro или Kandinsky - там не нужно разбираться в видеокартах и параметрах. Дизайнерам и маркетологам, которым важен полный контроль, ближе Stable Diffusion с ControlNet: медленнее в освоении, но точнее в деталях.
| Задача | Что выбрать |
|---|---|
| Быстрый аватар по фото | Nano Banana Pro или Crea AI |
| Художественная стилизация портрета | Midjourney или Playground |
| Максимальный контроль над результатом | Stable Diffusion + ControlNet, локально |
| Бесплатный старт без VPN | Kandinsky 6.0 или Шедеврум |
| Генерация с нуля без фото | text2img в любом из перечисленных сервисов |
Частые вопросы про img2img
Что такое img2img простыми словами? Это режим нейросети, где вместо чистого листа на вход подается ваша фотография. Модель меняет стиль, фон или детали, но сохраняет композицию и лицо в зависимости от настроек.
Чем img2img отличается от обычной генерации? Text2img создает картинку только по тексту, а img2img отталкивается от загруженного фото. Из-за этого результат в img2img предсказуемее и ближе к оригиналу.
Можно ли сделать аватар по своему фото бесплатно? Да. Kandinsky 6.0, Шедеврум и локальный Stable Diffusion работают бесплатно. Платные сервисы вроде Nano Banana Pro обычно точнее держат лицо и работают быстрее.
Какое значение denoising strength выбрать для аватара? Для сохранения узнаваемого лица держите значение в районе 0.3-0.5. Выше 0.7 нейросеть начинает придумывать заново, и сходство с оригиналом падает.
Сохраняет ли img2img лицо на фото? Да, если denoising strength невысокий и фото хорошего качества. При слишком сильном изменении или размытом исходнике сходство теряется.
Какая нейросеть лучше всего работает с фото в 2026 году? Для сохранения лица - Nano Banana Pro и Crea AI. Для художественной стилизации - Midjourney и Stable Diffusion с ControlNet. Выбор зависит от задачи, а не от одного универсального лидера.
Законно ли использовать сгенерированное по фото изображение коммерчески? Зависит от тарифа сервиса и от того, чье лицо на фото - свое или чужое. Для коммерческого использования проверяйте условия конкретной платформы перед публикацией.
Глоссарий
- Img2img (image-to-image) - режим генерации, где нейросеть меняет загруженное фото вместо рисования с нуля.
- Text2img - генерация изображения только по текстовому промту, без исходного фото.
- Denoising strength - параметр от 0 до 1, определяющий силу изменений относительно оригинального фото.
- Диффузионная модель - тип нейросети, обученный превращать случайный шум в изображение и обратно.
- ControlNet - расширение, которое удерживает композицию, позу или контуры исходника при сильных изменениях.
- Inpainting - точечное редактирование по маске: перерисовывается только выделенная зона фото.
- Апскейл (upscale) - повышение разрешения сгенерированного изображения после основной генерации.
- Карта персонажа - набор фото одного лица с разных ракурсов, который используют, чтобы нейросеть не искажала внешность в новых генерациях.
Img2img - не разовый трюк, а рабочий инструмент, если разобраться с denoising strength и качеством исходников. Посмотрите каталог AI-инструментов на VibeCoderz, чтобы сравнить сервисы для генерации и редактирования по своим задачам. А если нужен разбор именно вашего кейса - пишите на консультацию к Максиму в Telegram.
Обновлено: сентябрь 2026.