400 000+ органических переходов за 3 месяца. Со-основатель GoBanana (231K пользователей, 12+ млн ₽ без рекламы) и NeuroScribe (65K пользователей). SEO/GEO-стратегии для AI-поисковиков, 1 700+ единиц контента, 17+ реализованных стратегий.
Об авторе →Claude Code: новый CLI-агент от Anthropic
Anthropic выпустила Claude Code — терминальный AI-агент для разработчиков. Инструмент работает прямо в командной строке и умеет писать, редактировать и запускать код.
Zcode AI: Полный гид по визуальному интерфейсу для Claude Code и AI-агентов
Узнайте, как использовать Zcode для управления Claude Code, Gemini и Codex в едином GUI. Настройка провайдеров, MCP-серверов и визуальный вайбкодинг.
YouTube-канал с монетизацией из любой точки мира: Пошаговый гайд 2026
Инструкция по созданию YouTube-канала: обход блокировок SMS, настройка расширенных функций через виртуальные номера и правила безопасности для монетизации.
Windsurf Code Maps: Как глубоко понимать архитектуру проекта перед написанием кода
Полный гайд по Windsurf Code Maps, модели Sway 1.5 и Sway Grep. Узнайте, как визуализировать архитектуру кода и ускорить разработку в 13 раз.
Vk Fast Cash Strategy
Аудитория ВКонтакте — это те же люди, что и в Instagram, но 'социальный контракт' площадки другой. Если Instagram — это 'дорогой ресторан' с демонстрацией успеха, то VK — это 'душевная шашлычная'. Здесь не работает глянцевый 'успешный успех
Контекст ai агент теряет не потому, что модель "поглупела" за сессию. Он теряет качество ответов, потому что контекстное окно забито мусором: старые тул-коллы, забытые файлы, три версии одного и того же решения. Разберем, как собрать summary проекта, подключать нужные файлы через @ и не превращать сессию в свалку токенов.
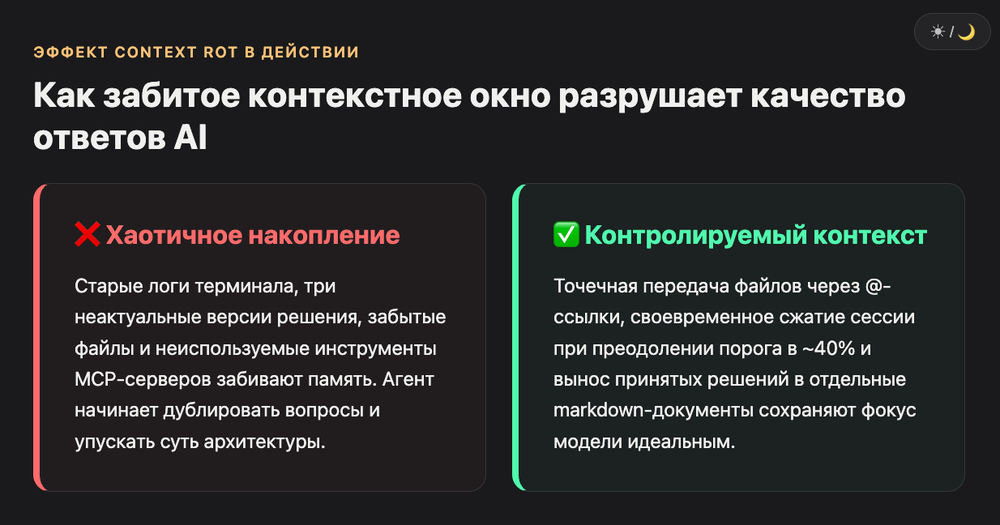
Context rot - это падение качества ответов агента по мере роста контекста, даже если окно еще не заполнено. Лечится тремя вещами: коротким summary проекта, точечной подгрузкой файлов через @-ссылки и хранением решений в отдельных docs, а не в переписке. Ниже: как это устроено в Claude Code и что делать на практике.
Context rot - это не баг, а свойство архитектуры трансформера: чем длиннее вход, тем неравномернее модель распределяет внимание между токенами.
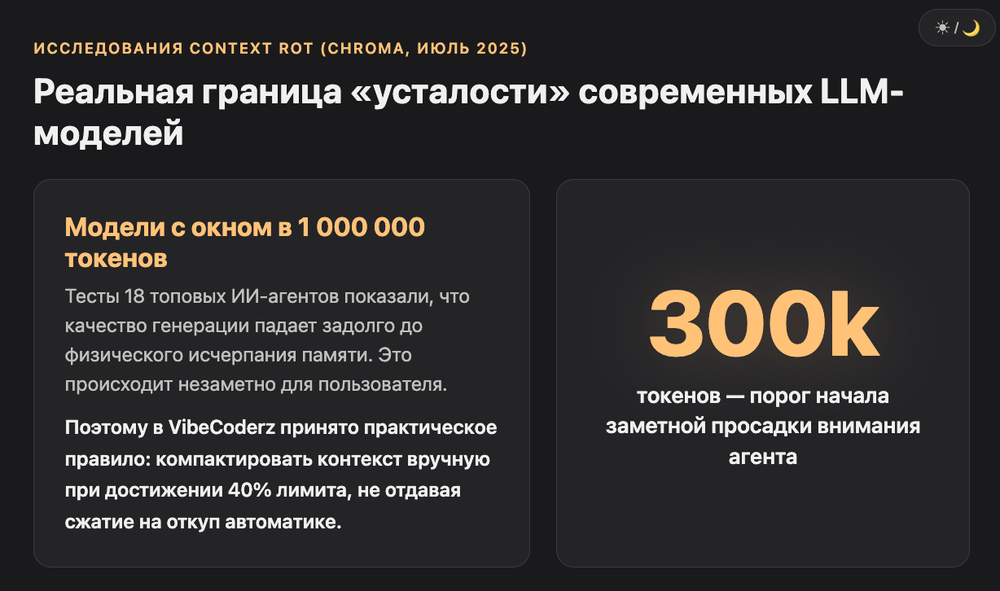
Исследование Chroma (июль 2025) протестировало 18 топовых моделей, включая семейство Claude, и зафиксировало: качество ответов падает задолго до заполнения окна, причем неравномерно и на простых задачах тоже. Для моделей с окном в 1 млн токенов заметная просадка обычно стартует в районе 300–400 тысяч токенов.
Разработчики называют это "context rot" не для красоты. Модель физически не обязана относиться к 200-тысячному токену так же внимательно, как к 20-му: чем дальше нужная деталь от начала или конца окна, тем выше шанс, что агент ее просто пропустит. Отсюда правило, которым в VibeCoderz пользуются на длинных задачах: заполнили около 40% контекстного окна, а сессия еще не закончена - компактируйте вручную, не дожидайтесь автосжатия. Это не жесткий научный порог, а практическая привычка, которая экономит часы переделок.
По факту разница между 95% и 40% в том, кто управляет сжатием. На автосжатии решает модель, и она часто выбрасывает архитектурные решения, оставляя мусорный вывод команд.
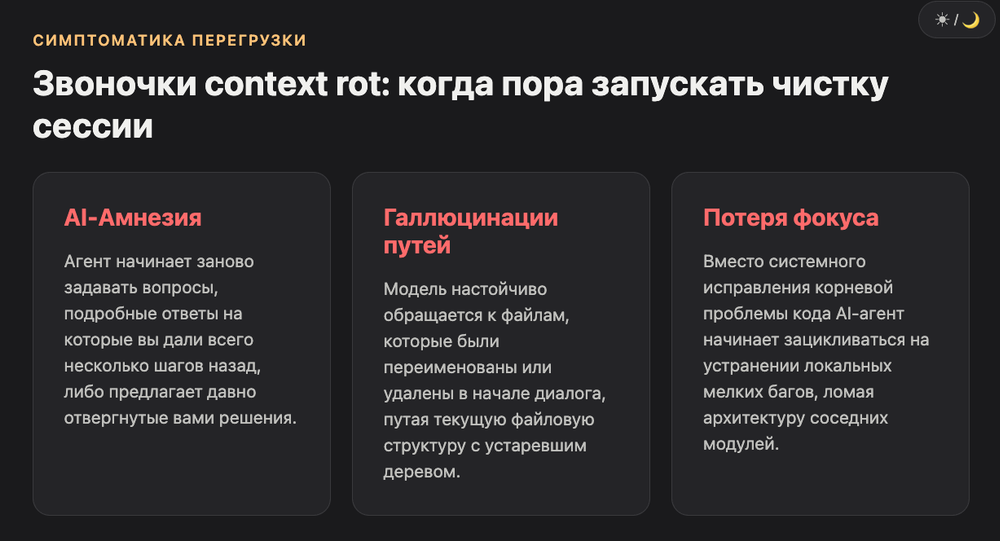
Агент начинает повторять уже отвеченные вопросы, ссылается на давно переименованные файлы или предлагает то, что вы уже отклонили час назад - это и есть первые звоночки context rot.
Признаки нарастают волнами. Сначала мелочи: ответы чуть более общие, чем обычно. Потом агент забывает структуру папки, которую сам же читал двадцать минут назад. На третьей стадии он теряет общую цель и начинает чинить локальные симптомы вместо причины - знакомая картина для тех, кто вел сессию в Claude Code дольше двух часов подряд.
Отдельно съедают контекст MCP-серверы: они по умолчанию грузят в окно описание всех своих инструментов, даже если задача их не касается. Если в проекте подключено пять серверов, а нужен один, остальные просто занимают место. Практическое решение - выключать неиспользуемые MCP или переносить редкие сценарии в skills, которые подгружаются по требованию, а не висят в контексте постоянно.
Summary проекта - это не описание "для людей", а компактный файл с фактами, которые агенту иначе пришлось бы искать заново в каждой сессии.
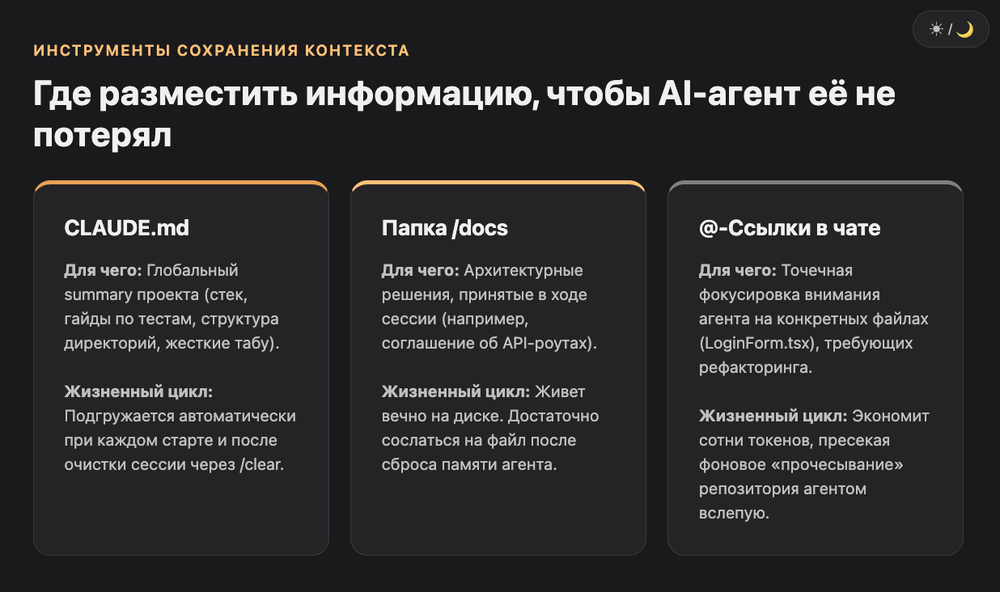
Файл CLAUDE.md перечитывается заново после каждого /clear и подгружается повторно после /compact. Все, что вы объясняете агенту чаще одного раза, стоит переносить туда, а не повторять в переписке - это снимает "налог на переобъяснение" с каждой новой сессии.
В summary имеет смысл держать не историю проекта, а то, что реально экономит поиск: стек, структуру папок, команды для тестов и сборки, жесткие ограничения вроде "никогда не трогать схему БД напрямую". Хороший summary весит 1–2 страницы, а не десять - раздутый CLAUDE.md сам становится источником перегруза, потому что грузится в каждую сессию целиком.
| Что писать в summary | Что туда не класть |
|---|---|
| Стек, структура папок, команды сборки/тестов | Историю переписок и старые баг-репорты |
| Жесткие правила ("не трогать миграции руками") | Разовые задачи текущего спринта |
| Соглашения по коду и неймингу | Полные логи и стектрейсы |
| Ссылки на docs с решениями | Черновики, которые еще не приняты |
Максим: «VibeCoderz мы собрали за неделю тремя скриптами голосом в Claude Code, 6 200 материалов легло в базу. Без четкого summary проекта в файле это бы не сработало: агент каждый раз заново гадал бы, какая у нас структура каталога и категорий».
@-ссылка на конкретный файл экономит контекст сильнее, чем кажется: агент читает именно то, что нужно, а не грепает половину репозитория в поисках догадки.
Здесь есть контринтуитивный момент из практики Claude Code: короткий расплывчатый промпт в итоге съедает больше контекста, чем длинный и точный. Без явного указания, где искать, агент вынужден сам сканировать директории, открывать лишние файлы и строить догадки, а каждая такая догадка - это токены. Промпт вида "поправь баг в LoginForm.tsx, где user может быть undefined" с @-ссылкой на файл экономит несколько итераций поиска.
Правило простое: если вы точно знаете, какой файл нужен агенту, дайте ссылку на него сразу через @, а не описывайте задачу общими словами и не надейтесь, что агент сам найдет нужное место с первого раза.
Компактируйте, если задача та же самая и просто разрослась. Очищайте контекст полностью, если начинаете новую задачу - старая история будет только мешать и создавать предвзятость.
Разница между командами принципиальная, а не косметическая. /compact сжимает текущую сессию в резюме и продолжает работу дальше в том же потоке. /clear стирает рабочую память полностью и стартует с чистого листа, при этом CLAUDE.md и настройки проекта подгружаются заново автоматически - ничего не приходится объяснять по новой.
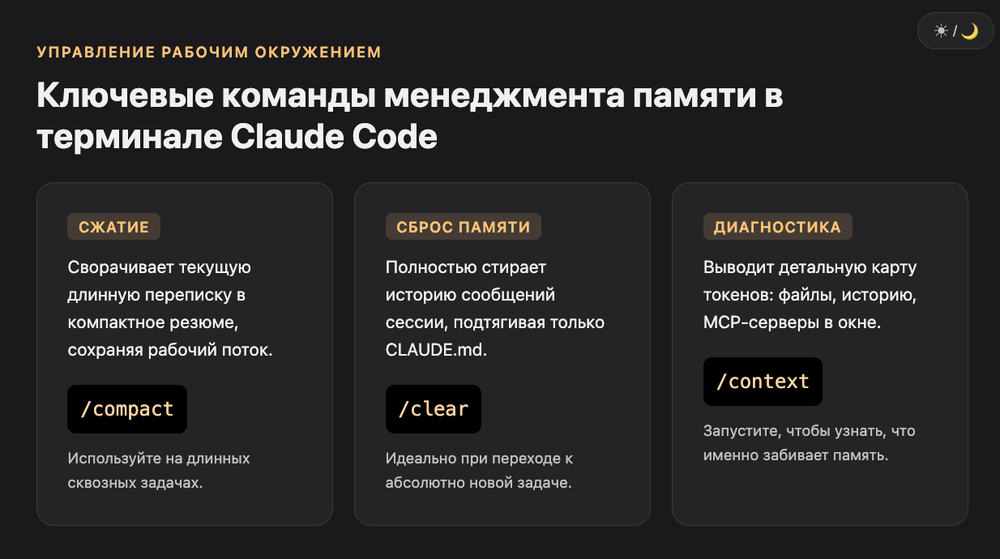
| Команда | Что происходит | Когда применять |
|---|---|---|
| /compact | Сессия сжимается в резюме, работа продолжается в том же потоке | Та же фича, контекст разросся, но нужна непрерывность |
| /clear | Контекст стирается полностью, CLAUDE.md подгружается заново | Новая задача, старая история мешает и не нужна |
| /context | Показывает, что именно занимает окно: файлы, MCP, история | Привычка перед /compact - сначала смотрите, потом чистите |
Перед крупной очисткой стоит зафиксировать промежуточное состояние в файле, а не только в голове. План задачи, список измененных файлов, команды проверки - если это лежит в docs, а не только в переписке, потеря контекста при /compact ничего не стоит команде.
Саб-агент работает в отдельном окне и возвращает в основной поток только итог, поэтому задачи вида "найди, где лежит валидация JWT" стоит делегировать ему, а не решать в основной сессии.
Саб-агент удобен ровно для одного сценария: вам нужен результат, а не процесс его получения. Поиск нужного сервиса в незнакомой кодовой базе, обзор диффа свежим взглядом, генерация текста в заданном тоне - все это подходящие задачи. Основной поток получает только выжимку, а весь шум от исследования остается в изолированном контексте саб-агента.
Есть и обратная сторона. Саб-агентов не стоит ставить на тест-раннеры: они прячут стектрейсы и стандартный вывод, которые нужны для диагностики. И последовательная цепочка из нескольких саб-агентов подряд работает плохо - на каждой передаче между ними теряется часть контекста, и в сумме это дороже, чем решить задачу в одном потоке.
Решения, принятые в разговоре, живут ровно до ближайшего /compact или /clear - если их не зафиксировать в docs, агент забудет их вместе со всей остальной историей.
Разница между вопросом и решением в том, что решение должно пережить сброс контекста. Практика: как только договорились о подходе, например "мутации только через server actions, без API-роутов", фраза уходит в отдельный файл в docs, а не остается жить только в переписке. При следующем /clear агенту достаточно сослаться на файл, вместо того чтобы заново объяснять весь ход рассуждений.
Такой подход экономит не только контекст, но и время команды: новый человек или новая сессия читает docs за пять минут вместо того, чтобы поднимать историю переписки на сотни сообщений.
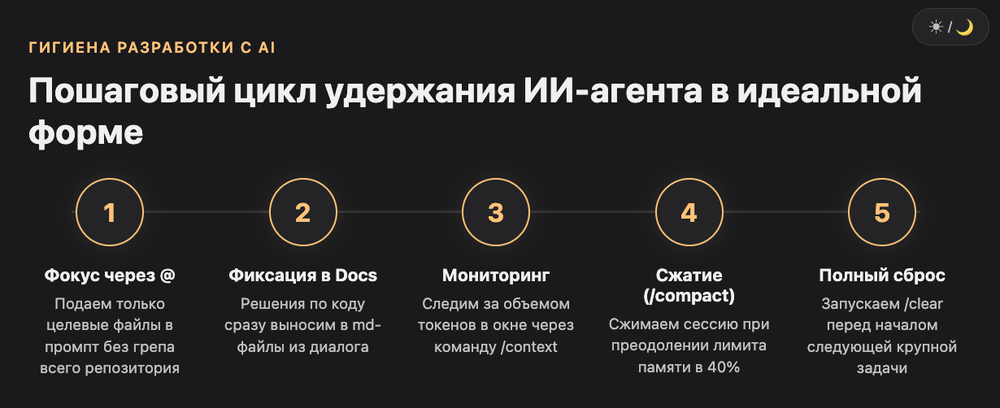
Ниже карта, к какому инструменту тянуться в зависимости от ситуации. Она не заменяет здравый смысл, но снимает половину вопросов "compact или clear" в моменте.
| Ситуация | Что делать |
|---|---|
| Сессия перевалила за ~40% окна, задача та же | /compact с уточнением, что сохранить |
| Задача закончена, начинается новая | /clear, детали смотрим в /resume при необходимости |
| Нужен только результат поиска по коду | Саб-агент вместо основного потока |
| Правило нужно объяснять уже второй раз | Перенести в summary проекта (CLAUDE.md) |
| Принято архитектурное решение | Зафиксировать в docs, а не оставлять в чате |
| Непонятно, что занимает контекст | /context, потом уже решать что чистить |
Прикинуть заранее, какие файлы понадобятся, и подать их через @ - дешевле, чем потом разгребать context rot на середине рефакторинга. Инструменты вроде Claude Code уже дают команды /context, /compact, /clear из коробки, дело за привычкой их использовать вовремя, а не когда агент уже путается в собственных ответах.
Что будет, если вообще не чистить контекст? Агент постепенно начнет терять детали, повторять вопросы и путать более раннюю часть беседы с текущей задачей. На автосжатии это происходит без вашего контроля, и модель сама решает, что выбросить.
Чем summary проекта отличается от обычного промпта? Промпт живет одну сессию, summary в CLAUDE.md перечитывается заново при каждом старте и после /clear. Это разница между "объяснить один раз" и "объяснять каждый день".
/clear правда удаляет весь прогресс безвозвратно? Нет, старая сессия остается доступной через историю переключения между чатами. /clear просто освобождает рабочее окно и подгружает CLAUDE.md заново, ничего не стирая с диска.
Нужно ли компактить контекст каждые 10 минут? Нет, это лишняя трата времени. Ориентир: примерно 40% окна на длинной задаче или явные признаки путаницы у агента, что бы ни наступило раньше.
Можно ли подключить через @ сразу целую папку, а не один файл? Да, но чем точнее ссылка, тем меньше лишнего попадет в контекст. Для больших директорий эффективнее сначала попросить саб-агента дать структурную выжимку.
Что делать, если агент забыл важное решение после /compact? Значит, решение жило только в переписке. Правильный порядок: сначала зафиксировать в docs, потом уже сжимать сессию, а не наоборот.
Работает ли этот подход в Cursor и Windsurf, а не только в Claude Code? Принцип один и тот же для любого агента с ограниченным окном: короткий summary, точечная подгрузка файлов, решения в docs. Конкретные команды у Cursor отличаются, но логика управления контекстом та же.
Если тема резонирует с задачей продукта, а не только с личным кодингом, посмотрите каталог AI-инструментов на VibeCoderz или запишитесь на консультацию к Максиму: t.me/maxnagovitsyn.
Обновлено: октябрь 2026.
