
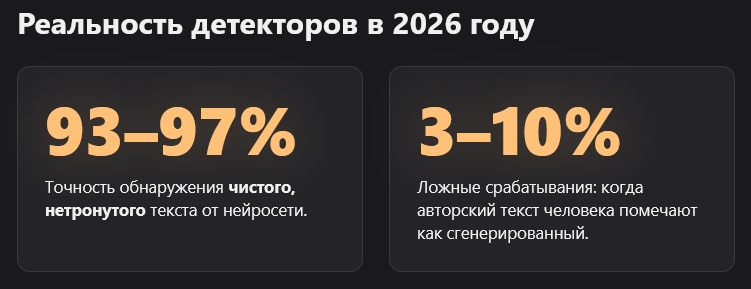
Написан ли текст нейросетью, надежно не скажет ни один детектор. Лучшие сервисы 2026 года ловят от 93 до 97% нетронутого AI-текста, но человека принимают за машину в 3-7% случаев. На русском языке они работают хуже, чем на английском. Разберем, как устроены детекторы, каким цифрам верить и что делать с результатом проверки.
Коротко: Детекторы AI-текста дают вероятность, а не приговор. По обзорам 2026 года GPTZero, Copyleaks и Sapling ошибаются на человеческих текстах в 3-7% случаев, на русском языке заметно чаще, а после правки текста точность падает. В статье: цифры, причины ошибок и правила чтения результата.
Можно ли точно определить, что текст написан нейросетью?
Нет, точно нельзя. Детектор оценивает вероятность по статистике текста и может ошибиться в обе стороны, поэтому его вердикт стоит считать поводом присмотреться, а не доказательством.
Ни один AI-детектор не дает стопроцентной точности. Лучшие сервисы 2026 года показывают от 93 до 97% на нетронутом AI-тексте и ошибочно помечают от 3 до 7% человеческих текстов. В реальных смешанных выборках цифры хуже. Поэтому результат проверки годится как сигнал, а не как доказательство авторства.
Возьмем разбор из видео про Антиплагиат.ВУЗ. Студенческая работа получает оригинальность 93%, совпадений почти нет, а в отчете все равно стоит отметка «подозрительный документ, сгенерированный текст». По словам автора ролика, с такой отметкой работу не допустят к защите. Оригинальность и AI-детекция считаются отдельно, и это сбивает с толку.
В другом видео исследовательница с двадцатилетним стажем показывает обратную сторону. Ее собственные гладкие тексты система тоже иногда помечает как сгенерированные.
Как работают детекторы AI-текста и при чем тут перплексия?
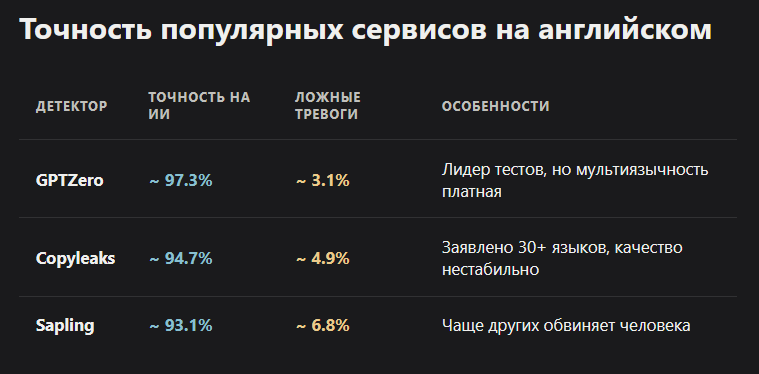
Детекторы ищут статистические привычки нейросетей: предсказуемые слова и ровный ритм предложений. Чем легче языковой модели угадать следующее слово, тем выше шанс получить отметку AI.
Перплексия показывает, насколько текст неожиданен для языковой модели. Низкая перплексия значит, что каждое следующее слово угадывается легко, и детектор подозревает нейросеть. Вторая метрика, burstiness, измеряет разброс длины и структуры предложений. Человек пишет неровнее, поэтому у него разброс выше, чем у типового ответа ChatGPT.
Автор одного разбора на канале об антиплагиате описывает разницу так: нейросеть выдает шаблонный, безупречно правильный текст, а человек пишет непредсказуемо. У него есть личные маркеры, огрехи, неожиданные слова. Еще одна примета из того же ролика: ошибки в фактах, датах и именах.
Обычно сервис склеивает несколько метрик в одну оценку от 0 до 100% и подсвечивает отдельные предложения, как это делает GPTZero.
Какая реальная точность у GPTZero, Copyleaks и Sapling в 2026 году?
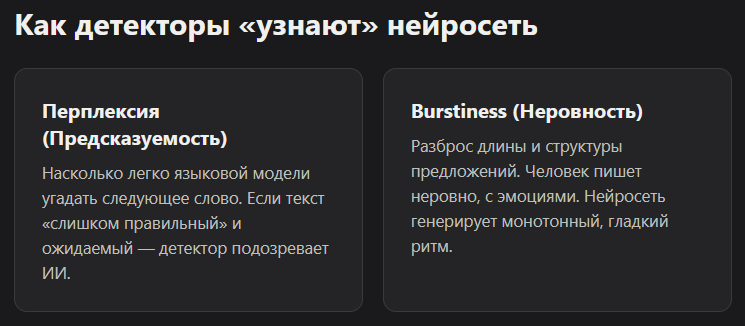
По сравнительным обзорам 2026 года GPTZero лидирует с точностью около 97% на чистом AI-тексте, Copyleaks и Sapling идут следом. Ложные срабатывания растут от 3 до 7%.
По данным обзоров 2026 года, GPTZero дает около 97,3% точности при 3,1% ложных срабатываний, Copyleaks около 94,7% при 4,9%, Sapling около 93,1% при 6,8%. Цифры относятся к немодифицированному AI-тексту. Проверьте их актуальность на момент чтения: сервисы обновляют модели каждые несколько месяцев.
| Детектор | Точность на чистом AI-тексте | Ложные срабатывания | Что учесть |
|---|---|---|---|
| GPTZero | около 97,3% | около 3,1% | Есть бесплатный тариф, лучше всего работает на английском |
| Copyleaks | около 94,7% | около 4,9% | Заявлена поддержка 30+ языков, но качество по языкам разное |
| Sapling | около 93,1% | около 6,8% | Чаще двух других принимает человека за машину |
Разброс между тестами огромный. Собственный бенчмарк GPTZero на 3000 образцах дал 99,3% точности и 0,24% ложных срабатываний. Независимая проверка на 2400 смешанных образцах, которую приводит Fastio, показала 87% и 10%. Разработчик меряет себя на своих условиях, а жизнь устроена сложнее.
Почему детекторы хуже работают на русском языке?
Большинство детекторов обучали преимущественно на английских текстах. На русском они чаще ошибаются и дают нестабильный результат, поэтому цифры из англоязычных тестов на русский переносить нельзя.
Большинство ведущих детекторов строилось на англоязычных выборках. Русскоязычных данных в обучении меньше, и статистические ориентиры английского на русском работают хуже. Отсюда нестабильные оценки и больше ложных срабатываний. Цифры GPTZero, Copyleaks и Sapling выше померены в основном на английском материале.
Обзоры вроде подборки на vc.ru показывают, что часть сервисов на русском выдает ненадежный результат. Наличие языка в списке поддерживаемых еще не гарантирует качество. В GPTZero мультиязычная проверка, например, доступна на платном тарифе.
Лайфхак на пять минут: возьмите 5-10 текстов, которые точно писал человек, лучше до 2022 года. Прогоните их через выбранный сервис. Если он помечает два-три из десяти, для важных решений он не годится.
Почему после правки текста точность детектора падает?
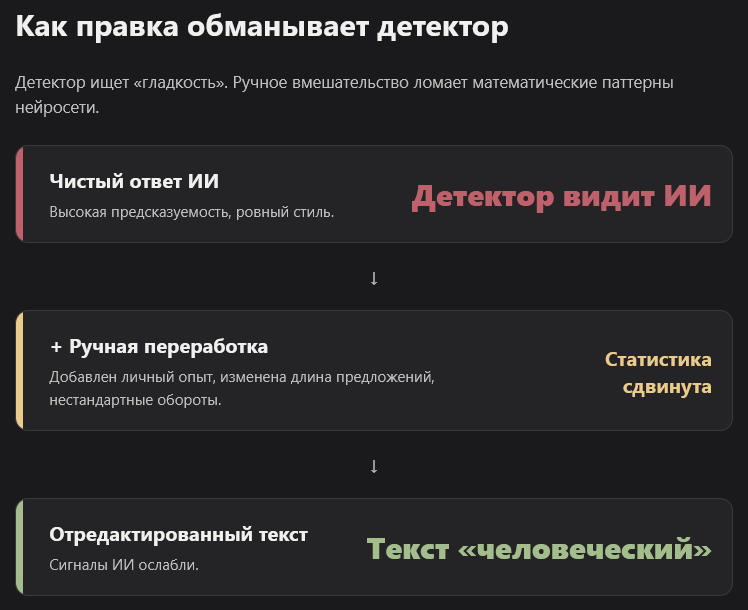
Детекторы ловят статистические паттерны генерации. Ручная и AI-переработка с личными деталями и нестандартными оборотами размывает эти паттерны, и переписанный текст обнаружить заметно сложнее.
Детектор смотрит на предсказуемость слов и ровность стиля, а не на происхождение текста. Когда автор добавляет личный опыт, меняет длину предложений и вставляет нестандартные обороты, эти сигналы слабеют. Исследование Weber-Wulff и коллег 2023 года, о котором пишет Wikipedia, зафиксировало: после перефразирования точность инструментов ухудшается.
Отсюда важный вывод для редакторов и преподавателей. Чистый результат проверки почти ничего не доказывает, потому что правка уже сдвинула статистику. Текст, который начинался как ответ Claude или ChatGPT, после ручной переработки может выглядеть человеческим.
Это не инструкция, как пройти проверку диплома. Смысл в другом: детектор измеряет привычки текста, а не то, кто его написал.
Где детекторы работают надежно, а где легко ошибаются?
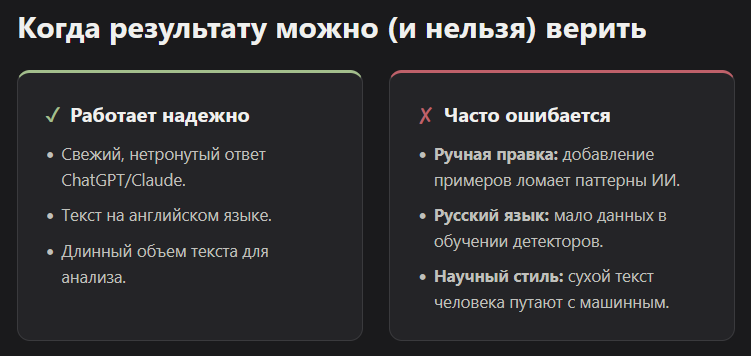
Надежнее всего детекторы ловят длинный нетронутый ответ нейросети на английском. Хуже всего справляются с русским, техническими текстами, переводами и текстом, который прошел ручную правку.
Детекторы дают пользу в узких условиях: свежий текст от ChatGPT, Claude или Gemini без правок, английский язык, достаточный объем. За пределами этих условий точность заметно проседает, а ошибка в любую сторону становится обычным делом. Ниже честный баланс сильных и слабых сторон.
Сильные стороны детекторов
Первое: они быстро отсеивают явный копипаст из чата. Если весь материал вставлен без правок, сервис поймает его в большинстве случаев. Второе: подсветка предложений подсказывает, куда смотреть редактору вручную. Третье: при массовой проверке они экономят часы, хотя финальное решение остается за человеком.
Слабые стороны детекторов
Гладкий научный и технический стиль они путают с машинным. Автор видеообзора GPTZero отмечает, что нехудожественный человеческий текст иногда получает отметку AI, а художественный определяется лучше. Ложно срабатывают и переводы через нейросеть. Плюс конфликт интересов: самые красивые цифры публикуют сами разработчики.
| Ситуация | Надежность сигнала | Что делать |
|---|---|---|
| Нетронутый ответ ChatGPT на английском | Высокая | Использовать как сигнал, сверить факты |
| Текст на русском | Средняя или низкая | Проверить в двух сервисах, тест на своих текстах |
| Научная или техническая статья автора | Много ложных срабатываний | Запросить черновики и историю правок |
| Текст после ручной правки | Низкая | Не опираться на чистый результат |
| Перевод через нейросеть | Часто ложная отметка | Уточнить у автора, как делался перевод |
Накажут ли Яндекс и Google за текст, написанный нейросетью?
Google оценивает пользу и намерение, а не способ производства. Наказание грозит за спам в масштабе, а не за использование нейросети как инструмента.
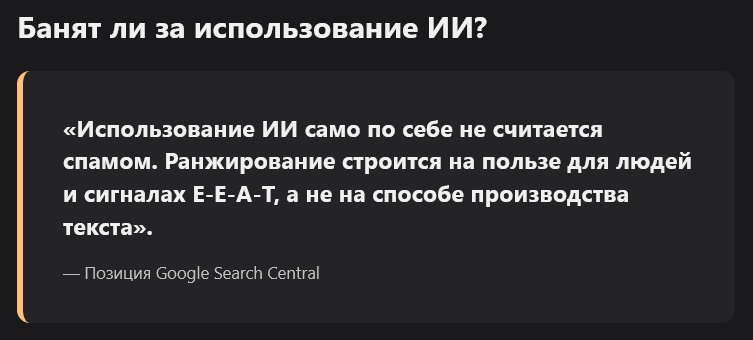
Google в блоге Search Central пояснил: автоматизация, включая ИИ, нарушает спам-политику, если ее главная цель манипулировать выдачей. Использование ИИ само по себе спамом не считается. Ранжирование строится на пользе для людей и сигналах E-E-A-T, а не на вердикте стороннего детектора.
Про Яндекс официальных заявлений именно про AI-происхождение мы не видели. В практике наших проектов жестких санкций за это тоже не встречалось. Работает то же правило: поведенческие сигналы и полезность страницы для запроса.
Лиза: «Прикинь, в Нейроскрайбе мы запустили программатик-SEO на 1000 статей под 500 ниш. За прошлый год это дало 300 000 заходов, а накопленно около 1,5 млн посетителей. Выдача смотрела на то, отвечает ли статья на запрос. Вот такие пироги.»
Подробнее о позиции Google по AI-контенту читайте в первоисточнике.
Стоит ли верить детектору AI-текста и как читать его результат?
Верить нужно как сигналу, не как доказательству. Высокий процент AI повод перечитать текст и поговорить с автором, а низкий процент не гарантирует, что текст написал человек.
Результат детектора читайте как вероятность и проверяйте другими способами: историей правок, вопросами автору, фактами, датами и именами. Выдуманные ссылки и ошибки в цифрах выдают нейросеть надежнее любого процента. Решение о человеке принимайте по совокупности признаков, а не по одному числу.
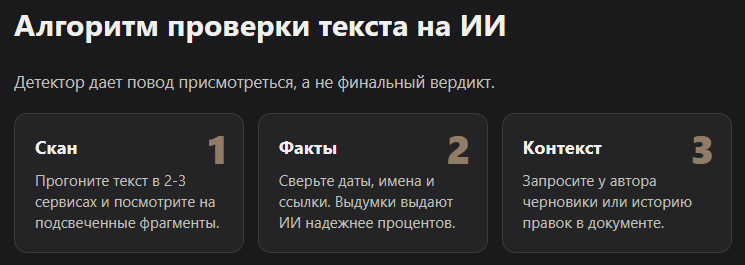
Рабочий порядок для редактора или преподавателя:
Прогнали текст в двух-трех сервисах -> посмотрели подсвеченные предложения -> сверили факты, даты и имена -> запросили черновики или историю правок -> поговорили с автором.
Особенно осторожно обращайтесь с академическими и техническими текстами. Там ложные срабатывания случаются чаще всего, потому что сухой стиль похож на машинный. Если сами пишете с помощью нейросети, посмотрите каталог AI-инструментов и, например, Claude Code. А под конкретную профессию есть каталог ИИ-агентов.
Что еще спрашивают про детекторы AI-текста?
Какой детектор лучше для русского языка?
Единого победителя нет. Часть сервисов заточена под русский рынок, например Антиплагиат.ВУЗ, но и он, по словам автора одного из видеоразборов, ошибается на гладком авторском тексте. Сравните сервисы на 5-10 заведомо человеческих текстах и смотрите, как часто они ошибаются.
Может ли детектор пометить текст, который я написал сам?
Да. Ложные срабатывания по обзорам 2026 года составляют от 3 до 7%, а в независимых тестах доходят до 10%. Чаще страдают технические и академические тексты с ровным сухим стилем и тексты, переведенные нейросетью.
Хватит ли одного детектора для проверки?
Нет. Разные сервисы дают разный процент на одном и том же тексте. Прогоните материал через два-три, сравните подсвеченные фрагменты и проверьте факты вручную.
Видит ли детектор текст, который дописал человек?
Частично. Если нейросеть написала черновик, а человек добавил примеры и переписал абзацы, статистические признаки ослабевают. Смешанные тексты остаются самым сложным случаем для любого детектора.
Банит ли Google за текст от нейросети?
Нет, если текст полезен людям. По руководству Google, спамом считается автоматизация с целью манипулировать выдачей. Сам факт использования ИИ санкций не влечет.
Как понять без детектора, что текст писала нейросеть?
Смотрите на ошибки в датах и именах, слишком ровный ритм, общие фразы без конкретики и отсутствие личных деталей. Ни один признак сам по себе не доказывает авторство. Ищите их в комплексе.
Что означают термины из статьи?
- Детектор AI-текста это сервис, который оценивает вероятность того, что текст сгенерирован нейросетью.
- Перплексия показывает, насколько текст неожиден для языковой модели. Низкая перплексия считается признаком машинного текста.
- Burstiness это разброс длины и структуры предложений. У человека он обычно выше.
- Ложное срабатывание это ситуация, когда текст человека помечен как сгенерированный.
- Recall (полнота) показывает, какую долю AI-текстов детектор нашел.
- Антиплагиат.ВУЗ это российская система проверки работ, которая теперь показывает и отметку о сгенерированном тексте.
Хотите разобраться, как строить контент и продукты с нейросетями без лишних рисков? Загляните в каталог AI-инструментов VibeCoderz и запишитесь на консультацию к Максиму.
Обновлено: сентябрь 2026.