
Hermes Agent не привязан ни к одному провайдеру. Он работает с OpenRouter, Anthropic, OpenAI, Nvidia, локальными моделями через Ollama, LM Studio и любым OpenAI-совместимым endpoint. Переключение между ними занимает 30 секунд. Если подбирать провайдера и вводить команды вручную не хочется, Hermes Start ставит помощника Hermes и подключает его к Telegram примерно за 30 минут, без терминала.
В этой статье: как устроена архитектура «мозг снаружи», какой провайдер подходит для каких задач, точные команды для настройки каждого варианта и что делать, если хочется работать бесплатно или без передачи данных за рубеж.
Почему выбор модели важен для Hermes
Hermes — это не модель. Это оболочка: агентский цикл, инструменты, память, навыки. Модель — внешний мозг, который принимает решения. Hermes выполняет то, что модель решила сделать.
Это разделение принципиально. Одна и та же задача на Claude Opus 4.7 и на бесплатной модели через OpenRouter даёт принципиально разное качество. Не потому что Hermes хуже — просто мозг другой.
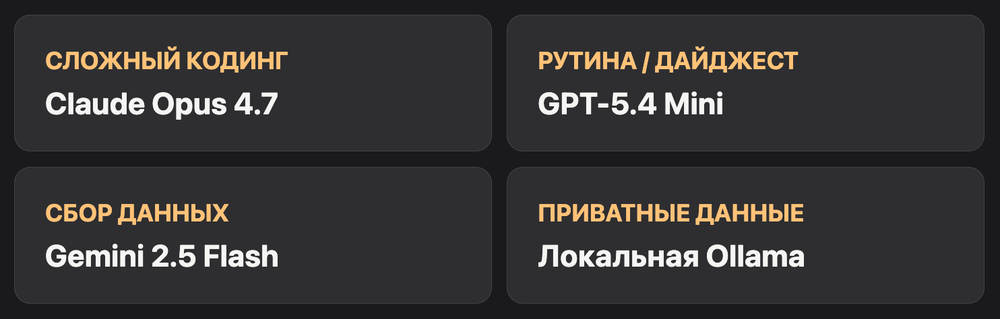
Из этого следует практическое правило: чем сложнее и длиннее задача, тем важнее качество модели. Для ежедневного дайджеста новостей GPT-5.4 mini отлично справляется. Для отладки 500 строк кода DeepSeek V4 Pro или Claude Opus 4.7 дадут результат на порядок лучше.
Лиза: «Мы гоняли Hermes на разных моделях для задач контент-автоматизации NanaBanana. GPT-5.4 mini хватает для сбора и форматирования данных — стоит копейки. На DeepSeek V3.2 через OpenRouter переходим только когда нужно анализировать большие объёмы или генерировать тексты. Разница в расходах — в 15-20 раз.»
Есть одно жёсткое техническое требование: контекстное окно модели должно быть минимум 64k токенов. Меньше — агент начнёт терять данные при многошаговых задачах. Не потому что ограничение Hermes, а потому что агентские цепочки инструментов быстро забивают контекст.
Как менять модель: команда hermes model
Независимо от провайдера, переключение модели всегда делается одной командой:
hermes modelОткрывается интерактивное меню. Стрелками выбираете провайдера, потом модель. Изменение применяется немедленно, без перезапуска агента и без правки конфигурационных файлов.
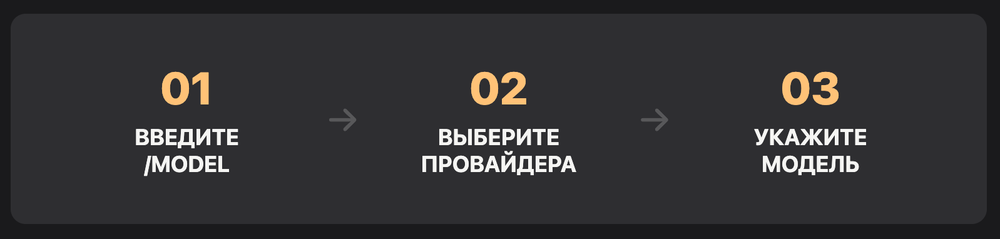
Внутри активного чата переключение делается slash-командой:
/modelЭто не прерывает текущую сессию — агент переключает «мозг» на лету. Именно этого не умеет большинство конкурентов: при смене модели в OpenClaw сессия ломается.
OpenRouter: один ключ — 200+ моделей
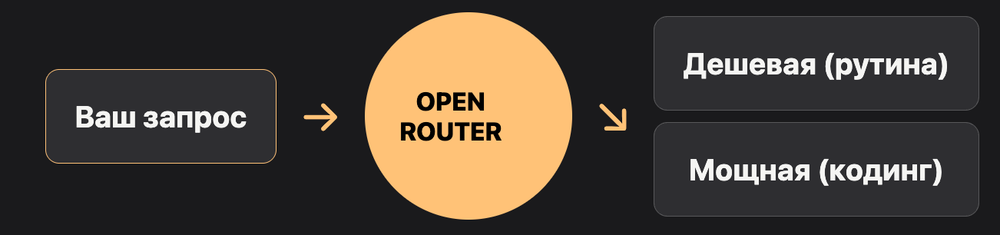
OpenRouter — агрегатор API. Один аккаунт, один ключ, доступ ко всем ведущим моделям: Claude, GPT, Gemini, DeepSeek, Grok, Qwen, Llama и сотни других. Провайдер автоматически роутит запросы.
Почему OpenRouter удобен для Hermes
Основная практическая причина — переключение моделей без смены API-ключа. Хочется попробовать DeepSeek V4 Pro вместо GPT-5.4 mini — просто меняете строку модели, ключ остаётся тот же. Не нужно заходить в пять разных личных кабинетов.
Второй плюс — OpenRouter Auto. Специальный режим, в котором OpenRouter сам выбирает модель под тип запроса: дешёвая для рутинных задач, дорогая для сложных. На практике это работает: простые запросы идут на Gemini 2.5 Flash или GPT-5.4 Nano, тяжёлые рассуждения — на Claude Opus. Итоговый счёт заметно ниже, чем при постоянном использовании топовых моделей.
Как подключить OpenRouter
Регистрируетесь на openrouter.ai, добавляете кредиты (минимум $5-10 для старта), создаёте API-ключ. Рекомендуется установить кредитный лимит — например, $25-50 в месяц — чтобы случайный сбой агента не опустошил счёт.
В Hermes:
hermes model
# В меню выберите: OpenRouter
# Введите API-ключ
# Выберите модель или введите custom model name
Для режима Auto введите имя модели как openrouter/auto.
| Модель | Тип | Стоимость | Для чего |
|---|---|---|---|
| openrouter/auto | Авто-роутинг | Смешанная | Повседневные задачи |
| deepseek/deepseek-chat-v3 | Платная | $0.28/M input | Кодинг, анализ |
| deepseek/deepseek-v4-pro | Платная | $0.43/M input | Сложный кодинг, большие файлы |
| google/gemini-2.5-flash | Платная (дёшево) | ~$0.075/M input | Быстрые рутинные задачи |
| minimax/minimax-m2.5 | Бесплатная | $0 | Тестирование, лёгкие задачи |
| nvidia/llama-3.1-nemotron-70b | Бесплатная | $0 | Бесплатный тест |
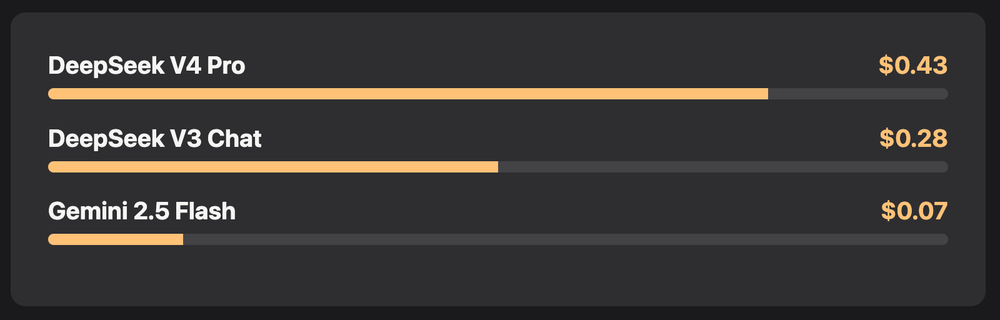
Рекомендуемые три модели для Auto-роутинга
Если используете OpenRouter Auto, в настройках роутинга укажите именно те модели, к которым хотите ограничить доступ. Дорогие модели вроде Claude Opus 4.7 могут съедать $10+ за 10 запросов на сложных задачах. Для старта безопаснее ограничить три:
- Google Gemini 2.5 Flash
- OpenAI GPT-5.4 Nano
- Moonshot Kimi K2.5
Потом расширяете по мере понимания своих сценариев.
Бесплатные модели через OpenRouter
OpenRouter предоставляет несколько моделей полностью бесплатно. Есть рейт-лимиты по запросам в час, доступность может меняться, но для тестирования и лёгкой нагрузки работает.
Актуальные бесплатные варианты на май 2026:
- Minimax M2.5 — хорошо справляется с текстовыми задачами, контекст 1M токенов
- Nvidia Nemotron 3 Super — ориентирован на агентские задачи
- OpenAI GPT-OSS — open-source версия, примерно уровень GPT-4
Для получения бесплатного доступа нужно пополнить счёт хотя бы на $1 — это активирует аккаунт. После этого бесплатные модели работают без списания.
Чтобы выбрать бесплатную модель, которой нет в стандартном меню Hermes, выберите «Enter custom model name» и вставьте идентификатор из карточки модели на openrouter.ai.
Важно: бесплатные модели подходят для знакомства с Hermes. Для серьёзных агентских задач — кодинга, анализа, автоматизации сложных workflows — разница с платными моделями существенная. Это не недостаток Hermes, это математика: более мощный мозг даёт лучший результат.
Nvidia NIM: бесплатные кредиты без VPN
Для работы из России проблема OpenRouter, Anthropic и OpenAI — блокировки и сложности с оплатой. Nvidia NIM решает часть этой проблемы.
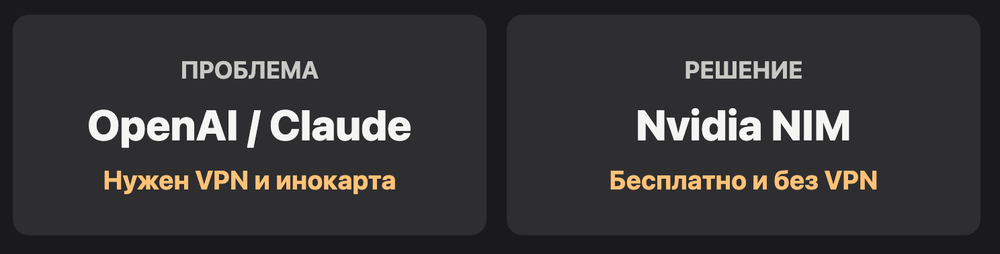
Nvidia предоставляет OpenAI-совместимый API через программу для разработчиков. Доступ бесплатный, достаточно зарегистрироваться на build.nvidia.com. Доступна модель MiniMax M2.7 с контекстным окном 1M токенов — полностью бесплатно.
Настройка в Hermes как кастомного endpoint:
hermes model
# Выберите: Custom OpenAI-compatible endpoint
# Base URL: https://integrate.api.nvidia.com/v1
# API Key: ваш ключ с build.nvidia.com
# Model name: nvidia/minimax-m2.7
Это не ограниченная бета — ключ выдаётся сразу после регистрации, работает стабильно.
Ollama: локальные модели без API-ключей
Ollama запускает open-source модели на вашем железе. Никаких API-ключей, никаких облачных серверов, никакой ежемесячной платы. Данные не покидают машину.
Это важно в двух сценариях: когда у вас чувствительные данные (медицина, финансы, юриспруденция) или когда просто хотите контролировать расходы при высокой нагрузке.
Что нужно для локального запуска
Минимальные требования зависят от модели. Для агентских задач нужна модель, которая умеет работать с инструментами (tool calling). Не каждая локальная модель это умеет — это ограничение самих моделей, не Hermes.
Рекомендованные модели для локального запуска:
| Модель | VRAM | Tool calling | Для чего |
|---|---|---|---|
| GLM 4.7 Flash | 25 GB | Хорошо | Общие агентские задачи |
| Qwen 2.5 Coder 32B | 20 GB | Хорошо | Кодинг |
| Llama 3.1 70B | 40+ GB | Удовлетворительно | Общее назначение |
| Qwen 3.5 | 10-16 GB | Хорошо | Компромисс VRAM/качество |
| Gemma 4 | 12 GB | Хорошо | Быстрые задачи |
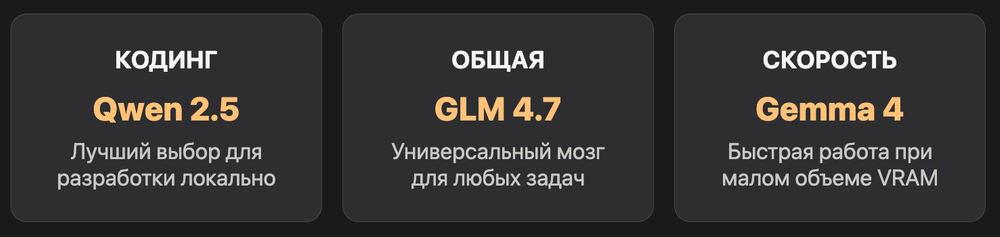
Если производительность локальной модели разочаровала — сначала попробуйте другую модель. Разные модели ведут себя очень по-разному в агентском режиме.
Установка Ollama и запуск модели
# Установка (Linux/macOS)
curl -fsSL https://ollama.ai/install.sh | sh

# Запуск как фоновый сервис
nohup ollama serve > /dev/null 2>&1 &

# Загрузка модели (пример)
ollama pull glm4:flash
Проверьте, что Ollama работает:
ollama listПодключение Ollama к Hermes
hermes model
# Выберите: Custom OpenAI-compatible endpoint
# Base URL: http://127.0.0.1:11434/v1
# API Key: (оставьте пустым или введите любое слово — Ollama не требует ключ)
# Model name: glm4:flash  (точно как указано в ollama list)
Критически важно: Ollama по умолчанию использует маленький контекст. Для агентской работы нужно минимум 16k-32k токенов. Настройте это на стороне Ollama:
OLLAMA_NUM_CTX=32768 ollama serveИли при запуске конкретной модели:
ollama run glm4:flash --num-ctx 32768Без этой настройки агент будет терять контекст на длинных задачах.
LM Studio: локальные модели с графическим интерфейсом
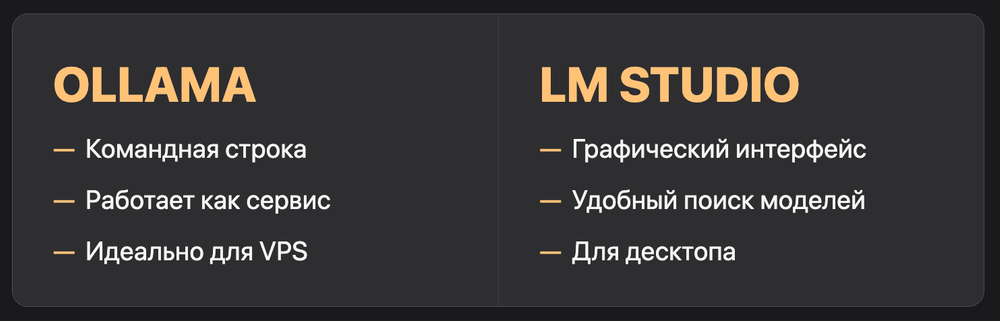
LM Studio — это Ollama с удобным GUI. Подходит тем, кто не хочет разбираться с командной строкой для управления локальными моделями.
Принцип работы тот же: LM Studio поднимает локальный сервер, совместимый с OpenAI API. Hermes подключается к нему как к кастомному endpoint.
Настройка
В LM Studio: откройте раздел «Server», включите сервер (порт по умолчанию 1234), загрузите модель.
В Hermes:
hermes model
# Выберите: Custom OpenAI-compatible endpoint
# Base URL: http://localhost:1234/v1
# API Key: (пустое или любое значение)
# Model name: имя модели точно как в LM Studio
Ollama vs LM Studio: что выбрать
| Параметр | Ollama | LM Studio |
|---|---|---|
| Интерфейс | Командная строка | Графический |
| Автозапуск как сервис | Легко через systemd | Нужно держать открытым |
| Производительность | Одинаковая | Одинаковая |
| Управление моделями | CLI | GUI |
| VPS/сервер | Да | Нет (только десктоп) |
Для VPS и постоянной работы — Ollama. Для десктопного использования с визуальным управлением — LM Studio.
Anthropic напрямую: Claude с кешированием промптов
Если хотите работать с Claude напрямую, минуя OpenRouter, Hermes поддерживает нативный Anthropic API.
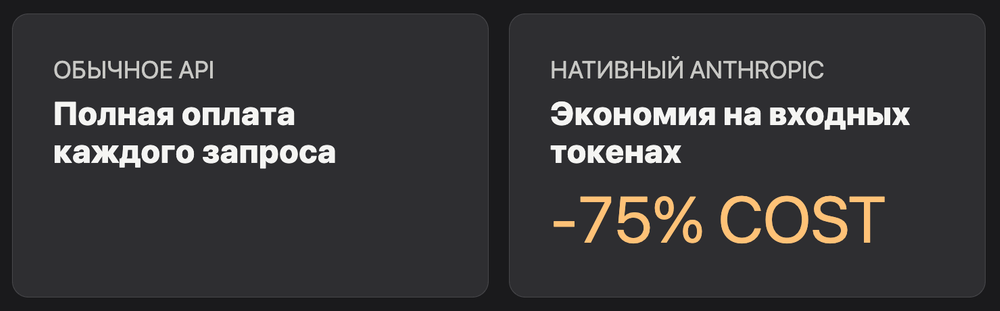
Преимущество нативного подключения: Hermes использует автоматическое кеширование промптов Anthropic. Системный промпт кешируется на всю сессию — каждый следующий запрос переиспользует кеш. Экономия около 75% на input-токенах при длинных многоходовых разговорах.
hermes model
# Выберите: Anthropic
# Введите API-ключ с console.anthropic.com
# Выберите модель: Claude Sonnet 4.6 или Claude Opus 4.7
Модели от дешёвой к дорогой:
- Claude Haiku 4.5 — быстрая, дешёвая, для простых задач
- Claude Sonnet 4.6 — лучший баланс цена/качество для большинства агентских задач
- Claude Opus 4.7 — самая мощная, для сложного кодинга и анализа
Про Россию: прямой доступ к Anthropic API из России ограничен — нужен VPN или VPS за рубежом. Через OpenRouter ситуация проще, т.к. запросы идут через инфраструктуру OpenRouter.
OpenAI и DeepSeek напрямую
Hermes поддерживает OpenAI API нативно. Настройка аналогична — выбираете провайдер OpenAI, вставляете ключ.
DeepSeek имеет собственный OpenAI-совместимый API. Подключается как кастомный endpoint:
hermes model
# Выберите: Custom OpenAI-compatible endpoint
# Base URL: https://api.deepseek.com/v1
# API Key: ваш ключ с platform.deepseek.com
# Model name: deepseek-chat (V3) или deepseek-coder
DeepSeek V4 Pro через их прямой API обходится дешевле, чем через OpenRouter — $0.43/M input токенов против немного выше через посредника. Для высоких объёмов разница ощутима.
Как выбрать провайдера: практическая таблица
| Сценарий | Рекомендация | Причина |
|---|---|---|
| Хочу попробовать Hermes бесплатно | OpenRouter (бесплатный тир) или Nvidia NIM | Нулевые расходы |
| Ежедневная автоматизация, нет чувствительных данных | OpenRouter Auto | Экономия + гибкость моделей |
| Кодинг и отладка | DeepSeek V4 Pro через OpenRouter или напрямую | Лучшее соотношение цена/качество для кода |
| Сложные многошаговые задачи | Claude Sonnet 4.6 / Opus 4.7 | Лучшие рассуждения и следование инструкциям |
| Чувствительные данные (медицина, финансы) | Ollama + GLM 4.7 Flash или Qwen 3.5 | Данные не покидают железо |
| Работа из России без VPN | Nvidia NIM + MiniMax M2.7 | Доступно напрямую |
| VPS 24/7 + экономия | OpenRouter Auto с лимитом $25/мес | Авто-роутинг на дешёвые модели |
| Максимальное качество ответов | Claude Opus 4.7 (нативно или через OpenRouter) | Лучший агентский LLM |
Настройка API-ключей для российских пользователей
Это практически важный раздел, который часто обходят стороной.
OpenRouter — принимает карты Visa/Mastercard российских банков. Не всегда, зависит от эмитента. Если не проходит обычная карта, попробуйте виртуальную карту через сервисы типа Revolut, Wise или криптовалютное пополнение.
Nvidia NIM — регистрация через email, без платёжных данных для бесплатного тира. Самый простой способ начать.
Anthropic и OpenAI — прямая оплата из России заблокирована. Варианты: VPN + иностранная карта, или работать через OpenRouter как прокси.
DeepSeek — китайский сервис, принимает WeChat Pay и Alipay. Для российских карт ситуация нестабильная — лучше через OpenRouter.
Ollama и LM Studio — полностью бесплатны, ничего не нужно.
Мастер сделает это за вас. Если возиться с ключами и пополнением счета модели не хочется, Hermes Start проведет по шагам: вы вставляете ключ ИИ-модели, а программа настраивает остальное. Потом в пульте видны остаток на счете модели и прогноз «хватит примерно на N недель», так что расходы не приходится считать вручную. Сам Hermes бесплатный, счет модели пополняется отдельно, способы оплаты меняются, поэтому актуальный проверяйте на сайте модели на дату покупки. Российской картой покупается сама программа.
Переключение модели на лету: slash-команды
Несколько полезных команд, которые упрощают работу с разными моделями:
/model          — интерактивное меню смены модели
/model deepseek — быстрое переключение, если знаете имя
/reasoning low  — снизить глубину рассуждений (экономит токены на простых задачах)
/reasoning high — максимальная глубина для сложных задач
/usage          — текущий расход токенов и лимиты
Умная маршрутизация в Hermes: если задача сформулирована как простой вопрос, агент может сам переключиться на более дешёвую модель (при настроенном auto-routing в OpenRouter). При сложном кодинге — эскалирует на мощную модель.
Поставить Hermes руками бесплатно, но нужен терминал и час-полтора времени. Hermes Start делает это за вас примерно за 30 минут и дальше остается пультом: показывает, все ли работает и сколько осталось на счете модели.
Три причины завести такого помощника
Любая нейросеть внутри. Модель в Hermes меняется за минуту: если одна ИИ-модель подорожала или перестала работать, помощник остается с вами, а память и навыки сохраняются. Это не привязка к одной компании на годы, подробности про больше 20 поставщиков описаны выше. Программа Hermes Start при установке подключает DeepSeek, а сменить модель можно позже в пульте, в разделе «Модель и ключ».
Помощник учится и превращает решенное в навык. Вы решили сложную задачу, и помощник сохраняет процедуру как навык: когда применять, какие шаги и какие грабли. В следующий раз он сам подтягивает нужный навык и делает сразу правильно, без объяснений с нуля, а обычный чат каждый раз начинает с чистого листа. Навыки накапливаются, совместимы с открытым стандартом agentskills.io, готовых в реестрах тысячи. Ставьте навыки только из проверенных источников: через случайные можно подменить инструкции помощника.
Подключение сервисов без программирования. Через Composio помощник подключается к Google Документам и Таблицам, Notion, GitHub, Slack и календарям: по данным Composio, сервисов больше полутора тысяч. В чате это выглядит как «подключи Gmail», вход по логину и готово. Дальше помощник не советует, а сам правит документ, заполняет таблицу и заводит задачу там, где вы и так работаете. Условия тарифов Composio проверяйте на его сайте.
FAQ
Можно ли использовать Hermes Agent совсем бесплатно? Да. Два пути: OpenRouter с бесплатными моделями (Minimax M2.5, Nemotron) или Ollama с локальными моделями. В обоих случаях сам Hermes бесплатен, платите только за мощное железо или пополнение OpenRouter на $1 для активации.
Какая модель лучше всего работает с Hermes? Нет универсального ответа. Claude Sonnet 4.6 и Claude Opus 4.7 дают лучшее следование инструкциям и наименьший процент ошибок при агентских задачах. DeepSeek V4 Pro — отличный выбор для кодинга по соотношению цена/качество. Для локального запуска — GLM 4.7 Flash или Qwen 3.5.
Hermes agent API key — где взять? Это не ключ самого Hermes (агент бесплатный и ключей не требует). Ключ нужен для выбранного вами LLM-провайдера: OpenRouter на openrouter.ai, Anthropic на console.anthropic.com, Nvidia на build.nvidia.com. Ollama ключей не требует.
Работает ли LM Studio с Hermes на Windows? Да. LM Studio запускается нативно на Windows, поднимает локальный API-сервер. Hermes подключается к нему через WSL2, указывая адрес хост-машины Windows: http://host.docker.internal:1234/v1 или ip-адрес вашей Windows-машины.
Насколько дорого обходится Hermes при активном использовании? Зависит от модели. На Claude Opus 4.7 при нескольких сложных задачах в день — $30-100/месяц. На GPT-5.4 mini — $5-20/месяц. На DeepSeek V3.2 — $3-10/месяц. На OpenRouter Auto с бюджетными моделями — $1-5/месяц. Всегда устанавливайте кредитный лимит в OpenRouter.
Что значит контекстное окно 64k? Почему это важно? Контекстное окно — сколько текста модель держит «в уме» за одну задачу. Hermes при агентской работе генерирует длинные цепочки вызовов инструментов, истории разговоров, результаты. Модель с 8k контекста просто не вместит всё это и начнёт «забывать» начало задачи. 64k — минимальный комфортный размер. У Claude — 200k, у MiniMax M2.7 через Nvidia NIM — 1M.
Можно ли подключить к Hermes мою корпоративную LLM? Да. Если корпоративная LLM предоставляет OpenAI-совместимый API endpoint — укажите его как кастомный endpoint в настройках. Base URL, API-ключ (если требуется), имя модели.
Чем Hermes Start отличается от самого Hermes? Hermes, бесплатный открытый помощник команды Nous Research, можно поставить самому через терминал. Hermes Start, программа для Mac и Windows, делает установку за человека: ставит Hermes, подключает Telegram и доводит до первой выполненной задачи примерно за 30 минут.
Полный обзор Hermes Agent — в нашей статье про возможности и архитектуру. Сравнение с OpenClaw — здесь. Другие AI-инструменты и IDE — в каталоге VibeCoderz.
Если хотите разобраться, какая конфигурация моделей подойдёт под ваши задачи и бюджет, запишитесь на консультацию к Максиму.
Обновлено: октябрь 2026
