Контекстное окно LLM — это объем текста, который модель держит в голове за один запрос: ваше сообщение, вся история переписки, системный промпт и прикрепленные файлы. Как только объем превышает лимит, старые куски разговора выпадают, и модель буквально перестает их видеть. Ниже разберем, что такое контекстное окно на пальцах, сколько токенов дают модели в 2026 году и почему увеличение окна не всегда делает ответы лучше.
Контекстное окно измеряется в токенах, а не в словах или символах. У топовых моделей 2026 года оно доходит до 1-2 млн токенов, но чем оно больше, тем выше цена, вычислительные затраты и риск, что модель потеряет важную деталь где-то в середине текста.
Что такое контекстное окно LLM простыми словами?
Контекстное окно, это рабочая память модели на один разговор. Все, что в нее не поместилось, модель не помнит и может начать додумывать.
Представьте прямоугольник фиксированного размера. Ваше сообщение, ответ модели, следующее сообщение, следующий ответ, все складывается в этот прямоугольник по очереди. Пока диалог помещается целиком, модель отвечает с учетом всего, что было сказано раньше. Когда переписка становится длиннее размера окна, часть старых сообщений просто перестает существовать для модели.
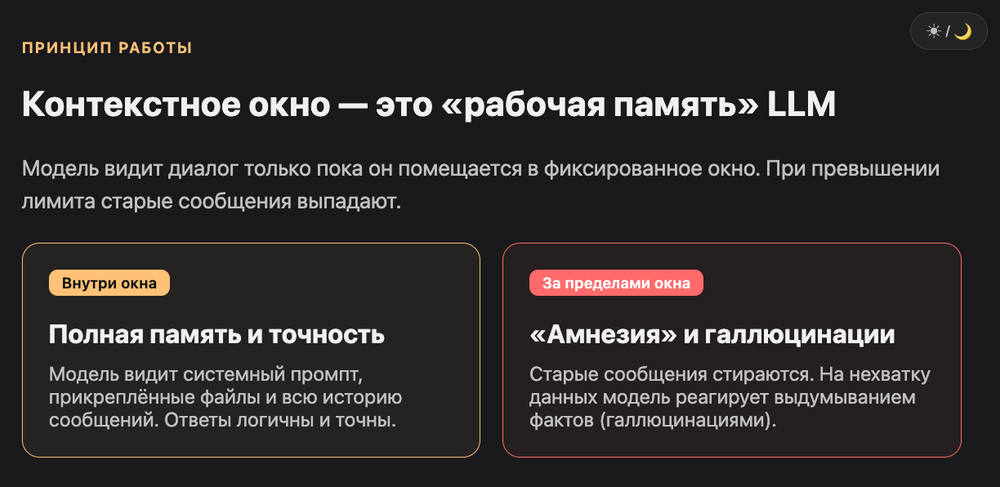
Отсюда и ощущение, что чат-бот "тупеет" к концу долгого разговора. Он не глупеет, он теряет доступ к началу. На нехватку данных модель реагирует так же, как человек с частичной амнезией: пытается угадать, что было раньше, по обрывкам, которые еще видит. Иногда угадывает верно, иногда выдумывает то, чего не было, это и называют галлюцинацией.
Что такое токен и как из него собирается контекстное окно?
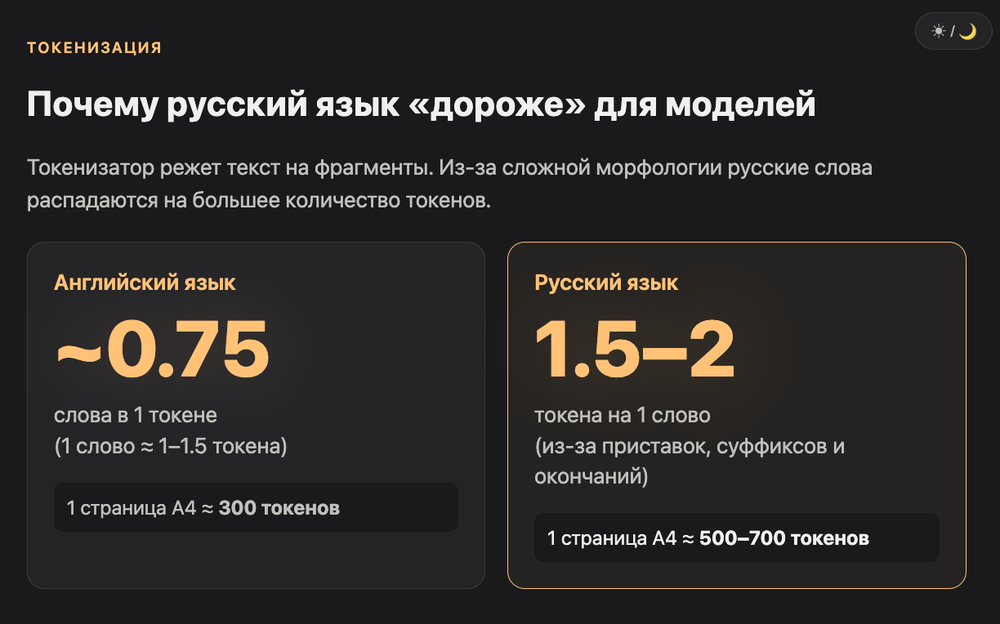
Токен, это не буква и не слово, а единица, на которую модель режет текст. Английское слово обычно занимает 1-1,5 токена, русское из-за морфологии, до 1,7-2.
Токенизатор режет фразу не по пробелам, а по фрагментам, которые чаще встречаются в обучающих данных. Слово "стол" может остаться целым токеном, а "столовая" разбивается на "стол" и "овая", потому что вторая часть используется в куче других слов. Знаки препинания, пробелы и даже разметка markdown тоже съедают токены.
Для русского языка это особенно важно. Из-за приставок, суффиксов и падежных окончаний один токенизатор может разбить обычное слово на два-три куска. Практический ориентир: одна страница текста А4 на русском занимает примерно 500-700 токенов, а не 300, как было бы для английского аналога того же объема.
Сколько токенов занимает разный контент
Ниже прикидка, чтобы понимать масштаб, а не точные цифры для конкретного текста.
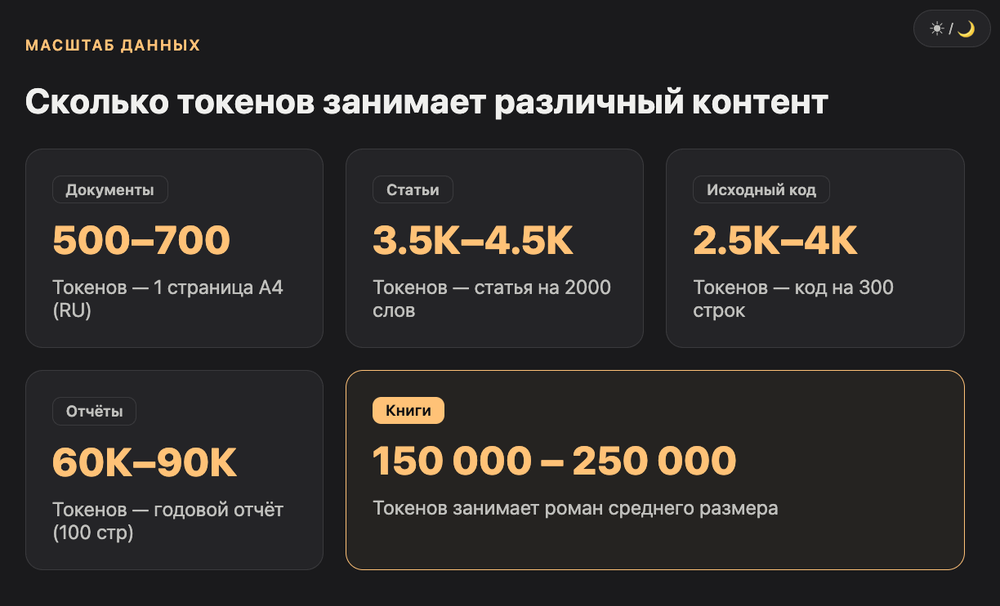
| Тип контента | Примерный объем в токенах |
|---|---|
| Одна страница А4 (русский) | 500-700 |
| Статья на 2000 слов | 3500-4500 |
| Небольшой файл кода (300 строк) | 2500-4000 |
| Роман среднего размера | 150 000-250 000 |
| Годовой отчет компании (100 страниц) | 60 000-90 000 |
Сколько токенов помещается в контекстное окно моделей в 2026 году?
Топовые модели в 2026 году держат от 128 тысяч до 2 миллионов токенов контекста. Разница в цене между окном 128К и 1М кратная, поэтому выбор модели зависит от задачи, а не только от размера окна.
Anthropic, OpenAI, Google и DeepSeek за последний год синхронно подняли лимиты. Claude Sonnet 4.6 и Opus 4.7 держат по 1 млн токенов входа, GPT-5.4 чуть больше, Gemini 3.1 Pro тоже на миллионе, а Grok 4.1 Fast от xAI ушел дальше всех, до 2 млн, за счет специализации на длинных юридических документах.
Ниже сравнение по состоянию на март 2026 года. Цены указаны за 1 млн токенов, вход и выход через API.
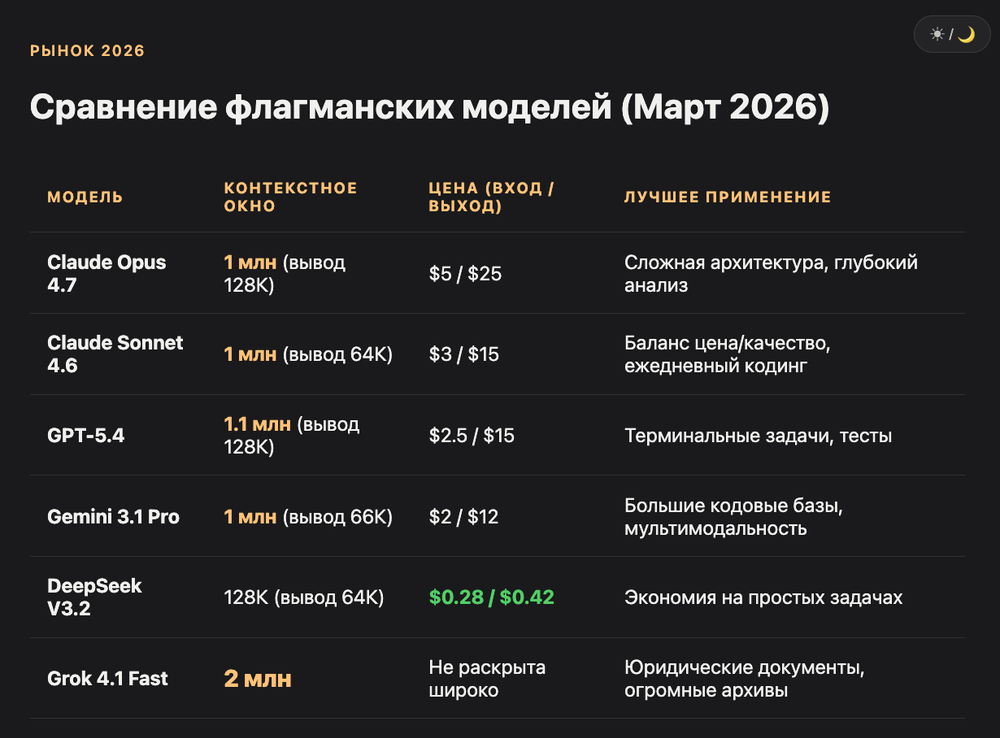
| Модель | Контекстное окно | Цена вход/выход | Лучше всего для |
|---|---|---|---|
| Claude Opus 4.7 | 1 млн / вывод 128К | $5 / $25 | Сложная архитектура, глубокий анализ |
| Claude Sonnet 4.6 | 1 млн / вывод 64К | $3 / $15 | Баланс цена/качество, ежедневный кодинг |
| GPT-5.4 | 1,1 млн / вывод 128К | $2,5 / $15 | Терминальные задачи, тесты |
| Gemini 3.1 Pro | 1 млн / вывод 66К | $2 / $12 | Большие кодовые базы, мультимодальность |
| DeepSeek V3.2 | 128К / вывод 64К | $0,28 / $0,42 | Экономия на простых задачах |
| Grok 4.1 Fast | 2 млн | не раскрыта широко | Юридические документы, огромные архивы |
Для сравнения, еще пару лет назад стандартом были 4000-8000 токенов, и модель забывала диалог уже после пары сообщений. Рост в 100-200 раз за короткий срок и правда сделал контекстное окно почти безлимитным для бытовых задач вроде переписки. С кодовыми базами на сотни тысяч строк ситуация другая, о ней ниже.
Что реально занимает место в контекстном окне кроме вашего текста?
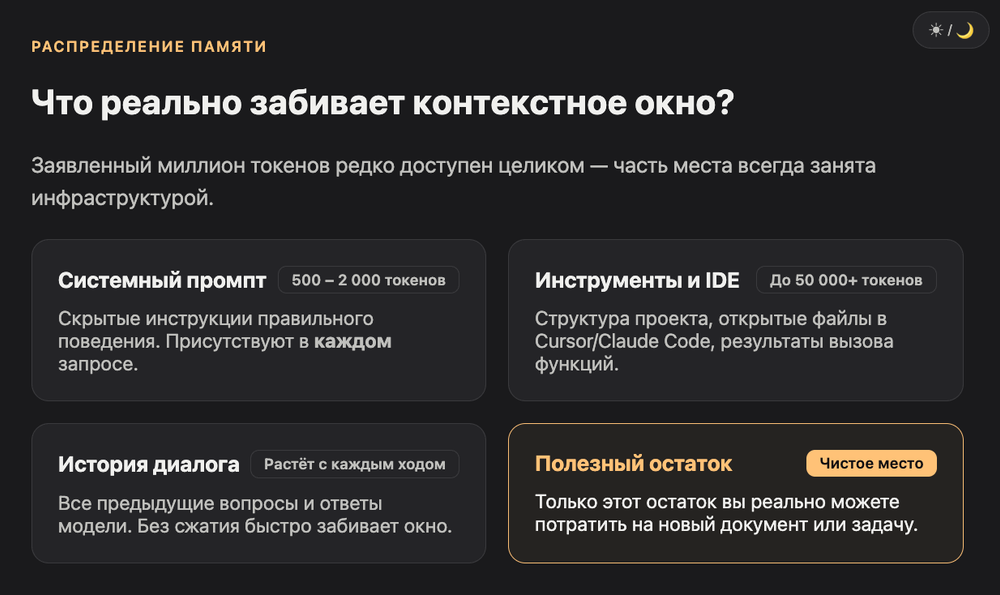
В контекстное окно входит не только ваше сообщение. Туда же садятся системный промпт, вся история диалога, прикрепленные файлы и данные, которые агент подгружает сам.
Системный промпт, скрытая инструкция, которая задает модели правила поведения, обычно занимает от нескольких сотен до пары тысяч токенов и присутствует в каждом запросе, даже если вы его не видите. Если вы работаете в Cursor или Claude Code, туда же добавляется структура проекта, открытые файлы и результаты вызова инструментов.
Поэтому цифра "1 миллион токенов" на практике редко доступна целиком. Часть съедает системный промпт, часть уходит на историю переписки, и только остаток можно потратить на новый документ или кусок кода. Мы в VibeCoderz регулярно видим, как новички загружают в чат весь проект целиком и удивляются, почему модель отвечает мимо задачи, окно забито шумом, а не потому что оно маленькое.
Почему модель забывает начало длинного разговора?
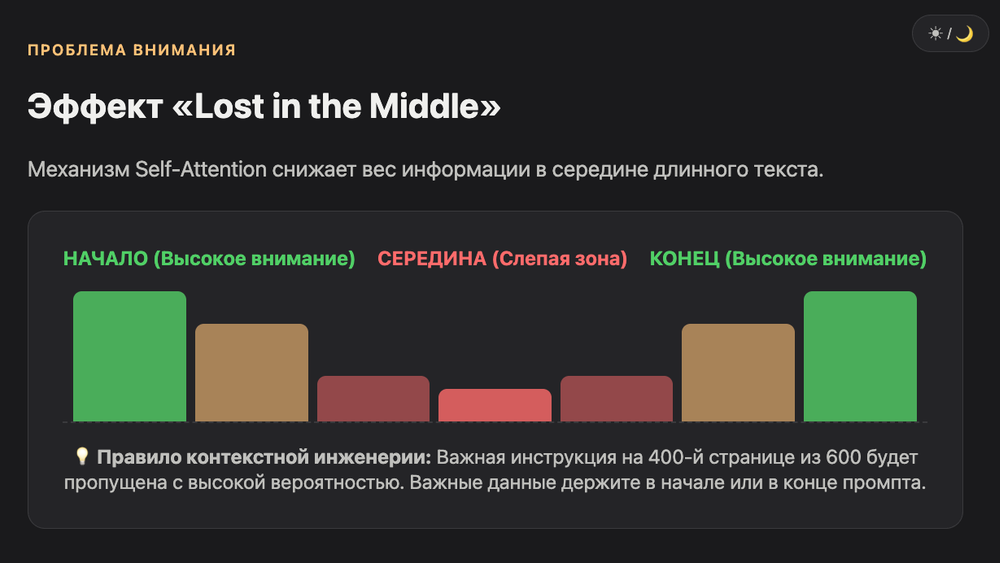
Даже если контекстное окно технически не переполнено, модель хуже использует информацию из середины длинного текста. Это явление называют lost in the middle, и оно подтверждено исследованиями Стэнфорда.
Механизм self-attention присваивает каждой паре токенов вес важности. Чем длиннее последовательность, тем сильнее размывается внимание, а данные ровно в середине документа получают вес ниже, чем начало или конец. Модель технически видит текст целиком, но опирается на него неравномерно.
На практике это значит: если нужный факт спрятан на 400-й странице из 600, шанс, что модель его пропустит, выше, чем если бы он был на первой или последней. Отсюда практический совет из мира разработки: важные инструкции и ключевые данные лучше держать в начале или в конце запроса, а не закапывать в середину длинной простыни текста.
Что теряет модель при слишком большом контексте?
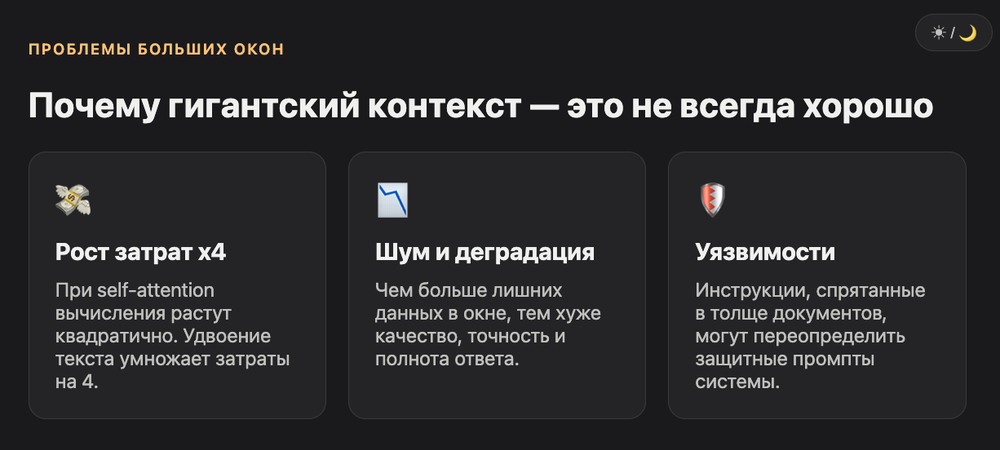
Большое контекстное окно не бесплатно. Вычисления растут квадратично от длины текста, качество ответа может падать, а спрятанные в документе инструкции способны обойти защиту модели.
При self-attention каждый токен сравнивается с каждым другим, поэтому при удвоении длины текста вычислительные затраты растут не в два, а примерно в четыре раза. Для API это прямые деньги, для локальных моделей, память видеокарты.
Есть и вторая проблема, качество. Формулу для нее можно сформулировать грубо: корректность и полнота ответа растут, а вот шум и лишний объем текста их портят. Чем больше в окне нерелевантных данных, тем хуже итог, даже если технически места хватает с запасом. И третье, безопасность: инструкция, спрятанная глубоко в загруженном документе, теоретически может попытаться переопределить поведение модели, если система не фильтрует такие вставки.
Как управлять контекстным окном на практике?
Профи не грузят в модель весь проект разом. Они дают только релевантные файлы, сохраняют промежуточные результаты в отдельный файл и держат заполнение окна в районе 40-50% от максимума.
Здесь работает правило, которое встречается во всех практических разборах контекстной инженерии: релевантность важнее объема. Вместо того чтобы кидать модели 500 страниц документации и просить найти баг, эффективнее выделить 3-5 файлов, которые точно относятся к задаче. Инструменты вроде Claude Code и Cursor умеют автоматически сжимать историю диалога при приближении к лимиту, превращая старые сообщения в краткое резюме, а последние сообщения оставляя как есть.
Лиза: «Для одной ниши в Текст Заводе мы отдаем модели сразу полтора миллиона ключей и 90 листов Excel. Большое окно берет такой объем без нарезки на части. Руками я бы до половины этих запросов никогда не додумалась, прикинь.»
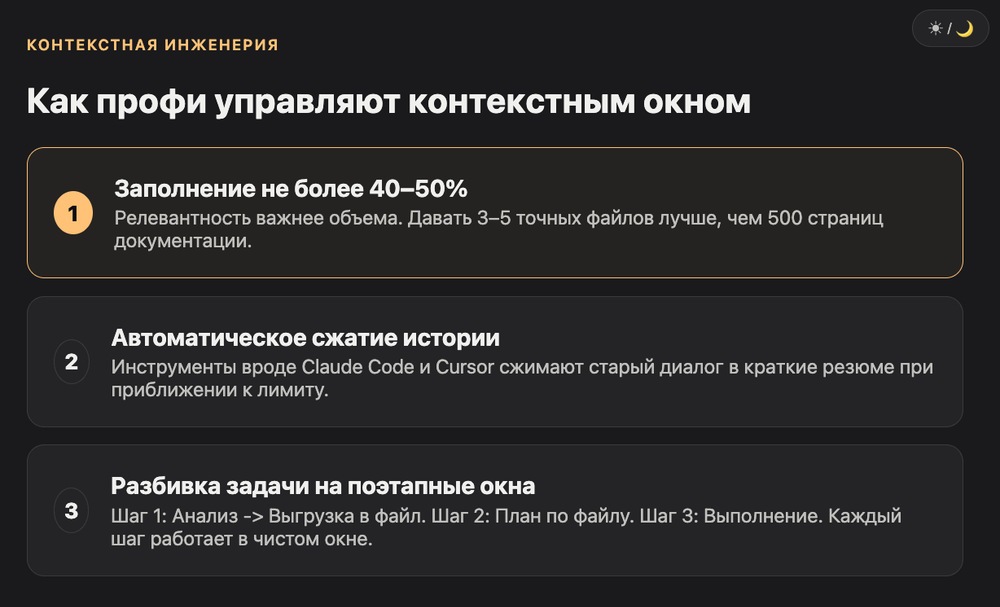
Второй прием, разбивка задачи на этапы вместо одного гигантского запроса. Сначала модель изучает кодовую базу и записывает выводы в отдельный файл, потом другой запрос читает эти выводы и строит план, третий выполняет план по шагам. Каждый этап работает в своем окне и не тащит за собой весь предыдущий шум.
Какое контекстное окно выбрать под задачу в 2026 году
Для переписки, коротких статей и большинства бытовых задач хватает окна в 64-128 тысяч токенов, ребят, это правда работает без переплаты за огромный лимит. Загрузка целой кодовой базы, юридического договора на сотни страниц или большого архива логов требует моделей с окном от 1 млн токенов, и тут разумно смотреть на Claude Opus 4.7, GPT-5.4 или Gemini 3.1 Pro в зависимости от задачи.
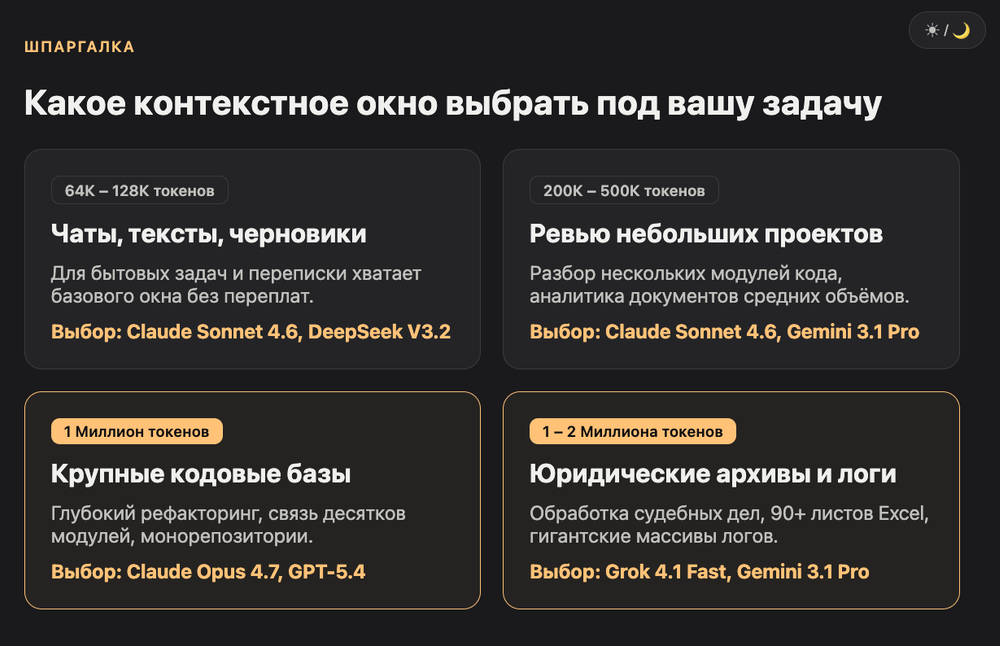
| Задача | Рекомендуемое окно | Модель на выбор |
|---|---|---|
| Чат, короткие тексты, черновики | 64-128К | Claude Sonnet 4.6, DeepSeek V3.2 |
| Ревью небольшого проекта | 200-500К | Claude Sonnet 4.6, Gemini 3.1 Pro |
| Крупная кодовая база, рефакторинг | 1 млн | Claude Opus 4.7, GPT-5.4 |
| Юридические документы, огромные архивы | 1-2 млн | Grok 4.1 Fast, Gemini 3.1 Pro |
Каталог обзоров всех инструментов, которые работают с большими контекстными окнами, включая Claude Code, Cursor и Windsurf, смотрите в каталоге AI IDE на VibeCoderz. Если вы только начинаете разбираться в теме, посмотрите подборку промптов и задач для новичков в каталоге AI-агентов.
Частые вопросы про контекстное окно LLM
Сколько это токенов, если считать в обычных словах? Для английского языка один токен примерно равен 0,75 слова. Для русского пропорция хуже из-за морфологии: одно слово часто занимает 1,5-2 токена, поэтому русский текст "весит" в токенах больше, чем такой же по смыслу английский.
Что произойдет, если контекстное окно переполнится? Модель или инструмент автоматически обрежет либо сожмет самые старые сообщения. Claude Code и Cursor делают это через сжатие истории в резюме, а часть простых интерфейсов просто откажется принять слишком длинный запрос с ошибкой лимита.
Можно ли увеличить контекстное окно самому? Нет, размер окна задан архитектурой модели и типом подписки или тарифа API. Можно только выбрать модель с большим окном или использовать RAG, чтобы не грузить документ целиком.
Почему русский текст съедает больше токенов, чем английский? Из-за приставок, суффиксов и падежных окончаний токенизатор чаще режет русские слова на несколько частей. В среднем на русском один токен покрывает меньше символов, чем на английском.
Чем лимит вывода отличается от контекстного окна? Контекстное окно, это все, что модель видит: ваш запрос плюс история. Лимит вывода, это отдельное ограничение на длину самого ответа, обычно оно в разы меньше общего окна.
Нужно ли новичку разбираться в размере контекстного окна? Да, хотя бы на базовом уровне. Понимание того, почему модель "забывает" начало разговора, экономит часы на попытках понять, что пошло не так, особенно при работе с длинными документами или большим проектом.
Какая модель в 2026 году держит самое большое контекстное окно? На момент обновления статьи это Grok 4.1 Fast от xAI с окном в 2 млн токенов, в основном за счет специализации на юридических документах. Среди универсальных моделей лидируют GPT-5.4 и модели линейки Claude и Gemini с окном около 1 млн токенов.
Если нужна помощь с выбором модели и настройкой контекста под конкретный проект, запишитесь на консультацию к Максиму, он разберет вашу задачу и подскажет, какое окно и какой инструмент реально нужны, без переплаты за лишние токены.
Обновлено: октябрь 2026