
Llama.cpp — это движок инференса на C/C++, на котором построены Ollama, LM Studio и десятки других программ для локального запуска нейросетей. Когда вы жмете кнопку "загрузить модель" в удобном интерфейсе, под капотом всё равно работает именно он. В этой статье разберем, что такое llama.cpp на самом деле, чем он отличается от обёрток вокруг него и когда есть смысл ставить его напрямую, минуя привычные приложения.
Llama.cpp — движок инференса моделей на C/C++ без тяжелых зависимостей вроде PyTorch. Ollama и LM Studio — обёртки над ним с удобным интерфейсом. Ниже: происхождение движка, три честные причины работать с ним напрямую, установка на Windows, режим llama-server и таблица сравнения с Ollama.
Что такое llama.cpp простыми словами?
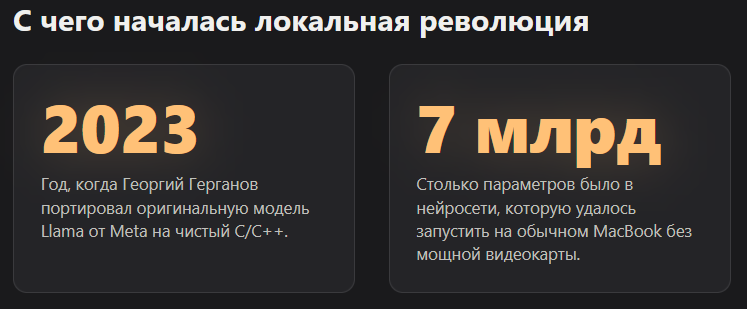
Llama.cpp — библиотека на C/C++ для запуска больших языковых моделей на обычном железе, включая процессор без видеокарты. Автор — Georgi Gerganov, старт проекта — весна 2023 года, сразу после релиза Llama от Meta.
Georgi Gerganov выпустил первую версию llama.cpp в марте 2023 года как порт модели Llama на чистый C/C++, без Python и без PyTorch. Задача была простая: заставить нейросеть в 7 миллиардов параметров крутиться на macbook без видеокарты. Получилось, и именно этот момент запустил всю нынешнюю волну локального ИИ.
До llama.cpp большая языковая модель ассоциировалась с кластером видеокарт в дата-центре. После — с файлом, который можно скачать и запустить на ноутбуке. Разница принципиальная: модель как сервис в облаке против модели как файла на диске.
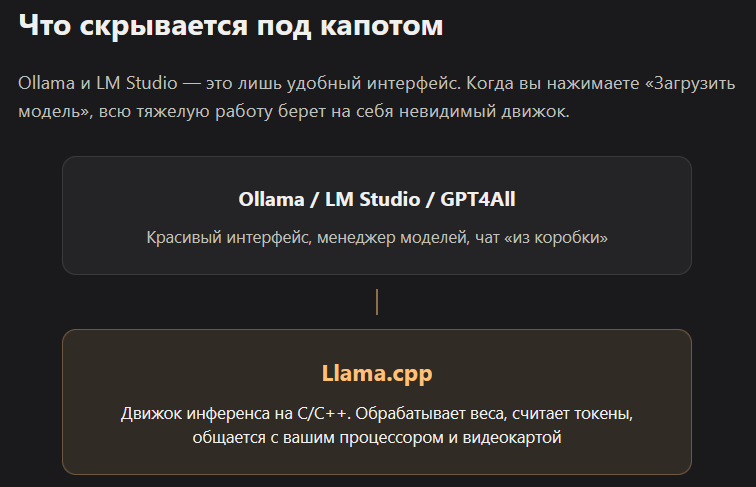
Философия проекта не менялась три года: минимум зависимостей, максимум производительности, поддержка максимально разного железа. Именно поэтому Ollama, LM Studio, GPT4All и еще десяток похожих программ не стали писать инференс с нуля, а взяли llama.cpp за основу.
Как llama.cpp связан с Ollama и LM Studio?
Ollama и LM Studio — надстройки над llama.cpp с готовым интерфейсом, менеджером моделей и автоматическими настройками. Сам движок инференса в обоих случаях — llama.cpp, часто более старой версии, чем актуальная в апстриме.
Прямая связь подтверждается на практике. В сравнительном тесте Ollama против llama.cpp на Windows автор отметил: LM Studio и другие подобные программы по сути используют устаревшую и более ограниченную версию llama.cpp. Апстрим-репозиторий обновляется быстрее, чем успевают подтягивать изменения обёртки.
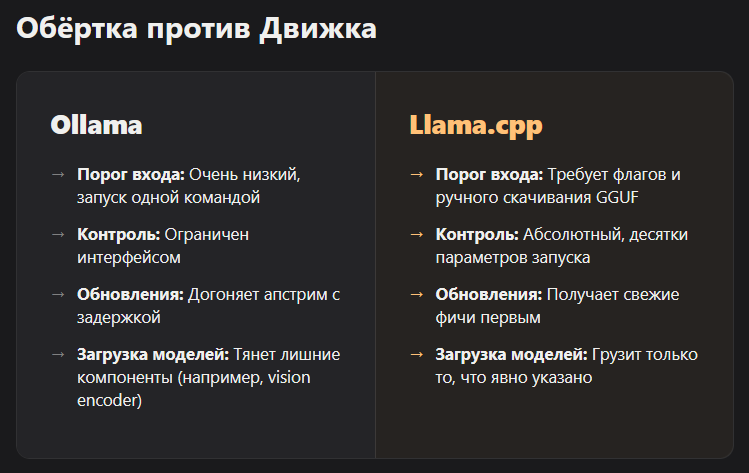
Отсюда и разница в поведении. Ollama упрощает запуск, но иногда грузит модель дольше и с лишними компонентами, вроде vision encoder, который не нужен для текстовой задачи. Llama.cpp такого не делает: вы явно указываете, что и как загружать.
На VibeCoderz мы уже разбирали Ollama и LM Studio отдельно, с точки зрения удобного использования — заглядывайте в каталог AI-инструментов, там оба разобраны подробно. Здесь же смотрим на то, что находится под капотом у обеих программ.
Зачем работать с llama.cpp напрямую?
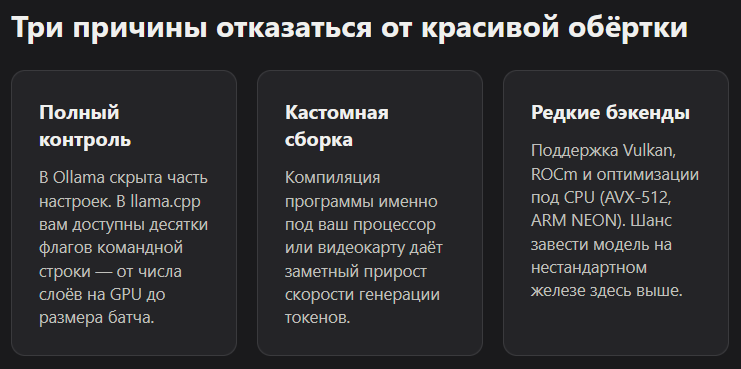
Три причины: полный контроль над параметрами запуска, прирост скорости от кастомной сборки под конкретное железо и поддержка бэкендов, которых нет в упрощенном интерфейсе обёрток.
В llama.cpp доступны десятки флагов командной строки — от количества слоев на GPU до размера батча при обработке промпта. В Ollama часть этих настроек скрыта или недоступна вообще, потому что интерфейс рассчитан на "поставил и работает", а не на тонкую настройку.
Кастомная сборка под конкретное железо — второй аргумент. Компиляция с флагами именно под вашу видеокарту или процессор часто дает заметный прирост против универсальной сборки, которую тянет за собой обёртка. В одном из технических разборов авторы показали разницу: правильно подобранное число потоков CPU может отличаться от значения, которое LM Studio выставляет автоматически, и это напрямую сказывается на скорости генерации.
Третья причина — бэкенды ускорения. Помимо CUDA для видеокарт Nvidia, llama.cpp поддерживает Vulkan как кроссплатформенный вариант для AMD и Intel, а также ROCm и оптимизации под CPU через инструкции AVX2, AVX-512 и ARM NEON. Если у вас нестандартное железо, шанс получить рабочую сборку у llama.cpp выше, чем у готовой обёртки.
Сборка из исходников на Windows и Linux
На Windows сборка требует компилятора через Visual Studio Build Tools и настройки CMake с флагами под нужный бэкенд. На Linux процесс обычно проще: инструменты сборки чаще уже стоят в системе.
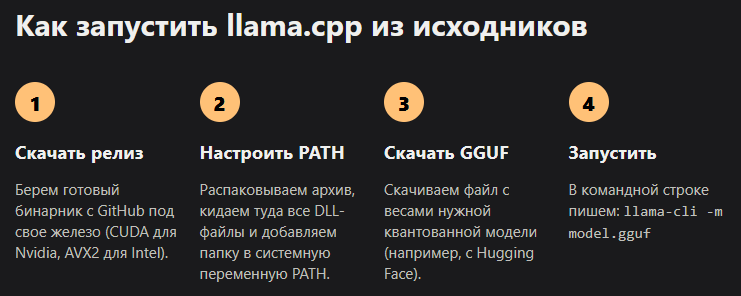
Практический путь на Windows такой: скачать готовый бинарный файл с официального репозитория на GitHub, а не собирать из исходников с нуля, если задача не требует специфичных флагов. Выбор бинарника зависит от железа: под Nvidia — сборка с поддержкой нужной версии CUDA, под Intel CPU без видеокарты — сборка с AVX2 или AVX-512 в зависимости от процессора, под AMD — соответствующий вариант CPU или GPU.
Дальше идет распаковка архива, перенос файлов в отдельную папку и добавление этой папки в системную переменную PATH. Отдельный нюанс — DLL-файлы из архива нужно положить туда же, куда указывает PATH, иначе llama-cli не найдет нужные библиотеки при запуске. После этого модель в формате GGUF скачивается отдельно, и команда llama-cli -m имя_файла.gguf запускает её прямо из командной строки.
Если действительно нужна сборка из исходников — например, под редкое железо вроде Strix Halo с Vulkan — потребуется CMake с флагами под конкретный бэкенд и, для Windows, набор Visual Studio Build Tools. На Linux эта же сборка обычно занимает несколько команд без лишней настройки окружения.
Llama.cpp или Ollama - что выбрать?
Для быстрого старта Ollama удобнее: одна команда, автоматическая загрузка модели, чат из коробки. Llama.cpp сложнее в настройке, но дает больше контроля над скоростью и памятью на конкретном железе.
Сравнение двух программ на одном и том же железе показало предсказуемую картину: Ollama проще, llama.cpp быстрее при правильной настройке. Разница особенно заметна на слабых видеокартах, где важно точно управлять, сколько слоев модели уйдет на GPU, а сколько останется на CPU.
| Критерий | Ollama | llama.cpp |
|---|---|---|
| Порог входа | Низкий, одна команда | Выше, нужны флаги и путь к GGUF |
| Контроль над параметрами | Ограничен интерфейсом | Полный, десятки флагов |
| Скорость обновлений | Догоняет апстрим | Обновляется первым |
| Загрузка больших моделей | Иногда медленнее, лишние компоненты | Быстрее, без лишнего |
| Серверный режим | Есть, упрощенный | llama-server, более гибкий |
| Подходит для | Быстрого старта, повседневных задач | Тонкой настройки под железо |
Если задача — быстро запустить модель и пообщаться с ней, Ollama или LM Studio закрывают это за пару минут. Если задача — выжать максимум токенов в секунду из конкретной видеокарты, разговор идет уже про llama.cpp и его параметры.
Что такое llama-server и зачем он нужен?
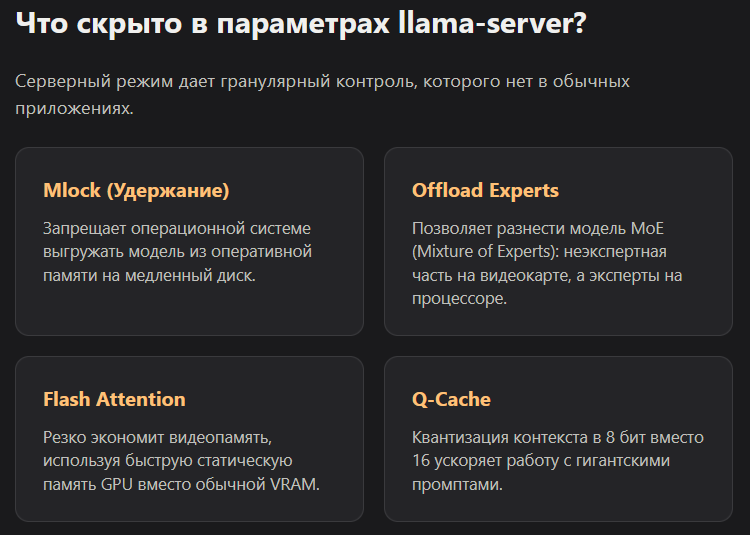
Llama-server — серверный режим llama.cpp, поднимающий локальный API поверх модели. Работает по тому же принципу, что серверный режим Ollama, но с более гранулярным контролем параметров запроса и производительности.
Llama-server пригождается именно тогда, когда вы уже уперлись в ограничения серверного режима более простых обёрток. Через него доступны параметры, напрямую влияющие на скорость: mlock удерживает модель в оперативной памяти и не дает системе выгружать её на диск, offload experts переносит неэкспертную часть модели-архитектуры Mixture of Experts на видеопамять, а самих экспертов держит на CPU — в отдельном разборе это давало прирост скорости почти вдвое.
Flash Attention экономит видеопамять за счет использования быстрой статической памяти видеокарты вместо обычной VRAM, а квантизация кэша в 8 бит вместо 16 ускоряет работу на очень больших контекстах, хотя на средних контекстах эффект почти незаметен. Отдельно стоит проверить количество потоков CPU: оптимальным чаще оказывается число физических ядер, а не то, что LM Studio выставляет автоматически.
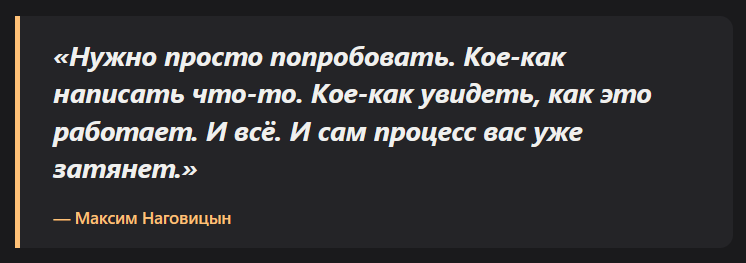
Максим: «Нужно просто попробовать. Кое-как написать что-то. Кое-как увидеть, как это работает. И всё. И сам процесс вас уже затянет.»
Этот принцип работает и здесь. Собрать llama.cpp, один раз запустить llama-server с нестандартным флагом и увидеть разницу в токенах в секунду — лучший способ понять, нужен вам этот уровень контроля или нет.
Кому стоит переходить на llama.cpp напрямую?
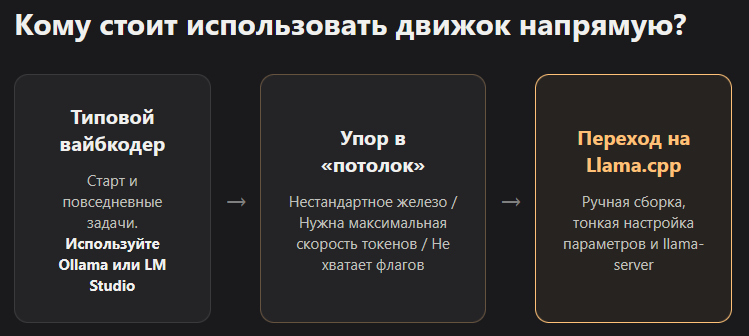
Типовому вайбкодеру без специфичных требований стоит начинать с Ollama или LM Studio. Переход на llama.cpp оправдан только при конкретном ограничении: нестандартное железо, недоступный в обёртке параметр или желание минимальной установки без лишних зависимостей.
Честная рекомендация звучит скучно, но именно она рабочая. Обёртки решают 90% задач быстрее и без головной боли. Прямая работа с llama.cpp имеет смысл, когда вы точно знаете, чего хотите добиться, и это упирается в конкретный потолок Ollama или LM Studio — будь то скорость на редкой видеокарте, недостающий флаг запуска или желание собрать максимально легкую установку без Python-окружения вокруг.
Локальный ИИ вообще имеет смысл там, где важна приватность документов и переписок, автономность без интернета или гибкий выбор моделей под конкретную задачу — код, черновики, работа с русским текстом. Если один из этих пунктов ваш случай, разница между удобной обёрткой и прямым доступом к движку рано или поздно станет заметна.
Частые вопросы про llama.cpp
Что такое llama.cpp простыми словами?
Это программа на C/C++, которая позволяет запускать большие языковые модели на обычном компьютере, даже без видеокарты. Ollama и LM Studio построены поверх неё.
Llama.cpp на Python или на C++?
Сам движок написан на C/C++ для максимальной скорости и минимума зависимостей. Python-биндинги существуют отдельно и удобны для интеграции в скрипты, но инференс всё равно выполняет C++-ядро.
Нужна ли видеокарта для llama.cpp?
Нет. Движок изначально создавался для запуска на CPU с оптимизациями под AVX2, AVX-512 и ARM NEON. Видеокарта через CUDA или Vulkan ускоряет процесс, но не обязательна.
Чем llama.cpp отличается от Ollama?
Ollama — обёртка над llama.cpp с упрощенным интерфейсом и автоматическими настройками. Llama.cpp дает больше контроля над параметрами и обновляется раньше, но требует ручной настройки через командную строку.
Как установить llama.cpp на Windows?
Скачать бинарный файл под своё железо с официального репозитория на GitHub, распаковать, добавить папку в переменную PATH, перенести DLL-файлы туда же и скачать модель в формате GGUF для запуска через llama-cli.
Что такое llama-server?
Серверный режим llama.cpp, который поднимает локальный API поверх загруженной модели. Похож на серверный режим Ollama, но дает более гранулярный контроль над параметрами запроса.
Стоит ли новичку сразу собирать llama.cpp из исходников?
Нет. Для старта достаточно Ollama или LM Studio. Переходить на llama.cpp напрямую имеет смысл только при конкретном ограничении обёртки, которое реально мешает задаче.
Хотите разобраться, какой локальный стек подойдет именно под вашу задачу — от выбора модели до параметров запуска? Загляните в каталог AI-инструментов VibeCoderz или запишитесь на консультацию к Максиму.
Смотрите также: Локальная нейросеть для программирования, GGUF: уровни квантизации Q4, Q5, Q8, vLLM: серверный инференс с высокой пропускной способностью.
Обновлено: октябрь 2026.