
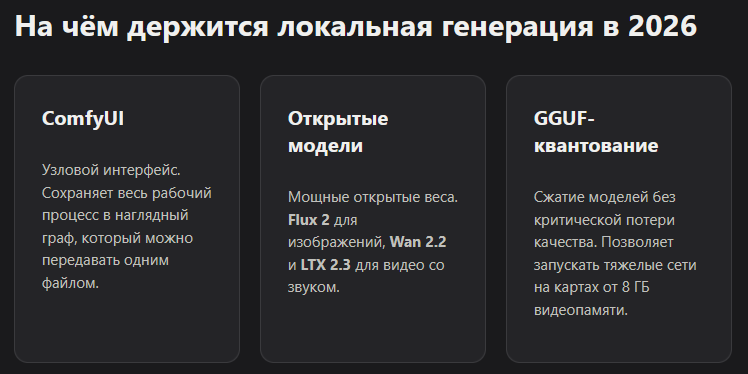
Локальные нейросети для генерации изображений и видео в 2026 году держатся на трех вещах: узловом интерфейсе ComfyUI, открытых моделях Flux, Wan и LTX и GGUF-квантовании, которое ужимает эти модели под обычную видеокарту. Разница с закрытыми сервисами простая: один раз настроил рабочий процесс и генерируешь бесконечно, без подписки и без лимитов. Ниже разберем по порядку: чем эта категория отличается от локальных текстовых LLM, как читать граф ComfyUI, что умеют Flux 2, Wan 2.2 и LTX 2.3, как работает квантование именно для картинок и видео и какая видеокарта нужна, чтобы все это не тормозило.
Локальная генерация изображений и видео в 2026 году строится на связке ComfyUI и трех открытых моделей: Flux 2 для картинок, Wan 2.2 и LTX 2.3 для видео со звуком. GGUF-квантование позволяет запускать их на видеокартах от 8 ГБ. Дальше сравниваем модели, разбор нод ComfyUI и пошаговая установка для новичка.
Чем локальная генерация картинок и видео отличается от текстовых нейросетей?
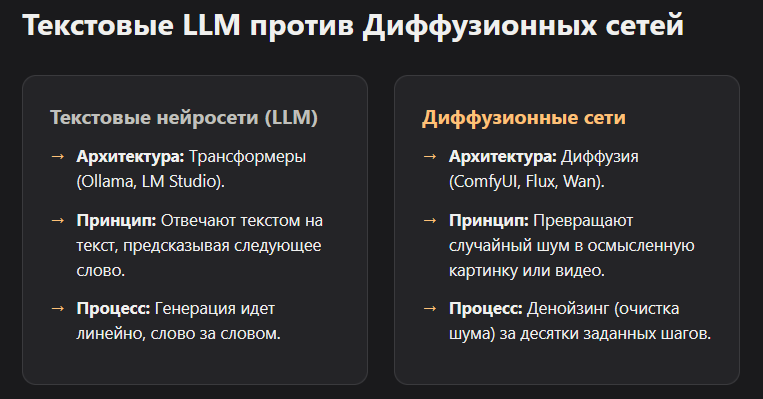
Локальные LLM вроде Ollama или LM Studio, это трансформеры, которые отвечают текстом на текст. ComfyUI работает с диффузионными моделями: Flux, Wan и LTX превращают шум в готовую картинку или видео за десятки шагов.
Диффузионная модель не предсказывает следующее слово, как текстовая нейросеть. Она стартует с случайного шума и на каждом шаге денойзинга убирает часть этого шума, пока из него не проступит изображение. Именно поэтому весь инструментарий вокруг Flux, Wan и LTX сильно отличается от привычного мира Ollama: другие форматы весов, другой софт для запуска, другие требования к видеопамяти.
Смешивать эти два мира не стоит: советы по локальным LLM для текста здесь почти не применимы. Зато принцип GGUF-квантования переносится напрямую. Разница только в том, что сжимается не языковая модель, а диффузионная.
Как устроен ComfyUI и почему это не просто окно с промптом?
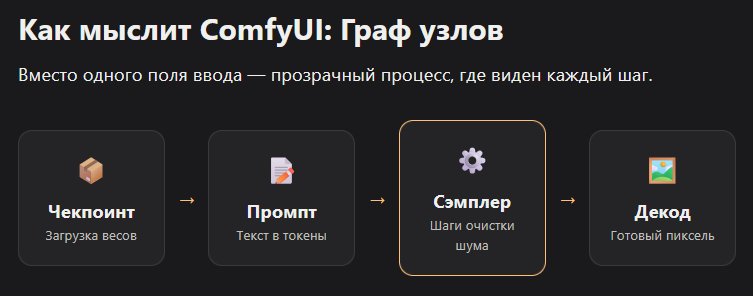
ComfyUI показывает весь путь генерации как граф связанных узлов: загрузка модели, обработка промта, сэмплер, апскейл, сохранение. Каждый узел можно заменить или перенастроить отдельно.
В сервисах вроде Midjourney есть одно поле для промта. В ComfyUI вместо этого граф нод, где виден каждый этап: откуда берется чекпоинт, как обрабатывается текст, какой сэмплер считает шаги денойзинга, куда уходит результат. На первый взгляд пугает. На практике стартовые шаблоны закрывают 90% случаев, и трогать граф руками почти не приходится.
Модели ищутся на Civitai и Hugging Face, докачиваются прямо из интерфейса через ComfyUI Manager, если чего-то не хватает, новая версия подсвечивает недостающий узел красным. Рабочий процесс сохраняется в файл и переносится между проектами одной кнопкой. Колесиком мыши перемещаешься по графу, а готовые картинки лежат в папке output без лишних кликов.
Что умеет Flux 2 в локальной генерации изображений?
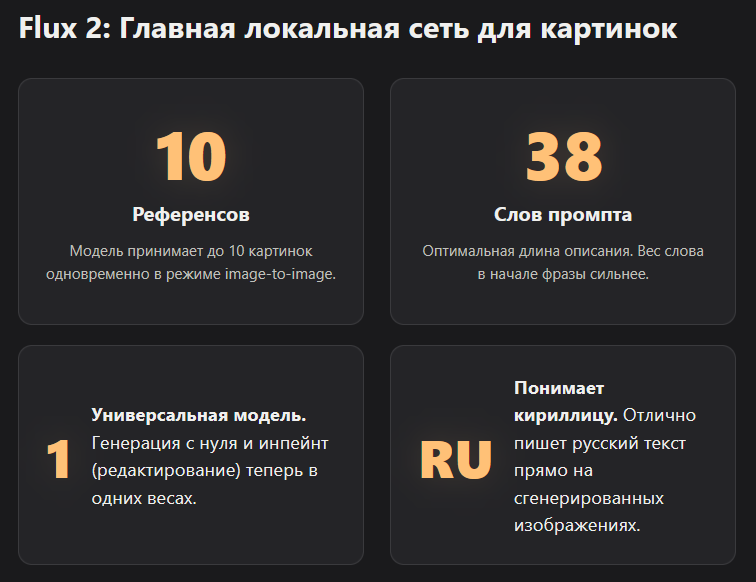
Flux 2 от Black Forest Labs генерирует и редактирует изображения в одной модели, принимает до 10 референсов и понимает кириллицу в тексте на картинке.
Flux 2 объединяет генерацию с нуля и редактирование готового изображения: отдельная модель для инпейнта больше не нужна. В режиме image-to-image модель принимает до 10 референсных изображений одновременно, что для локального open source на момент выхода модели встречается нечасто. Разрешение доходит до 4 мегапикселей, а минимальный размер генерации, например для иконки, составляет 64x64 пикселя.
Есть версии под разное железо: FP16 для мощных карт, FP8 и GGUF-варианты для более скромных. Модель заметно устойчивее к деградации при многократном редактировании, чем предыдущие открытые аналоги, и неплохо держит консистентность персонажа между сценами, что удобно для раскадровок и комиксов. В промтинге работает правило: 38 слов считается оптимальной длиной, вес слова в начале фразы усиливает его влияние, а для реализма стоит называть конкретную модель камеры и объектива, а не писать «фотореалистично».
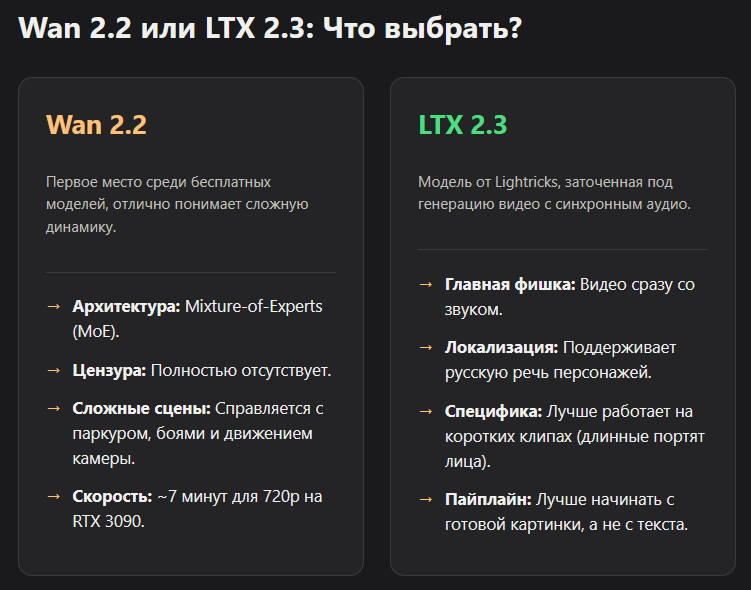
Wan 2.2 или LTX 2.3, что выбрать для генерации видео?
Wan 2.2 от Alibaba держит первое место среди бесплатных моделей для видео и работает без цензуры. LTX 2.3 от Lightricks добавляет синхронный звук прямо в генерации.
Wan 2.2 построена на архитектуре Mixture-of-Experts: одна сеть отвечает за общую композицию и движение, вторая доводит детали. Модель понимает текст-в-видео и картинку-в-видео, поддерживает Cinematic Vision Control для управления цветом и светом и неплохо справляется со сложными сценами вроде боя или паркура с движением камеры. На RTX 3090 генерация в разрешении 720p занимает около 7 минут, на связке из четырех видеокарт быстрее почти вдвое.
LTX 2.3 от Lightricks заточена под другое: видео сразу со звуком, включая речь персонажа на русском языке. Здесь работает свое правило: сначала генерировать качественное стартовое изображение, а уже потом превращать его в видео, а не идти напрямую из текста. Длинные ролики портят черты лица персонажа, поэтому короткие клипы с последующим монтажом выглядят надежнее одного затянутого видео.
| Модель | Основная задача | Типичное время генерации | Особенность |
|---|---|---|---|
| Flux 2 | Изображения, редактирование | 4–7 минут (зависит от числа референсов) | До 10 референсов, кириллица в тексте |
| Wan 2.2 | Текст/картинка в видео | ~7 минут на RTX 3090 (720p) | MoE-архитектура, без цензуры |
| LTX 2.3 | Видео со звуком | Зависит от длины и разрешения | Синхронный звук, речь на русском |
Как GGUF-квантование сжимает диффузионные модели?
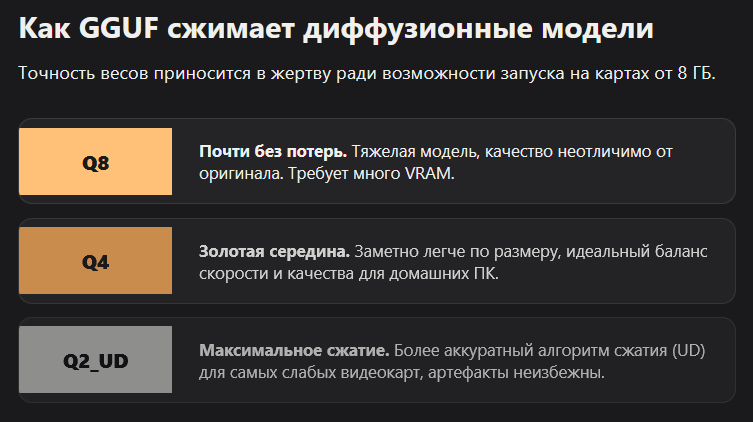
GGUF-квантование ужимает веса Flux, Wan и LTX по тому же принципу, что и текстовые LLM: чем меньше цифра в названии, тем легче модель и ниже качество.
Принцип один и тот же для двух разных архитектур, трансформеров и диффузионных моделей: часть точности весов приносится в жертву ради размера файла и скорости на слабой видеокарте. Для диффузионных моделей это работает так же наглядно: Q8 почти не теряет в качестве, Q4 уже заметно легче, а UD-варианты вроде Q3_UD или Q2_UD дают более аккуратное сжатие на тех же уровнях, чем обычное квантование.
Для Low VRAM сценариев основная модель дополнительно разбивается на части, которые подгружаются по очереди, а не хранятся в видеопамяти целиком. Это позволяет запускать тяжелые видео-модели вроде Wan или LTX даже на картах с ограниченной памятью, хотя скорость генерации при этом падает.
Какая видеокарта нужна для ComfyUI, Flux, Wan и LTX?
Видеопамяти для генерации видео нужно заметно больше, чем для картинок, при сопоставимой «сложности» модели на первый взгляд.
Честный момент, который редко проговаривают заранее: генерация видео остается одной из самых требовательных к железу задач среди всех локальных AI-сценариев. Одна и та же видеокарта, которая легко тянет Flux 2 в высоком разрешении, может не справиться с Wan 2.2 в 720p без GGUF-версии и Low VRAM workflow.
Если своей мощной карты нет, есть два обходных пути: аренда удаленного компьютера с оплатой за генерацию или облачный API той же модели. Разница ощутима: аренда обходится в несколько рублей за прогон, а покупка токенов на официальном сайте модели выйдет заметно дороже за то же количество результатов.
Как установить ComfyUI и запустить первую генерацию?
Portable-версия ComfyUI на Windows с Nvidia ставится без командной строки: скачал архив, распаковал, запустил один файл.
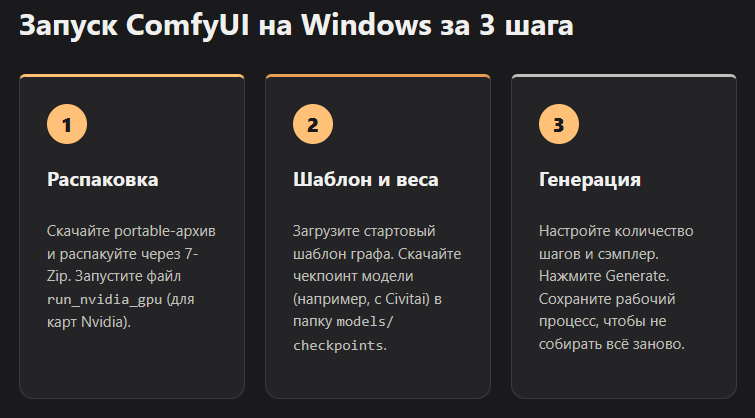
Три шага закрывают запуск с нуля.
Шаг 1. Скачайте portable-архив ComfyUI и распакуйте его 7-Zip, если своего архиватора нет. Для Windows с видеокартой Nvidia запускается файл run_nvidia_gpu, а не обычный ярлык.
Шаг 2. Откройте один из стартовых шаблонов интерфейса и выберите чекпоинт на Civitai или Hugging Face. Если модель после скачивания не появилась в списке, обновите страницу ComfyUI, она подхватит файл не сразу.
Шаг 3. Настройте шаги, guidance и сэмплер по рекомендациям со страницы модели, запустите генерацию и сохраните рабочий процесс через вкладку «Рабочие процессы», чтобы не собирать граф заново в следующий раз.
Максим: «Нужно просто попробовать. Кое-как написать что-то. Кое-как увидеть, как это работает. И все. И сам процесс вас уже затянет.»
Плюсы и минусы локальной генерации против облачных сервисов
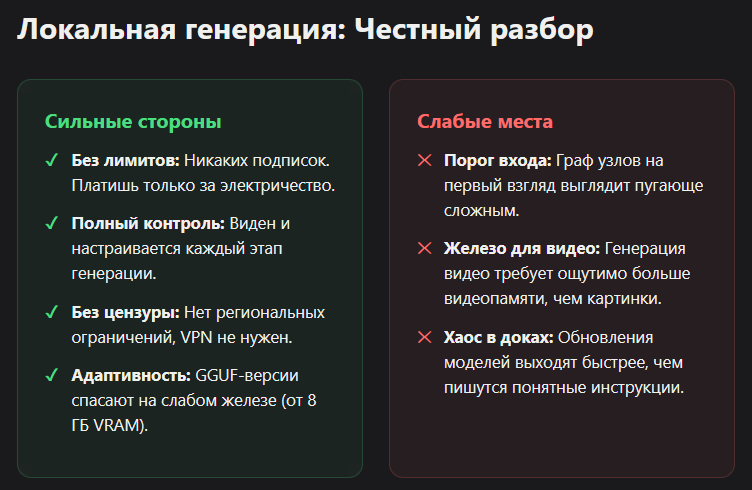
Сильные стороны локальной генерации редко сводятся к одной экономии.
- Без лимитов и подписки. Один раз настроил рабочий процесс, и дальше генерируешь сколько нужно, платишь только электричеством.
- Полный контроль над пайплайном. Граф нод в ComfyUI показывает и позволяет менять каждый этап, а не скрывает его за одной кнопкой «Generate».
- Без цензуры и региональных ограничений. Не нужны ни VPN, ни зарубежная карта для оплаты.
- GGUF-версии под слабое железо. Даже без топовой видеокарты можно запустить урезанную, но рабочую версию модели.
Минусы тоже стоит назвать честно.
- Порог входа выше, чем у сайта с одним полем ввода. Граф нод и настройка сэмплера пугают в первый вечер, хотя стартовые шаблоны сильно упрощают дело.
- Требования к видеопамяти для видео ощутимо выше, чем кажется по цене видеокарты среднего уровня.
- Обновления моделей и нод идут быстрее документации. Иногда проще спросить в сообществе, чем искать официальный гайд.
Часто задаваемые вопросы
Нужна ли мощная видеокарта, чтобы начать работать в ComfyUI?
Нет. Для старта с Flux или SDXL Turbo хватает карты с 8 ГБ видеопамяти при использовании GGUF-версии модели. Для видео на Wan или LTX запас памяти лучше брать с большим запасом.
Можно ли запускать ComfyUI без видеокарты Nvidia?
Технически да, через CPU-режим, но скорость генерации падает в разы. Для регулярной работы карта Nvidia с поддержкой CUDA остается практическим стандартом.
Чем Flux 2 отличается от Flux 1?
Flux 2 объединяет генерацию и редактирование в одной модели, принимает до 10 референсов вместо ограниченного набора и меньше деградирует при многократном редактировании одной картинки.
Почему видео на Wan или LTX генерируется дольше картинки?
Модель держит согласованность между десятками кадров одновременно, а не рисует один статичный кадр. Отсюда и разница в требованиях к видеопамяти, и во времени расчета.
Работает ли локальная генерация с русским языком?
Да, Flux 2 понимает и генерирует кириллицу на изображениях, а LTX 2.3 умеет синхронизировать русскую речь персонажа со звуком в видео.
Что такое GGUF-версия модели простыми словами?
Это сжатая копия оригинальной модели, где часть точности весов принесена в жертву ради меньшего размера файла и возможности запуска на слабой видеокарте.
С чего начать, если раньше никогда не работал с нейросетями локально?
С portable-версии ComfyUI и одного из стартовых шаблонов. Разбор пошаговой установки есть в разделе выше, отдельная статья про подбор видеокарты поможет понять, на что рассчитывать по железу.
Глоссарий терминов
| Термин | Что означает |
|---|---|
| ComfyUI | Узловой интерфейс для локального запуска диффузионных моделей изображений и видео |
| Диффузионная модель | Модель, которая превращает случайный шум в изображение или видео за серию шагов денойзинга |
| Чекпоинт | Файл с весами конкретной модели, который загружается в ComfyUI |
| Сэмплер | Алгоритм, который управляет процессом денойзинга на каждом шаге генерации |
| GGUF | Формат сжатых весов модели, снижающий требования к видеопамяти ценой части качества |
| Latent space (латентное пространство) | Внутреннее сжатое представление изображения, которое модель расшифровывает в финальный результат |
| Low VRAM workflow | Рабочий процесс, где модель разбита на части для запуска на видеокартах с ограниченной памятью |
Локальные нейросети для генерации изображений и видео уже не требуют статуса энтузиаста с сервером в шкафу: portable-сборка ComfyUI, одна модель и один вечер на установку, и дальше это просто инструмент. Полный каталог AI-инструментов для вайбкодинга собран в каталоге VibeCoderz, а если нужен план под конкретный проект с картинками или видео, можно обсудить его на консультации с Максимом.