
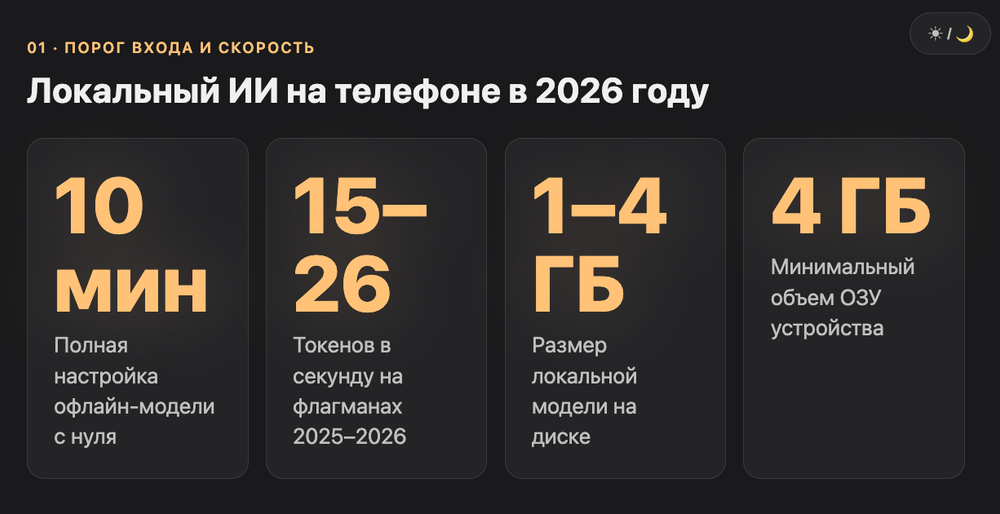
Локальный ИИ на телефоне без интернета ставится примерно за десять минут: одно приложение из трех, модель весом 1-4 ГБ, авиарежим. На флагмане 2025-2026 годов это 15-26 токенов в секунду, на бюджетнике около трех, и разница чувствуется сразу. Ниже разберем, какие модели влезают в 6 и 8 ГБ памяти, чем Gemma 4 отличается от GGUF-зоопарка, сколько процентов батареи съедает генерация и в каких задачах офлайн ИИ бесполезен.
Три приложения закрывают тему в 2026: Google AI Edge Gallery с Gemma 4 E2B и E4B, PocketPal AI под любые GGUF-модели и MLC Chat со скоростью до 26 токенов в секунду на Snapdragon 8 Elite. Порог входа: 4 ГБ оперативной памяти и пара гигабайт на диске. В статье таблицы скоростей, расход батареи и карта выбора под конкретный телефон.
Что такое локальный ИИ на телефоне и чем он отличается от облачного?
Модель лежит файлом в памяти устройства, а ответ считает его же процессор. Интернет нужен ровно один раз, чтобы скачать этот файл.
Разница с облаком механическая. ChatGPT отправляет ваш запрос на сервер и возвращает ответ оттуда, локальная модель не отправляет никуда ничего. После загрузки файла на 1-4 ГБ приложение работает в авиарежиме бесконечно и бесплатно. Открытые веса для этого выкладывают Google, Alibaba и Meta: Gemma 4, Qwen 3, Llama 3.2.
Отсюда три понятных сценария. Самолет и поезд, где связи нет по определению. Поездка за границу, где роуминг стоит дороже, чем вы готовы платить за пересказ меню. И работа с тем, что не хочется отдавать чужому серверу, от медицинских выписок до черновиков договора.
А еще тут нет подписки. Скачал и пользуешься, сколько хочешь, без лимитов сообщений и без карты.
Какие модели влезают в память телефона в 2026?
Практический потолок для телефона это 4 млрд параметров. Реально удобно живут модели на 1-3 млрд в квантизации Q4, они весят от 0,8 до 2,5 ГБ.
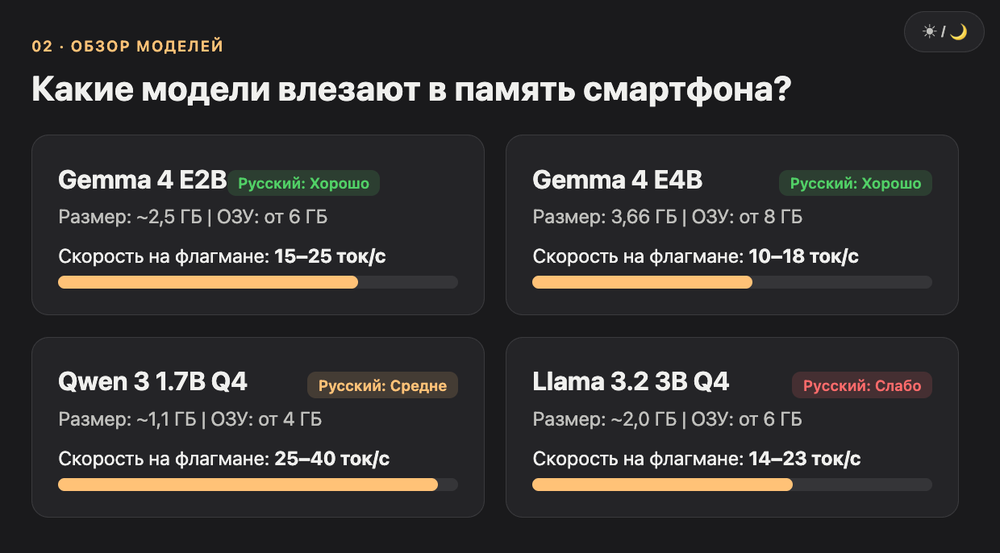
Gemma 4 вышла в четырех размерах, и два из них сделаны под край сети: E2B и E4B, то есть эффективные 2 и 4 млрд параметров. Файл E4B в формате LiteRT весит 3,66 ГБ, из них 2,24 ГБ занимают веса декодера. Контекст до 32 тысяч токенов, вход мультимодальный: текст, картинки, звук.
Трюк Google в архитектуре с послойными эмбеддингами: часть параметров подгружается по мере надобности, поэтому рабочая память держится ниже, чем ждешь от четырехмиллиардной модели (анонс Gemma 4 в блоге Google, карточка E4B на Hugging Face).
| Модель | Размер файла | Минимум ОЗУ | Скорость на флагмане | Русский язык |
|---|---|---|---|---|
| Gemma 3 1B Q4 | ~0,8 ГБ | 4 ГБ | 30+ ток/с | Хорошо |
| Qwen 3 1.7B Q4_K_M | ~1,1 ГБ | 4 ГБ | 25-40 ток/с | Средне |
| Llama 3.2 3B Q4_K_S | ~2 ГБ | 6 ГБ | 14-23 ток/с | Слабо |
| Gemma 4 E2B | ~2,5 ГБ | 6 ГБ | 15-25 ток/с | Хорошо |
| Gemma 4 E4B | 3,66 ГБ | 8 ГБ | 10-18 ток/с | Хорошо |
| Phi-4 mini Q4 | ~2,5 ГБ | 8 ГБ | ~22 ток/с (NPU) | Слабо |
Сколько оперативки нужно и что означает буквенный хвост Q4_K_M?
Считайте так: вес файла умножить на 1,3, плюс полтора гигабайта операционной системе. Q4 это степень сжатия весов, четыре бита вместо шестнадцати.
Квантизация решает, влезет модель или нет. Q4_K_M сжимает веса вчетверо и почти не режет качество, поэтому это стандарт для телефонов. Q2 сжимает сильнее: Gemma 3 4B в Q2 весит 1,7 ГБ и заводится даже на аппарате за сто долларов. Q8 умнее, но требует 8 ГБ ОЗУ и отдает медленнее.
Буквы после цифры это размер блока квантизации. S значит small, M значит medium. На практике берите Q4_K_M, если телефон свежий, и Q4_0 или Q3, если памяти впритык.
Почему iPhone обгоняет старый ноутбук
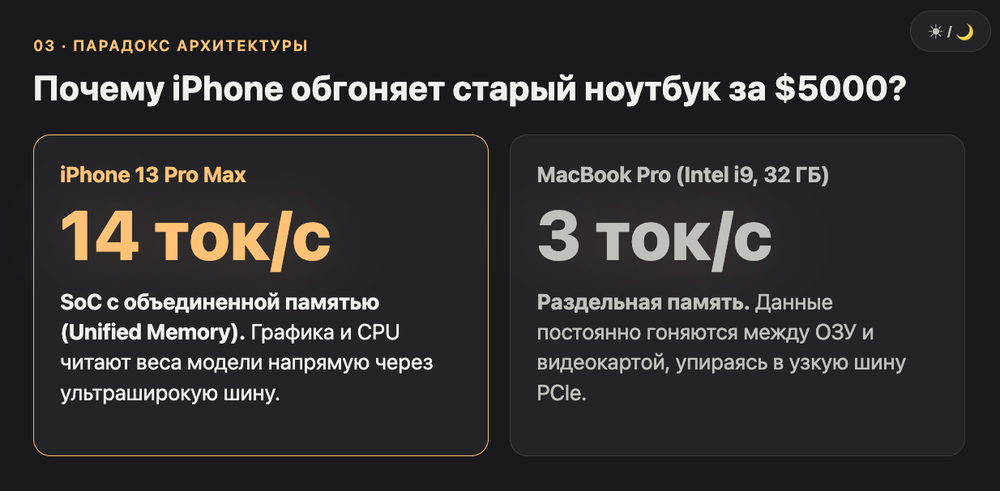
Тут есть нюанс, который ломает интуицию. В одном из тестов iPhone 13 Pro Max выдал почти 14 токенов в секунду на Llama 3.2 3B, а MacBook Pro на Intel i9 с 32 ГБ оперативки на той же модели дал три. Разница в четыре раза не в пользу ноутбука за пять тысяч долларов.
Причина в архитектуре. У телефона система на кристалле с общей памятью, графическое ядро читает те же самые веса по широкой шине. У старого ноутбука память отдельно, видеокарта отдельно, и на каждом шаге данные ездят туда-сюда.
Google AI Edge Gallery подойдет тем, кто ставит нейросеть оффлайн впервые?
Да, это самый короткий путь. Приложение официальное, лежит в Google Play и App Store, модели скачиваются в два тапа прямо внутри.
AI Edge Gallery перестал быть экспериментом: с версии 1.0.11 он поддерживает Gemma 4 E2B и E4B, работает на Android, iOS 17+ и macOS, умеет ускорение на NPU Snapdragon. Внутри не только чат: Ask Image разбирает фотографии, Audio Scribe расшифровывает 30-секундные клипы и переводит их, Prompt Lab дает готовые шаблоны пересказа.
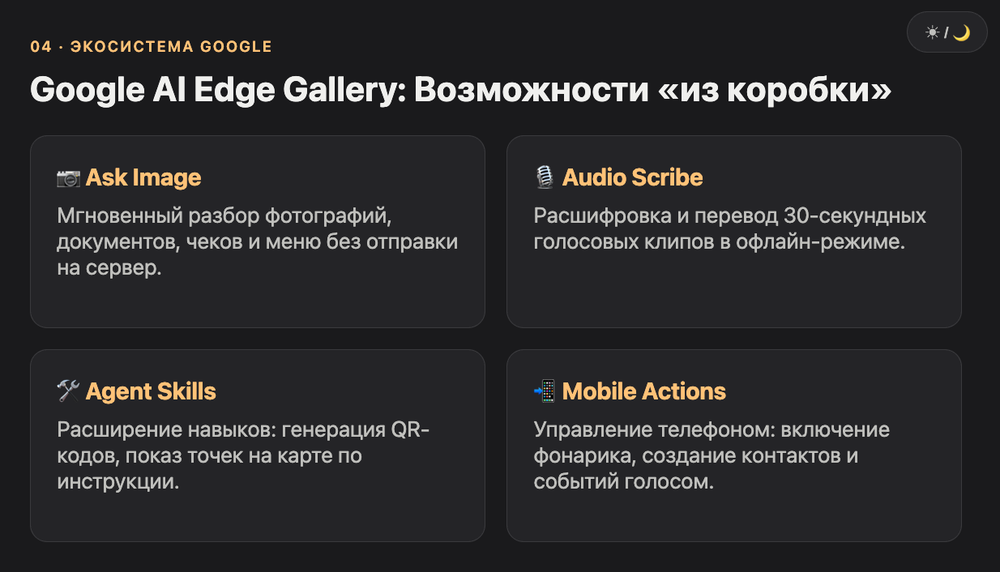
Отдельная история это Agent Skills. Модель получает доступ к маленьким навыкам и может, например, сгенерировать QR-код или показать точку на карте. Есть и Mobile Actions: голосом включить фонарик, создать контакт, поставить событие в календарь.
Честная оговорка про навыки. Их пишет сообщество, Google их не модерирует, а навык это по сути инструкция для модели, которая может содержать код. Ставьте только то, что готовы прочитать глазами.
Чем PocketPal AI берет тех, кто хочет свои модели?
Свободой. PocketPal построен на llama.cpp и грузит любой GGUF-файл с Hugging Face, а не только то, что положили в витрину.
У PocketPal больше 500 тысяч загрузок на двух платформах, и главная его фишка практическая: перед скачиванием приложение честно пишет, потянет ваш телефон эту модель или нет. Метки low memory и memory tight появляются до того, как вы потратите два гигабайта трафика. Внутри есть вкладка бенчмарка, которая меряет реальные токены в секунду.
Два приема из практики. Первый: отключайте мультимодальность перед загрузкой, если картинки вам не нужны. На тестах Galaxy S24 Ultra генерация с включенным зрением проседала с 4,8 до 2,49 токена в секунду. Второй: ставьте лимит ответа в тысячу токенов, иначе модель иногда уходит в бесконечный цикл.
Персоны тут называются Pals. Это просто сохраненные системные промпты с именем: один под код, один под письма, один под перевод (исходники проекта на GitHub).
Кому стоит поставить MLC Chat вместо остальных?
Владельцам Snapdragon 8 Elite. MLC компилирует модель под конкретное железо и добирается до NPU Hexagon, отсюда лучшая скорость среди бесплатных приложений.
На Galaxy S25 Ultra MLC Chat выдает 20-26 токенов в секунду там, где PocketPal на том же аппарате держит 14-18. На Qwen3 1.7B независимые замеры показывают около 40 токенов в секунду против 8-12 у решений, которые считают только на процессоре. Платить за это приходится закрытой витриной: своя GGUF-модель сюда не загрузится.
Приложение родом из академического проекта MLC LLM, который собирает модели через TVM в нативный код устройства. Документация и исходники открыты (быстрый старт MLC LLM).
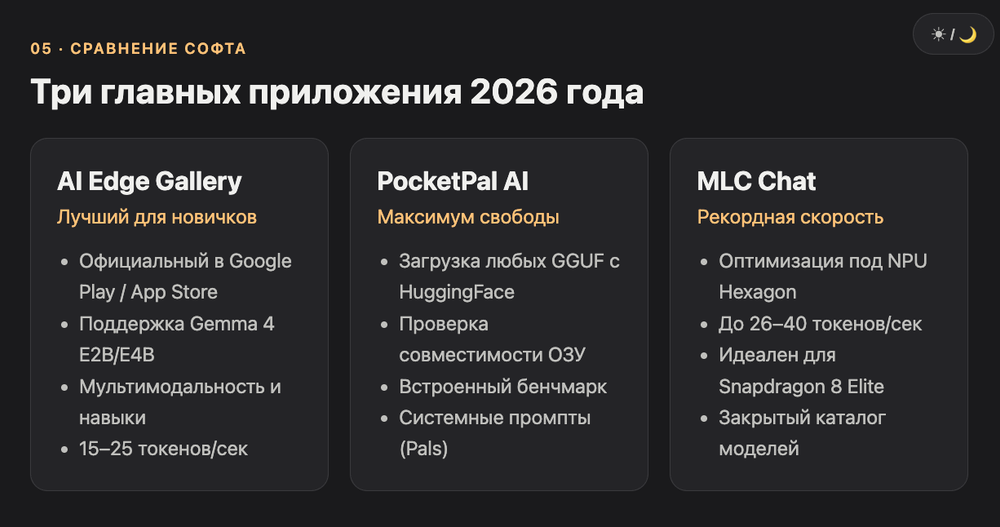
| Приложение | Платформы | Модели | Скорость (S25 Ultra) | Кому |
|---|---|---|---|---|
| Google AI Edge Gallery | Android, iOS, macOS | Gemma 4, Qwen 2.5, Phi-4 | 15-25 ток/с | Первый запуск, мультимодальность |
| PocketPal AI | Android, iOS | Любые GGUF | 14-18 ток/с | Свои модели, персоны, бенчмарк |
| MLC Chat | Android, iOS | Готовая витрина | 20-26 ток/с | Максимум скорости на Snapdragon |
Как запустить ИИ на телефоне за десять минут?
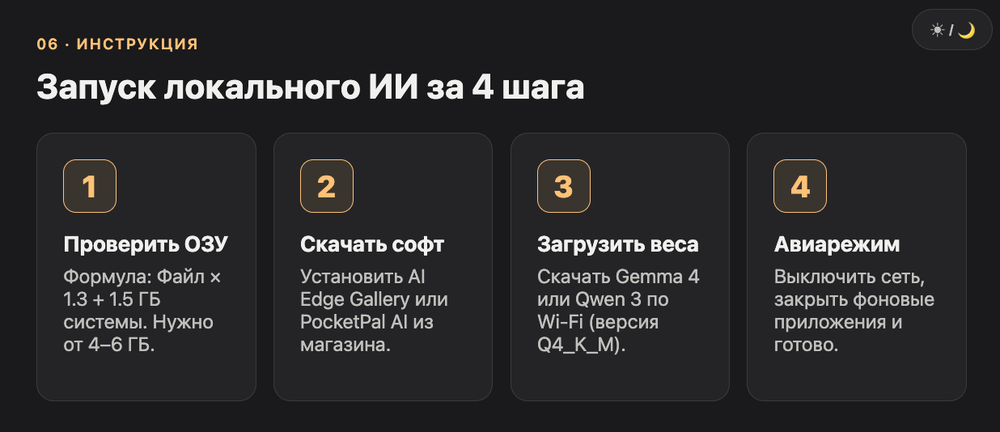
Четыре шага: проверить память, поставить приложение, скачать модель по Wi-Fi, проверить в авиарежиме. Дольше всего качается сам файл.
Порог входа низкий. Если в телефоне 6 ГБ оперативной памяти и пара свободных гигабайт на диске, запуск ИИ на телефоне пройдет с первого раза. На 4 ГБ берите модель на 1-2 млрд параметров. На 3 ГБ и меньше затея бессмысленна: система убьет процесс в момент, когда придет уведомление.
Шаг 1. Посмотреть, что у вас за железо
Откройте настройки и найдите объем ОЗУ. Дальше простая арифметика: файл модели умножьте на 1,3 и добавьте полтора гигабайта на систему. Gemma 4 E2B на 2,5 ГБ означает примерно 4,75 ГБ занятых, то есть нужен аппарат с шестью.
Шаг 2. Поставить приложение и скачать модель
AI Edge Gallery и PocketPal лежат в магазинах, MLC Chat ставится из Google Play или APK с сайта проекта. Качайте модель только по Wi-Fi. В PocketPal выбирайте вариант Q4_K_M, в Edge Gallery достаточно нажать на карточку Gemma 4.
Шаг 3. Проверить и настроить
Включите авиарежим и задайте вопрос. Работает, значит все получилось. Сразу закройте фоновые приложения: при нехватке памяти система режет частоты и модель начинает тупить. И добавьте в промпт фразу про ответ на русском языке, иначе Gemma регулярно уходит в английский.
Почему телефон греется и сколько батареи съедает офлайн ИИ?
Активная генерация тянет 3-5 Вт, это нагрузка уровня тяжелой игры. Через 10-15 минут включается тротлинг и скорость падает на треть.
Цифры из замеров на iPhone 16 Pro выглядят так: старт 37,58 токена в секунду, после двух итераций 25,31, дальше 22,56. Потеря 44 процента за пару минут. На Android картина растянутее: Snapdragon 8 Gen 3 отдает 12,4 токена в секунду на старте и 3,8 через полчаса непрерывной работы.
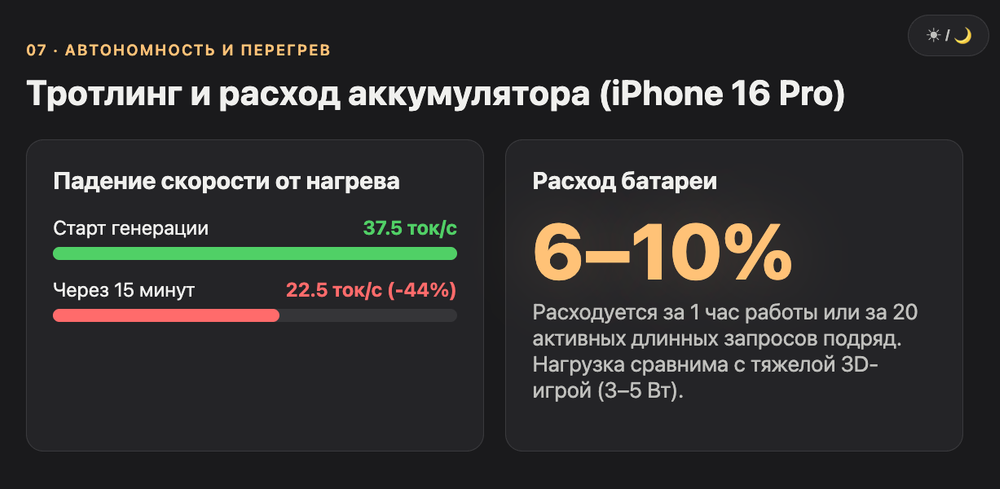
Батарея уходит быстрее, чем кажется по ощущениям. Двадцать запросов подряд на iPhone 16 Pro это около 10 процентов заряда, то есть примерно двести генераций на полную зарядку. В спокойном режиме, когда вы пишете пару вопросов в час, расход держится на уровне 6-10 процентов в час.
| Устройство | Модель | Скорость | Расход батареи |
|---|---|---|---|
| iPhone 16 Pro | Llama 3.2 3B Q4 | ~15 ток/с | ~6% в час |
| Samsung S25 Ultra | Llama 3.2 3B | ~22 ток/с | ~10% в час |
| Pixel 9 Pro XL | Llama 3.2 3B Q4 | ~14 ток/с | ~9% в час |
| Realme C63 | Gemma 3 4B Q2 | ~3 ток/с | не замеряли |
Что помогает: класть телефон экраном вверх на твердую поверхность, не заряжать во время генерации и ограничивать длину ответа. Академический разбор устойчивой нагрузки на мобильных чипах есть в работе на arXiv, там же видно, что тепловой режим важнее пиковой производительности.
Что локальная нейросеть без интернета не умеет?
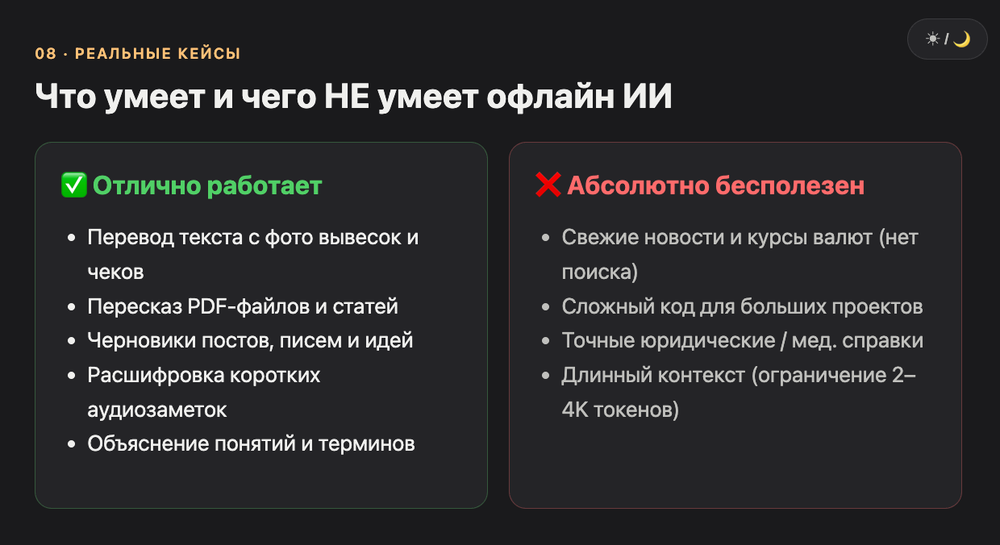
Три вещи: не знает свежих фактов, не ходит в поиск и не держит длинный контекст. Это не баг, это размер модели.
Проверка на дату показывает границу знаний честнее любого бенчмарка. Локальная Gemma на вопрос о сегодняшнем числе спокойно отвечает датой позапрошлого года. Поиска у нее нет, значит курсы валют, релизы и новости мимо. Контекст на телефоне обычно держат в пределах 2-4 тысяч токенов, хотя модель формально умеет 32 тысячи.
Еще один момент, который всплывает на второй день. Маленькая модель уверенно ошибается. Она не говорит, что не знает, она придумывает. Для перевода вывески это неважно, для юридического вопроса критично.
И да, полноценный агент для кода локальная модель не заменяет. Простую функцию на Python она напишет, но проекта не видит и терминалом не управляет. Для реальной разработки нужен десктопный инструмент из каталога AI-инструментов, вроде Claude Code или Cursor.
Какие задачи реально закрывает локальный ИИ на телефоне?
Перевод, пересказ, черновики и разбор картинок. Все, где важна не свежесть данных, а наличие связи.
Сильнее всего офлайн ИИ показывает себя в поездке. Gemma 3 переводит текст с фотографии вывески или чека за несколько секунд и поддерживает больше сотни языков. Разбор презентации в PDF на локальной модели занимает примерно столько же времени, сколько ответ обычной облачной модели без режима рассуждений.
Рабочий список короткий и честный: перевод с картинки, пересказ длинного текста, черновик письма или поста, объяснение незнакомого термина, разбор фотографии устройства или документа, расшифровка короткой голосовой заметки.
Максим: «Веб-версию GoBanana мы собрали за 3 часа после выхода модели. Выиграл не движок, а доступ: без VPN, без зарубежных карт, платишь сколько нужно. 200 000+ пользователей пришли именно за этим. С локальными моделями та же логика, побеждает то, что работает без условий.»
Если задача повторяется каждый день, локальная модель на телефоне быстро упирается в потолок. Тогда логичнее собрать под нее готовый сценарий из каталога ИИ-агентов и запускать его там, где есть сеть.
Какой вариант выбрать под ваш телефон?
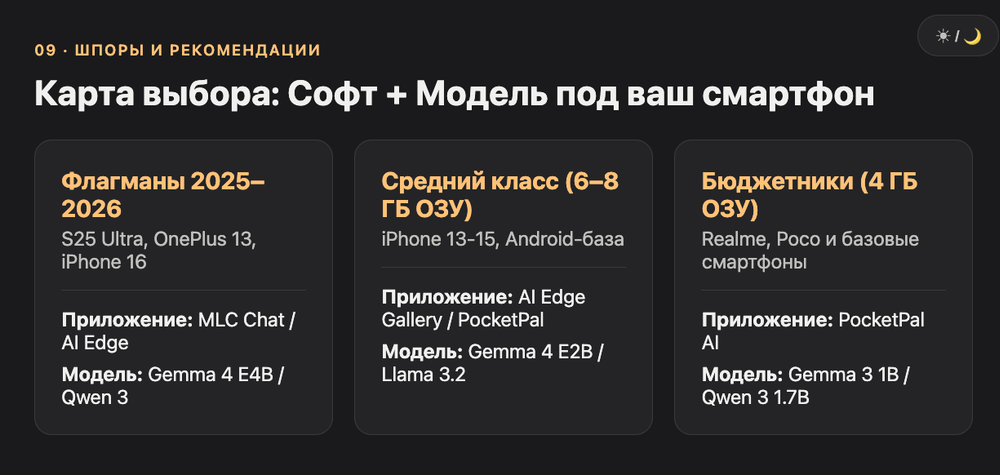
Флагман на Snapdragon берет MLC Chat, iPhone и любой Android с 6 ГБ берут AI Edge Gallery, любители своих моделей идут в PocketPal.
Правило простое: чем меньше оперативной памяти, тем меньше параметров. На 4 ГБ ставьте Gemma 3 1B или Qwen 3 1.7B, на 6 ГБ открывается Gemma 4 E2B, на 8 ГБ и выше работает E4B с картинками и звуком. Бюджетный аппарат за сто долларов выдаст около трех токенов в секунду, и это уже неприятно медленно.
| Ваш телефон | Приложение | Модель |
|---|---|---|
| Galaxy S25 Ultra, OnePlus 13 | MLC Chat | Qwen3 1.7B, Phi-4 mini |
| iPhone 15 и новее | AI Edge Gallery | Gemma 4 E4B |
| Android 6-8 ГБ ОЗУ | AI Edge Gallery | Gemma 4 E2B |
| iPhone 13, старые флагманы | PocketPal AI | Llama 3.2 3B Q4_K_S |
| Бюджетник 4 ГБ ОЗУ | PocketPal AI | Gemma 3 1B Q4 |
Мы в VibeCoderz держим AI Edge Gallery на рабочем телефоне ради перевода фотографий и PocketPal на втором аппарате для тестов новых GGUF. MLC ставим, когда нужна скорость на длинном пересказе.
Частые вопросы про запуск ИИ на телефоне
Сколько оперативки нужно для запуска ИИ на телефоне? Минимум 4 ГБ для моделей на 1-2 млрд параметров. Для Gemma 4 E2B и Llama 3.2 3B комфортно от 6 ГБ, для Gemma 4 E4B и Phi-4 mini от 8 ГБ. Формула: вес файла умножить на 1,3 плюс полтора гигабайта системе.
Локальный ИИ на телефоне правда работает без интернета? Да. Сеть нужна один раз, чтобы скачать приложение и файл модели. Дальше включаете авиарежим и пользуетесь. Ответы считает процессор или графика телефона, запросы никуда не уходят, история чатов лежит в памяти устройства.
Какая модель лучше понимает русский язык? Линейка Gemma от Google. Даже в сильной квантизации Q2 она пишет по-русски без мусорных символов. Llama 3.2 3B на русском заметно слабее и сбивается. В промпте лучше прямо просить ответ на русском, иначе модель уходит в английский.
Почему телефон греется при работе нейросети оффлайн? Генерация грузит процессор и графику почти на полную, активная инференция тянет 3-5 Вт. Через 10-15 минут непрерывной работы включается тротлинг и скорость падает на 30-50 процентов. Помогает положить телефон на твердую поверхность экраном вверх.
Можно ли писать код с локальной моделью на телефоне? Простые функции на Python и C модели уровня 3B пишут сносно, даже с объяснением логики. Но это черновик: контекст короткий, проекта модель не видит, ошибки ловить придется самому. Для настоящей разработки нужен десктопный агент.
Локальная модель знает свежие новости? Нет. Доступа к поиску у нее нет, знания ограничены датой обучения. На вопрос о текущей дате она уверенно назовет прошлый год. Спрашивать про курсы, релизы и события бессмысленно, сильные стороны офлайн ИИ это перевод, пересказ и черновики.
Google AI Edge Gallery безопасен? Само приложение открытое и официальное, инференция идет локально. Риск только в пользовательских Agent Skills: их пишет сообщество, Google не проверяет, а навык может содержать исполняемый код. Ставьте только те, что готовы прочитать сами.
Глоссарий
Квантизация это сжатие весов модели. Q4 значит четыре бита на вес вместо шестнадцати, файл становится вчетверо меньше при небольшой потере качества.
GGUF это формат файла модели для llama.cpp. В нем лежит большинство моделей на Hugging Face, которые можно загрузить в PocketPal.
Токен в секунду это скорость генерации. Один токен примерно равен половине слова. Комфортное чтение начинается от 10 токенов в секунду.
Контекстное окно это объем текста, который модель держит в голове за один диалог. На телефоне обычно 2-4 тысячи токенов.
NPU это отдельный блок чипа для нейросетевых вычислений. У Qualcomm он называется Hexagon, ускорение относительно процессора доходит до десятков раз.
Тротлинг это принудительное снижение частот при перегреве. Именно он превращает 12 токенов в секунду в 4 через полчаса работы.
Мультимодальность это способность модели принимать не только текст, но и картинки или звук. Gemma 4 E2B и E4B умеют оба варианта.
Что делать дальше
Начните с малого: поставьте AI Edge Gallery, скачайте Gemma 4 E2B и проверьте ее в авиарежиме на переводе фотографии. Если зайдет, добавьте PocketPal и поиграйте с GGUF-моделями под свои задачи.
Подобрать десктопный инструмент под разработку можно в каталоге AI-инструментов VibeCoderz, там собраны обзоры IDE и агентов с ценами и разбором сильных сторон. А если хотите разобрать свой проект и понять, где ИИ реально сэкономит время, запишитесь на консультацию к Максиму.
Обновлено: сентябрь 2026. Цены, версии приложений и скорости проверены по состоянию на сентябрь 2026 года.