
Короткий ответ: под 8 ГБ видеопамяти берите Qwen2.5-Coder 7B, под 24 ГБ — Qwen3-Coder-30B-A3B, а Kimi K2.6 и Hermes на домашнем компьютере не запустить физически, они живут только в облаке Ollama. Дальше разберем, почему именно так и что делать, если у вас 16 или 48 ГБ.
В статье: таблица VRAM для восьми моделей Ollama, отдельно про Qwen3-Coder для кода, про Kimi K2.6 и Hermes для чата и агентов, и что реально тянет Llama 3.3 70B. Данные на сентябрь 2026, каталог моделей меняется каждую неделю.
Какую модель Ollama выбрать в 2026 году под свое железо?
Выбор зависит от одной цифры — объема видеопамяти. Дальше уже смотрите на задачу: код, чат или мультимодальные вещи вроде описания картинок.
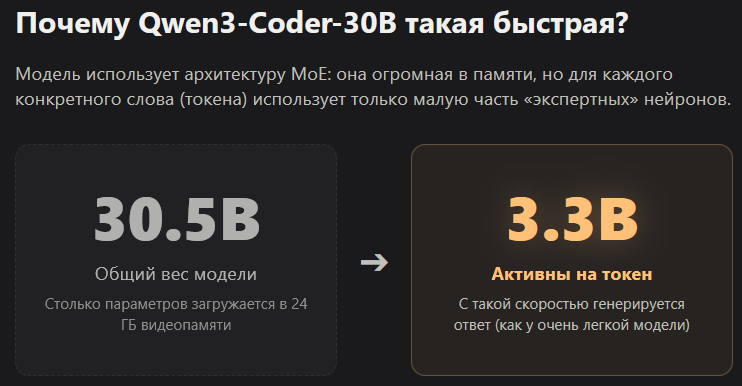
Параметры модели — это не база знаний внутри нее, а количество числовых коэффициентов, которые определяют, как модель обрабатывает запрос и строит ответ. Чем их больше, тем точнее рассуждения, но тем больше памяти нужно железу. У MoE-моделей вроде Qwen3-Coder часть параметров вообще не участвует в конкретном проходе, поэтому 30-миллиардная модель по скорости ведет себя как 3-миллиардная.
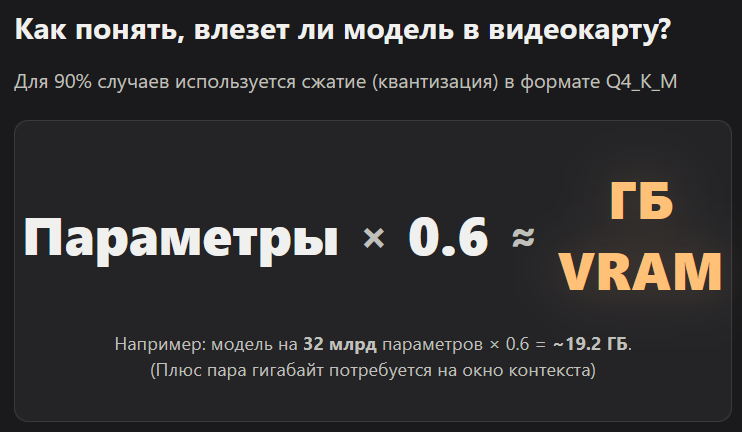
Дальше все упирается в квантизацию. Полная точность FP16 — золотой стандарт, но она съедает вдвое больше памяти, чем компактный формат Q4_K_M. На практике 90% локальных установок в Ollama работают именно на Q4, и разница в качестве ответов почти не заметна на глаз.
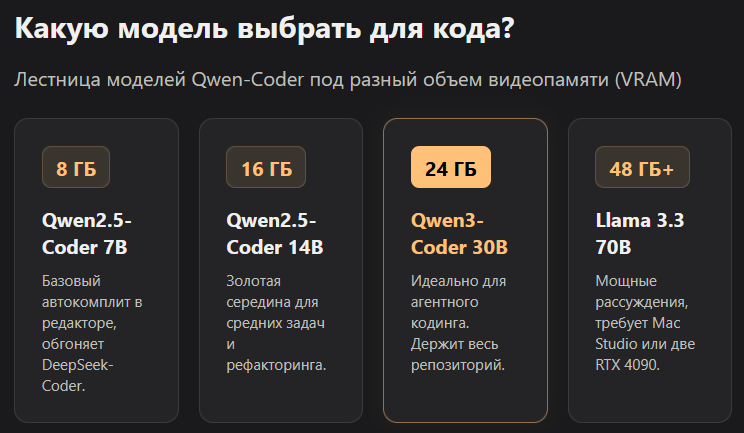
Сколько видеопамяти нужно для разных моделей Ollama?
8 ГБ хватает на 7B модели в Q4, 24 ГБ открывает Qwen3-Coder-30B, а от 48 ГБ и выше уже можно говорить про Llama 3.3 70B. Все, что тяжелее, живет только в облаке.
Реальная нагрузка на память — это вес модели плюс KV-кеш под контекст плюс runtime-надбавка. Формула грубая, но рабочая: гигабайты FP16 примерно равны миллиардам параметров, умноженным на два, а Q4_K_M — это уже коэффициент 0,6. Отсюда и берется таблица ниже.
| VRAM | Модель для кода | Модель для общих задач |
|---|---|---|
| 8 ГБ | Qwen2.5-Coder 7B | Llama 3.2 3B или Gemma 2 |
| 16 ГБ | Qwen2.5-Coder 14B | Mistral 7B, Qwen 2 |
| 24 ГБ | Qwen3-Coder-30B-A3B | Qwen3 32B |
| 48 ГБ+ | Qwen3-Coder-30B без ужатого контекста | Llama 3.3 70B |
| Только облако | — | Kimi K2.6, Hermes 4 405B |
Максим: «GoBanana мы собрали за 3 часа после выхода новой модели, шесть-восемь часов суммарно на продукт, который потом принес 12 миллионов рублей. Так же и с моделями в Ollama: вышла новая версия — сразу пробуем на своем железе, а не ждем месяц обзоров.»
Qwen3-Coder или лестница Qwen2.5-Coder что выбрать для кода?
Qwen3-Coder-30B-A3B — лучший локальный вариант для агентного кодинга на 24 ГБ VRAM. Для более слабого железа берите Qwen2.5-Coder нужного размера: 7B, 14B или 32B.
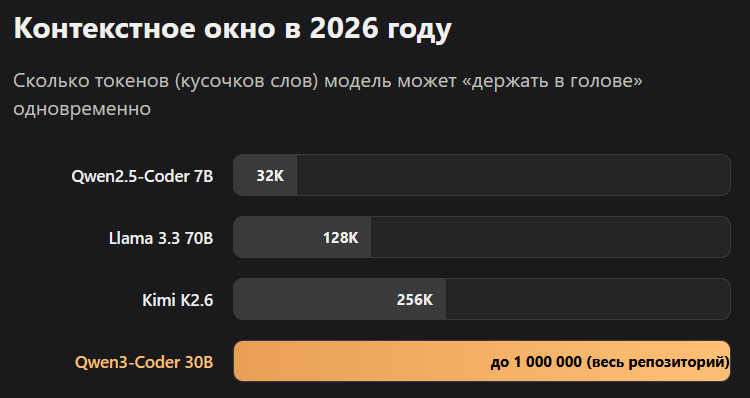
Qwen3-Coder-30B-A3B — это MoE-модель на 30,5 млрд параметров, из которых на каждый токен активны только 3,3 млрд. В Q4_K_M ей нужно около 22 ГБ видеопамяти, а с запасом на контекст комфортно чувствует себя на карте от 24 ГБ. Контекст у модели нативно 256K токенов, с расширением через YaRN — до 1M, чего достаточно для работы с целым репозиторием, а не с одним файлом.
Для железа послабее работает лестница Qwen2.5-Coder: версия 7B умещается в 8 ГБ и по автодополнению в редакторе обгоняет CodeLlama и DeepSeek-Coder похожего размера, 14B требует 16 ГБ, а 32B на топовой потребительской карте показывает результат близкий к GPT-4o на бенчмарке Aider. Мы уже разбирали эту лестницу подробно в статье про локальную нейросеть для программирования, здесь не повторяем детали.
Отдельно стоит Qwen3-Coder-Next — облегченная агентная версия, которая при активных 3 млрд параметров держится на уровне моделей на порядок крупнее. Она хорошо ведет себя в CLI-агентах вроде Qwen Code и открыто дает 1000 бесплатных запросов в день, что закрывает основную часть рабочих задач без подписки.
Зачем нужны Kimi K2.6 и Hermes если это не про код?
Kimi K2.6 и модели семейства Hermes закрывают роль персонального ассистента и чата без ограничений. Локально их не запустить, но через облако Ollama они доступны бесплатно по квоте или по подписке Ollama Pro.
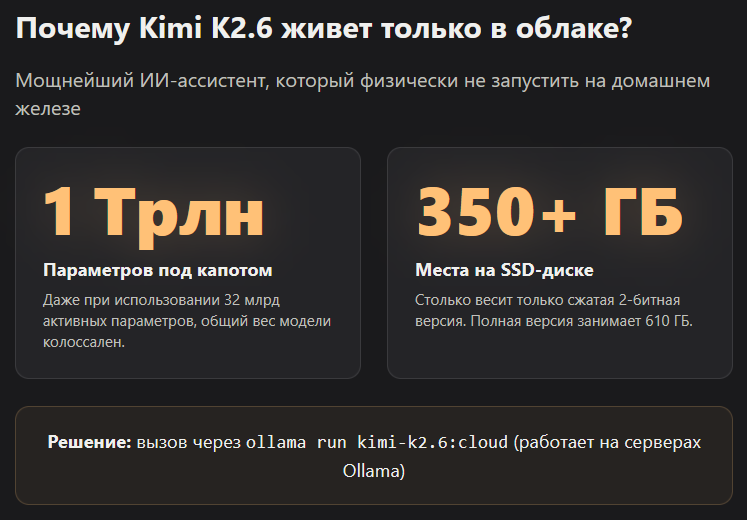
Kimi K2.6 от Moonshot AI вышла в апреле 2026 и держит гибридную архитектуру на 1 триллион параметров с активными 32 млрд на токен. Контекст — 256K токенов, модель принимает и текст, и изображения. Полная версия занимает около 610 ГБ диска, а компактный динамический 2-бит вариант — от 350 ГБ. Дома такое не поднять, зато через ollama run kimi-k2.6:cloud модель отвечает за секунды, используя серверы Ollama, а не вашу видеокарту.
Hermes от Nous Research — семейство диалоговых моделей на базе Llama 3.1, версии 70B и 405B с контекстом 128K токенов. Их ценят за минимум отказов и хорошую управляемость через системный промпт, поэтому они часто становятся ядром для персональных Telegram-ассистентов. По цене через провайдеров вроде Nous Portal 405B-версия стоит от $0,09 за миллион входных токенов, что заметно дешевле подписки на закрытые модели уровня Claude или GPT.
Стоит ли брать Llama 3.3 70B на мощном железе?
Да, если у вас 48 ГБ видеопамяти или объединенной памяти на Mac. Llama 3.3 70B в Q4_K_M занимает около 42-43 ГБ и дает заметно более качественные рассуждения, чем модели 30-32B.
На картах вроде RTX 4090 24 ГБ модель просто не влезает и уходит в тяжелый оффлоад, что резко режет скорость. А вот на Mac Studio с 128 ГБ объединенной памяти или на паре видеокарт по 24 ГБ Llama 3.3 70B выдает 10-15 токенов в секунду, чего хватает для комфортного диалога и ревью кода. Для агентных сценариев с длинными цепочками вызовов это уже приемлемый темп, хотя и заметно медленнее облачных Opus или Sonnet.
Здесь есть нюанс: если у вас нет 48 ГБ, гнаться за 70B не стоит вообще. Лучше взять Qwen3 32B или Qwen3-Coder-30B, они дадут больше токенов в секунду на том же бюджете и почти не проиграют в качестве на бытовых задачах. Подробный разбор, какая видеокарта и конфигурация нужна под конкретные модели, мы собрали в статье какой компьютер и видеокарта нужны для локальной нейросети.
Как посмотреть какие модели уже стоят на компьютере?
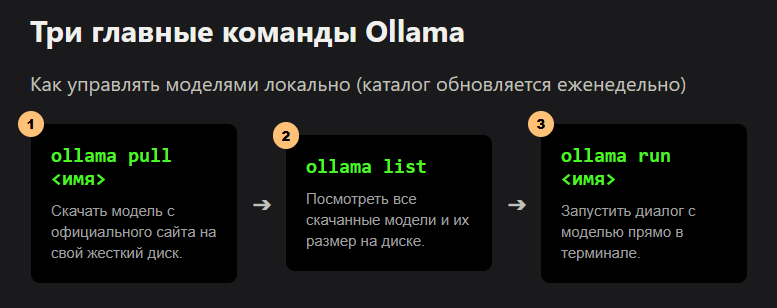
Команда ollama list показывает все локально скачанные модели с их размером на диске. Одновременно активна может быть только одна модель, вторая просто выгрузит первую из памяти.
Если модель не найдена, ollama pull <название> скачивает ее с официального каталога, а ollama run <название> запускает диалог. Каталог на ollama.com обновляется постоянно, и версии в видеогайдах на YouTube устаревают за пару месяцев. Прежде чем качать модель по старому туториалу, стоит свериться с актуальным списком на сайте, там же указаны точные размеры под каждый квант.
Для облачных моделей вроде Kimi логика другая: сначала авторизуетесь через ollama signin, дальше запускаете с суффиксом :cloud, и вся нагрузка уходит на сервера Ollama. Разницу между локальным и облачным режимом, а также когда каждый вариант выгоднее, мы разбирали в статье про Ollama Cloud и облачные модели без своей видеокарты.
Цены и доступность моделей на сентябрь 2026
Локальные модели в Ollama сами по себе бесплатны, платите только за железо или аренду сервера. Облачные модели считаются иначе: Kimi K2.6 через Ollama Cloud идет в рамках бесплатной дневной квоты, а после нее по тарифу Ollama Pro. Hermes 405B через Nous Portal обойдется примерно в $0,09 за миллион входных токенов и $0,37 за выходные, что для персонального ассистента почти незаметная сумма.
Актуальные цифры лучше проверять прямо на ollama.com/library и nousresearch.com, каталог обновляется быстрее любого гайда.
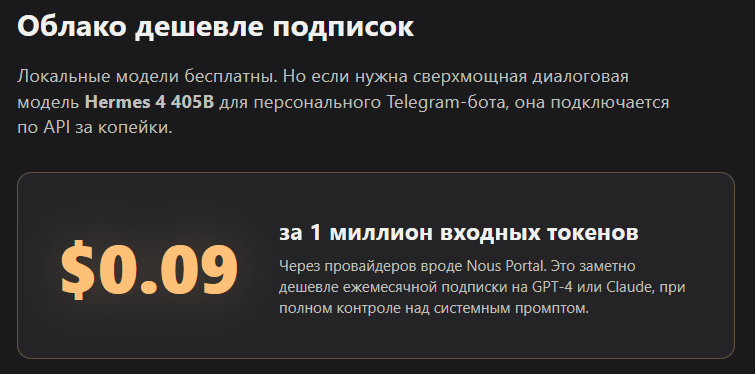
Таблица сравнения моделей по задачам
| Модель | Параметры | Контекст | Где работает |
|---|---|---|---|
| Qwen2.5-Coder 7B | 7B | 32K | Локально, 8 ГБ VRAM |
| Qwen3-Coder-30B-A3B | 30,5B (3,3B активных) | 256K, до 1M | Локально, 24 ГБ VRAM |
| Llama 3.3 70B | 70B | 128K | Локально, 48 ГБ+ |
| Kimi K2.6 | 1T (32B активных) | 256K | Только облако |
| Hermes 4 405B | 405B | 128K | Только облако |
Частые вопросы про модели Ollama
Можно ли запустить Kimi K2.6 на домашнем компьютере?
Нет, модель весит от 350 ГБ даже в сжатом виде. Используйте облачный режим через ollama run kimi-k2.6:cloud, вычисления идут на серверах Ollama.
Что лучше для кода: Qwen3-Coder-30B или Qwen2.5-Coder 32B?
Qwen3-Coder-30B-A3B быстрее за счет MoE-архитектуры и держит контекст до 1M токенов, это лучший выбор при 24 ГБ VRAM. Qwen2.5-Coder 32B чуть точнее на сложных задачах, но требует больше памяти на тот же результат.
Сколько видеопамяти нужно для Llama 3.3 70B?
В Q4_K_M весит около 42-43 ГБ, для комфортной работы с контекстом нужно от 48 ГБ видеопамяти или объединенной памяти на Mac.
Можно ли запускать несколько моделей Ollama одновременно?
Технически да, но активной в моменте будет только одна: при переключении Ollama выгружает предыдущую модель из памяти и загружает новую.
Что значит суффикс MLX у модели?
Модель подготовлена под фреймворк MLX от Apple и оптимизирована под чипы M1-M4, на Mac она работает быстрее обычной GGUF-версии.
Заменяет ли локальная модель подписку на Claude или GPT?
Для рутинного кодинга и чата на своем железе — во многом да, особенно Qwen3-Coder на агентных задачах. Для самых сложных архитектурных решений облачные модели пока точнее.
Где смотреть самые свежие версии моделей?
На ollama.com/library, каталог обновляется чаще, чем выходят новые видеогайды на YouTube.
Разобраться, какая связка модели и агента подойдет именно под ваши задачи, можно на бесплатной консультации у Максима: t.me/maxnagovitsyn. А если ищете готовый инструмент вместо локальной настройки, загляните в каталог AI-инструментов на VibeCoderz.
Обновлено: октябрь 2026.