
Одна модель для всех ролей или разные модели под каждого агента? Короткий ответ: universально правильного варианта нет, всё зависит от разницы в сложности между ролями и от объёма трафика. Multi-agent LLM система на старте вполне работает на одной модели, а смешивание моделей начинает окупаться только тогда, когда счёт за API становится заметной статьёй расходов. Разберём аргументы за оба подхода и дадим практический критерий выбора для конкретной ситуации.
Multi-agent LLM система выигрывает от смешивания моделей ровно тогда, когда роли внутри неё реально разного уровня сложности, а трафика достаточно, чтобы экономия на дешёвых ролях была заметна в счёте. Для маленького прототипа с 2-3 ролями обычно хватает одной модели.
Что такое multi-agent LLM система и почему это не про одну "супермодель"?
Multi-agent LLM - это не одна большая модель, а несколько ролей-агентов, каждая со своей задачей, которые вместе решают то, с чем один запрос к нейросети не справится.
Планировщик разбивает задачу на шаги, исполнитель делает конкретное действие, а координатор собирает результаты в единый ответ. Такую архитектуру описывают почти во всех гайдах по агентам за 2026 год: у каждой роли свой "мозг" (модель), свои инструменты и своя память.
Вопрос, который встаёт сразу после проектирования ролей: одна и та же модель тянет всех агентов или каждой роли нужен свой "мозг" под её уровень сложности. Ответ зависит не от моды на конкретную модель, а от того, насколько роли в вашей multi-agent LLM системе отличаются друг от друга по сложности задачи.
Максим: «У Нейроскрайба ждали от разработчика неделю-две-три. У Нейроштата целая команда работала, ждали целую фичу месяцами». Чем больше движущихся частей в системе, тем дороже каждая правка. С моделями агентов работает та же логика: пока роли простые, лишняя сложность не окупается.
Когда одной модели достаточно для всех агентов?
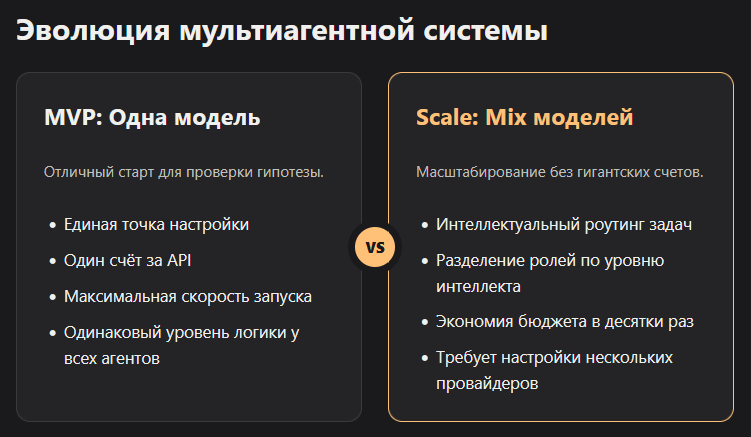
Одна модель на все роли отлично работает на этапе прототипа: единая точка настройки, один счёт за API, не нужно разбираться с особенностями следования инструкциям у разных вендоров.
Единая конфигурация экономит время разработки в моменты, когда важнее скорость запуска, чем оптимизация по стоимости. Если у мультиагентной системы всего 2-3 роли и они примерно сопоставимы по сложности, разделение по мощности модели просто не даёт заметного выигрыша.
У каждой модели свой стиль следования инструкциям и свои сильные стороны. Подключение второго провайдера добавляет отдельный API-ключ, отдельный лимит запросов и отдельную точку отказа. Для команды из одного-двух человек, которая ещё тестирует гипотезу продукта, такая сложность часто просто не окупается временем, которое она отнимает.
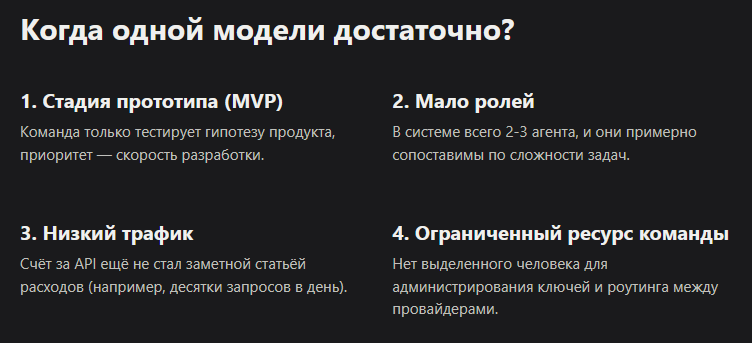
Практический сигнал, что пора остановиться на одной модели: система ещё не прошла стадию прототипа, роли не сильно различаются по сложности задачи, а приоритет команды - скорость разработки, а не экономия на масштабе, которого пока нет.
Почему разные модели под разные роли реально экономят деньги?
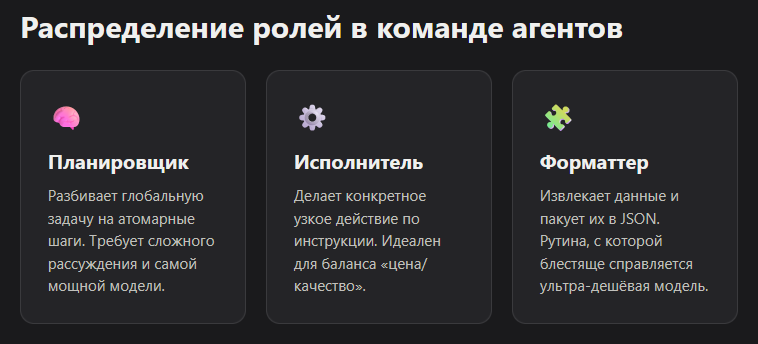
Роль планировщика с декомпозицией задачи выигрывает от мощной модели, а роль простого форматтера данных справляется не хуже на заметно более дешёвой модели без потери качества результата.
Разница в стоимости между моделями по состоянию на март 2026 доходит до 15-20 раз на одном и том же миллионе токенов. По разбору структуры расходов в цепочках агентов за 2026 год, основную долю бюджета system'ы обычно съедает именно токен-стоимость модели, а не инфраструктура вокруг неё, если роли не отсортированы по сложности, что делает выбор модели под каждый шаг цепочки главным рычагом снижения счёта.
Механической роли, которая извлекает данные по явному шаблону или форматирует ответ, мощная и дорогая модель не даёт прироста качества, только прирост счёта. Суммарная стоимость системы падает именно за счёт того, что дорогая модель используется точечно, там, где её мощность реально нужна для сложного рассуждения.
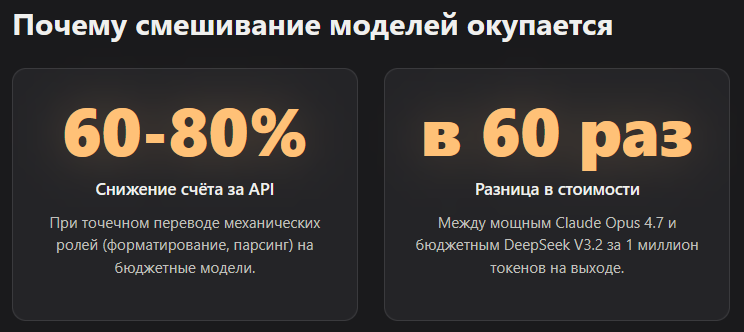
По практике индустрии, интеллектуальный роутинг между провайдерами способен снизить расход на токены на 60-80% для основной массы трафика, сохранив качество для самых требовательных запросов, поскольку не каждый запрос нуждается в максимальной модели для получения приемлемого результата.
Какую модель поставить на роль планировщика, а какую на роль исполнителя?
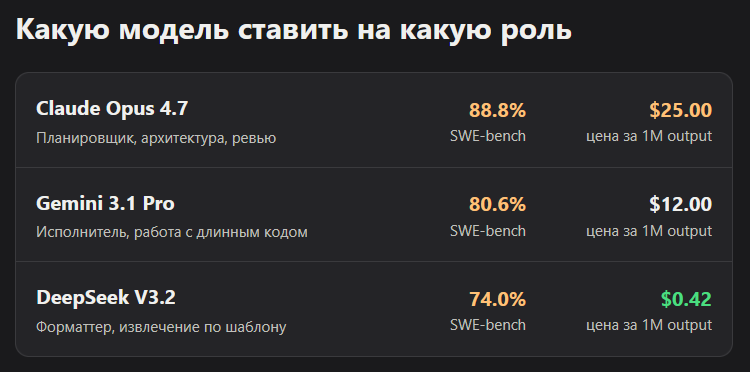
Планировщику и агенту с ревью кода нужна модель с высоким качеством рассуждения, а роли извлечения данных, классификации и форматирования спокойно закрывает бюджетная модель.
Ниже таблица моделей по состоянию на март 2026 с ориентиром, под какую роль в multi-agent LLM системе каждая подходит лучше всего.
| Модель | Цена (input/output за 1M токенов) | SWE-bench | Роль в системе агентов |
|---|---|---|---|
| Claude Opus 4.7 | $5 / $25 | 88.8% | Планировщик, архитектурные решения, ревью сложного кода |
| Claude Sonnet 4.6 | $3 / $15 | 79.6% | Универсальный исполнитель, баланс цена/качество |
| Gemini 3.1 Pro | $2 / $12 | 80.6% | Работа с большими кодовыми базами, длинный контекст |
| GPT-5.4 | $2.5 / $15 | ~80% | Терминальные задачи, написание тестов |
| DeepSeek V3.2 | $0.28 / $0.42 | 72-74% | Форматирование, извлечение данных по шаблону |
Разница между Claude Opus 4.7 и DeepSeek V3.2 по цене output-токена - почти 60 раз. На роли планировщика, где цена ошибки в декомпозиции задачи высокая, переплата за качество обоснована. На роли форматтера, который просто раскладывает уже готовые данные по JSON-схеме, та же переплата - деньги на ветер.
Какой критерий подсказывает, что пора смешивать модели?
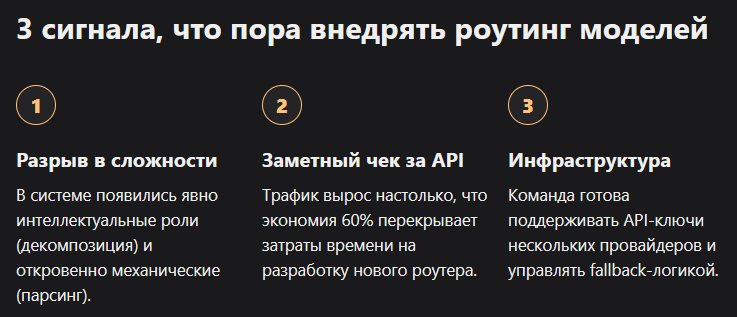
Смешивание моделей оправдано, если роли системы явно разного уровня сложности, трафика достаточно, чтобы экономия была заметна в счёте, и команда готова администрировать конфигурацию из нескольких провайдеров.
Три условия работают вместе, а не по отдельности. Явная разница в сложности между ролями - первый и самый важный сигнал: планировщик и простой форматтер данных очевидно разного уровня задачи, а два похожих по сложности исполнителя - нет.
Второе условие - объём. Экономия в 60-80% на токенах ощутима, только когда база трафика уже заметна в месячном счёте. На пяти запросах в день разница между дорогой и дешёвой моделью - это разница между 20 центами и 3 долларами, ради которой не стоит городить роутинг.
Третье - готовность команды. Несколько провайдеров моделей одновременно означают отдельные ключи, отдельные лимиты и роутер, который решает, куда отправить конкретный вызов. Для команды без выделенного человека под инфраструктуру эта сложность накапливается быстро.
Сколько реально экономит смешивание моделей на практике?
Перевод механических ролей на бюджетную модель при сохранении дорогой модели для планировщика снижает суммарный счёт системы в разы, не трогая качество результата на сложных шагах.
Возьмём цепочку из четырёх агентов: планировщик, два исполнителя и агент-ревьюер. Если все четыре работают на Claude Opus 4.7, стоимость обработки типовой задачи считается по самой дорогой модели на каждом шаге. Если планировщик и ревьюер остаются на Opus, а два исполнителя-форматтера переходят на DeepSeek V3.2, суммарная стоимость цепочки падает в несколько раз, потому что именно исполнители обычно делают основную массу вызовов.
Похожий вывод дают технические отчёты об оптимизации агентных workload'ов за 2026 год: комбинации моделей внутри одного пайплайна тестируют десятками сочетаний именно потому, что оптимальная связка редко совпадает с "везде самая мощная модель", а количество проверяемых комбинаций моделей на одной и той же задаче в подобных экспериментах measures десятками.
Так сколько моделей реально нужно команде агентов?
Универсального числа нет, и любой ответ вида "три модели на систему" будет натяжкой. Небольшой системе с 2-3 сопоставимыми по сложности ролями на этапе прототипа хватает одной модели: проще настроить, проще посчитать бюджет, проще объяснить новому человеку в команде.
Как только в системе появляется явно более сложная роль вроде планировщика и явно более простая вроде форматтера, а трафик уже заметен в счёте за API, смешивание моделей начинает окупать себя. Дальше - вопрос готовности команды администрировать чуть более сложную конфигурацию ради экономии, которая на этом этапе уже реальна, а не гипотетична.
Если проектируете такую систему под конкретную профессиональную задачу, посмотрите каталог AI-инструментов на VibeCoderz - там собраны готовые агенты и IDE для вайбкодинга, с которых можно начать сборку своей связки.
Глоссарий терминов multi-agent LLM
| Термин | Значение |
|---|---|
| Multi-agent LLM | Система из нескольких ролей-агентов на базе языковых моделей, которые вместе решают одну задачу |
| Планировщик | Роль, которая разбивает общую задачу на шаги для остальных агентов |
| Исполнитель | Роль, которая выполняет конкретное узкое действие по инструкции планировщика |
| Роутинг моделей | Логика, которая решает, какую модель вызвать для конкретного шага или роли |
| SWE-bench | Бенчмарк для оценки качества моделей на задачах реального программирования |
| Токен | Единица текста, по которой считается стоимость запроса к модели |
Частые вопросы про multi-agent LLM
Можно ли использовать одну модель для всех ролей в мультиагентной системе?
Да, это нормальная практика для небольшой системы на этапе прототипа. Одна модель упрощает настройку и не требует управления несколькими провайдерами одновременно.
Какая модель лучше подходит на роль планировщика?
Обычно более мощная и дорогая модель вроде Claude Opus 4.7 или Gemini 3.1 Pro, потому что декомпозиция задачи требует сложного рассуждения, а не простого следования шаблону.
Сколько можно сэкономить, смешивая модели по ролям?
По практике индустрии за 2026 год перевод простых ролей на бюджетные модели снижает счёт за токены на 60-80% без заметной потери качества на этих ролях.
Что сложнее администрировать: одну модель или несколько разных?
Несколько моделей от разных провайдеров требуют отдельных API-ключей, разного поведения при следовании инструкциям и роутера, который решает, какую модель вызывать для какой роли.
С какого объёма трафика есть смысл смешивать модели?
Когда объём вызовов уже заметен в месячном счёте за API. На стадии MVP с десятками запросов в день экономия обычно не покрывает сложность настройки.
Нужно ли сразу проектировать систему под несколько моделей?
Нет. Разумнее запустить прототип на одной модели, увидеть реальную нагрузку по ролям и уже потом переводить дешёвые роли на более бюджетные модели.
Как понять, что роль пора перевести на более дешёвую модель?
Если роль механическая: форматирование, извлечение данных по явному шаблону, простая классификация, дорогая модель на ней не даёт прироста качества, только прирост счёта.
Разобраться в архитектуре под свою задачу быстрее с человеком, который уже собирал такие системы. Загляните в каталог AI-инструментов VibeCoderz или запишитесь на консультацию к Максиму.
Обновлено: сентябрь 2026.