Нейросеть для больших текстов читает книгу или отчет целиком только тогда, когда весь документ помещается в ее контекстное окно. Но и в этом случае ответы по разным частям текста получаются разного качества. Ниже разберем, как выбрать модель, сколько текста влезает в окно, где нейросеть теряет детали и как задавать вопросы, чтобы важное не пропало. Если вы берете модели через агрегатор вроде NeuroScribe, сразу смотрите на заявленное окно конкретной модели: даже внутри одного агрегатора оно сильно отличается.
Большой документ нейросеть читает надежно, если он целиком влезает в окно контекста. У современных флагманов оно около 1 миллиона токенов, это порядка трех томов «Войны и мира». Но заявленное окно не равно рабочему. В статье: как считать объем, куда ставить важное и когда резать текст на части.
Какую нейросеть выбрать для работы с большими документами и на что смотреть в первую очередь?
Сначала смотрите на размер контекстного окна модели, а не на громкое название. Если документ в него не помещается, нейросеть видит только часть текста и отвечает по ней.
Контекстное окно задает, сколько текста модель видит за один раз. У Claude Sonnet 5 и Opus 5.5 оно равно 1 миллиону токенов, у Claude Haiku 4.5 всего 200 тысяч. Так выглядят данные Morph на сентябрь 2026. Две модели одной линейки по-разному справятся с одной и той же книгой.
Порядок простой. Оцените объем документа, откройте карточку модели в агрегаторе и найдите цифру окна. В NeuroScribe модели собраны в одном месте, а окна у них разные, поэтому выбирать по привычке рискованно.
Часть окна съедают ваш запрос и ответ. При окне в 1 миллион и лимите ответа 128 тысяч на вход остается около 870 тысяч токенов. Оставляйте запас. Для кода и репозиториев загляните в каталог AI-инструментов: в Claude Code команда /context показывает, сколько окна уже занято.
Что такое контекстное окно и сколько текста в него помещается?
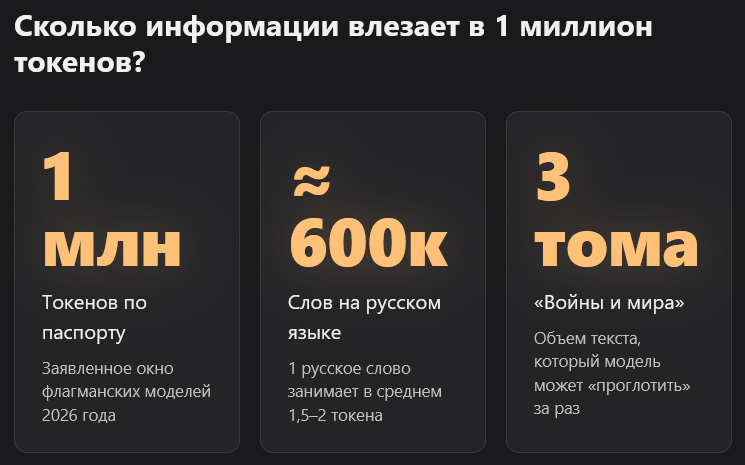
Контекстное окно называют рабочей памятью модели: это предел токенов, которые она учитывает одновременно. Русское слово занимает 1,5-2 токена, так что 1 миллион токенов вмещает около трех томов «Войны и мира».
Токен это кусок слова или слово целиком. В английском одно слово занимает примерно один токен, в русском от полутора до двух. Роман на 100 000 слов дает 150-200 тысяч токенов, и русский текст упирается в лимит быстрее английского.
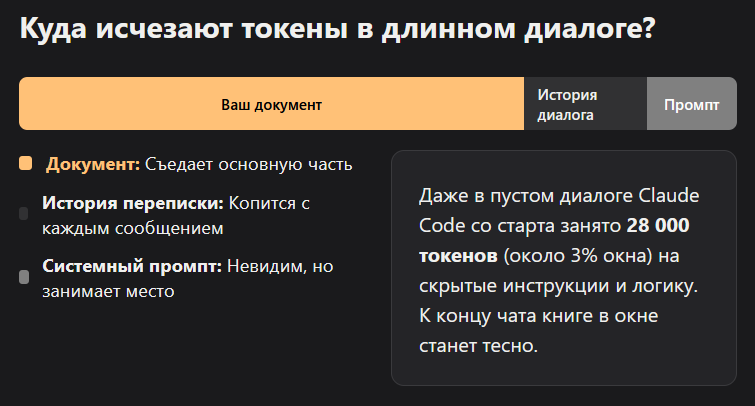
Заполняют окно не только ваши документы. Туда попадают скрытый системный промпт, вся история диалога, прикрепленные файлы и ответы самой модели. Автор одного из разборов на YouTube показал, что в пустом диалоге Claude Code уже занято 28 000 токенов, это 3% миллионного окна.
Отсюда практический вывод. Загрузили книгу, потом час переписывались с нейросетью о ней? К концу разговора окно забито историей, и книге в нем тесно.
Почему нейросеть забывает начало или середину длинного документа?
Заявленное окно показывает, сколько текста модель принимает, а не сколько она использует одинаково хорошо. Точность зависит от места факта в документе и падает вместе с ростом объема.
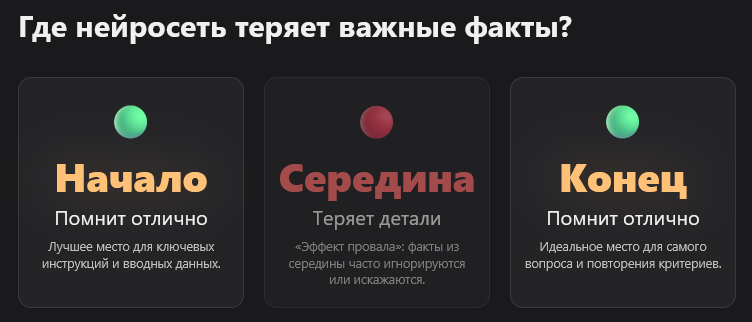
В исследовании Liu и соавторов модели точнее всего отвечали, когда нужный факт стоял в начале или в конце входа, и заметно хуже, когда он лежал в середине. Это касалось и моделей, созданных под длинный контекст. Работа вышла в 2023 году, а в 2024 ее опубликовал журнал TACL. Ссылка: arXiv 2307.03172.
Что такое заявленный и эффективный контекст?
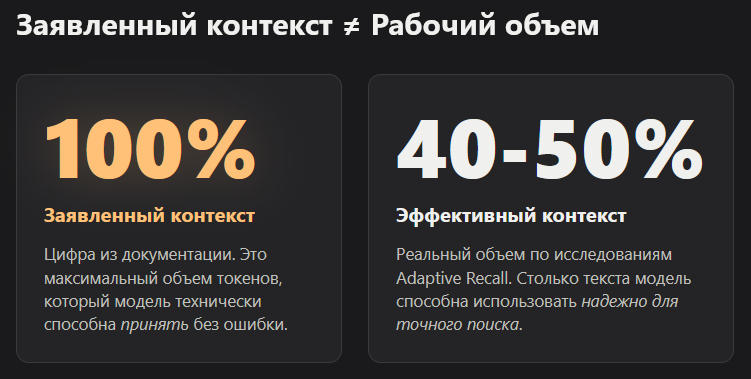
Заявленный контекст это цифра из документации: сколько токенов модель принимает. Эффективный контекст показывает, сколько из них она использует надежно. Morph ссылается на документацию Anthropic: с ростом числа токенов точность и полнота извлечения падают, явление называют context rot.
Один из авторов разборов по Claude Code называет порогом 150-200 тысяч токенов, после которых модель начинает игнорировать инструкции. Это личное наблюдение практика, а не закон. Обзор Adaptive Recall советует для задач с точным поиском планировать 40-50% от заявленного окна.
Где именно проседает качество?
Картина зависит от модели. В том же исследовании у Llama-2 на 7 миллиардов параметров выигрывал только конец текста, начало не помогало. Поэтому вывод один: ни одна модель не гарантирует одинаковую надежность по любой части сколь угодно длинного текста, и свою связку нужно проверять на своем документе.
Как заставить нейросеть заметить важные фрагменты большого документа?
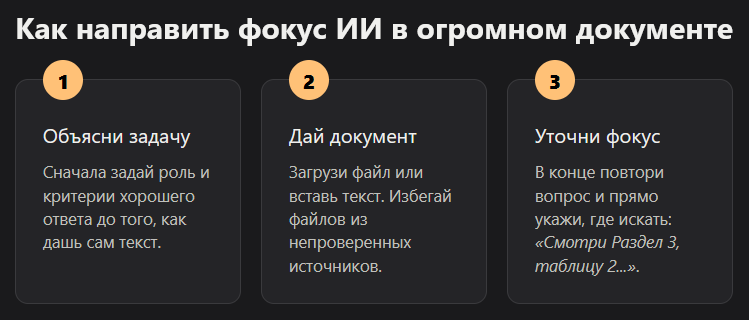
Назовите важные места прямо в запросе: раздел, страницу, ключевые слова. Нейросеть не всегда сама поймет, какой кусок из сотен страниц решает ваш вопрос.
Рабочая схема из трех шагов. Сначала объясните задачу и критерии хорошего ответа, потом дайте документ, в конце повторите вопрос. Указывайте, где искать: «раздел 4, таблица с выручкой». Просите цитаты и номера страниц, а потом проверяйте их вручную.
Вот промпт, который можно копировать:
Ниже отчет на 80 страниц. Сначала прочитай раздел 3 «Риски» и таблицу 2 на странице 41: это самое важное. Ответь, какие три риска названы критичными и почему. К каждому ответу дай короткую цитату и номер страницы. Если ответа в тексте нет, так и напиши.Последняя фраза промпта нужна не для красоты. Она оставляет модели право сказать «не нашла» вместо того, чтобы придумать правдоподобный ответ.
Можно ли доверять документу из интернета?
Осторожнее с чужими файлами. В длинном тексте можно спрятать инструкцию для модели, и она иногда пробивает защитные механизмы. Загружаете PDF от незнакомого источника? Читайте ответ критично и не давайте нейросети права что-то отправлять или удалять.
Что делать, если документ больше контекстного окна?
Разбейте его на логические части, обработайте каждую отдельно и соберите итог из промежуточных выжимок. Для постоянной работы с большой базой документов подходит подход RAG.
Схема для гигантских текстов такая: глава 1 -> выжимка, глава 2 -> выжимка, затем итоговый запрос по всем выжимкам. RAG работает похоже. Система сама находит нужные куски базы и подает модели только их, поэтому контекст остается чистым, а ответ опирается на конкретные фрагменты.
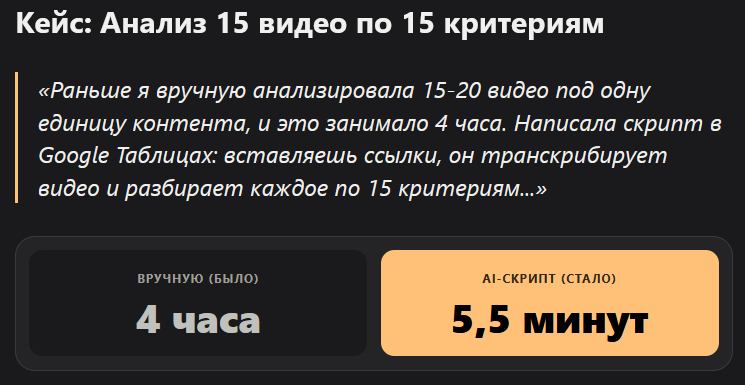
Лиза: «Раньше я вручную анализировала 15-20 видео под одну единицу контента, и это занимало 4 часа. Написала скрипт в Google Таблицах: вставляешь ссылки, он транскрибирует видео и разбирает каждое по 15 критериям. Теперь 5,5 минут. Прикинь.»
Обратите внимание на устройство скрипта: каждое видео он обрабатывает отдельно и по 15 критериям. Та же логика работает в кодовых инструментах. В Cursor и Claude Code при долгой сессии помогает сжатие диалога командой compact, а еще просьба вести лог-файл, чтобы прогресс не жил только в памяти модели. Если сжатие не спасает, открывайте новый диалог.
Какое окно у популярных моделей в сентябре 2026 и кому что подходит?
Окно около 1 миллиона токенов стало стандартом флагманов. Выбирать теперь стоит по цене, скорости и качеству на длинном тексте, а не по одной цифре из рекламы.
По данным Upsolve на сентябрь 2026, у GPT-5.6 окно составляет 1,05 миллиона токенов, у Claude Opus 5 и Sonnet 5 миллион, у Gemini 3.1 Pro тоже около миллиона, а у Grok 4.20 два миллиона. Цифра больше не отличает модели друг от друга. Отличают цена и поведение на длинном тексте.
| Модель | Окно | Кому подходит |
|---|---|---|
| Claude Haiku 4.5 | 200 тысяч токенов | Отчеты и статьи, быстрые выжимки |
| Claude Sonnet 5 / Opus 5.5 | 1 миллион токенов | Книги, большие отчеты, кодовые базы |
| Gemini 3.1 Pro | около 1 миллиона токенов | Объемные документы и архивы |
| GPT-5.6 | 1,05 миллиона токенов | Длинные документы с запасом |
| Grok 4.20 | 2 миллиона токенов | Очень большие подборки материалов |
Таблица отражает данные Morph и Upsolve на сентябрь 2026. Перед покупкой проверьте цифры в документации провайдера: линейки моделей меняются каждые несколько месяцев.
Когда длинный контекст выигрывает, а когда лучше резать документ?
Целиком стоит загружать текст, где важны связи между главами. Резать лучше, когда нужны точные факты, дешевле и стабильнее ответ.
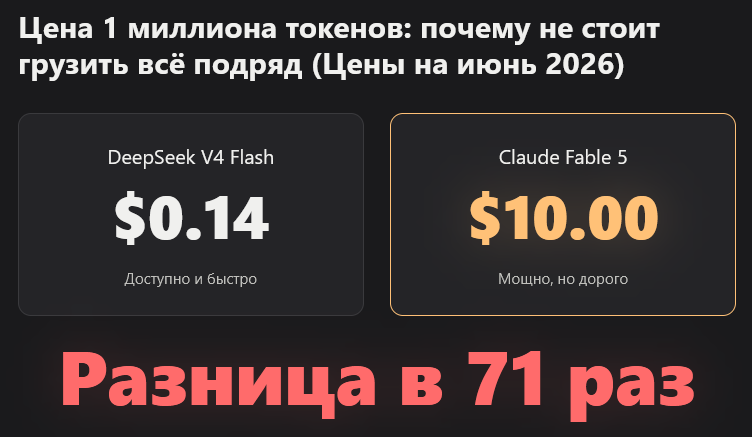
Заполнить окно в 1 миллион токенов на DeepSeek V4 Flash стоит около 0,14 доллара, а на Claude Fable 5 около 10 долларов. Так было в июне 2026, и разброс в 71 раз объясняет, почему бездумная загрузка всего подряд бьет по бюджету.
| Длинный контекст целиком | Нарезка на части | |
|---|---|---|
| Сильные стороны | Модель видит связи между главами и повторы | Дешевле, точнее по конкретным фактам |
| Слабые стороны | Дорого, риск потерять середину | Теряются связи между частями |
| Лучше для | Резюме книги, поиск противоречий | Вопросы по базе, регламентам, договорам |
Честная оговорка: метод с нарезкой требует больше ручной работы. Придется самим решить, как делить текст, и следить, чтобы выжимки не исказили смысл. Зато для критичных документов это надежнее.
С чего начать работу с большим текстом уже сегодня?
Оцените объем, выберите модель с запасом окна, назовите важные места в запросе и проверьте цитаты. Если документ огромный, режьте его и собирайте выжимки.
Четыре шага на сегодня. Посчитайте слова и умножьте на 1,5-2. Откройте карточку модели и сверьте окно. Добавьте в запрос разделы и страницы, где лежит суть. Попросите цитаты и проверьте две-три из них руками.
Проверка окна до загрузки занимает минуту. После загрузки она обычно занимает вечер.
Частые вопросы про нейросеть для больших текстов
Можно ли загрузить целую книгу в нейросеть и получить ответ?
Можно, если книга помещается в окно модели. Роман на 100 000 слов дает 150-200 тысяч токенов, это влезает в модели с окном в 1 миллион. Для проверки задайте вопросы по началу, середине и концу и сравните ответы с текстом.
Почему нейросеть забывает начало документа?
Модель не хранит текст как человек. Качество зависит от места факта, а в длинном тексте оно просаживается. У разных моделей картина своя: в исследовании Liu и соавторов лучше работали начало и конец, а у Llama-2 7B только конец.
Сколько слов помещается в 1 миллион токенов?
На русском примерно 500-670 тысяч слов, если считать 1,5-2 токена на слово. Автор разбора на YouTube прикинул это как три тома «Войны и мира». Из окна надо вычесть запрос, историю диалога и ответ, поэтому реальный запас меньше.
Чем отличается заявленный контекст от эффективного?
Заявленный контекст это то, сколько токенов модель принимает. Эффективный показывает, сколько она использует надежно. Обычно он меньше заявленного, а на задачах с точным поиском может заметно отставать: Adaptive Recall советует планировать 40-50% окна.
Как проверить, что нейросеть не выдумала ответ по документу?
Попросите цитату и номер страницы для каждого вывода, потом найдите их в файле. Добавьте разрешение ответить «в тексте этого нет». Модель без такой оговорки чаще додумывает правдоподобное. Выборочно проверьте две-три цитаты руками, этого хватает, чтобы заметить проблему.
Как работать с текстом, который больше контекстного окна?
Разбейте текст на главы, сделайте выжимку по каждой, затем задайте итоговый вопрос по выжимкам. Для постоянной базы документов используйте RAG: система сама подает модели только нужные фрагменты. Так контекст остается чистым, а ответы опираются на конкретные куски.
Что почитать дальше
Соберите свой набор инструментов в каталоге AI-инструментов VibeCoderz. Про среды для работы с кодом и длинными сессиями читайте в обзорах Claude Code и Cursor. Хотите разобрать свой документ и подобрать под него связку? Запишитесь на консультацию к Максиму.
Обновлено: октябрь 2026