
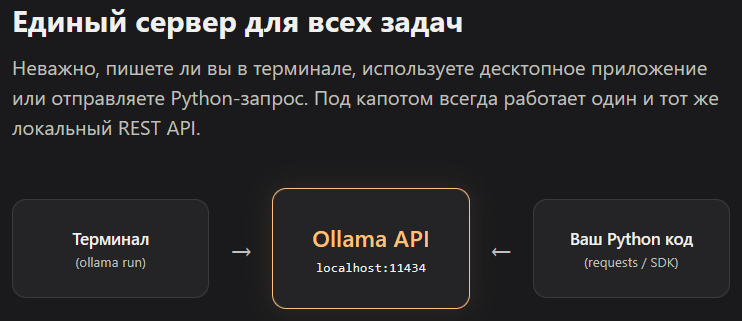
Ollama API это не отдельная функция, которую нужно где-то включать, а обычный REST-сервер, который Ollama поднимает на localhost сразу после установки. Даже когда вы просто вводите ollama run llama3.2 и общаетесь с моделью в терминале, команда под капотом стучится в тот же самый API. Ниже разберем, как вызвать Ollama API из своего кода на Python, чем отличаются эндпоинты /api/generate и /api/chat и когда реально нужен API-ключ.
Ollama всегда работает как REST API сервер на localhost:11434, даже если вы просто общаетесь с моделью через терминал. Разбираем запуск ollama serve, разницу между /api/generate и /api/chat, вызов из Python через requests и через официальную библиотеку ollama, а также OpenAI-совместимый эндпоинт для быстрой замены облачного провайдера.
Что такое Ollama API и зачем он нужен, если я и так общаюсь через терминал?
Терминальный чат ollama run тоже общается с локальным HTTP-сервером Ollama. Тот же сервер можно вызывать напрямую из своего кода без единого платного API-вызова.
Ollama поднимает REST API сервер на порту 11434 сразу после установки, причем на macOS и Windows сервис стартует в фоне автоматически. На Linux его запускают через systemctl start ollama или вручную командой ollama serve. Это описано в официальной документации Ollama и подтверждается независимыми разборами кода.
Разница простая. Клиент в терминале, интерактивный чат, десктопное приложение — все это интерфейсы. Под ними один и тот же сервер отвечает на HTTP-запросы. Как только вы это понимаете, Ollama перестает быть просто чатом для баловства и превращается в бесплатный локальный backend. Chat-бот, инструмент саммаризации, классификатор обращений — все это можно собрать на связке с локальной моделью, не отправляя ни рубля ни одному облачному провайдеру.
Как проверить что сервер Ollama действительно запущен?
Проще всего постучаться в корень API через curl. Если сервер работает, вернется короткая текстовая строка, а не ошибка соединения.
Одна команда в терминале снимает все вопросы: curl http://localhost:11434/. В ответ приходит строка «Ollama is running» — сервер жив и принимает запросы на порту 11434 по умолчанию. Если строки нет, скорее всего сервис еще не стартовал, и его нужно поднять вручную командой ollama serve.
Полезно держать это в голове перед тем, как писать код для своего проекта. Не работает интеграция? Первым делом проверьте не саму библиотеку, а сам сервер. На практике половина проблем на старте — это просто незапущенный ollama serve, а не баг в скрипте.
Чем отличаются эндпоинты /api/generate и /api/chat?
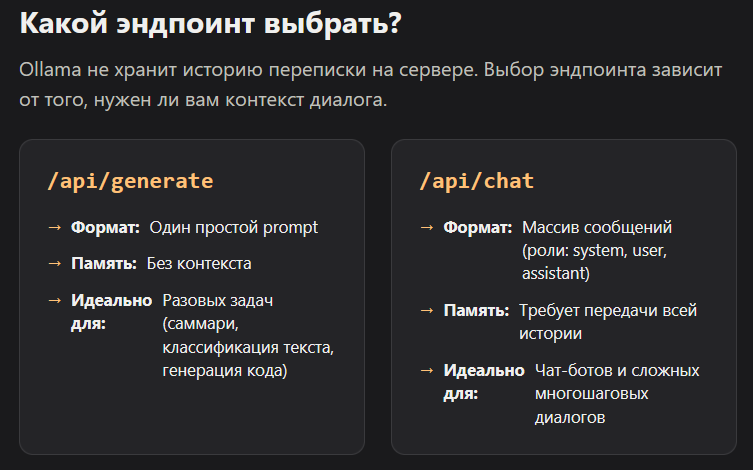
generate подходит для разовых запросов без памяти диалога. chat нужен, когда важна история сообщений: система сама не хранит контекст, его приходится передавать заново при каждом вызове.
По данным официальной документации, /api/generate возвращает завершение по одному промпту, а /api/chat работает с массивом сообщений, где у каждого есть роль: system, user, assistant. Ollama не сохраняет состояние между запросами, поэтому для продолжения диалога всю историю приходится отправлять заново при каждом обращении к серверу.
| Эндпоинт | Формат запроса | Когда использовать |
|---|---|---|
| /api/generate | один prompt | одноразовые задачи: саммари, классификация, генерация текста без контекста |
| /api/chat | массив messages с ролями | чат-боты, диалоги, все что требует памяти предыдущих реплик |
| /v1/chat/completions | формат OpenAI | быстрая замена облачного провайдера без переписывания клиентского кода |
Оба эндпоинта по умолчанию отдают ответ в потоковом режиме, токен за токеном. Если стрим не нужен, в теле запроса достаточно передать "stream": false — тогда ответ придет одним куском вместе с метаданными: сколько токенов ушло на вычисление и сколько времени занял запрос.
Как вызвать Ollama API из Python без библиотек?
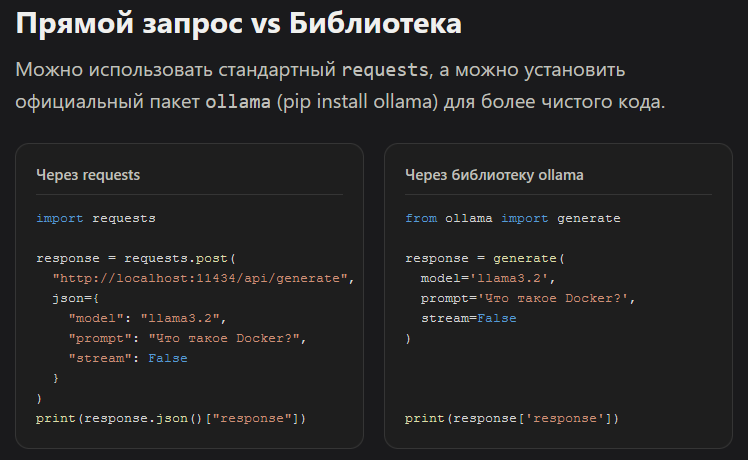
Ollama API это обычный HTTP-сервер, поэтому запрос можно отправить любым инструментом: curl, Postman или прямым POST-запросом из requests.
Минимальный вызов через requests выглядит так:
import requests

response = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.2",
        "prompt": "Объясни что такое Docker в трех предложениях",
        "stream": False
    }
)

print(response.json()["response"])
Никакого API-ключа, никакой авторизации. Модель должна быть заранее скачана командой ollama pull llama3.2, иначе сервер вернет ошибку, что модель не найдена локально.
Как упростить код через официальную библиотеку ollama?
Библиотека ollama для Python оборачивает те же HTTP-запросы в понятные функции: chat, generate, pull, list. Ставится одной командой pip install ollama.
Для более чистого кода есть официальная Python-библиотека, которая просто оборачивает те же самые HTTP-вызовы:
from ollama import chat

response = chat(model='llama3.2', messages=[
    {'role': 'user', 'content': 'Почему небо голубое?'}
])

print(response['message']['content'])
Для потокового вывода достаточно добавить stream=True и пройтись циклом по чанкам ответа. Библиотека повторяет структуру REST API один в один: chat() для /api/chat, generate() для /api/generate, pull() для скачивания моделей, list() для списка установленных.
Нужен ли API-ключ для Ollama?
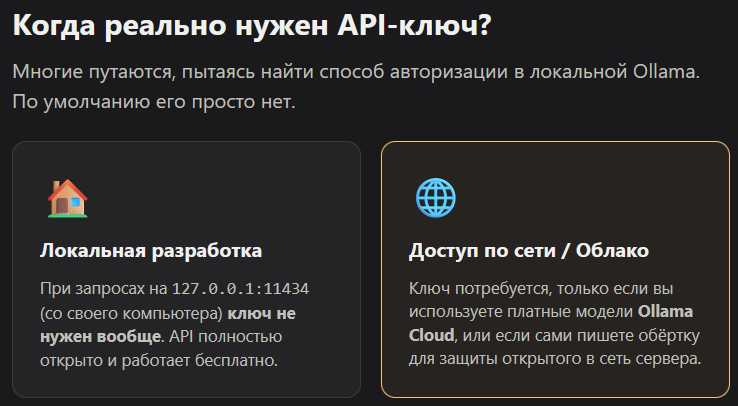
Для чисто локального использования на своей машине ключ не нужен вообще. Он требуется только для облачных моделей Ollama Cloud или при открытии сервера для доступа по сети.
Здесь чаще всего путаются. У облачных провайдеров ключ обязателен всегда, у Ollama при локальной работе он вообще не участвует в процессе. Ключ становится нужен в двух случаях: если вы подключаетесь к облачным моделям Ollama Cloud, или если открываете свой локальный сервер для доступа с других устройств в сети.
За доступ по сети отвечает переменная OLLAMA_HOST. По умолчанию она равна 127.0.0.1:11434, и сервер отвечает только на локальные запросы с той же машины. Если поменять значение на 0.0.0.0:11434, сервер станет доступен из локальной сети — и вот тут уже стоит задуматься о защите.
| Переменная | Значение по умолчанию | За что отвечает |
|---|---|---|
| OLLAMA_HOST | 127.0.0.1:11434 | адрес и порт, на которых слушает сервер |
| OLLAMA_ORIGINS | не задано | список разрешенных источников для CORS, нужен при вызовах из браузера |
| OLLAMA_MODELS | системная папка по умолчанию | путь хранения скачанных моделей на диске |
Как использовать Ollama через OpenAI-совместимый эндпоинт?
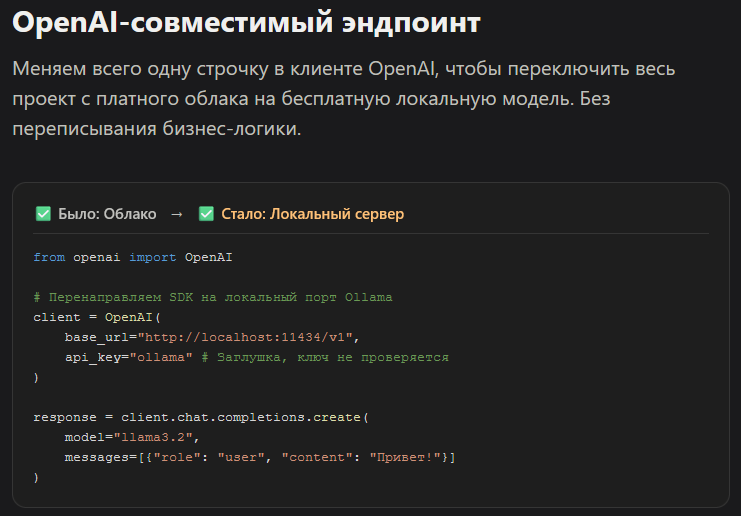
Ollama отдает не только собственный формат ответа, но и эндпоинт /v1/chat/completions, полностью совместимый с форматом OpenAI. Меняется одна строка в клиенте.
Если проект уже написан под OpenAI SDK, переезжать на Ollama можно почти без переписывания кода. Достаточно поменять base_url:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:11434/v1", api_key="ollama")

response = client.chat.completions.create(
    model="llama3.2",
    messages=[{"role": "user", "content": "Привет!"}]
)
Ключ api_key="ollama" здесь формальность. Сам SDK требует, чтобы поле не было пустым, но Ollama его никак не проверяет. Такой подход удобен для миграции: пишете прототип на облачной модели, а после теста переключаетесь на локальную без переписывания бизнес-логики.
Как защитить Ollama API, если открыл доступ по сети?
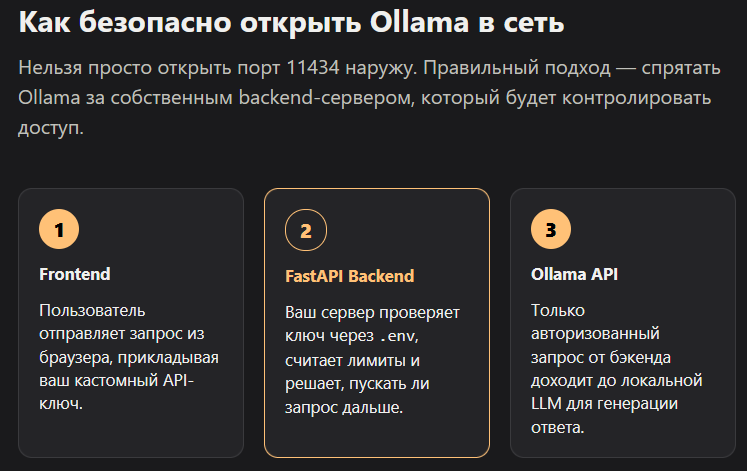
Собственный API-ключ и лимиты запросов встроить проще, чем кажется: небольшой FastAPI-сервер между фронтендом и Ollama полностью контролирует, кто и сколько может обращаться к модели.
Прямой вызов LLM из фронтенда, будь то облачный провайдер или локальный сервер в сети, открывает доступ каждому, кто видит код клиента. Правильная схема — фронтенд обращается к собственному backend, а уже backend решает, стоит ли пускать запрос дальше к модели. На этом принципе строится связка Python + FastAPI + Ollama: свой эндпоинт /generate, проверка API-ключа через .env и fastapi.Depends, лимит запросов на ключ по принципу кредитов. Тестировать такой сервер удобно через Postman или прямо из PyCharm.
Максим: «Я уверен полностью, что языки программирования вообще не нужно изучать. Нейросети обучены на 80+ языках. Нужно погружаться в архитектуру: фронт, бэк, база данных.»
Собрать такой слой самому — задача на вечер, а не на неделю разработчиков. Если хочется делегировать настройку сервера и деплой, посмотрите подборку агентов для DevOps-задач на портале.
Итог: когда встраивать Ollama API в свой проект
Локальный API имеет смысл там, где важна приватность данных, нет бюджета на облачные токены, или проект уже упирается в лимиты платных провайдеров. Для прототипа, внутреннего инструмента команды или чат-бота без огромной нагрузки Ollama закрывает вопрос backend'а бесплатно. Для продакшена с большим потоком пользователей стоит сразу закладывать свой слой авторизации поверх сервера, тот же принцип, что и с любым другим LLM API.
Разница между /api/generate, /api/chat и OpenAI-совместимым эндпоинтом решается один раз при выборе архитектуры и дальше не требует пересмотра. Если проект начинался на облаке, а сейчас упирается в стоимость токенов — миграция на Ollama обычно занимает пару часов, не дней.
Частые вопросы про Ollama API
Ollama работает как API даже без специальной настройки?
Да. Сразу после установки Ollama поднимает сервер на localhost:11434, и все взаимодействия, включая чат в терминале, идут через этот же сервер.
Какой порт использует Ollama по умолчанию?
Порт 11434. Изменить его можно через переменную окружения OLLAMA_HOST, если нужен другой адрес или доступ по сети.
Чем /api/generate отличается от /api/chat на практике?
generate подходит для разовых задач без памяти диалога, chat принимает массив сообщений с ролями и лучше подходит для чат-ботов. История сообщений в обоих случаях хранится на стороне клиента, а не сервера.
Нужен ли платный аккаунт для вызова Ollama API из своего проекта?
Нет, если модель запускается локально на вашем железе. Платный аккаунт и ключ нужны только для облачных моделей Ollama Cloud.
Можно ли вызывать Ollama API из Node.js, а не только из Python?
Да, сервер отвечает на обычные HTTP-запросы, поэтому подойдет любой язык с поддержкой fetch или аналогичного клиента. Официальная Python-библиотека — лишь удобная обертка, не единственный способ подключения.
Что делать, если запрос к API возвращает ошибку про отсутствующую модель?
Модель нужно сначала скачать командой ollama pull имямодели. Сервер API не скачивает модели автоматически при первом обращении через код, в отличие от команды ollama run в терминале.
Безопасно ли открывать Ollama API для доступа из локальной сети?
Само по себе нет, потому что сервер по умолчанию не требует авторизации. Для сетевого доступа стоит добавить собственный слой с API-ключами и лимитами запросов, как в связке с FastAPI.
Больше про локальный стек для вайбкодинга: Локальный AI стек для вайбкодинга за 0 рублей и Локальная нейросеть для программирования. Полный каталог IDE и AI-инструментов — на vibecoderz.ru/ide. Если нужна помощь с архитектурой своего продукта, запишитесь на консультацию к Максиму.
Обновлено: октябрь 2026.