
Выбор между Ollama, LM Studio, vLLM и llama.cpp зависит не от того, какой инструмент «лучше», а от сценария. Ollama побеждает по простоте старта, LM Studio даёт визуальный интерфейс и встроенный RAG, vLLM держит продакшн-нагрузку с сотнями пользователей, а llama.cpp напрямую нужен только тем, кто упёрся в конкретное техническое ограничение. Ниже — сводная матрица по всем четырём и практическая рекомендация под четыре профиля пользователя.
Ollama, LM Studio, vLLM и llama.cpp решают разные задачи локального запуска нейросетей в 2026 году. В статье: сравнительная таблица по сложности установки и сценариям, рекомендация под 4 профиля пользователя и объяснение, почему инструменты не исключают друг друга.
Чем принципиально отличаются эти четыре инструмента?
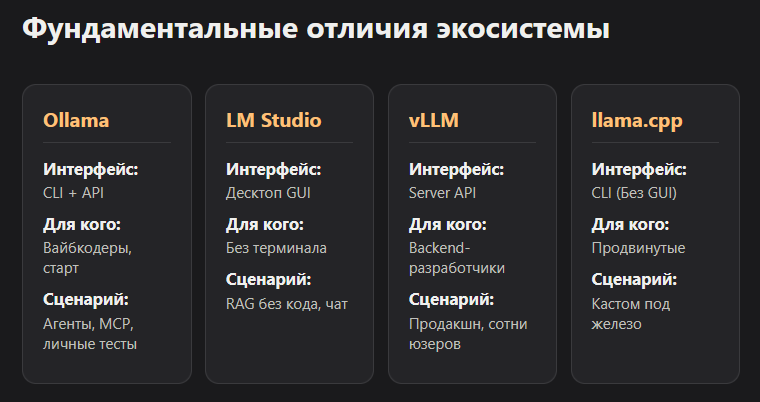
Ollama — про простоту и экосистему, LM Studio — про визуальный интерфейс, vLLM — про продакшн-нагрузку, llama.cpp — про максимальный контроль на низком уровне. Все четыре построены вокруг одного и того же принципа: модель весит меньше, если её квантовать.
Все четыре инструмента запускают open-weight модели вроде Llama, Qwen или DeepSeek на вашем железе. Но задачи, под которые их проектировали, разные. Llama.cpp появился первым и стал фундаментом: именно на нём строятся Ollama и многие другие обёртки. vLLM решал другую задачу — как обслужить тысячи одновременных запросов без деградации скорости.
| Критерий | Ollama | LM Studio | vLLM | llama.cpp |
|---|---|---|---|---|
| Сложность установки | Одна команда | Установщик, GUI | Требует настройки окружения | Сборка из исходников или бинарник |
| Интерфейс | CLI + API | Десктопное приложение | Только API, без GUI | CLI, без GUI |
| Формат моделей | Собственный registry поверх GGUF | GGUF, MLX | Собственные веса, safetensors | GGUF |
| Лучший сценарий | Личные эксперименты, агенты, MCP | Работа с документами, RAG без кода | Продакшн-сервис с высокой нагрузкой | Кастомная сборка под железо |
| Для кого | Новички и вайбкодеры | Пользователи без терминала | Backend-разработчики | Продвинутые пользователи |
Когда выбрать Ollama?
Ollama подходит большинству вайбкодеров, начинающих с локальных моделей: одна команда для установки модели, встроенный OpenAI-совместимый API и растущая экосистема MCP-интеграций. Это стартовая точка по умолчанию, если нет специфичных требований.
Модель скачивается и запускается одной командой ollama run, дальше инструмент сам подбирает квантизацию под доступную память. За 2026 год у Ollama появились облачные модели (Ollama Cloud), встроенный веб-поиск и MCP-серверы, через которые Ollama подключается к Claude Desktop, Cursor и другим агентным инструментам. Для тех, кто пишет код с помощью AI, это удобно: локальная модель встраивается в тот же MCP-контур, что и облачные.
Из наших видео на эту тему: локальные модели с меньшим числом активных параметров работают быстрее на слабом железе, а сам факт, что можно не отправлять корпоративные данные в облако, для многих вайбкодеров становится решающим аргументом. Ollama здесь выигрывает именно за счёт скорости старта, а не за счёт пиковой производительности.
Когда LM Studio удобнее Ollama?
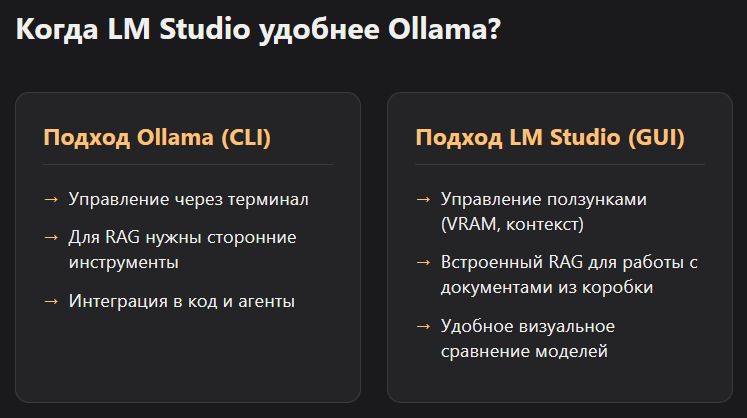
LM Studio выигрывает, когда важен визуальный интерфейс без терминала, встроенный RAG для работы с документами из коробки и удобное сравнение нескольких моделей на глаз перед выбором. Для непрограммиста это часто комфортнее командной строки.
LM Studio — десктопное приложение с поиском моделей внутри интерфейса, ползунками контекста и графиками загрузки VRAM. В 2026 году в LM Studio добавили LM Link — подключение к удалённым инстансам LM Studio через сквозное шифрование, и обновили RAG-конвейер под модели вроде Qwen 3.5. По факту это тот же движок llama.cpp внутри, но обёрнутый в интерфейс, который не пугает человека без опыта разработки.
В одном из разобранных видео автор тестировал LM Studio на бытовом ноутбуке без дискретной видеокарты и всё равно решал реальные задачи: извлекал реквизиты компании из документов и писал код. Разница с платными моделями вроде Claude или GPT оказалась не катастрофической, если правильно выстроить промпт и контекст вокруг модели.
В чём разница между vLLM и остальными тремя?
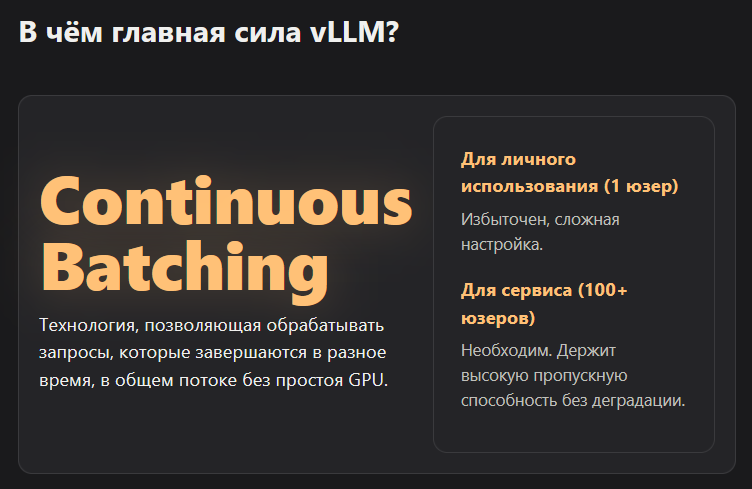
vLLM решает задачу другого класса — обслуживание production-нагрузки с десятками и сотнями одновременных пользователей, где Ollama и LM Studio физически не справляются с пропускной способностью. Для личного использования vLLM избыточен.
vLLM построен вокруг continuous batching и PagedAttention: запросы, которые завершаются в разное время, обрабатываются в общем потоке без простоя GPU, а KV-кэш переиспользуется эффективнее, чем в обычных движках. По сути это отдельная категория инструментов, не конкурент Ollama или LM Studio, а инфраструктурный слой для тех, кто уже развернул сервис в Kubernetes или на выделенной VM.
Настраивать vLLM сложнее: нужно понимать, что такое батчирование запросов, как работает дисагрегация pre-fill и decode-стадий, и держать в голове совместимость с оборудованием. Если сравнивать в лоб llama.cpp и vLLM по способности масштабироваться, у llama.cpp это доступность на потребительском железе, у vLLM — производительность под нагрузкой в продакшене.
Максим: «Мог просто засесть до пяти ночи и просто там править одну какую-то функцию, которая не работала. Если бы не терпение, в моменте я уже испотел, и мне хотелось просто всё это закрыть. Но я понимал, что это можно решить и нужно решить, чтобы идти дальше.»
Настройка vLLM под конкретное железо требует такого же упорства: с первого раза редко всё поднимается гладко.
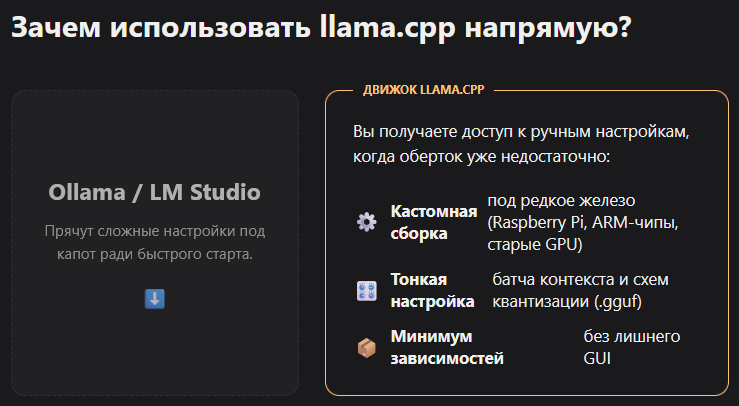
Зачем использовать llama.cpp напрямую, если Ollama и так на нём работает?
llama.cpp напрямую нужен, когда требуется максимальный контроль над параметрами инференса, кастомная сборка под редкое железо или минимум зависимостей без обёрточного приложения поверх движка. Это точка входа не для новичка, а для тех, кто уже упёрся в ограничение.
Ollama и LM Studio берут именно llama.cpp за основу, но прячут от пользователя параметры вроде размера батча контекста, точной схемы квантизации или флагов сборки под конкретный процессор. Когда нужно выжать максимум из Raspberry Pi, старого ноутбука без GPU или специфичного ARM-чипа, эти параметры внезапно начинают иметь значение. Формат .gguf, который объединяет веса, токенизатор и конфигурацию в одном файле, тоже придумали в экосистеме llama.cpp, и это сильно упростило перенос моделей между инструментами.
Работать с llama.cpp напрямую — значит собирать бинарник под своё железо и вручную выставлять флаги квантизации. Это не для тех, кто хочет запустить модель за пять минут. Это для тех, кому обёртки Ollama и LM Studio уже не дают нужной гибкости.
Как выбрать инструмент под свой профиль?
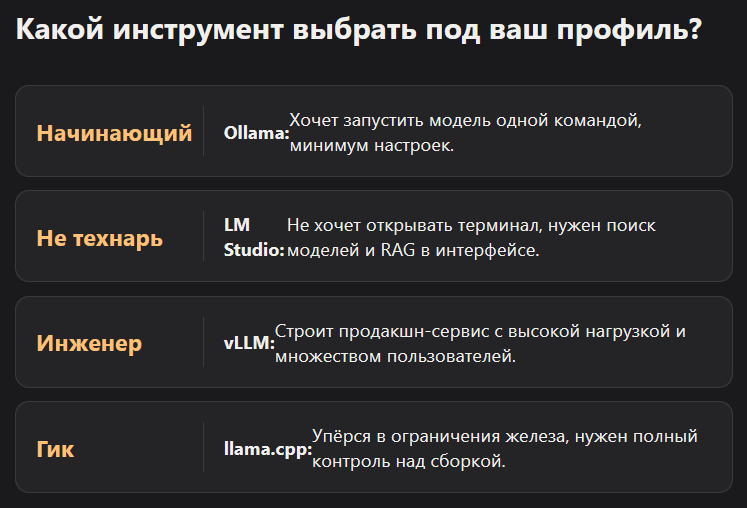
Профиль пользователя решает больше, чем формальные технические характеристики инструмента. Матрица ниже — рабочий ориентир, а не догма: у большинства вайбкодеров профиль со временем меняется.
| Профиль | Инструмент | Почему |
|---|---|---|
| Новичок в локальных моделях | Ollama | Одна команда, готовые модели, минимум настроек |
| Не хочет открывать терминал | LM Studio | GUI, встроенный поиск моделей, RAG без кода |
| Строит production-сервис с нагрузкой | vLLM | Continuous batching держит сотни запросов без деградации |
| Упёрся в конкретное ограничение железа | llama.cpp напрямую | Полный контроль над квантизацией и сборкой |
Если у вас профессия завязана на постоянную работу с документами и структурированными данными, посмотрите каталог готовых решений: агенты для работы с документами. Там же можно найти нишевые сценарии под конкретную задачу, а не только под инструмент.
Обязательно ли выбирать один инструмент навсегда?
Нет. Типичный путь вайбкодера — начать с Ollama для личных экспериментов, попробовать LM Studio для задач с документами через встроенный RAG, и только при реальном росте нагрузки перейти на vLLM. Инструменты дополняют друг друга, а не исключают.
Ollama и LM Studio часто стоят на одной машине одновременно: одна для быстрых CLI-запросов и MCP-агентов, вторая для визуальной работы с документами. Переход к vLLM происходит не потому, что Ollama «плохой», а потому что появляется новая задача — обслужить множество пользователей одновременно, а не один локальный чат. llama.cpp напрямую подключают точечно, когда конкретный сценарий (слабое железо, редкий чип, минимум зависимостей) требует того, что обёртки не дают.
Из наблюдений по видео на тему локальных моделей: даже разработчики, которые сравнивают llama.cpp и vLLM в лоб, признают, что оба движка стремятся к совместимости с API OpenAI. Это как раз то, что позволяет менять инструмент под капотом, не переписывая приложение сверху.
Ещё один сценарий сравнения — выбор именно под задачи программирования: локальная нейросеть для программирования.
Итог: что выбрать в 2026
Если сомневаетесь, с чего начать, начните с Ollama. Она бесплатна, ставится за пару минут и покрывает 80% сценариев личного использования и экспериментов с агентами. LM Studio подключайте отдельно, когда нужен визуальный интерфейс или быстрый RAG по документам без написания кода. vLLM рассматривайте только при реальном росте до продакшн-нагрузки с множеством пользователей. А к llama.cpp напрямую возвращайтесь, когда упрётесь в конкретное ограничение железа, которое обёртки решить не могут.
FAQ
Ollama и LM Studio делают одно и то же?
Почти. Оба используют GGUF-модели и совместимы с OpenAI API, но Ollama сильнее в CLI и экосистеме MCP-агентов, а LM Studio — в визуальном интерфейсе и встроенном RAG без написания кода.
Можно ли запустить vLLM на обычном ноутбуке?
Технически да, но смысла немного. vLLM создан под нагрузку с множеством одновременных пользователей, и его настройка сложнее, чем у Ollama или LM Studio, ради выгоды, которая проявляется только при реальном масштабе.
Нужно ли программисту знать llama.cpp, если он использует Ollama?
Нет, для повседневной работы это не обязательно. Ollama прячет детали сборки и квантизации. Знание llama.cpp пригодится, только если понадобится кастомная сборка под нестандартное железо.
Какой инструмент дешевле в использовании?
Все четыре бесплатны и open source, платить придётся только за электричество и, в случае vLLM, за серверную инфраструктуру под нагрузку.
С чего начать новичку без опыта в разработке?
С LM Studio: интерфейс не требует терминала, модели скачиваются кликом, а встроенный RAG сразу позволяет загрузить документы и получить ответы по ним.
Правда ли, что разница между локальными и платными моделями небольшая?
По состоянию на 2026 год разница между топовыми платными моделями и качественными open-source моделями заметна, но перестала быть катастрофической для многих практических задач вроде извлечения данных или написания несложного кода.
Можно ли использовать несколько инструментов одновременно на одной машине?
Да, это обычная практика: Ollama для CLI-задач и агентов, LM Studio для визуальной работы с документами, они не конфликтуют друг с другом.
Если сомневаетесь, какой инструмент закрывает именно вашу задачу, лучше свериться с полным каталогом AI-инструментов на портале: каталог AI-инструментов, или разобрать сценарий лично — запишитесь на консультацию к Максиму.
Обновлено: октябрь 2026.