
Оживить фото нейросетью сегодня можно за пять минут: загружаешь одну картинку, пишешь пару строк промта и получаешь готовый видеоролик с движением камеры или анимацией объекта. Технология называется image to video, работает на диффузионных моделях вроде Veo, Kling и Hailuo, и в 2026 году доступна бесплатно почти в каждом крупном AI-сервисе. Ниже разберем, как это устроено внутри, какие нейросети реально справляются с задачей и где технология еще спотыкается.
Оживить фото нейросетью реально бесплатно уже сегодня, но результат зависит от модели и качества исходника. Лучше всего с задачей справляются Veo 3.1 в Google AI Studio, Kling AI и Hailuo 2.3 от MiniMax. Ниже — сравнение восьми сервисов, цены на сентябрь 2026 года и пошаговая инструкция для новичка.
Как работает нейросеть для генерации видео из фото?
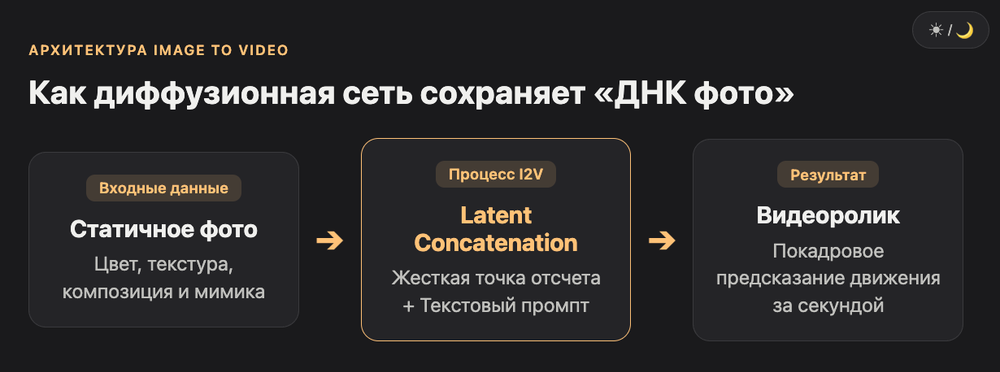
Модель превращает загруженную фотографию в первый кадр будущего видео, а дальше диффузионная сеть достраивает движение по текстовому промту, покадрово предсказывая, как должна измениться сцена.
Технически это называется image latent concatenation: нейросеть берет визуальные данные фото, цвет, текстуру, композицию, и встраивает их в процесс генерации видео как жесткую точку отсчета. Из-за этого готовый ролик не превращается в случайную анимацию, а остается продолжением исходной картинки.
Разработчики Hunyuan Video I2V от Tencent описывают процесс похоже: модель сохраняет "визуальную ДНК" фото и достраивает вокруг нее движение, освещение и мимику. Если фото статичное и на нем есть лицо, сеть в первую очередь анимирует моргание, легкий поворот головы и мимику, потому что именно на этих паттернах модели обучали больше всего. С фоном и объектами на заднем плане ситуация сложнее: там чаще случаются искажения.
Для новичка это работает так же просто, как фильтр в редакторе фото, только вместо статичного эффекта нейросеть додумывает целую секунду за секундой картину движения, опираясь на миллионы видео, на которых она обучалась.
Зачем оживлять фото нейросетью в 2026 году?
Анимация фотографии нейросетью решает три задачи: реклама и контент для соцсетей, оживление старых семейных снимков и быстрые прототипы видео без съемки и монтажной команды.
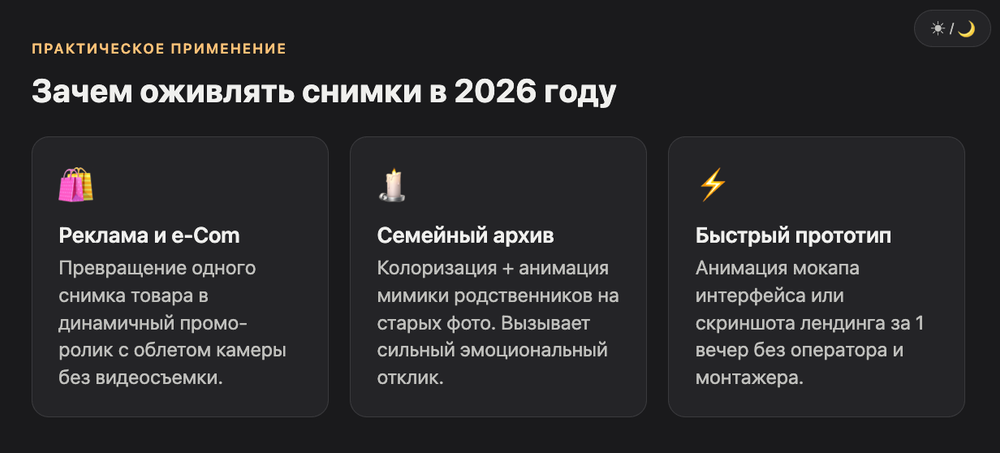
Маркетологи используют image to video для карточек товара: один продуктовый снимок превращается в ролик с движением камеры за 500-2000 кредитов сервиса, и клиенту не нужно заказывать съемку. Это уже рабочий формат для соцсетей и маркетплейсов.
Отдельная категория запросов — оживление старых черно-белых фотографий: сначала снимок красят через нейросети вроде palet.fm, а затем анимируют мимику родственников на фото через image to video. Получается короткое видео, где человек с архивного снимка моргает и улыбается, и это стабильно набирает просмотры в соцсетях именно из-за эмоционального эффекта.
Третий сценарий, актуальный для наших читателей, это быстрый прототип. Если у вас есть готовый мокап интерфейса, скриншот лендинга или иллюстрация продукта, image to video позволяет собрать динамичный тизер за один вечер, без оператора и без монтажера.
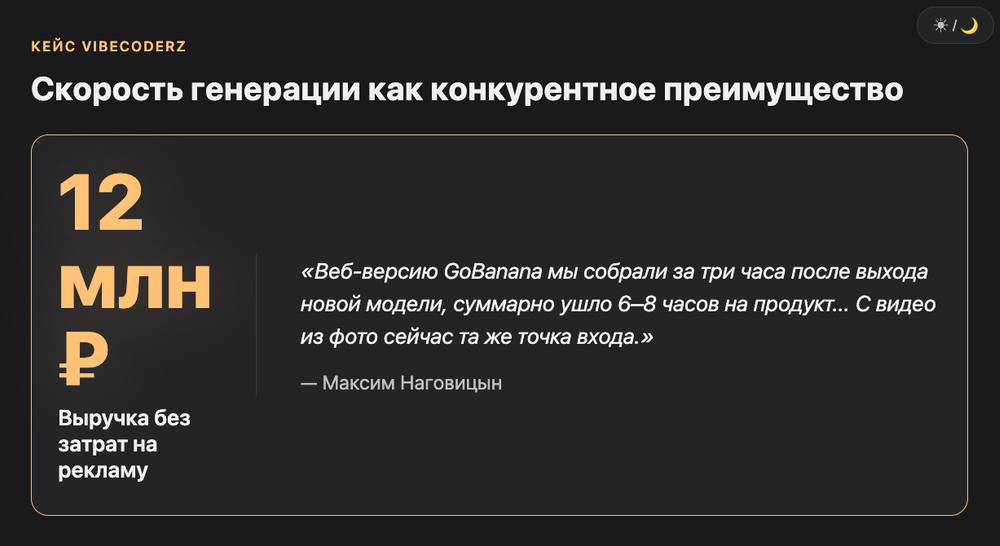
Максим: «Веб-версию GoBanana мы собрали за три часа после выхода новой модели, суммарно ушло 6-8 часов на продукт, который принес 12 миллионов рублей без рубля рекламы. С видео из фото сейчас та же точка входа, что была с фотогенерацией полтора года назад. Кто сейчас разберется с промптами для движения камеры, тот соберет свой сервис первым.»
Какие сервисы лучше всего превращают фото в видео?
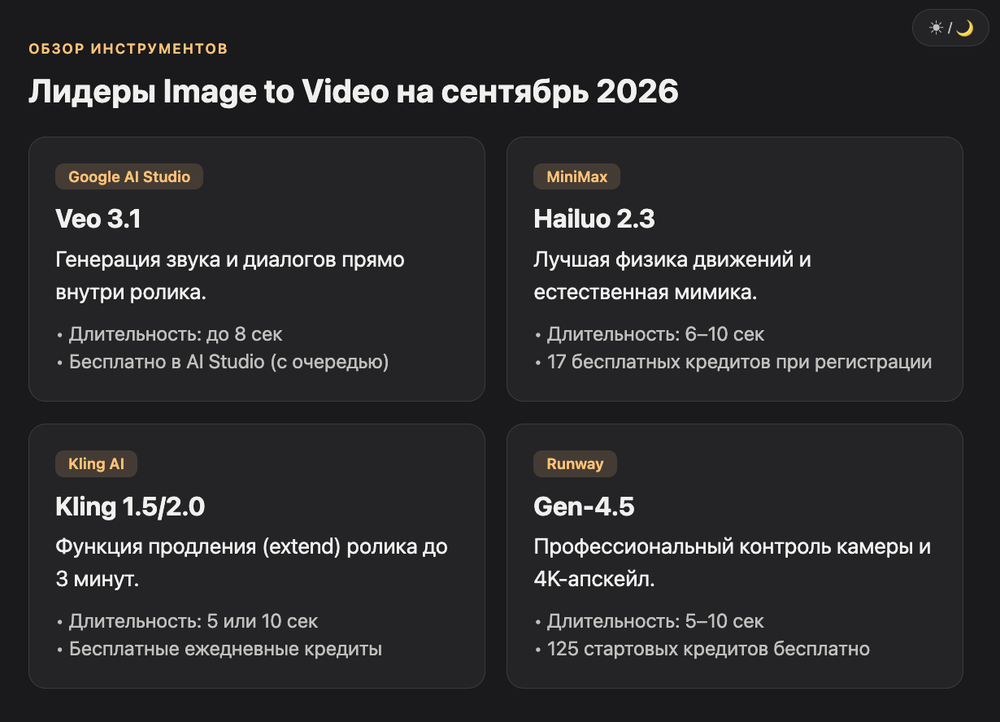
Для бесплатного старта лучше всего подходят Google AI Studio с Veo, Grok Imagine и Qwen. Для профессионального результата с управлением камерой — Kling AI, Runway Gen-4.5 и Hailuo 2.3 от MiniMax.
По итогам сравнения восьми сервисов лучшую физику движения показывает Hailuo 2.3 от MiniMax, а самый гибкий контроль камеры дает связка Runway Gen-4.5 и открытая модель LTX-2. Google Veo 3.1 выигрывает по встроенному звуку: он генерирует реплики персонажей и фоновые шумы прямо внутри ролика, без отдельной озвучки.
| Сервис | Что умеет | Длительность | Бесплатный тариф |
|---|---|---|---|
| Veo 3.1 (Google AI Studio) | Фото в видео, встроенный звук и диалоги | до 8 секунд | Да, с лимитом очереди |
| Kling AI | Фото в видео, продление ролика до 3 минут | 5 или 10 секунд | Да, ограниченные кредиты |
| Runway Gen-4.5 | Только image to video, апскейл до 4K | 5 или 10 секунд | 125 кредитов разово |
| Hailuo 2.3 (MiniMax) | Реалистичная физика и мимика | 6-10 секунд | 17 кредитов при регистрации |
| Qwen (Wan) | Фото в видео на русском промте | до 5 секунд | 5 генераций в сутки, без вотемарки |
| Grok Imagine | Фото в видео, перевод промта не нужен | до 6 секунд | Да, с очередью |
| LTX-2 | Открытая модель, гибкое управление камерой | до 5 секунд | Бесплатно, но нужна своя видеокарта |
| Hunyuan Video I2V | Открытая модель, сохранение мимики | до 5 секунд | Бесплатно, нужно 60+ ГБ видеопамяти |
Полный каталог таких инструментов и десятки других AI-сервисов собраны в каталоге AI-инструментов VibeCoderz, там же можно сравнить их по категориям.
Чем платные сервисы отличаются от бесплатных open source моделей?
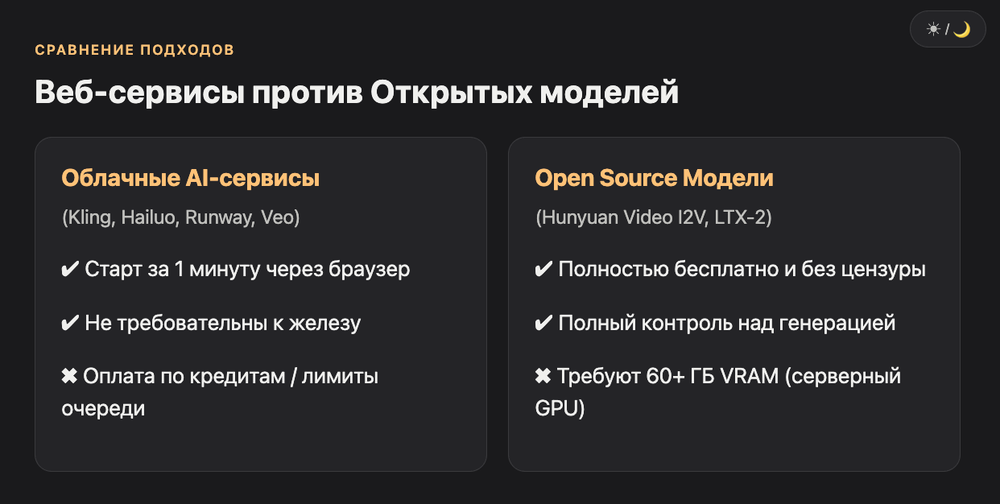
Открытые модели вроде LTX-2 и Hunyuan Video I2V бесплатны в прямом смысле, но требуют мощную видеокарту: Hunyuan официально просит минимум 60 ГБ видеопамяти для разрешения 720p, и это уровень серверной карты, а не домашнего компьютера. Для новичка проще арендовать облачный GPU или воспользоваться готовым веб-интерфейсом вроде Kling или Hailuo, где вся вычислительная часть уже настроена за вас.
Сколько стоит анимация фотографии нейросетью на сентябрь 2026 года?
Цены на image to video держатся в диапазоне от бесплатного тарифа до 180 долларов в месяц. Дешевле всего генерировать через Runway API за счет оплаты по секундам, дороже всего — топовые тарифы Kling с большим запасом кредитов.
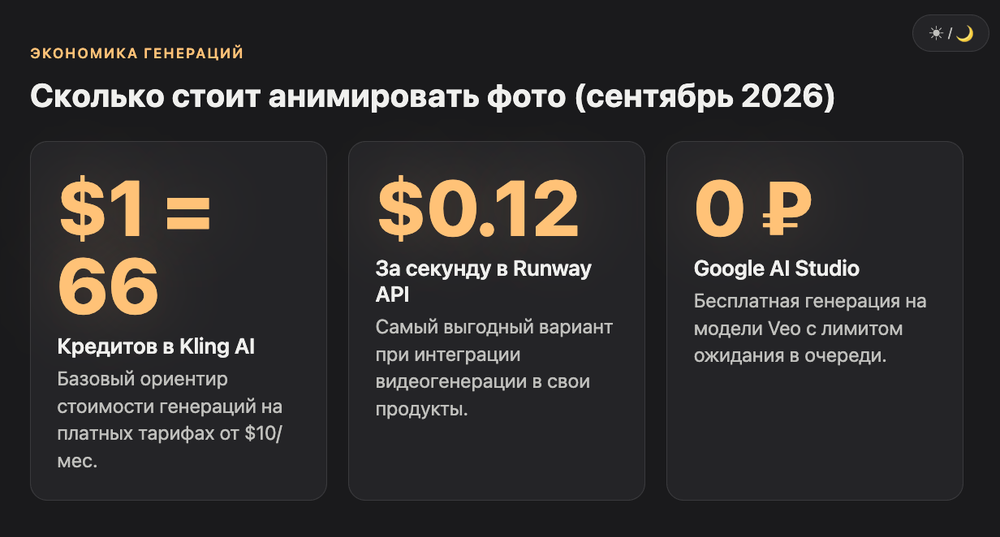
Kling AI на сентябрь 2026 года предлагает тарифы Standard от 10 долларов до Ultra за 180 долларов в месяц, а стандартный ориентир кредитов, по официальной политике сервиса, составляет 1 доллар за 66 кредитов.У Runway цены завязаны на секунды: Gen-4.5 в приложении стоит 12 кредитов за секунду, а через API — 0,12 доллара за секунду сгенерированного видео.
| Сервис | Стартовый тариф | Топовый тариф | Особенность оплаты |
|---|---|---|---|
| Kling AI | $10/мес (Standard) | $180/мес (Ultra) | Кредиты, 1$ = 66 кредитов |
| Runway | Бесплатно, 125 кредитов | $76/мес (Unlimited) | Оплата по секундам в API |
| Hailuo (MiniMax) | Бесплатные кредиты при регистрации | ~$20/мес | Кредиты за генерацию, 15-80 за ролик |
| Google Veo 3.1 | Бесплатно в AI Studio с лимитом | Подписка Gemini/AI Ultra | Очередь на бесплатном тарифе |
Российской картой оплатить большинство этих сервисов напрямую нельзя: Visa и Mastercard российских банков не работают для международных платежей после приостановки операций этих систем в России. На практике вайбкодеры оплачивают такие подписки через посреднические сервисы или виртуальные карты, но это отдельная тема для консультации.
Как оживить фото нейросетью бесплатно за 10 минут?
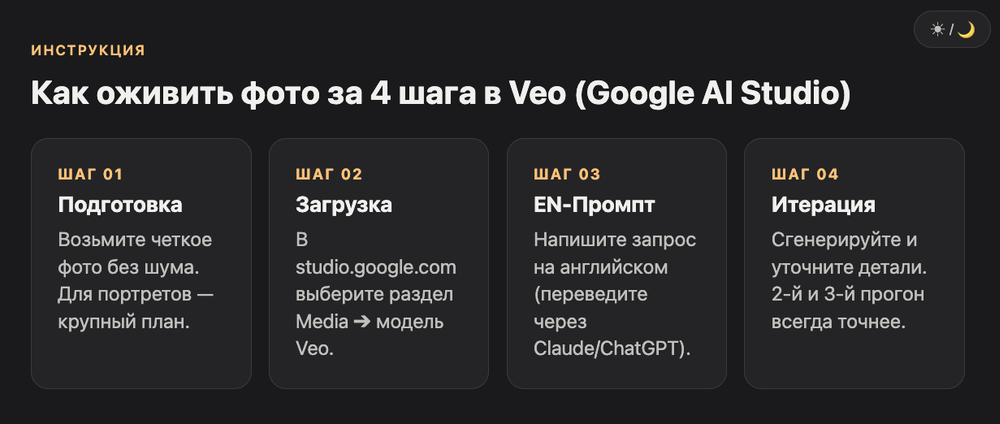
Проще всего начать с Google AI Studio: там есть бесплатный доступ к Veo без подписки, единственное неудобство — периодическая очередь на генерацию.
Один прогон занимает от одной до трех минут, и в бесплатном тарифе иногда нужно нажать кнопку запуска повторно из-за лимита очереди, это нормальное поведение сервиса, а не ошибка. Если хочется избежать ожидания совсем, платная подписка снимает это ограничение.
Шаг 1. Подготовьте фото
Возьмите фото в хорошем разрешении, желательно без сильного шума и с четким объектом в кадре. Для портретов лучше всего работают снимки в полный рост или крупный план лица, для товаров — фото на нейтральном фоне.
Шаг 2. Зайдите в AI Studio и выберите Veo
Откройте studio.google.com, в левом меню выберите генерацию медиа, затем модель Veo. Загрузите фотографию и опишите словами, что должно происходить в кадре: движение камеры, действие персонажа, погоду или свет.
Шаг 3. Напишите промт на английском
Нейросети заметно лучше понимают промты на английском языке. Если не уверены в формулировке, попросите ChatGPT или Claude перевести и детализировать запрос: указать конкретное действие персонажа, а не общую фразу вроде "оживи фото".
Шаг 4. Сгенерируйте и доработайте
После первой генерации можно уточнить промт и попросить добавить деталь, например конкретный объект в кадре или другую эмоцию у персонажа. Второй и третий прогон обычно точнее первого, потому что вы уже видите, как модель интерпретирует формулировки.
Как управлять движением камеры в видео из фото?
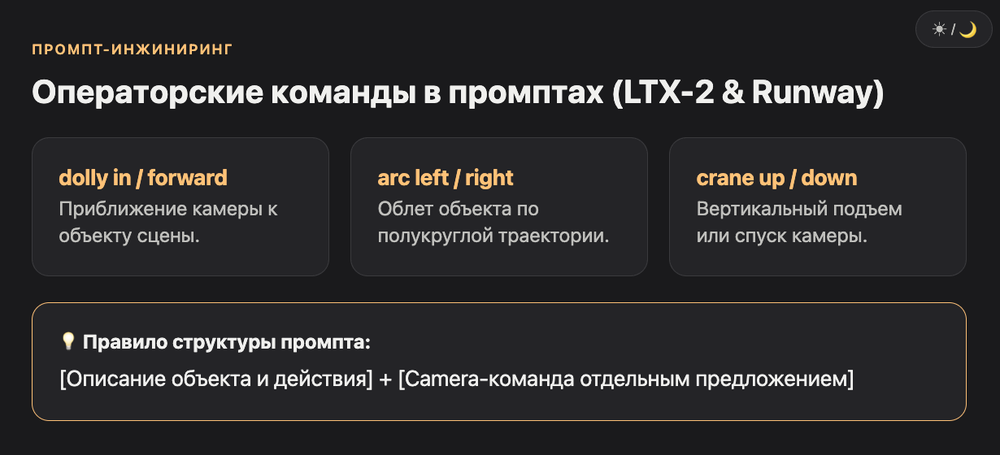
Движение камеры задается отдельными словами в промте: dolly in и dolly out для приближения и отдаления, arc left и arc right для облета сцены, crane up для подъема камеры.
У модели LTX-2 набор ключевых слов камеры работает почти как у оператора-постановщика: конкретное слово в промте однозначно определяет траекторию, а без него камера просто медленно наезжает на объект по умолчанию. Формулировка вроде "быстрый зум" при этом игнорируется моделью и заменяется на стандартный медленный наезд.
| Термин в промте | Что делает камера |
|---|---|
| dolly in / dolly forward | Камера приближается к объекту |
| dolly out / dolly backward | Камера отдаляется от объекта |
| arc left / arc right | Камера облетает сцену по дуге |
| crane up | Камера поднимается снизу вверх |
| static / handheld | Камера почти неподвижна, легкое дрожание для живости |
Порядок слов в промте тоже важен: сначала стоит описать субъект и его действие, а camera-инструкцию добавлять отдельным предложением после этого. Модели вроде LTX-2 читают промт как режиссерский сценарий, а не как список тегов, поэтому чем ближе формулировка к обычному описанию сцены, тем точнее результат.
Какие есть честные ограничения у image to video в 2026 году?
Технология еще далека от идеала: мелкий текст на объектах искажается, второстепенные детали фона плывут, а сложные многофигурные сцены модели путают чаще, чем одиночный портрет.
В тестах на продуктовых фото мелкий текст на этикетке искажался почти в половине генераций, а движения вроде пузырьков в воде или дыма модели воспроизводят неестественно, потому что физика жидкостей и газов дается диффузионным моделям сложнее движения твердых объектов. Это не брак конкретного сервиса, а общее слабое место технологии на сентябрь 2026 года.
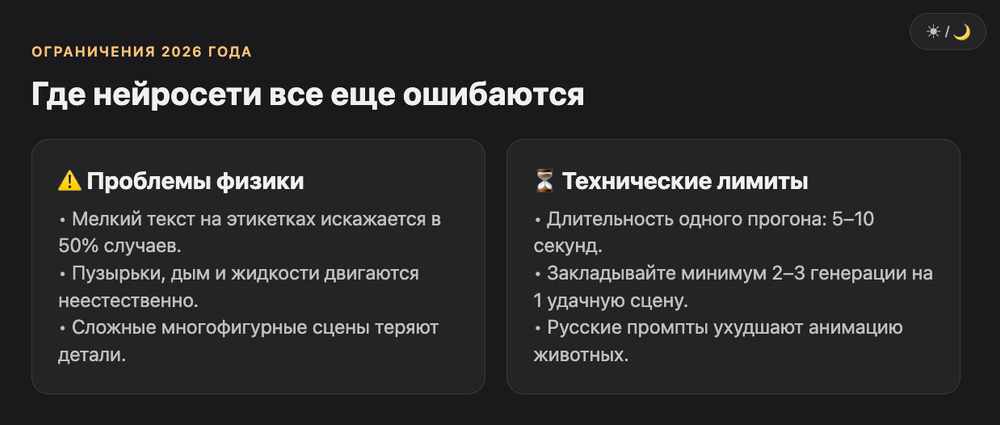
Есть и практические ограничения:
- Бесплатные тарифы почти everywhere ограничены очередью или количеством генераций в сутки.
- Длительность ролика на большинстве сервисов ограничена 5-10 секундами, для более длинного видео нужна функция продления.
- Открытые модели типа Hunyuan Video I2V требуют мощного железа и недоступны без облачного GPU.
- Животные и нестандартные звуки, например мяуканье кота, модели воспроизводят с ошибками при русском промте и заметно точнее при английском.
Честная оговорка: если вам нужен результат для клиента прямо сейчас, закладывайте минимум две-три попытки генерации на каждую сцену. С первого раза устраивающий вас результат получается редко, и это касается всех сервисов из таблицы выше, включая платные.
Кому подходит анимация фотографии нейросетью?
Технология подходит маркетологам для карточек товара, контент-мейкерам для соцсетей и всем, кто хочет оживить архивные фото близких. Для профессионального видеопроизводства с точным сюжетом инструмент пока слабоват.
Для маркетолога, которому нужен короткий ролик для рекламы в соцсетях, любой сервис из таблицы дает применимый результат за один вечер работы. Для видеопродакшена с точной хореографией сцены и множеством персонажей image to video пока остается вспомогательным инструментом, а не заменой полноценной съемки.
Если вы ведете Telegram-канал или соцсети бизнеса, такие ролики хорошо заходят как отдельный формат контента: не рекламный, а эмоциональный. Именно поэтому у создателей роликов "оживить старое фото" стабильно высокая досматриваемость, люди останавливаются на движении там, где мимо статичной фотографии просто пролистали бы.
Итог: какую нейросеть выбрать чтобы оживить фото
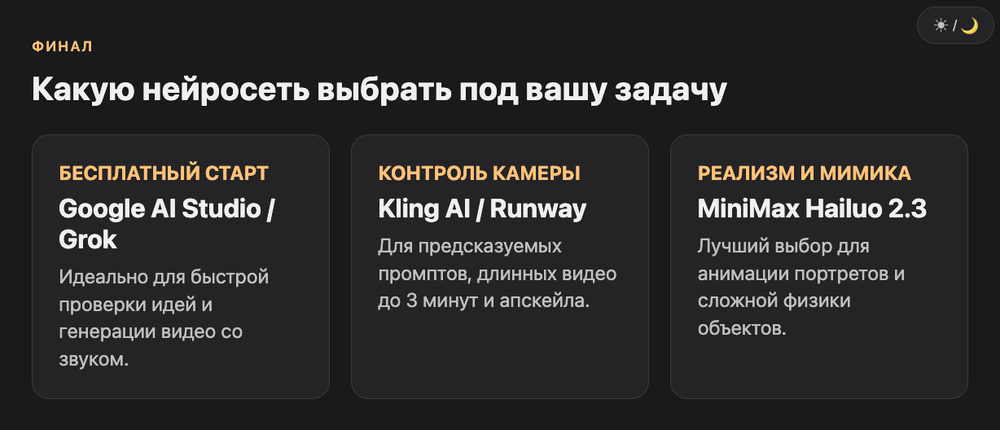
Для быстрого бесплатного теста берите Google AI Studio с Veo или Grok Imagine, для стабильно точного результата с управлением камерой присмотритесь к Kling AI или Runway Gen-4.5, а если нужна лучшая физика движения и мимика, MiniMax Hailuo 2.3 сейчас справляется с этим сильнее конкурентов. Для собственного мини-сервиса на базе таких моделей вайбкодеры чаще всего собирают обертку через Cursor или Claude Code, это отдельная тема, которую можно обсудить на консультации с Максимом.
Глоссарий
Image to video (I2V) — технология, которая превращает одну фотографию в короткое видео, достраивая движение вокруг исходного кадра.
Диффузионная модель — тип нейросети, который генерирует изображение или видео постепенно, шаг за шагом убирая "шум" из случайных данных, пока не получится итоговая картинка.
Промт — текстовое описание того, что должно происходить в видео: действие персонажа, движение камеры, настроение сцены.
Кредиты — внутренняя валюта AI-сервисов, которой оплачивается каждая генерация, обычно чем выше качество и длительность видео, тем больше кредитов уходит.
Апскейл — увеличение разрешения готового видео, например с 720p до 4K, через отдельный инструмент внутри сервиса.
Соотношение сторон (aspect ratio) — формат кадра видео, горизонтальный 16:9 для десктопа и вертикальный 9:16 для сторис и рилсов.
Частые вопросы про оживление фото нейросетью
Можно ли оживить фото нейросетью бесплатно? Да, у Google AI Studio, Grok Imagine и Qwen есть бесплатный доступ к image to video. Ограничение обычно в очереди на генерацию или количестве попыток в сутки, а не в самой функции.
Какая нейросеть лучше всего оживляет старые фотографии? Для архивных черно-белых снимков сначала стоит раскрасить фото через сервис вроде palet.fm, а затем анимировать через Kling или Hailuo. Раздельный процесс дает точнее результат, чем попытка сделать все за один шаг.
Почему нейросеть искажает лицо на видео из фото? Чаще всего проблема в качестве исходного фото: размытость, неудачный ракурс или слишком мелкое лицо в кадре. Чем четче и крупнее лицо на исходнике, тем стабильнее модель сохраняет черты при анимации.
Нужно ли писать промт на английском языке? Не обязательно, но результат заметно точнее. Большинство моделей обучены преимущественно на английских описаниях, поэтому даже простой перевод через ChatGPT или Claude ощутимо повышает качество генерации.
Сколько по времени занимает генерация одного видео из фото? От 30 секунд до трех минут в зависимости от сервиса и загруженности очереди. В бесплатных тарифах в часы пик время ожидания может увеличиваться из-за лимита одновременных запросов.
Можно ли сделать видео длиннее 10 секунд из одного фото? Напрямую нет, большинство моделей ограничены 5-10 секундами за одну генерацию. Kling AI и некоторые другие сервисы позволяют продлевать готовый ролик через отдельную функцию extend, доводя итоговую длительность примерно до трех минут.
Работает ли оживление фото нейросетью с животными? Работает, но менее стабильно, чем с людьми: модели чаще путают звуки и мимику животных при русском промте. Перевод запроса на английский заметно повышает точность результата.
Если хотите не просто оживить одно фото, а собрать на этих моделях полноценный продукт с интерфейсом и оплатой, посмотрите каталог AI-инструментов на VibeCoderz или запишитесь на консультацию к Максиму, чтобы обсудить конкретный сценарий.