
Поиск по PDF с AI собирается из трех шагов: документ режется на куски текста, для каждого куска считается embedding, а потом любая LLM отвечает на вопрос по найденному контексту. Все это реально закрыть за один вечер, без Langchain и без тяжелого RAG-фреймворка, если писать код построчно самому. Ниже разберем, как загрузить PDF, экспорт из Notion или Markdown-заметки, посчитать embeddings через OpenAI API и подключить бота, который честно скажет "в документах об этом нет", если ответа не нашлось.
Собрать бота, который ищет ответы по вашим PDF, Notion-заметкам или Markdown-файлам, можно за вечер: pypdf читает файлы, text-embedding-3-small считает embeddings за $0.02 за миллион токенов, ChromaDB хранит векторы, а любая бюджетная модель через OpenRouter пишет ответ. Внутри: код целиком, разбор частых ошибок и таблица цен на 2026 год.
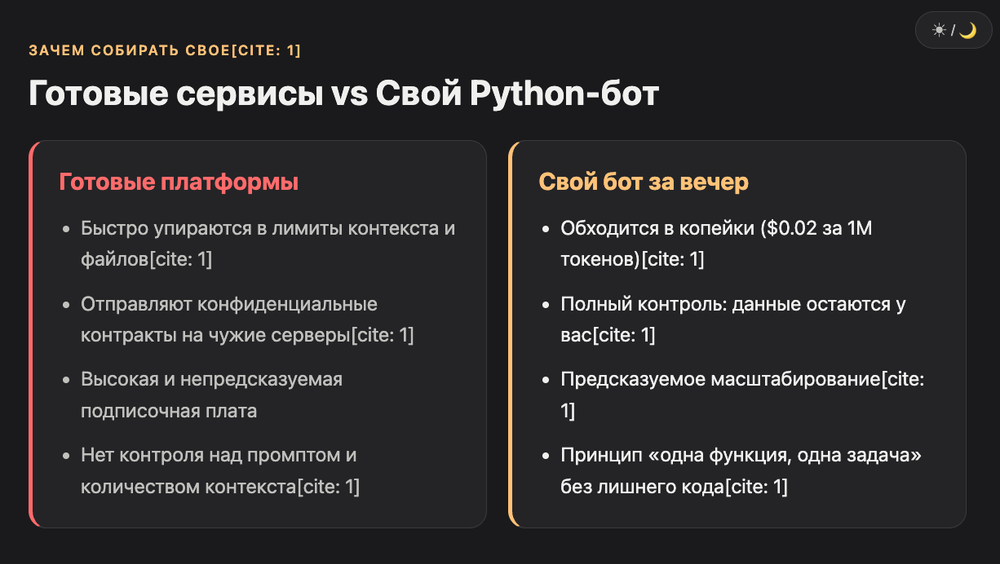
Зачем собирать поиск по документам, если есть готовые сервисы?
Готовые сервисы с загрузкой файлов быстро упираются в лимит документов и контекста, а свой поиск обходится в копейки и не отправляет ваши контракты на чужой сервер.
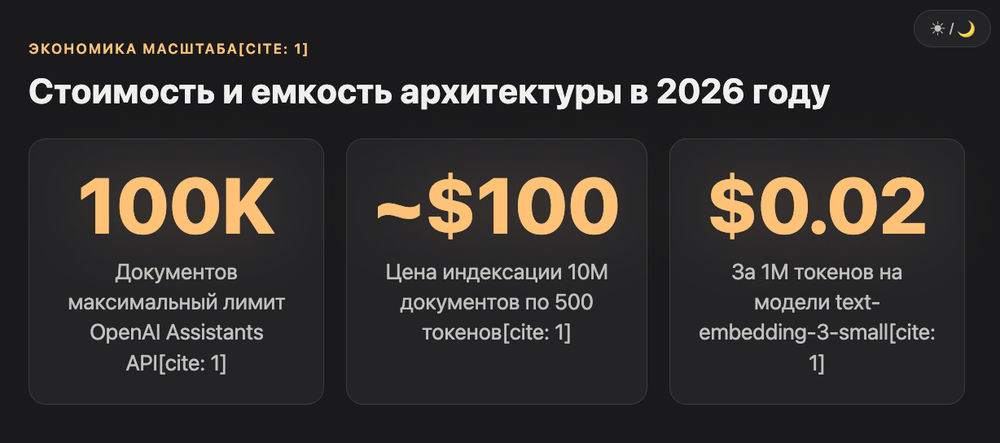
OpenAI Assistants API позволяет загрузить до 100 000 документов на одного ассистента, но при росте базы качество поиска в этой куче начинает проседать. Индексация 10 миллионов документов по 500 токенов каждый через text-embedding-3-small стоит около $100. Свой пайплайн масштабируется предсказуемо, а данные остаются у вас.
Для юриста, который хочет искать по договорам, или для вайбкодера, который собирает базу знаний из заметок в Notion, свой бот решает конкретную задачу без лишней инфраструктуры. Плюс появляется контроль: сами решаете, сколько кусков текста показывать модели и как формулировать промпт. Это тот самый принцип "одна функция, одна задача", о котором в VibeCoderz говорят применительно к любому микропродукту.
Как работает embeddings поиск по документам простыми словами?
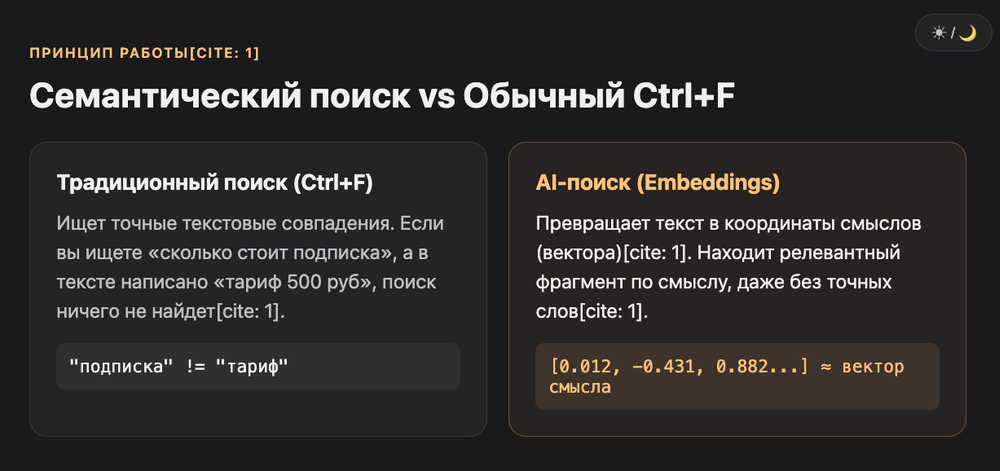
Embedding превращает кусок текста в список чисел, вектор, а похожие по смыслу тексты получают похожие вектора. Вопрос тоже превращается в вектор, и система находит ближайшие по смыслу куски.
Представьте библиотеку, где каждая книга получает координаты на карте по смыслу, а не по алфавиту. Книги про кулинарию окажутся рядом друг с другом, а не рядом с учебником по электрике. Вопрос "как испечь хлеб" превращается в точку на этой же карте, и система просто находит ближайшие книги.
Технически это называется семантический поиск (semantic search): вместо совпадения слов система ищет совпадение смысла. Поэтому вопрос "сколько стоит подписка" найдет кусок текста со словом "тариф", даже если слово "стоит" там не встречается буквально. В этом разница между обычным поиском по Ctrl+F и AI-поиском по документам.
Что понадобится для сборки бота за вечер?
Минимальный стек: библиотека для чтения файлов, функция для нарезки текста на куски, API для embeddings, векторная база и любая LLM для финального ответа.
Для вечернего пет-проекта не нужен ни Langchain, ни оркестратор агентов. Пять компонентов покрывают весь путь от файла до ответа, и каждый можно поставить одной командой pip install. Ниже таблица с тем, что реально стоит взять для старта, без переусложнения.
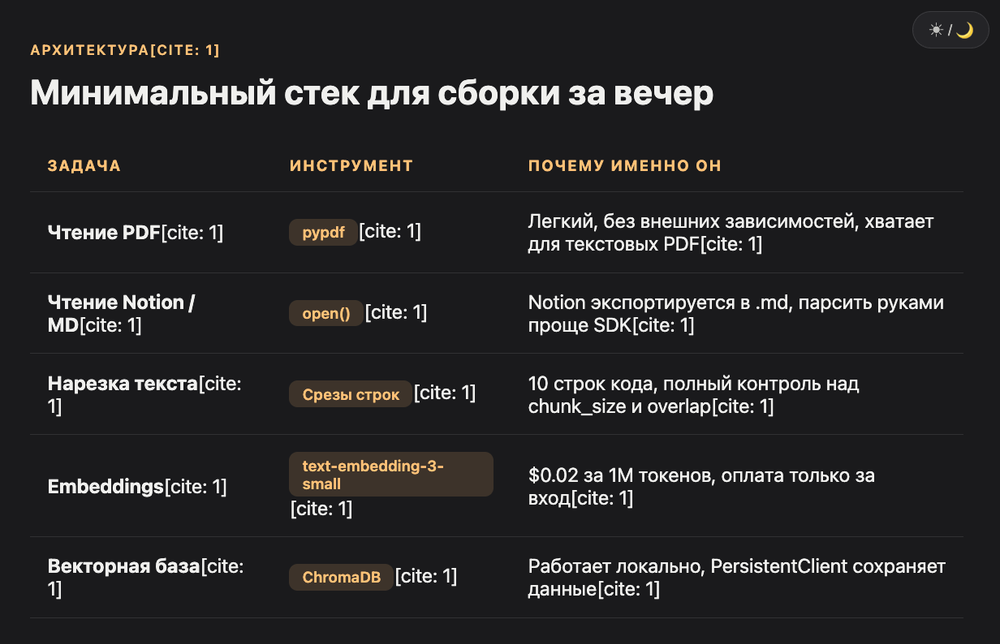
| Задача | Инструмент | Почему именно он |
|---|---|---|
| Чтение PDF | pypdf | Легкий, без внешних зависимостей, хватает для текстовых PDF |
| Чтение Notion/Markdown | обычный open() файла | Notion экспортируется в .md, парсить руками проще, чем тащить SDK |
| Нарезка на чанки | свой цикл на срезах строки | 10 строк кода, полный контроль над chunk_size и overlap |
| Embeddings | OpenAI text-embedding-3-small | $0.02 за миллион токенов, только входные токены, без вывода |
| Векторная база | ChromaDB | Работает локально, PersistentClient сохраняет данные между запусками |
Такой стек не тянет за собой оркестрацию агентов и цепочки промптов, поэтому дебажить проще: каждая функция делает одну вещь и ее легко протестировать отдельно. Если пишете этот код в Cursor или через Claude Code, можно попросить модель сразу сгенерировать заготовку по этой структуре, а руками только докрутить промпт под свои документы.
Шаг 1. Как подготовить PDF, Notion и Markdown для загрузки?
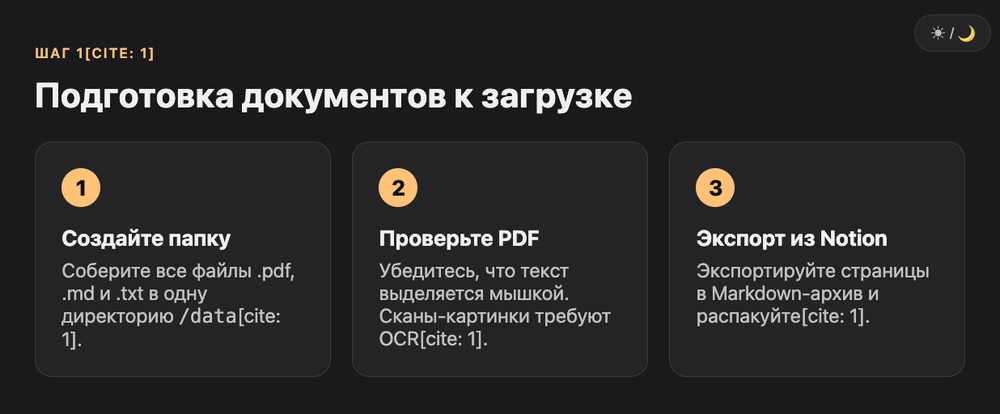
Соберите все файлы в одну папку data, экспортируйте Notion-страницы в Markdown через встроенный экспорт, а PDF проверьте на то, что текст в них не картинка.
Если PDF отсканирован как изображение, pypdf вернет пустую строку вместо текста, и это самая частая причина, почему бот "не видит" документ. Проверить легко: откройте файл и попробуйте выделить текст мышкой. Если выделяется, все в порядке, если нет, нужен OCR, а это уже отдельная задача.
Notion экспортируется в Markdown через кнопку "Export" в настройках страницы, архив распаковывается в обычные .md файлы. Их можно читать тем же кодом, что и .txt, никакого специального парсера не нужно. Из практики авторов YouTube-туториалов по RAG: если у вас много мелких PDF на несколько страниц каждый, есть смысл объединить их в один файл перед загрузкой, это сокращает количество отдельных документов и упрощает нарезку на чанки.
from pathlib import Path
from pypdf import PdfReader

def load_pdf(path: str) -> str:
    reader = PdfReader(path)
    return "\n".join(page.extract_text() or "" for page in reader.pages)

def load_text_file(path: str) -> str:
    return Path(path).read_text(encoding="utf-8")

def load_document(path: str) -> str:
    if path.endswith(".pdf"):
        return load_pdf(path)
    return load_text_file(path)
Шаг 2. Как посчитать embeddings и сохранить их в базу?
Текст режется на куски по 800 символов с нахлестом в 100 символов, каждому куску присваивается уникальный ID, и только новые ID отправляются на пересчет embeddings.
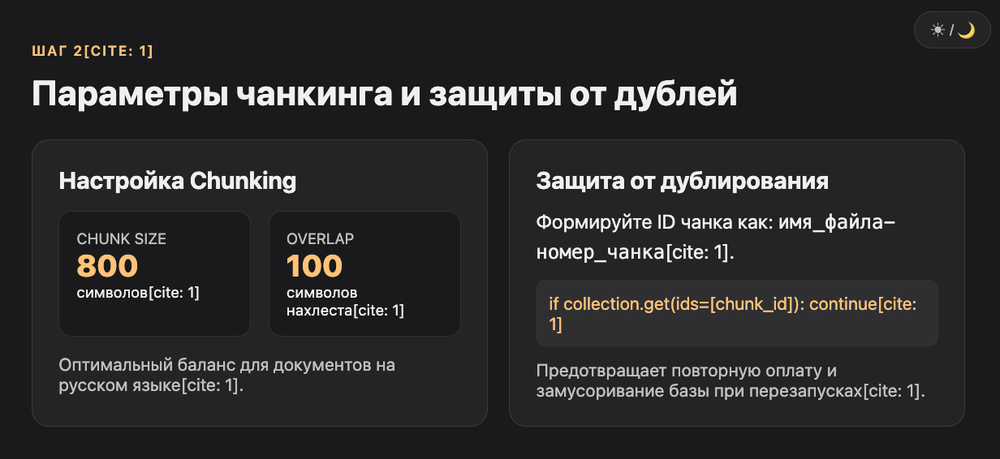
Уникальный ID вида "имя_файла-номер_чанка" критически важен: без него при повторном запуске скрипта вы задублируете весь текст в базе. Это ровно та ошибка, на которую натыкается большинство новичков в первом же RAG-туториале, судя по разбору популярных видео на эту тему. Chunk_size в 800 символов и overlap в 100 хорошо работают для документов на русском языке, если куски выходят рублеными по смыслу, увеличьте overlap до 150-200.
import os
import chromadb
from openai import OpenAI

client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])
chroma_client = chromadb.PersistentClient(path="./chroma_db")
collection = chroma_client.get_or_create_collection("my_docs")

def chunk_text(text: str, chunk_size: int = 800, overlap: int = 100) -> list[str]:
    chunks = []
    start = 0
    while start < len(text):
        end = start + chunk_size
        chunks.append(text[start:end])
        start = end - overlap
    return chunks

def embed(text: str) -> list[float]:
    response = client.embeddings.create(model="text-embedding-3-small", input=text)
    return response.data[0].embedding

def index_document(path: str) -> None:
    text = load_document(path)
    chunks = chunk_text(text)
    for i, chunk in enumerate(chunks):
        chunk_id = f"{Path(path).stem}-{i}"
        if collection.get(ids=[chunk_id])["ids"]:
            continue
        collection.add(ids=[chunk_id], embeddings=[embed(chunk)], documents=[chunk])
Запустите index_document для каждого файла из папки data, и через пару минут у вас будет полностью проиндексированная база. На 300-страничном PDF это займет секунд 30-40, зависит от скорости API.
Шаг 3. Как подключить бота, который отвечает по документам?
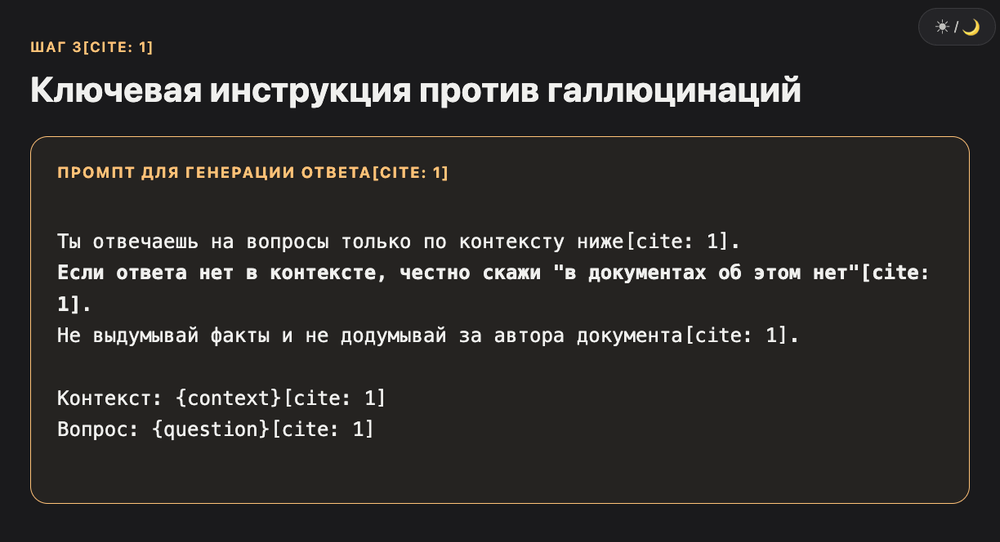
Вопрос пользователя превращается в embedding, находится 5 ближайших кусков текста, они вставляются в промпт вместе с вопросом, а модель генерирует ответ строго по контексту.
Ключевая часть промпта, ломающая галлюцинации: прямая инструкция отвечать "в документах об этом нет", если контекст не содержит ответа. Без нее модель охотно придумывает правдоподобные, но неверные факты, особенно на узкоспециализированных документах.
import requests

def ask(question: str, k: int = 5) -> str:
    q_embedding = embed(question)
    results = collection.query(query_embeddings=[q_embedding], n_results=k)
    context = "\n---\n".join(results["documents"][0])

    prompt = f"""Ты отвечаешь на вопросы только по контексту ниже.
Если ответа нет в контексте, честно скажи "в документах об этом нет".
Не выдумывай факты и не додумывай за автора документа.

Контекст:
{context}

Вопрос: {question}
Ответ:"""

    response = requests.post(
        "https://openrouter.ai/api/v1/chat/completions",
        headers={"Authorization": f"Bearer {os.environ['OPENROUTER_API_KEY']}"},
        json={"model": "deepseek/deepseek-v4-flash", "messages": [{"role": "user", "content": prompt}]},
    )
    return response.json()["choices"][0]["message"]["content"]
Этого достаточно для рабочего прототипа в консоли. Чтобы обернуть функцию ask() в Telegram-бота, хватает библиотеки aiogram и одного обработчика сообщений, который вызывает ask(text_пользователя) и отправляет результат обратно.
Максим: «Веб-версию GoBanana мы собрали за 3 часа после выхода новой модели, 6-8 часов суммарно на продукт, который принес 12 млн рублей. Ребят, это работает, если не закапываться в фреймворки, а сразу писать рабочий код.»
LlamaIndex или ручной код что выбрать для сборки?
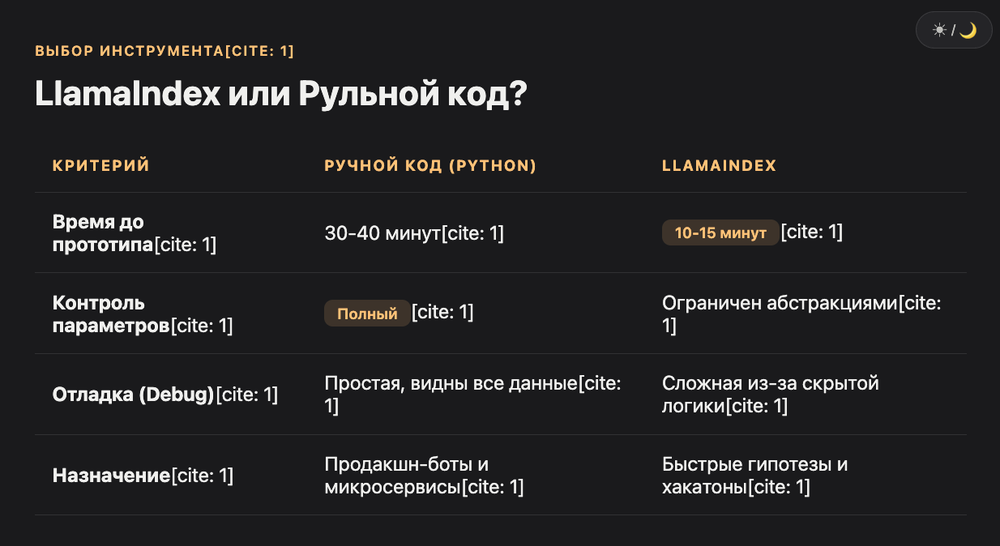
LlamaIndex закрывает тот же путь в 5 строк кода через готовые абстракции, ручной код дает полный контроль над chunk_size, ID и промптом.
LlamaIndex устанавливается через pip install llama-index и стартует буквально так: SimpleDirectoryReader читает папку data, VectorStoreIndex.from_documents строит индекс, а as_query_engine().query() отвечает на вопрос. Это быстрее для прототипа, но абстракции скрывают детали: сложнее контролировать, как именно режутся чанки и что попадает в промпт модели.
| Критерий | Ручной код | LlamaIndex |
|---|---|---|
| Время на первый рабочий прототип | 30-40 минут | 10-15 минут |
| Контроль над chunk_size и overlap | Полный | Через параметры Node Parser |
| Контроль над промптом | Полный | Нужно переопределять шаблон |
| Порог входа для новичка | Средний, нужно понимать код | Низкий, пять строк из документации |
| Подходит для | Продакшн-бота под конкретную задачу | Быстрого прототипа и экспериментов |
Для вечернего пет-проекта, где нужно быстро проверить идею, LlamaIndex экономит время. Для бота, который пойдет в продакшн под конкретную задачу клиента, ручной код проще дебажить и дешевле в поддержке, потому что вы точно знаете, что происходит на каждом шаге.
Сколько стоит поиск по документам на 2026 год?
Embeddings стоят копейки: индексация 100 000-документной базы на text-embedding-3-small обходится примерно в $2.72 за год. Основные траты приходятся на модель, которая генерирует ответы.
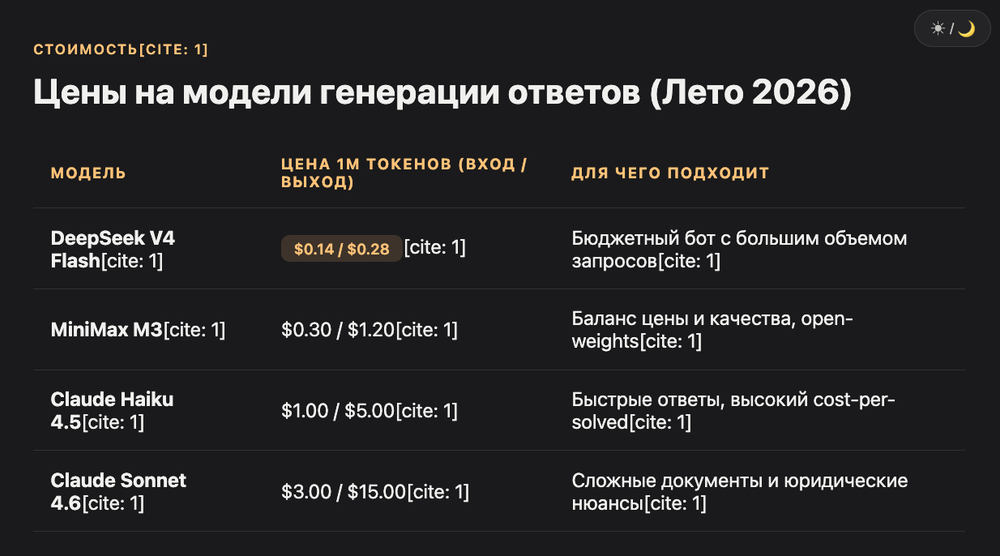
По состоянию на июнь 2026 года разброс цен на модели для генерации ответа большой, от бюджетных китайских моделей до топового Claude Fable 5. Для бота, который отвечает по личным заметкам или документам компании, переплачивать за флагман обычно не нужно, разница в качестве ответа на простые фактические вопросы почти незаметна.
| Модель | Цена за 1M токенов (вход/выход) | Для чего подходит |
|---|---|---|
| DeepSeek V4 Flash | $0.14 / $0.28 | Бюджетный бот с большим объемом запросов |
| MiniMax M3 | $0.30 / $1.20 | Баланс цены и качества, open-weights |
| Claude Haiku 4.5 | $1 / $5 | Быстрые ответы, лучший cost-per-solved-point |
| Claude Sonnet 4.6 | $3 / $15 | Сложные документы с юридическими нюансами |
Для сравнения: text-embedding-3-large стоит $0.13 за миллион токенов против $0.02 у small-версии, но на большинстве задач разница в качестве поиска не оправдывает шестикратную наценку. Batch API у OpenAI снижает стоимость embeddings еще вдвое, если не нужен ответ мгновенно.
Какие ошибки убивают качество ответов бота?
Главные причины плохих ответов: слишком большой chunk_size, отсутствие overlap между чанками и использование разных embedding-функций при индексации и при запросе.
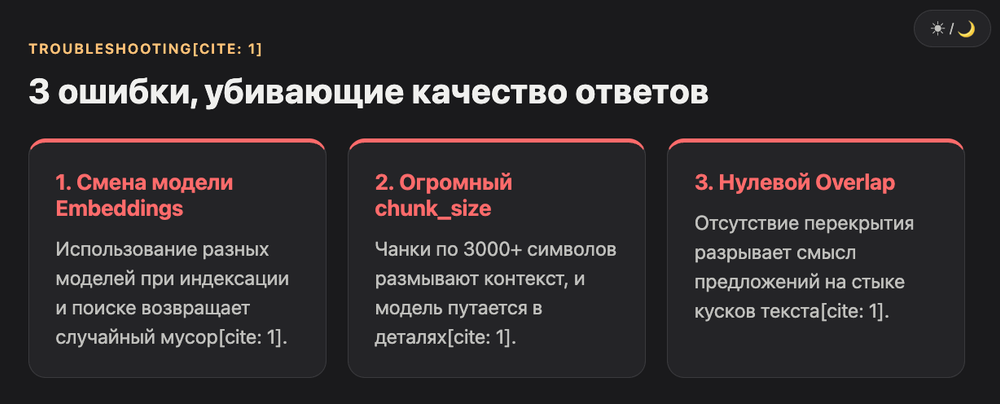
Если функция для создания embeddings при индексации и при поиске отличается хоть на модель, векторы окажутся несопоставимы и поиск начнет возвращать случайный мусор. Это одна из самых частых ошибок в первых RAG-проектах: разработчик меняет модель embeddings на середине разработки и забывает переиндексировать базу.
Вторая частая проблема: слишком крупные чанки. Если PDF режется на куски по 3000-4000 символов, в контекст попадает много лишнего текста, и модель теряется среди деталей, менее релевантных вопросу. На практике для документов на русском языке 600-900 символов на чанк с overlap 100-150 работают стабильнее всего, но это стоит проверить на своих данных.
Кому подходит такой бот и когда нужен полноценный RAG-фреймворк?
Ручной пайплайн подходит для одной конкретной задачи с понятным набором документов. Полноценный фреймворк нужен, когда документов сотни тысяч и требуется гибридный поиск, реранкинг и мультиагентные сценарии.
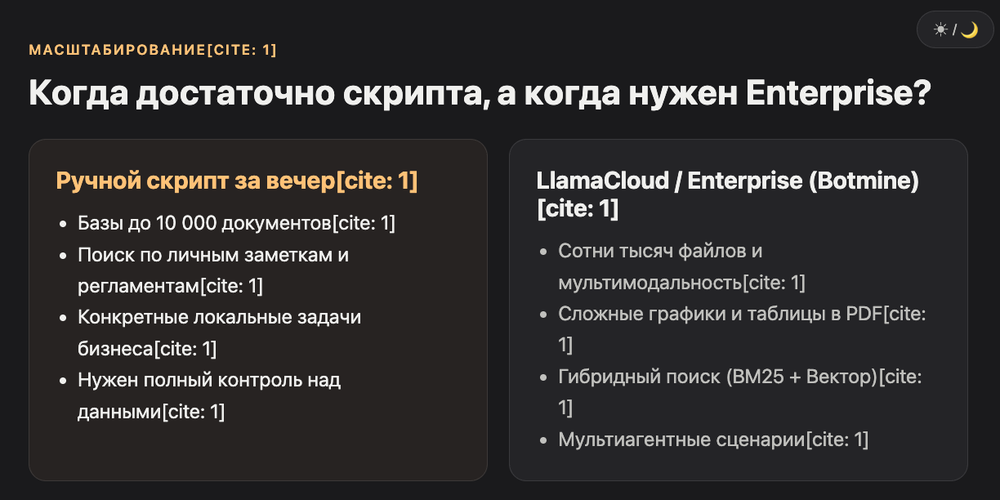
Для юриста с базой из 200 договоров, для консультанта с базой методичек или для вайбкодера, который хочет искать по собственным заметкам, описанный подход закрывает задачу полностью. Как только объем данных переваливает за десятки тысяч документов и нужна работа с изображениями внутри PDF, таблицами или гибридным поиском по ключевым словам и смыслу одновременно, стоит смотреть в сторону LlamaCloud или enterprise-платформ вроде Botmine, где эти вещи уже собраны.
Часто задаваемые вопросы
Можно ли сделать поиск по документам полностью бесплатно? Да, если использовать локальные embeddings через Ollama или Hugging Face вместо OpenAI API, а для ответов взять бесплатный тир Nemotron 3 Super через OpenRouter. Качество будет чуть ниже, но для личного проекта хватит.
Какой размер чанка выбрать для документов на русском языке? 600-900 символов с overlap 100-150 символов подходят для большинства текстов. Для юридических документов со сложными формулировками можно увеличить чанк до 1200 символов, чтобы не рвать смысл посреди пункта договора.
Нужно ли знать Python, чтобы собрать такого бота? Базовое понимание синтаксиса нужно, но весь код в статье можно вставить в Cursor или Claude Code и попросить адаптировать под свои файлы. Это и есть вайбкодинг: не пишете каждую строку с нуля, а редактируете рабочий каркас.
Чем ChromaDB отличается от Pinecone? ChromaDB работает локально и бесплатно, Pinecone это облачный сервис с оплатой за хранение векторов. Для вечернего проекта или базы до пары сотен тысяч чанков ChromaDB полностью достаточно.
Можно ли подключить такого бота в Telegram? Да, функция ask() из статьи оборачивается в один обработчик aiogram. Пользователь пишет вопрос боту в Telegram, бот вызывает ask(текст) и отправляет ответ обратно тем же сообщением.
Нужно ли пересчитывать embeddings, если документ изменился? Да, но только для измененного файла. Проверка по chunk_id из статьи не спасает от отредактированных чанков с тем же ID, поэтому при правке документа проще удалить старые чанки этого файла и проиндексировать заново.
LlamaIndex или ручной код лучше для новичка? Для первого эксперимента за вечер LlamaIndex быстрее: пять строк, и у вас уже работает поиск. Если планируете дорабатывать бота под конкретную задачу дальше, ручной код на старте сэкономит время на переучивание чужих абстракций.
Принцип из статьи легко переносится дальше: если хотите ускорить сам процесс написания кода, посмотрите полный каталог AI-инструментов VibeCoderz. Готового агента под смежную задачу, например разбор юридических документов без единой строчки кода, можно поискать в каталоге AI-агентов.
Если нужна помощь с архитектурой конкретно под ваши документы, запишитесь на консультацию к Максиму: t.me/maxnagovitsyn.