
Проблемы мультиагентных систем начинаются не с архитектуры, а с ожиданий. Команда добавляет второго, третьего, пятого агента, рассчитывая на кратный рост качества, а получает кратный рост расходов и новый класс ошибок, которых не было в системе с одним агентом. Обновлено: октябрь 2026. Ниже пять проблем, с которыми сталкивается практически каждый, кто внедряет мультиагентность впервые, и что с ними делать до того, как система уйдет в продакшен.
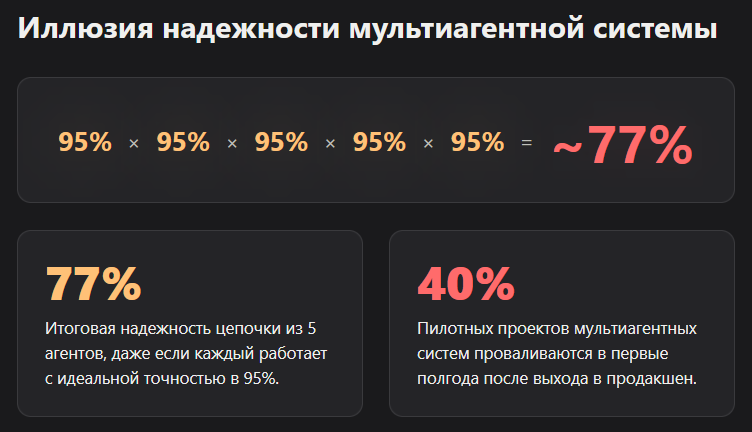
Мультиагентные системы решают задачи, недоступные одному агенту, но платят за это экспоненциальным ростом сложности координации. По данным TechAhead, 40% пилотов мультиагентных систем проваливаются в первые полгода после выхода в продакшен, а цепочка из пяти агентов с точностью 95% каждый на выходе дает не 95%, а около 77% надежности всей системы. В статье — пять причин, почему так происходит, и чек-лист перед запуском.
Почему агенты теряют контекст друг друга?
Каждый агент видит только то, что ему явно передали на входе. Если координатор забыл включить деталь в сообщение, следующий агент работает вслепую и выдает результат, который противоречит предыдущему шагу.
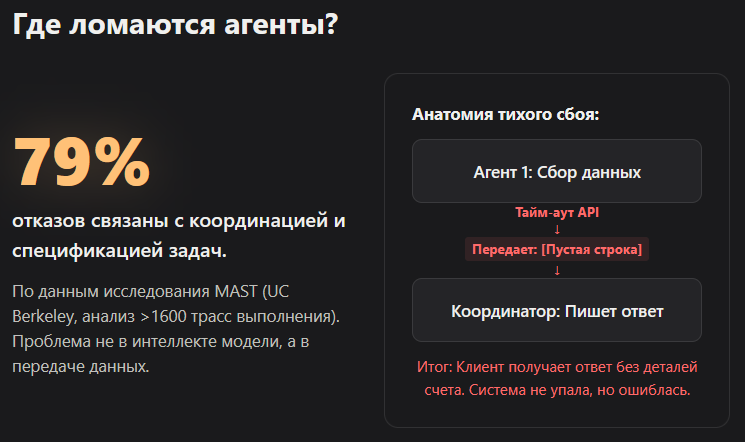
Передачу данных между агентами инженеры называют handoff, и это скорее ремесло, чем наука: универсального рецепта, что именно передавать дальше, не существует. По данным исследования MAST (UC Berkeley, анализ свыше 1600 трасс выполнения в семи популярных фреймворках), около 79% отказов мультиагентных систем связаны именно с координацией и спецификацией задач, а не с качеством самой модели.
На практике handoff ломается предсказуемо. Под-агент собрал информацию о клиенте, но не успел уложиться в тайм-аут и вернул пустую строку вместо ошибки. Координатор эту пустоту не заметил и сформировал ответ только на основе части данных, оставив пользователя без информации о счете. Это тихий сбой: он не роняет систему, а незаметно подтачивает доверие к ней, потому что снаружи все выглядит нормально. Найти причину рассогласования сложнее, чем в системе с одним агентом, который держит весь контекст сразу и ничего никому не передает.
Решение здесь не в том, чтобы гонять между агентами весь диалог целиком. Нужно решить заранее: агент передает саммари, полный контекст или одну конкретную команду на выполнение. И зафиксировать формат ошибки, а не молчать пустой строкой, если что-то пошло не так.
Почему мультиагентная система выходит дороже одного агента?
Каждый дополнительный агент — это отдельный вызов модели, и стоимость растет не линейно, а по мере роста внутренних итераций: рассуждений, перепроверок, сборки контекста.
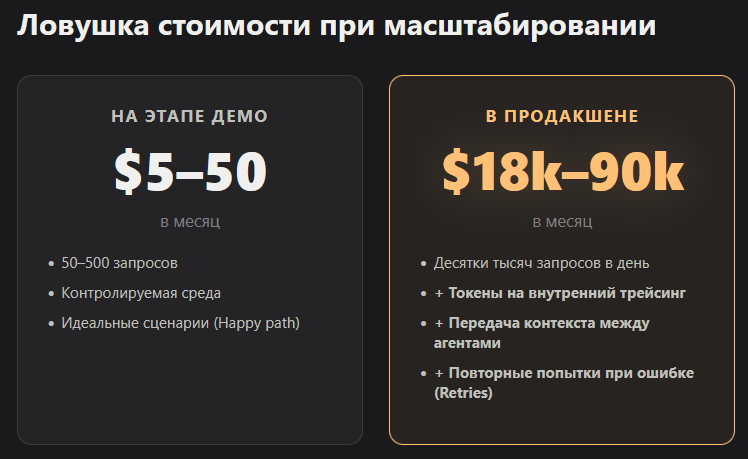
Демо на 5-50 долларов в месяц может превратиться в счет на 18-90 тысяч долларов при выходе в продакшен из-за умножения токенов на каждом шаге цепочки. Это данные TechAhead по реальным внедрениям мультиагентных пайплайнов в 2026 году, и разброс объясняется тем, что в демо прогоняют 50-500 контролируемых запросов, а в проде система обрабатывает десятки тысяч в день с непредсказуемыми edge-кейсами.
Экономия появляется не автоматически от факта разделения задачи на роли, а от того, насколько осознанно эти роли распределены по стоимости моделей. Дешевую модель туда, где нужна скорость и простая классификация, дорогую туда, где действительно нужна глубина рассуждения. Внутренний трейсинг, перекидывание контекста между агентами, повторные попытки при ошибке — все это отдельные вызовы LLM, и каждый стоит либо прямых денег за API, либо GPU-времени, если модель развернута у вас.
Что такое каскадный сбой и чем он опасен?
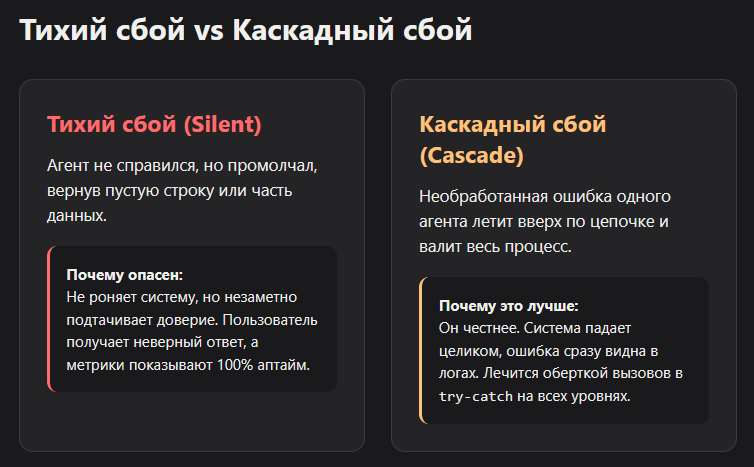
Каскадный сбой — это необработанное исключение одного агента, которое летит дальше по цепочке и валит весь процесс целиком, вместо того чтобы аккуратно завершиться структурированной ошибкой.
Разница между тихим и каскадным сбоем принципиальна для отладки. Тихий сбой опаснее в продакшене именно потому, что незаметно подрывает доверие клиентов, выдавая неполные данные без предупреждения. Каскадный сбой заметнее и в этом смысле честнее: система падает целиком, а не притворяется, что все хорошо.
Пример из практики: под-агент поиска заказа обращается к базе данных, а база недоступна. Исключение не поймано, летит вверх по цепочке и роняет весь процесс агента. Правильное поведение другое: под-агент оборачивает вызов инструмента в try-catch, ловит ошибку базы и возвращает структурированный ответ вида «база данных заказов недоступна». Координатор получает эту структуру, а не сырое исключение, и формирует для пользователя честный частичный ответ вместо краха всей сессии. Такую же обертку стоит держать и на уровне координатора как второй рубеж защиты, потому что нельзя рассчитывать, что каждый под-агент всегда корректно обработает свою ошибку.
Почему отладку мультиагентной системы называют черным ящиком?
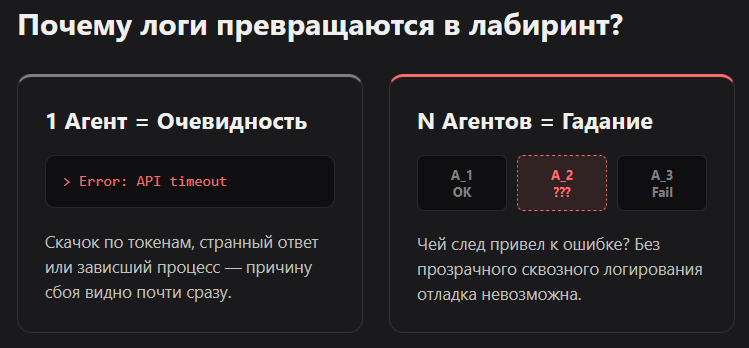
Чем больше агентов в системе, тем сложнее понять, что именно пошло не так и на каком шаге, потому что каждый агент оставляет свой цифровой след, а эти следы нужно объединять и читать вместе.
Скачок по токенам, странный ответ, зависший процесс — в системе с одним агентом причину видно почти сразу. В мультиагентной системе нужно сначала понять, какой из агентов и на каком именно шаге взаимодействия дал сбой. Без прозрачного логирования каждого шага отладка превращается в гадание на трассах.
Отдельная сложность — оценка качества. Составить метрики (evals), по которым можно регулярно проверять, насколько система соответствует ожиданиям, трудно уже для одного агента, а для системы из нескольких ролей сложную поведенческую цепочку почти невозможно свести к простому числу. Разработчик мультиагентных продуктов в Сбере Дима в своем разборе мультиагентности отмечает: не стоит гнаться за идеальными эволсами с первого дня. Даже базовый бенчмаркинг лучше, чем прод без всякой обвязки для контроля качества.
Когда мультиагентность создает сложность без пользы?
Часть команд добавляет агентов не потому, что задача требует специализированных ролей, а потому что архитектура не доделана и агент выглядит как быстрое решение вместо настройки промпта или логики одного сервиса.
Если задача не решается, самый простой ход — попробовать решить ее агентом, а если агент не справился, добавить еще одного. Вместо того чтобы разобраться с архитектурой промпта, метриками качества и целеполаганием одного исполнителя, команда получает пять или двадцать агентов и новый слой издержек на координацию между ними, который никак не окупается результатом.
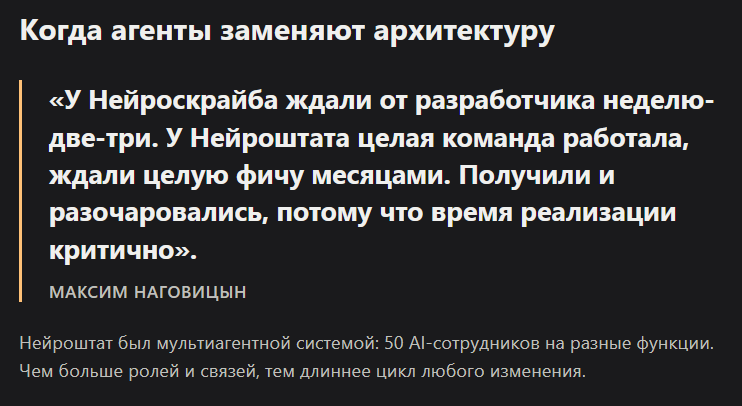
Максим: «У Нейроскрайба ждали от разработчика неделю-две-три. У Нейроштата целая команда работала, ждали целую фичу месяцами. Получили и разочаровались, потому что время реализации критично».
Нейроштат в этой истории и был по сути мультиагентной системой: 50 специализированных AI-сотрудников на разные функции бизнеса. Чем больше ролей и связей между ними, тем длиннее цикл любого изменения, и это стоит закладывать в план заранее, а не обнаруживать постфактум.
Что проверить перед запуском мультиагентной системы?
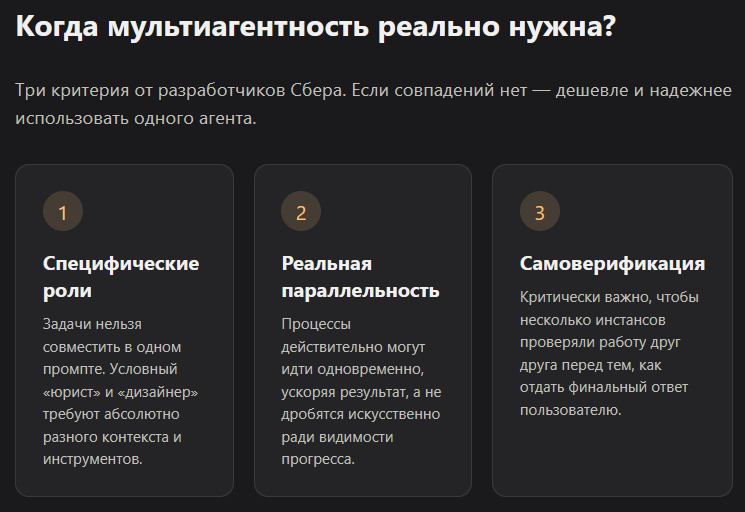
Мультиагентность оправдана, когда у задачи явно разные роли, реальная параллельность и нужна самопроверка результата. Без этого проще и дешевле остаться на одном агенте.
Дима из Сбера предлагает три ориентира, когда мультиагентная архитектура действительно нужна: специфические роли, которые нельзя совместить в одном агенте (юрист и дизайнер требуют разных навыков и разного контекста), реальная возможность распараллелить работу, а не искусственное дробление ради видимости прогресса, и потребность в самоверификации, когда несколько инстансов проверяют друг друга и наружу выходит только финальное согласованное решение.
| Проблема | Как проявляется | Что делать |
|---|---|---|
| Потеря контекста при handoff | Агент работает на неполных данных, результат противоречит предыдущему шагу | Зафиксировать формат передачи (саммари/полный контекст/команда), возвращать структурированную ошибку вместо пустоты |
| Рост расходов на API | Счет за токены растет быстрее, чем качество результата | Распределять модели по стоимости под задачу, не ставить дорогую модель туда, где хватит дешевой |
| Каскадные сбои | Ошибка одного агента роняет весь процесс | try-catch на каждом вызове инструмента и в координаторе, структурированные ошибки вместо исключений |
| Сложная отладка | Непонятно, какой агент и на каком шаге дал сбой | Логировать каждый шаг с первого дня, начинать хотя бы с базовых evals |
| Избыточная сложность | Агентов больше, чем того требует задача | Проверить чек-лист: разные роли, реальная параллельность, нужна самоверификация |
Практический совет один: начинать с простейшей системы из двух-трех ролей на реальной, но не критичной задаче. Логировать каждый шаг взаимодействия между агентами с первого дня. Наращивать сложность архитектуры только тогда, когда для этого есть конкретная причина, а не заранее, с расчетом на будущий рост.
Частые вопросы про проблемы мультиагентных систем
Всегда ли мультиагентная система лучше одного агента?
Нет. Если задачу может решить один хорошо настроенный агент, добавление ролей только увеличит расходы и сложность отладки без роста качества результата.
Почему мультиагентная система стоит дороже, если агенты меньше и проще?
Потому что каждый агент это отдельный вызов модели, а внутренние итерации, перепроверки и передача контекста между ролями умножают число вызовов на всю цепочку.
Как отличить тихий сбой от каскадного?
Каскадный сбой останавливает весь процесс и виден сразу. Тихий сбой не ломает систему, а выдает неполный результат без предупреждения, и это выявляется только по жалобам пользователей.
С чего начать логирование мультиагентной системы?
С фиксации входа и выхода каждого агента на каждом шаге, до первого запуска в продакшен, а не после первого сбоя.
Сколько агентов нужно для старта?
Два-три агента с четко разными ролями на некритичной задаче достаточно, чтобы понять паттерны сбоев, прежде чем масштабировать архитектуру.
Можно ли обойтись без evals на старте?
Полноценные evals не обязательны сразу, но базовый бенчмаркинг стоит завести с первого дня, иначе о качестве системы можно только гадать.
Если планируете многошаговый пайплайн, разумно сверить архитектуру с тем, как ее собирают в готовых средах для агентов, например в Claude Code, и посмотреть остальные инструменты в каталоге IDE и AI-инструментов. Для разбора конкретной архитектуры под вашу задачу можно записаться на консультацию к Максиму.
Обновлено: октябрь 2026