10+ лет в маркетинге, 300+ клиентских проектов: сайты, реклама, боты. Создатель GoBanana (228K+ пользователей, 11.6 млн ₽ выручки) и VibeCoderz. Делаю AI-продукты сам через Claude Code, Cursor, Windsurf и консультирую тех, кто хочет так же.
Об авторе →Claude Code: новый CLI-агент от Anthropic
Anthropic выпустила Claude Code — терминальный AI-агент для разработчиков. Инструмент работает прямо в командной строке и умеет писать, редактировать и запускать код.
Zcode AI: Полный гид по визуальному интерфейсу для Claude Code и AI-агентов
Узнайте, как использовать Zcode для управления Claude Code, Gemini и Codex в едином GUI. Настройка провайдеров, MCP-серверов и визуальный вайбкодинг.
YouTube-канал с монетизацией из любой точки мира: Пошаговый гайд 2026
Инструкция по созданию YouTube-канала: обход блокировок SMS, настройка расширенных функций через виртуальные номера и правила безопасности для монетизации.
Windsurf Code Maps: Как глубоко понимать архитектуру проекта перед написанием кода
Полный гайд по Windsurf Code Maps, модели Sway 1.5 и Sway Grep. Узнайте, как визуализировать архитектуру кода и ускорить разработку в 13 раз.
Vk Fast Cash Strategy
Аудитория ВКонтакте — это те же люди, что и в Instagram, но 'социальный контракт' площадки другой. Если Instagram — это 'дорогой ресторан' с демонстрацией успеха, то VK — это 'душевная шашлычная'. Здесь не работает глянцевый 'успешный успех
Qwen 3.8 Max стала первой моделью линейки Max, у которой Alibaba открыла веса. 12 августа 2026 года чекпоинт на 2,4 трлн параметров появился на Hugging Face, и скачать его может любой. А вот запустить дома не выйдет: даже 1-битная версия весит 397 ГБ. Поэтому Qwen 3.8 локально на практике означает младшую Qwen 3.8 27B, а к Max подключаются через API. Ниже пошагово разберем оба пути: где скачать веса, какой квант Q4 поставить на 16-24 ГБ видеопамяти и как получить доступ к Max без китайского аккаунта.
TL;DR. Qwen 3.8 Max (2,4 трлн параметров, 95 млрд активных) доступна по API за $2/$6 за 1M токенов и как открытые веса, которым нужен кластер. Для домашнего ПК берите Qwen 3.8 27B под Apache 2.0: квант Q4 занимает 16-19 ГБ и запускается одной командой в Ollama. В статье: таблицы квантов, команды запуска и пять способов доступа к Max.
Qwen 3.8 Max это флагманская MoE-модель Alibaba на 2,4 трлн параметров с контекстом 1M токенов. Главное отличие от Qwen 3.7 Max в открытых весах, которых у линейки Max раньше не было.
Qwen 3.8 Max вышла в превью 19 июля 2026 года, в общий доступ по API 2-3 августа, а веса опубликовали 12 августа. На Intelligence Index от Artificial Analysis модель набрала 58 баллов: пятое место в общем рейтинге и второе среди открытых моделей. Младшая Qwen 3.8 27B с 52 баллами заняла третье место среди открытых.
С сентября 2025 года каждая Max-версия оставалась закрытой: Qwen3-Max-Preview, Qwen 3.6 Max, Qwen 3.7 Max работали только через API и Qwen Chat. Веса Alibaba отдавала лишь младшим моделям вроде Qwen 3.6 27B. Пока она держала флагманы при себе, лидерство в open-weights делили Moonshot с Kimi и Z.ai с GLM.
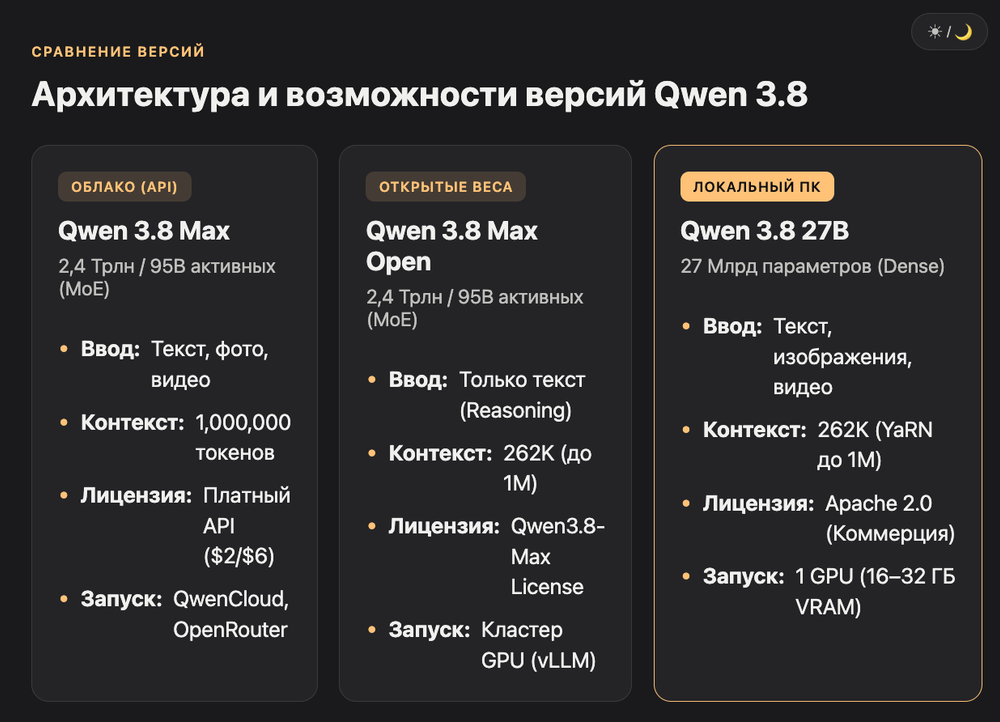
Под капотом Mixture-of-Experts: на каждый токен включается 95 млрд параметров из 2,4 трлн. Модель принимает текст, картинки и видео, пишет до 131 тыс. токенов ответа. Подробный разбор архитектуры и бенчмарков есть в материале The Batch, а ниже короткая выжимка.
| Параметр | Qwen 3.8 Max (API) | Qwen 3.8 Max (открытые веса) | Qwen 3.8 27B |
|---|---|---|---|
| Параметры | 2,4 трлн / 95 млрд активных | 2,4 трлн / 95 млрд активных | 27 млрд (dense) |
| Контекст | 1M токенов | 262K, расширяется до ~1M | 262K, до 1M через YaRN |
| Ввод | Текст, изображения, видео | Только текст | Текст, изображения, видео |
| Лицензия | Платный API | Qwen3.8-Max License | Apache 2.0 |
| Где запускать | QwenCloud, OpenRouter | Кластер GPU | Одна видеокарта 16-32 ГБ |
Веса Max открыты, но под собственной лицензией Qwen с ограничениями для крупного бизнеса. Qwen 3.8 27B вышла под Apache 2.0 и подходит для коммерции без оговорок.
Лицензия Qwen3.8-Max License требует от компаний с выручкой от $20 млн в месяц или аудиторией от 100 млн MAU показывать название модели в интерфейсе. Сервисы формата Model as a Service с оборотом выше $50 млн за 12 месяцев обязаны получить отдельную коммерческую лицензию. Для стартапов и вайбкодеров эти пороги недостижимы.
Расклад простой. Если вы собираете свой продукт, бота или внутренний инструмент, обе лицензии вам подходят. Но юристы крупной компании будут читать условия Max с карандашом в руках, и 27B тут проще: Apache 2.0 не требует ничего, кроме сохранения уведомления об авторстве.
Есть нюанс с открытой версией Max. Она работает только с текстом и всегда думает в режиме reasoning. Зрение, видео и полный контекст на 1M токенов остались в облачной версии на QwenCloud. Так что скачанная Max слабее той, что отвечает вам в Qwen Chat.
Нет, если под «своим железом» понимать ПК или рабочую станцию. Самый сжатый квант Max весит 397 ГБ и требует от 450 ГБ оперативной памяти.
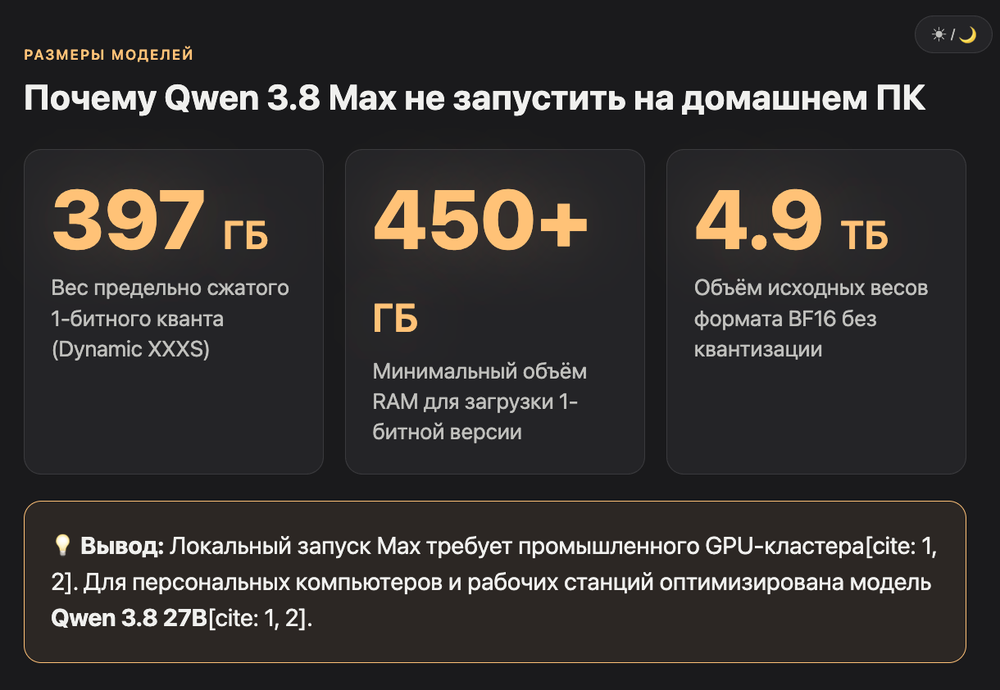
По данным Unsloth, Qwen 3.8 Max в динамическом 1-битном кванте занимает 397 ГБ, в 2-битном 657 ГБ, в Q8_0 около 2,6 ТБ, а в исходном BF16 4,9 ТБ. NVIDIA проводила свои замеры на стойке GB300 NVL72. Для домашнего ПК это недостижимо, поэтому локальный сценарий для Max закрыт.
| Формат Qwen 3.8 Max | Размер файлов | Для чего |
|---|---|---|
| Dynamic 1-bit XXXS | 397 ГБ | Эксперименты на сервере с 450+ ГБ RAM |
| Dynamic 1-bit | 508 ГБ | То же, чуть точнее |
| Dynamic 2-bit | 657 ГБ | Минимально рабочее качество |
| Q8_0 | ~2,6 ТБ | Продакшен на кластере |
| BF16 | 4,9 ТБ | Исходные веса без потерь |
Скачать Qwen 3.8 Max можно из репозитория Qwen/Qwen3.8-2.4T-A95B на Hugging Face или с ModelScope. Для сервинга Alibaba рекомендует SGLang и vLLM.
Кому это вообще нужно? Компаниям, которые не могут отправлять данные в облако: банки, медицина, госсектор. И провайдерам, которые будут перепродавать Max по API дешевле Alibaba. Всем остальным разумнее взять 27B или платить за токены.
Qwen 3.8 27B лежит на Hugging Face, ModelScope и в библиотеке Ollama. Для обычной видеокарты нужен GGUF-квант от Unsloth, а исходные BF16-веса весят 56 ГБ.
Скачать Qwen 3.8 27B можно в трех видах: исходные веса BF16 на 56 ГБ в репозитории Qwen, GGUF-кванты от Unsloth от 7 до 31 ГБ и готовая сборка Ollama на ~18 ГБ. Ollama добавила модель в версии 0.32.12 от 15 августа 2026 года, команда запуска: ollama run qwen3.8:27b.
Ollama. Одна команда, и через 10-15 минут скачивания модель отвечает в терминале. Сборка по умолчанию использует Q4_K_M: 17 ГБ весов плюс 931 МБ на модуль зрения. MTP (ускорение генерации, о нем ниже) уже включен.
Есть оговорка. В первых версиях сборки ломалась передача картинок на квантованных весах. Баг поправили, но если планируете работать со скриншотами, проверьте этот сценарий до того, как строить на нем процесс.
Репозиторий unsloth/Qwen3.8-27B-GGUF. Там десяток квантов разного размера, и под каждую видеокарту можно подобрать свой. Плюс у Unsloth рабочий MTP, которого нет в официальных GGUF от Qwen. Таблица требований к памяти лежит в документации Unsloth.
Неофициальные uncensored-версии мы трогать не советуем без причины. Это модификации сообщества, которые реже отказываются отвечать, но умнее от этого не становятся.
На 24 ГБ берите Q4_K_XL или Q4_K_M, на 16 ГБ UD-Q3_K_XL. Q4 остается лучшим балансом качества и размера, если он помещается в видеопамять целиком.
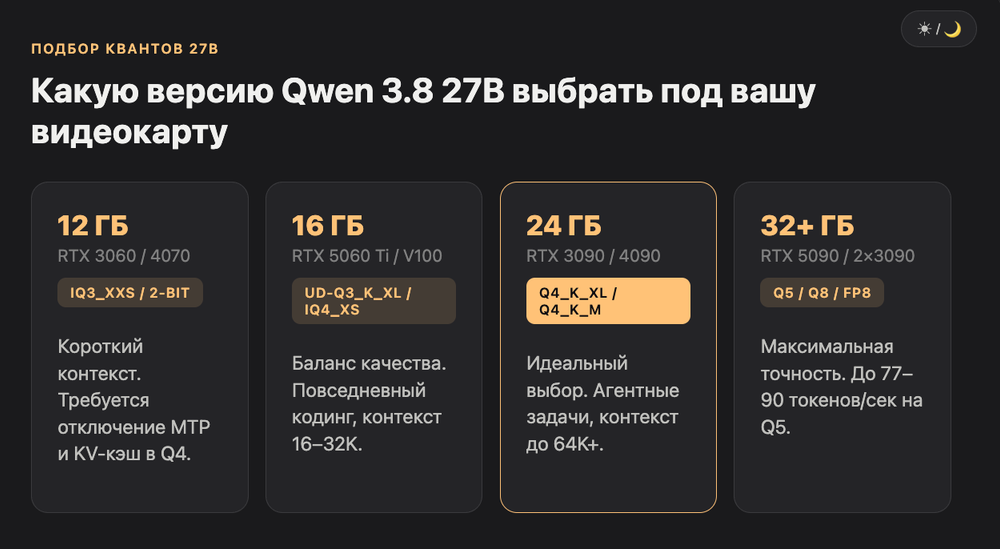
Квант Qwen 3.8 27B в 4 бита занимает 16-19 ГБ, в 3 бита 12-14 ГБ, в 8 бит 31 ГБ. Ключевое правило: модель должна целиком помещаться в видеопамять. Если слои переливаются в оперативку, скорость падает с 40 токенов в секунду до единиц, и работать становится невозможно.
Цифры в таблице собраны из документации Unsloth и десяти разборов на YouTube, которые мы прогнали через транскрибатор для этой статьи.
| Видеопамять | Пример GPU | Квант | Что получите |
|---|---|---|---|
| 12 ГБ | RTX 4070, 3060 12GB | IQ3_XXS или 2-bit | Работает, но контекст короткий. Отключите MTP, KV-кэш в Q4 |
| 16 ГБ | RTX 5060 Ti, Tesla V100 | UD-Q3_K_XL (баланс), IQ4_XS (качество), UD-IQ3_XS (запас) | Повседневный кодинг, контекст 16-32K |
| 24 ГБ | RTX 3090, 4090 | Q4_K_XL / Q4_K_M, новый квант GSQ RCO | Агентные задачи, контекст до 64K и выше |
| 32 ГБ | RTX 5090 | Q5-Q6 | 77-90 токенов в секунду на Q5 |
| 48+ ГБ | 2×3090, RTX 6000 | Q8 или FP8 | Качество, близкое к исходным весам |
Автор теста квантов на 16, 24 и 32 ГБ пришел к выводу, который ломает интуицию. Кванты одного уровня от разных авторов ведут себя по-разному, а победитель на QuantBench проигрывает на тесте поиска по длинному контексту. Больше бит не гарантирует лучший результат.
Отдельный момент про Q4_K_M на длинных задачах. В разборе запуска на RTX 3090 он терял контекст там, где FP8 справлялся. Если ваш сценарий это работа с большими документами или длинная агентная сессия, проверьте выбранный квант именно на ней, а не на коротких промптах.
Самый быстрый путь: установить Ollama и выполнить одну команду. Для максимальной скорости используйте llama.cpp с GGUF от Unsloth и включенным MTP.
Локальный запуск Qwen 3.8 27B укладывается в три шага: скачать модель через Ollama или llama.cpp, настроить сэмплинг под режим размышлений и подключить модель к редактору кода. На RTX 3090 с MTP генерация идет около 40 токенов в секунду, без MTP заметно медленнее.
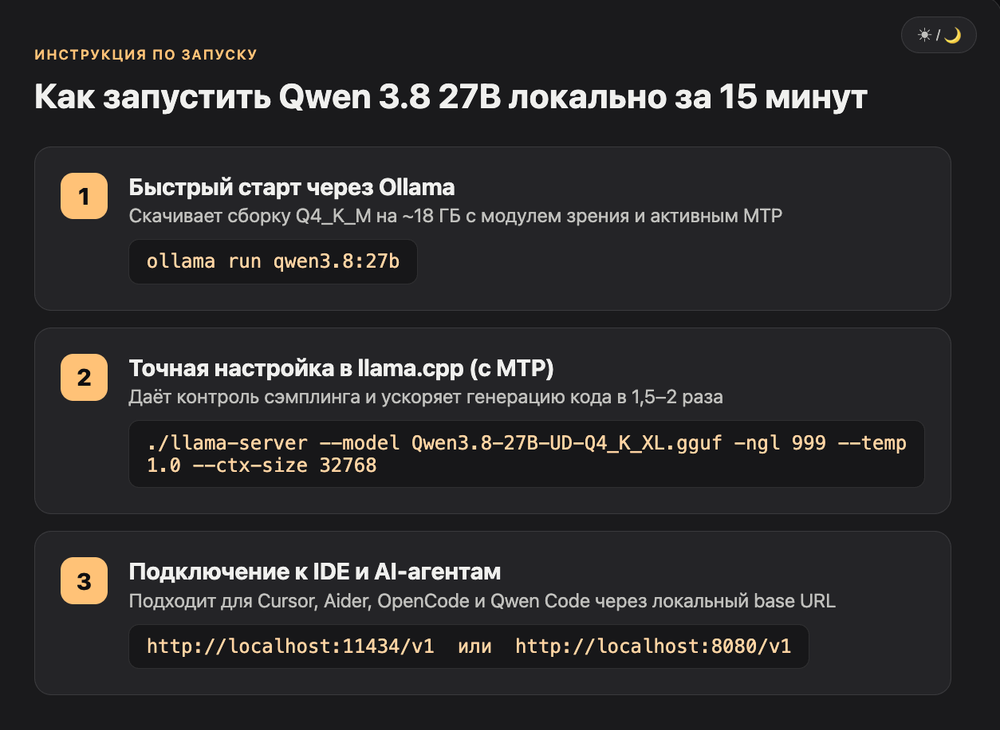
Скачайте Ollama с официального сайта, затем откройте терминал:
ollama run qwen3.8:27bЗагрузка ~18 ГБ займет 10-20 минут на домашнем интернете. После этого модель доступна в терминале и по локальному API на порту 11434, к которому подключаются IDE и агенты.
Этот путь дает больше контроля. Скачайте квант UD-Q4_K_XL из репозитория Unsloth и запустите сервер:
./llama-server \
  --model Qwen3.8-27B-UD-Q4_K_XL.gguf \
  -ngl 999 \
  --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.0 \
  --ctx-size 32768
Флаг -ngl 999 выгружает все слои на видеокарту. MTP (multi-token prediction) включается флагами спекулятивного декодирования с типом draft MTP, точный синтаксис зависит от версии llama.cpp. По замерам из разборов, MTP ускоряет генерацию кода в 1,5-2 раза.
Оба сервера отдают OpenAI-совместимый API. Его понимают Aider, OpenCode, консольный Qwen Code (нужен Node.js) и Cursor через настройку собственного base URL. В поле адреса укажите http://localhost:11434/v1 для Ollama или http://localhost:8080/v1 для llama-server.
Поделимся правилом из одного разбора про локальных агентов. Добавляйте в системный промпт запрет удалять файлы и выкладывать что-то на живой сервер без явного разрешения. Агент на вашем ПК выполняет команды по-настоящему, и откатить удаленную папку будет нечем. Если разворачиваете модель на сервере команды, загляните в ИИ-агента для DevOps, он поможет с конфигами.
Уровень reasoning effort и формулировка задачи. На Extra High модель может потратить все токены на размышления и не выдать код, а Medium решает ту же задачу.
В тесте на генерацию JavaScript-функции Qwen 3.8 27B с уровнем размышлений Extra High написала около 4000 токенов внутренних рассуждений и не выдала ни строчки ответа. На уровне Medium модель вернула рабочий код быстрее и дешевле. Высокий reasoning effort стоит по умолчанию и переполняет контекст на слабом железе.
Unsloth рекомендует две связки. Для режима размышлений: temperature 1.0, top_p 0.95, top_k 20. Для быстрых ответов без reasoning: temperature 0.7, top_p 0.8, top_k 20, presence_penalty 1.5. Ставить «среднее между ними» смысла нет, модель обучали под эти пресеты.
У Qwen 3.8 27B заметна склонность соглашаться с пользователем, даже когда тот неправ. Вместо «у тебя тут ошибка» описывайте желаемое поведение: «функция должна возвращать пустой массив при пустом входе». Так модель проверяет код по требованию, а не подстраивается под ваше мнение.
Из 64 слоев только 16 используют классическое внимание, остальные 48 построены на gated DeltaNet с линейной сложностью. Это экономит видеопамять на длинном контексте. Плата за экономию: на задачах с глубоким запоминанием модель уступает, а с инструкциями и сборкой кода справляется отлично.
Китайский номер телефона не нужен. Max доступна в Qwen Chat, через международный QwenCloud и OpenRouter, сложности из России возникают только с оплатой.
Qwen 3.8 Max работает через пять каналов: бесплатный Qwen Chat, API QwenCloud за $2 и $6 за 1M входных и выходных токенов, подписка Token Plan от $6 в месяц, OpenRouter и среда Qoder. QwenCloud держит серверы в Сингапуре, Франкфурте, Токио и США, поэтому китайская регистрация не требуется.
| Способ | Цена (октябрь 2026) | Что нужно | Кому подходит |
|---|---|---|---|
| Qwen Chat (веб и приложения) | Бесплатно | Почта или Google-аккаунт | Попробовать модель за 5 минут |
| QwenCloud API, ID qwen3.8-max | $2 / $6 за 1M, кэш $0,25 | Международный аккаунт, карта | Продакшен, свои сервисы |
| Token Plan | $6, $18, $68 в месяц | Подписка QwenCloud | Плотная работа агентов |
| OpenRouter | $2 / $6 за 1M | Один ключ на все модели | Cursor, Claude Code, Cline |
| Qoder | По тарифу ключа | Аккаунт Qoder | Автономный кодинг |
Qwen Chat открывается без ограничений, но выбор модели спрятан за логином, и проверить снаружи, что отвечает именно 3.8 Max, нельзя. Для серьезной работы удобнее OpenRouter: один баланс для всех моделей и оплата криптовалютой, которая снимает вопрос зарубежной карты.
Максим: «Когда мы делали GoBanana, главный российский угол был простой: без VPN, без зарубежных карт, платишь сколько нужно. Веб-версию собрали за 3 часа после выхода модели, а продукт в итоге принес 12 млн рублей. Ребят, это работает: если доступ к модели для людей сложный, его упрощение само по себе становится продуктом.»
Max понимает и OpenAI API, и Anthropic API. Значит, в Claude Code ее можно подставить через смену base URL без прокси-роутеров. Учтите ограничение: в официальном конфиге OpenClaw вывод урезан до 65 536 токенов, хотя модель умеет до 131 тыс. На OpenRouter в сентябре вышел чекпоинт 0902, актуальный слаг проверяйте на странице модели.
Сильная сторона линейки в открытых весах и цене, слабая в том, что почти все бенчмарки Max пока опубликовала сама Alibaba.
Qwen 3.8 Max занимает 4-е место в WebDev Arena с 1667 Elo, 2-е в Vision Arena и лучший результат на τ³-Banking (51,3%). При этом таблица бенчмарков на запуске исходила от Qwen, и независимых воспроизведений почти нет. Для продакшена правильнее прогнать модель на своих задачах.
Локальная 27B нужна тем, кому важна приватность данных и нулевая цена токена. API Max нужен тем, кому важно максимальное качество без покупки железа.
Локальный запуск Qwen 3.8 27B окупается, если у вас уже есть видеокарта от 16 ГБ и задачи с закрытым кодом или чувствительными документами. Для сложных агентных задач и мультимодальности выгоднее API Qwen 3.8 Max: $2 за 1M входных токенов дешевле, чем докупать память под большой квант.
| Ваша ситуация | Что берем |
|---|---|
| Хочу просто попробовать Max | Qwen Chat, бесплатно |
| Есть RTX 3090/4090, пишу код для клиентов под NDA | Qwen 3.8 27B Q4 локально |
| Видеокарта на 16 ГБ, хочу локального помощника | Qwen 3.8 27B UD-Q3_K_XL или IQ4_XS |
| Собираю продукт на модели, нужна стабильность | QwenCloud API или OpenRouter |
| Компания, данные нельзя выносить, есть свой кластер | Открытые веса Max через vLLM или SGLang |
| Нужен максимум качества на коде любой ценой | Не Qwen, а Claude Opus 4.8 или Fable 5 |
Мы в VibeCoderz используем облачные модели для основной работы, а локальную 27B держим под задачи, где код нельзя отдавать наружу. Полный список инструментов для вайбкодинга с обзорами собран в каталоге AI IDE.
MoE (Mixture-of-Experts) это архитектура, где на каждый токен работает только часть параметров модели. У Qwen 3.8 Max активны 95 млрд из 2,4 трлн.
Открытые веса (open weights) это файлы обученной модели, которые можно скачать и запустить у себя.
Квантизация это сжатие весов модели за счет снижения точности чисел, например с 16 до 4 бит. Q4 занимает примерно в 3,5 раза меньше места, чем BF16.
GGUF это формат файлов модели для llama.cpp, Ollama и LM Studio.
MTP (multi-token prediction) это предсказание нескольких токенов за шаг, которое ускоряет генерацию в 1,5-2 раза.
Reasoning effort это уровень размышлений модели перед ответом. Чем он выше, тем больше токенов уходит на рассуждения.
VRAM это память видеокарты. Модель должна целиком в нее помещаться для нормальной скорости.
Можно ли скачать Qwen 3.8 Max бесплатно? Да, веса лежат на Hugging Face и ModelScope с 12 августа 2026 года. Но самая сжатая версия весит 397 ГБ и требует от 450 ГБ RAM, так что для домашнего ПК практичнее скачать Qwen 3.8 27B.
Сколько видеопамяти нужно для Qwen 3.8 27B в Q4? Квант Q4 занимает 16-19 ГБ, плюс память под контекст. Комфортно он работает на картах с 24 ГБ вроде RTX 3090 и 4090. На 16 ГБ лучше взять UD-Q3_K_XL или IQ4_XS.
Чем Qwen 3.8 Max в API отличается от скачанной версии? Облачная Max понимает картинки и видео и держит контекст 1M токенов. Открытая версия работает только с текстом, всегда в режиме размышлений и с нативным контекстом 262K.
Нужен ли китайский аккаунт для доступа к Qwen 3.8 Max? Нет. Qwen Chat пускает по почте, QwenCloud работает в международных регионах, а через OpenRouter модель доступна по одному ключу вместе с остальными нейросетями.
Почему Qwen 3.8 27B думает долго и ничего не отвечает? Скорее всего, стоит высокий reasoning effort, и модель тратит весь лимит токенов на рассуждения. Снизьте уровень до Medium или увеличьте лимит вывода.
Можно ли использовать Qwen 3.8 27B в коммерческом проекте? Да, 27B выпущена под Apache 2.0 без дополнительных ограничений. У Max своя лицензия, которая вводит условия только для очень крупных компаний.
Что лучше для кодинга: локальная Qwen 3.8 27B или API? Для закрытого кода и экономии на токенах локальная 27B. Для сложных многошаговых задач и работы со скриншотами API Max заметно сильнее.
Если хотите сравнить Qwen с другими моделями для кодинга, загляните в обзоры Claude Code, Cursor и Aider или откройте весь каталог AI-инструментов. А если нужно собрать локальный стек под свой проект или решить, где выгоднее держать модель, запишитесь на консультацию к Максиму.
Статья обновлена: октябрь 2026.
