
Что такое RAG простыми словами для вайбкодера в 2026 году
Спросите обычного чат-бота про внутренний регламент вашей компании или вчерашний прайс-лист — и он либо честно скажет «не знаю», либо красиво соврёт. RAG (retrieval-augmented generation) решает именно эту проблему: перед каждым ответом система сначала находит нужный кусок из ваших документов, а потом отдаёт его нейросети как подсказку. Ниже — как это устроено на пальцах, из чего состоит пайплайн и что RAG на самом деле не умеет.
RAG подключает к боту вашу базу знаний через пять шагов: документы, эмбеддинги, векторная база, поиск и генерация. Технология снижает число галлюцинаций, но не убирает их полностью. Дальше — аналогия, разбор пайплайна и честные ограничения на конкретном примере.
Что такое RAG простыми словами?
RAG — приём, при котором перед каждым обращением к нейросети система достаёт релевантные куски из внешней базы данных и подмешивает их в промт. Модель отвечает не по памяти, а по подсунутому контексту.
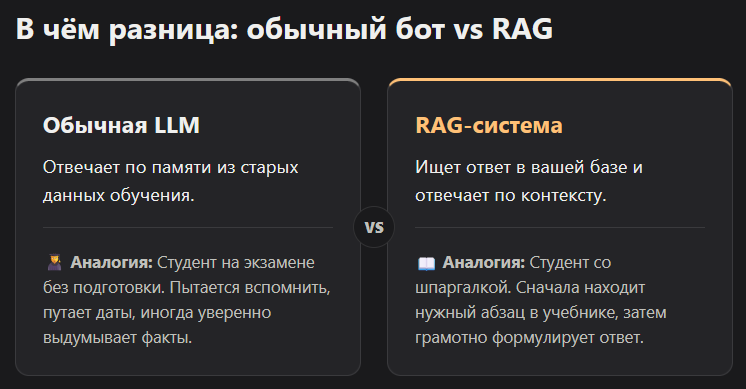
Представьте студента на экзамене. Один отвечает по памяти и иногда путает даты — это обычная LLM. Второй достаёт шпаргалку с нужным разделом учебника прямо перед ответом — это и есть RAG. Разница не в уме студента, а в том, откуда берётся информация.
Rag не меняет саму нейросеть и не требует дообучения модели. Система просто ищет подходящий фрагмент в базе, вставляет его в запрос и просит ответить, опираясь именно на этот текст. Отсюда и название: retrieval (поиск) + augmented (дополненный) + generation (генерация).
Зачем вайбкодеру вообще подключать RAG?
Обычная модель отвечает по данным из обучения, которые устаревают и не включают вашу приватную информацию. RAG даёт доступ к актуальным и закрытым документам без переобучения модели — это дешевле и быстрее.
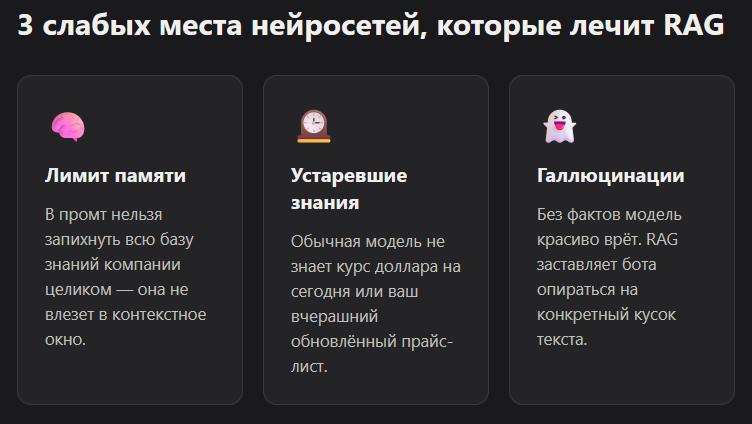
У языковых моделей три слабых места: ограниченное контекстное окно, отсутствие достоверного источника и устаревшие знания. GPT может нагуглить курс доллара, но понятия не имеет, что написано в вашей внутренней документации или переписке с клиентом.
Тут и пригождается RAG. Мы в VibeCoderz видим это на практике: клиенты хотят бота, который консультирует по конкретному продукту, а не рассуждает в общем. Загрузили спецификацию, регламент, базу FAQ — и модель начинает отвечать по существу, а не выдумывать красивую, но неточную формулировку.
Если тема шире, чем один бот, посмотрите каталог AI-агентов VibeCoderz — там собраны готовые сценарии под конкретные профессии и задачи, включая работу с базами знаний.
Как устроен пайплайн RAG: пять шагов от документа до ответа
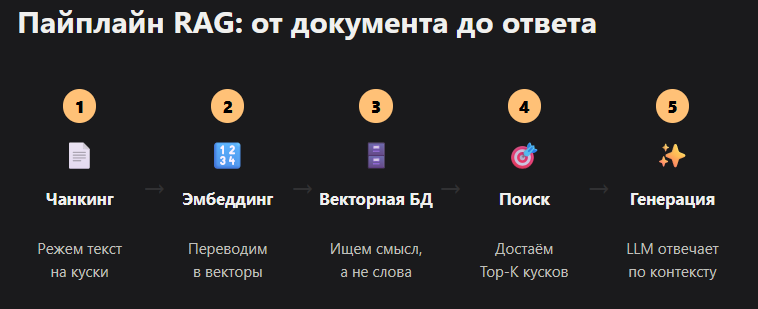
Пайплайн состоит из пяти звеньев: документы, эмбеддинги, векторная база, поиск и LLM. Каждый шаг превращает текст в числа и обратно, чтобы модель нашла смысл, а не совпадение слов.
Компьютер не понимает слова, только числа. Поэтому весь текст сначала переводится в векторы — списки чисел, которые отражают смысл фрагмента. Дальше по шагам.
Шаг 1. Документы и чанкинг
Берём любой источник: PDF, markdown, страницы сайта, транскрипты созвонов. Длинный текст режем на чанки — куски по несколько сотен символов с небольшим перекрытием, чтобы не терять контекст на стыке абзацев.
Шаг 2. Эмбеддинги
Каждый чанк проходит через эмбеддинг-модель и превращается в вектор — например, 1024 числа, которые описывают его смысл. Похожие по смыслу тексты получают близкие векторы, даже если слова в них разные.
Шаг 3. Векторная база
Все векторы складываются в специальную базу вроде Chroma, Qdrant или pgvector. Она умеет за миллисекунды находить вектора, которые лежат ближе всего к запросу — это и есть семантический поиск, в отличие от обычного поиска по ключевым словам.
Шаг 4. Поиск
Когда пользователь пишет вопрос, он тоже превращается в вектор. База находит top-k ближайших по смыслу чанков — обычно от трёх до десяти, в зависимости от настроек.
Шаг 5. Генерация
Найденные фрагменты вставляются в промт вместе с вопросом пользователя и системной инструкцией вида «отвечай только на основе контекста ниже». Модель формирует ответ, опираясь на конкретный текст, а не на общие знания из обучения.
По состоянию на март 2026 этот стек чаще всего собирают на связке LangChain или LlamaIndex + векторная база + любая LLM через API — от OpenAI до открытых моделей.
Какие инструменты нужны, чтобы собрать RAG самому?
Минимальный набор — Python, векторная база вроде ChromaDB и доступ к любой LLM через API. Базовую рабочую версию собирают за 10–15 минут на готовом шаблоне с requirements.txt.
Для первого прототипа не нужна экзотика. Достаточно связки из PDF-загрузчика, текстового сплиттера и векторной базы, которая хранится прямо в файле на диске.
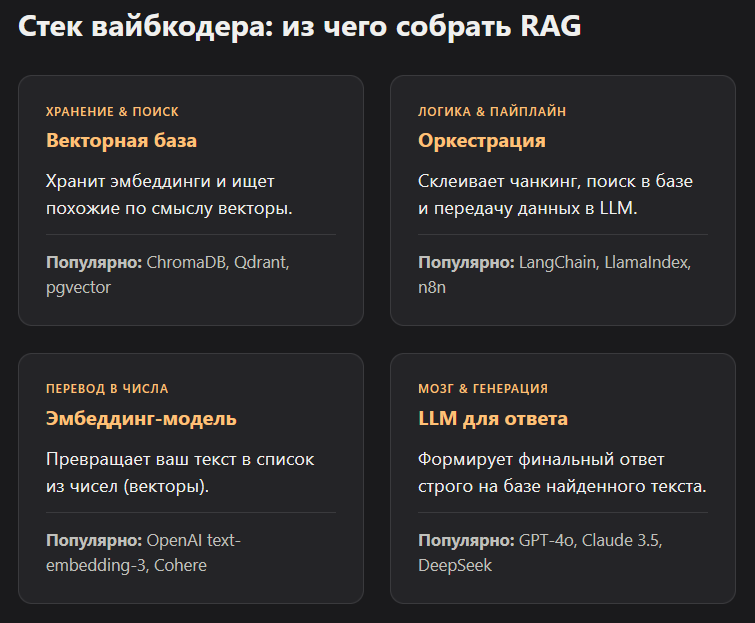
| Компонент | Популярные варианты 2026 | Для чего |
|---|---|---|
| Векторная база | ChromaDB, Qdrant, pgvector, FAISS | Хранит эмбеддинги, ищет похожие по смыслу |
| Оркестрация | LangChain, LlamaIndex | Склеивает чанкинг, поиск и промт в пайплайн |
| Эмбеддинг-модель | OpenAI text-embedding-3, Cohere v3, Voyage 3 | Превращает текст в вектор |
| LLM для ответа | GPT-4o, Claude, DeepSeek | Генерирует финальный ответ по контексту |
Для вайбкодера без опыта в ML такой набор собирается без единой строчки классического ML-кода — вся математика спрятана внутри библиотек, ваша задача — правильно настроить параметры чанкинга и порог релевантности.
Максим: «Мог просто засесть до пяти ночи и просто там править одну функцию, которая не работала. В моменте хотелось всё бросить, но я понимал: это можно решить и нужно решить, чтобы идти дальше.»
Калибровка RAG-системы — это ровно такой процесс. Чанкинг, размер перекрытия, порог сходства редко попадают в цель с первой попытки, и это нормально.
Как правильно разбить документы на чанки?
Универсального размера чанка нет: юридические тексты требуют крупных кусков с сохранением структуры пунктов, а транскрипты диалогов лучше резать по предложениям с высоким перекрытием.
Разные типы документов ведут себя по-разному. Договор с нумерованными пунктами сломается, если разрезать его посередине условия — модель потеряет смысл абзаца. А транскрипт созвона можно резать почти по репликам, потому что там и так короткие законченные мысли.
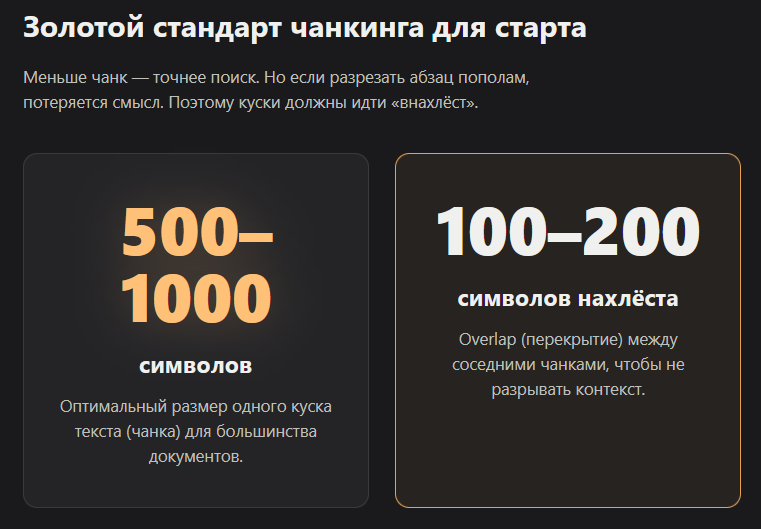
На практике стартуют с чанка на 500–1000 символов и перекрытием в 100–200 символов, а дальше смотрят на качество ответов и подгоняют цифры под конкретный тип контента. Меньше чанк — точнее попадание, но меньше контекста вокруг найденного фрагмента.
RAG правда устраняет галлюцинации нейросети?
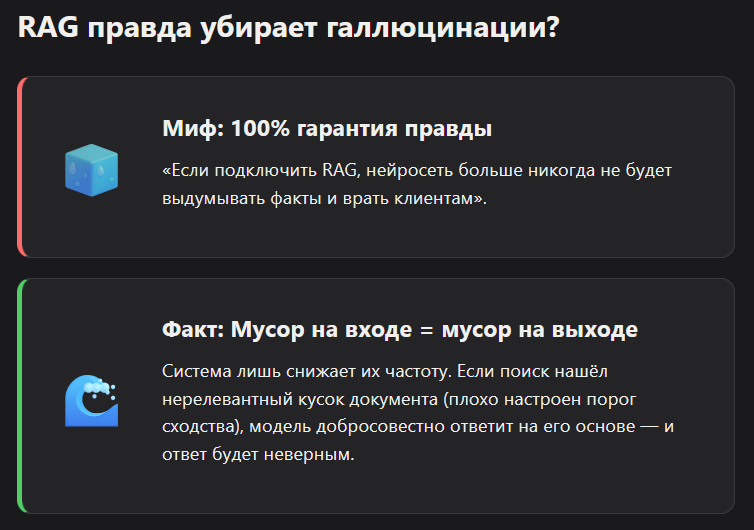
Нет. RAG снижает частоту галлюцинаций, но не убирает их полностью — если найденный чанк неполный или неоднозначный, модель всё равно может дофантазировать недостающую часть ответа.
Это честное ограничение, которое стоит проговаривать клиентам сразу. Качество итогового ответа напрямую зависит от качества поиска: если в базу попал нерелевантный чанк, модель добросовестно ответит на его основе — и ответ будет неверным, хоть и логично звучащим.
Хорошая практика — настраивать порог сходства (similarity threshold) так, чтобы система честно отвечала «не знаю» при отсутствии релевантных совпадений, вместо того чтобы натягивать слабый чанк на вопрос.
Нужны ли вайбкодеру гибридный поиск и реранкинг?
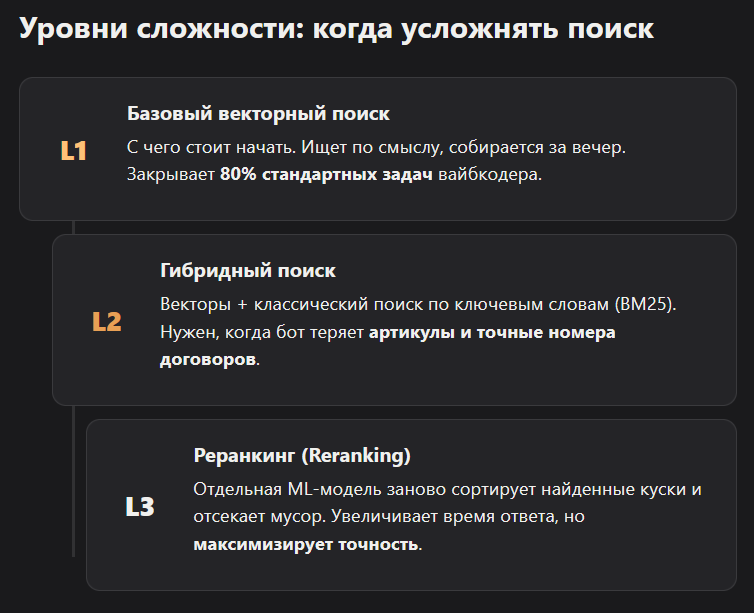
Для первого прототипа — нет. Базовый векторный поиск закрывает 80% задач. Гибридный поиск и реранкинг подключают, когда точность важнее скорости запуска.
В 2026 году зрелые RAG-системы всё чаще комбинируют векторный поиск с классическим BM25 по ключевым словам — так система не теряет точные совпадения (номера договоров, артикулы), которые векторный поиск иногда упускает. Следующий слой — реранкинг: после первого отбора кандидатов отдельная модель пересортировывает их по релевантности и отсекает мусор.
Обе техники усложняют пайплайн и увеличивают время ответа. Начинать стоит с простого варианта, а докручивать сложность только там, где база реально ошибается.
Итог: с чего начать RAG вайбкодеру прямо сейчас
Соберите первую версию на 5–10 документах, которые точно знаете вдоль и поперек — так проще заметить, где система врёт. Проверьте на вопросах, ответ на которые точно есть в базе, и на тех, которых там точно нет: хороший RAG честно скажет «не знаю» во втором случае.
Дальше изучите обзоры инструментов для сборки таких систем без кода в каталоге AI-инструментов VibeCoderz, а для готовых автоматизаций на базе агентов посмотрите разбор n8n AI-агентов. Если нужна помощь с архитектурой под конкретный проект — запишитесь на консультацию к Максиму.
Частые вопросы про RAG
Чем RAG отличается от файнтюнинга модели?
Файнтюнинг меняет веса самой модели и требует времени и данных для обучения. RAG ничего не меняет в модели, а просто подсовывает ей нужный контекст в момент запроса — быстрее и дешевле для большинства задач.
Можно ли собрать RAG без знания Python?
Базовую версию — сложно, современные конструкторы под RAG обычно требуют минимального кода. Но связку из готового шаблона, векторной базы и LLM вайбкодер с нуля собирает за один вечер, ориентируясь на готовые примеры.
Сколько документов нужно для старта?
Хватит и пяти-десяти, если это реальные документы вашей темы. Больше данных не значит лучше — сначала важно настроить чанкинг и порог релевантности на небольшой выборке.
RAG работает с любым языком, включая русский?
Да, если эмбеддинг-модель обучена на многоязычных данных. В 2026 году для русского текста используют как международные модели, так и специализированные эмбеддинги с поддержкой русского.
Почему бот с RAG иногда всё равно ошибается?
Чаще всего дело в поиске: чанк либо не нашёлся, либо оказался неполным. Ответ модели ровно такой, какой контекст она получила — мусор на входе даёт мусор на выходе.
Нужна ли отдельная видеокарта для RAG?
Для запросов через облачные API (OpenAI, Claude и другие) — нет, вся тяжёлая часть считается на стороне провайдера. GPU нужен только если разворачиваете эмбеддинг-модель и LLM локально.
RAG подходит для маленького проекта на 20 страниц документации?
Да, масштаб не критичен. RAG выгоден уже там, где обычный чат не может принять все документы разом — а это часто случается и на паре десятков страниц.
Источники: документация LlamaIndex — по архитектуре retrieval-пайплайнов; n8n AI Agents — по интеграции RAG в автоматизации.
Обновлено: октябрь 2026