
Rate limit для AI-сервиса это ограничение количества запросов на пользователя или на всю систему за единицу времени. Без него любой скрипт, конкурент или собственный баг может за час пробить месячный бюджет на токены OpenAI или Claude. Ниже разберем алгоритмы, покажем код на Redis и объясним, чем per-user лимит отличается от global.
Rate limit для AI-сервиса решает две задачи: не дает злоумышленникам гонять API бесплатно и защищает бюджет от случайного или намеренного перерасхода токенов. В 2026 году для этого чаще всего берут Redis и алгоритм token bucket, потому что он лучше остальных подстраивается под неровный расход токенов у LLM-запросов. Ниже конкретные пороги, код на FastAPI и Next.js, и разбор что выбрать: per-user, global или оба сразу.
Зачем AI-сервису вообще нужен rate limit?
Rate limit нужен, потому что AI-запросы стоят реальных денег за каждый токен, а не просто нагружают сервер. Без лимита один бот способен сжечь бюджет за минуты.
Figma в свое время столкнулась со спам-атакой: боты рассылали тысячи приглашений на случайные email через ее API. Команда закрыла дыру Redis-based рейт-лимитером, иначе счет за отправку писем и репутационный удар были бы куда болезненнее. Stripe пошла другим путем: вместо наращивания серверов инженеры ограничили именно тех пользователей, чьи скрипты или откровенное злоупотребление монополизировали ресурсы.
С обычным API атака выглядит как перегрузка сервера. С AI API она выглядит как счет от OpenAI на пять цифр. Каждый вызов модели стоит денег за входные и выходные токены, поэтому rate limit тут не про стабильность, а в первую очередь про деньги. Ошибка в коде, зацикленный вызов или намеренный abuse через API одинаково опасны для кошелька.
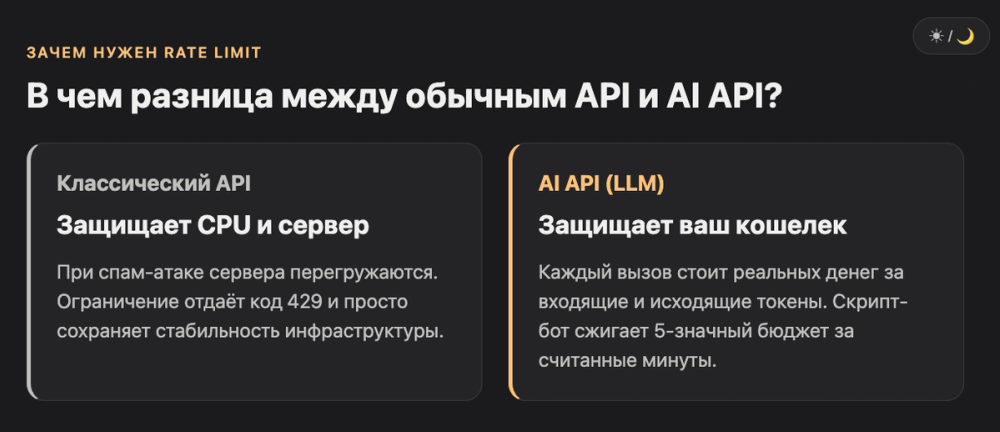
Здесь и разница с классическим API. Обычный сервис просто отдает 429 и бережет CPU. AI-сервис бережет счет за токены, а значит лимит должен учитывать не только количество запросов, но и их вес.
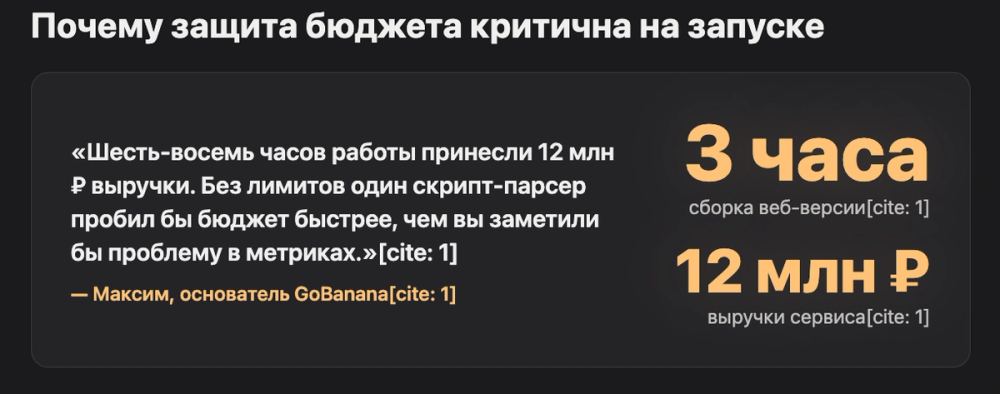
Максим: «Мы собрали веб-версию GoBanana за 3 часа после выхода новой модели. Шесть-восемь часов работы в сумме принесли 12 миллионов рублей выручки. Без лимитов на запросы такую нагрузку просто не выдержать: один скрипт-парсер способен пробить бюджет быстрее, чем вы заметите проблему в метрике.»
Какие алгоритмы rate limiting выбрать для AI API?
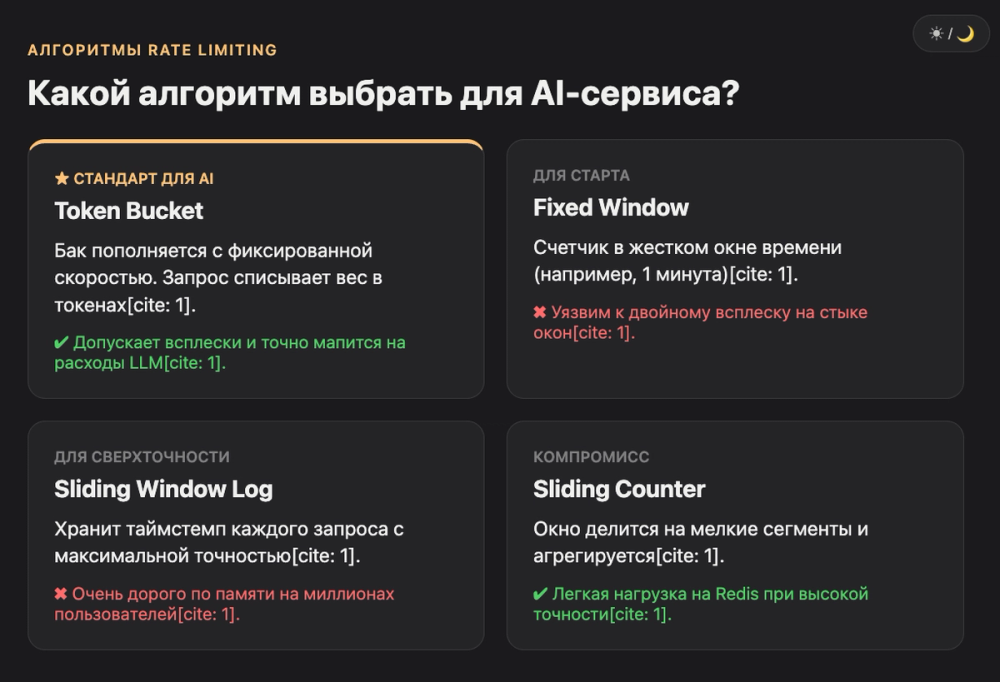
Для AI-сервисов лучше всего подходит token bucket, потому что он допускает всплески трафика и одновременно учитывает вес каждого запроса в токенах. Fixed window проще, но пропускает двойной всплеск на границе минуты.
Четыре алгоритма закрывают 90% реальных задач. Token bucket мапится прямо на биллинг AI-провайдера: у пользователя есть "бак" токенов, который наполняется с фиксированной скоростью, и каждый запрос списывает столько токенов, сколько реально стоил. Fixed window считает запросы в жестком временном окне вроде "минута с 12:00 до 12:01", это просто, но уязвимо к двойному всплеску на стыке окон.
Sliding window log хранит таймстемп каждого запроса и дает максимальную точность, подходит для финансовых операций, но требует больше памяти на миллионах пользователей. Sliding window counter это компромисс: окно бьется на мелкие сегменты и агрегируется, точность чуть ниже лога, зато нагрузка на Redis намного легче.
| Алгоритм | Как работает | Плюс для AI-сервиса | Минус |
|---|---|---|---|
| Token bucket | Бак наполняется токенами, запрос списывает вес | Точно мапится на реальный расход токенов LLM | Логика пополнения чуть сложнее в распределенной системе |
| Fixed window | Счетчик в жестком окне (например, минута) | Проще всего реализовать | Двойной всплеск на границе окна |
| Sliding window log | Таймстемп каждого запроса | Максимальная точность | Дорого по памяти на большом трафике |
| Sliding window counter | Окно бьется на сегменты и агрегируется | Баланс точности и нагрузки | Чуть менее точен, чем log |
| Leaky bucket | Запросы "вытекают" с постоянной скоростью | Ровный, предсказуемый трафик | Плохо переносит легитимные всплески |
Для хобби-проекта с редким трафиком fixed window закроет вопрос за 10 строк кода. Для продакшн AI-сервиса с платящими пользователями token bucket остается стандартом, потому что позволяет разово потратить больше токенов на длинный запрос, а не резать всех под одну гребенку.
Как построить rate limit на Redis для AI-сервиса?
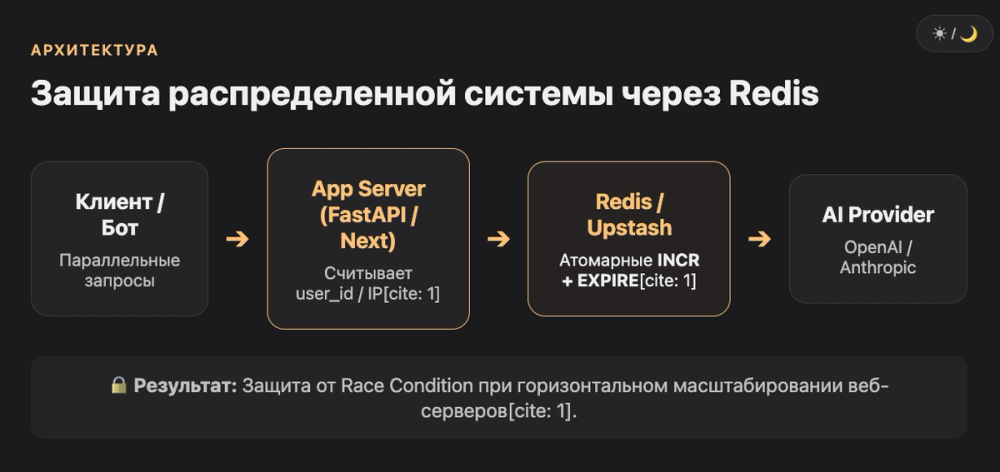
Redis дает атомарные операции INCR и EXPIRE, поэтому рейт-лимитер на нем не ловит race condition даже при параллельных запросах с разных серверов. Готовые SDK вроде @upstash/ratelimit уже включают token bucket из коробки.
Redis стал стандартом для рейт-лимитеров не случайно. Атомарные операции, Lua-скрипты и персистентность данных дают то, что нужно для распределенной системы: несколько инстансов вашего AI-сервиса видят один и тот же счетчик без гонок. GitHub, например, перешел на Redis-бэкенд с клиентским шардингом именно для того, чтобы выдерживать распределенный трафик без потери консистентности.
Вот минимальный пример на FastAPI с библиотекой slowapi, которая под капотом использует тот же принцип, что и Redis-счетчики:
from fastapi import FastAPI, Request
from slowapi import Limiter
from slowapi.util import get_remote_address
from slowapi.errors import RateLimitExceeded
from fastapi.responses import JSONResponse

app = FastAPI()
limiter = Limiter(key_func=get_remote_address)
app.state.limiter = limiter

@app.exception_handler(RateLimitExceeded)
async def rate_limit_handler(request: Request, exc: RateLimitExceeded):
    return JSONResponse(status_code=429, content={"detail": "Too many requests"})

@app.post("/ai/generate")
@limiter.limit("5/minute")
async def generate(request: Request):
    return {"message": "ok"}
Пять запросов в минуту с одного IP, шестой сразу получает 429. Для Next.js-приложений на Vercel чаще берут @upstash/ratelimit, у которого token bucket, sliding window и fixed window уже реализованы как готовые примитивы, без ручной работы с Lua-скриптами.
import { Ratelimit } from "@upstash/ratelimit";
import { Redis } from "@upstash/redis";

const ratelimit = new Ratelimit({
  redis: Redis.fromEnv(),
  limiter: Ratelimit.tokenBucket(20, "1 h", 20),
  analytics: true,
});

const { success, remaining, reset } = await ratelimit.limit(userId);
if (!success) {
  return new Response("Rate limit exceeded", { status: 429 });
}
Идентификатором чаще берут IP через get_remote_address, если авторизации нет, или user_id из сессии, если пользователь залогинен. Второй вариант точнее: один человек с двух устройств не должен получать двойной лимит, а бот за NAT-провайдером не должен прятаться за общим IP тысячи легитимных людей.
Per-user или global лимит: что реально защищает кошелек?
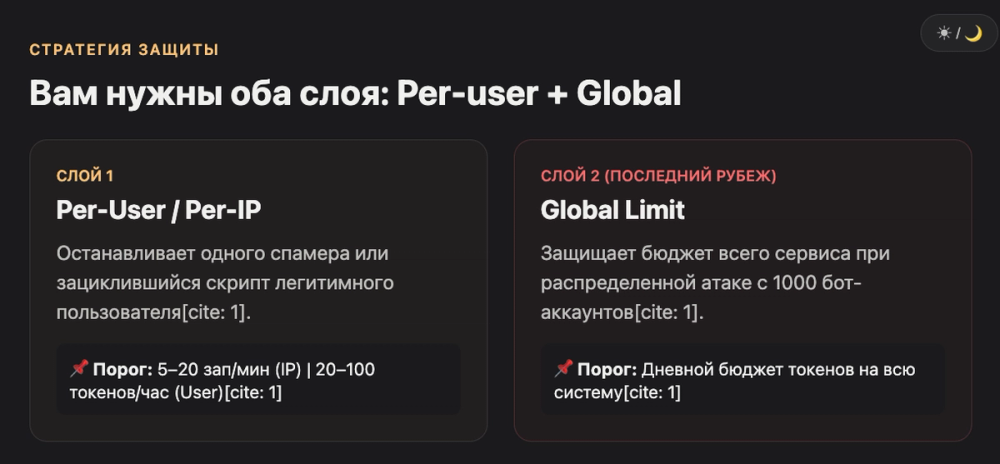
Per-user лимит останавливает одного злоупотребляющего пользователя, а global лимит защищает весь бюджет сервиса, если атака размазана по тысяче аккаунтов. В продакшене нужны оба слоя одновременно.
Один per-user лимит не спасает от распределенной атаки: если у злоумышленника тысяча фейковых аккаунтов, каждый под лимитом, суммарная нагрузка на кошелек все равно взлетает. Global лимит на весь сервис работает как последний рубеж: даже если тысяча пользователей легитимны, но AI-провайдер поднял цены или трафик неожиданно вырос, общий потолок трат не даст счету выйти из-под контроля.
Хорошая практика, найденная в туториалах по защите AI-эндпоинтов, это оценка веса запроса в токенах до вызова модели, а не после. Параметр max_completion_tokens в запросе к AI-провайдеру ограничивает длину ответа сверху, а размер входного текста оценивается заранее, грубо по количеству символов или слов. Считать нужно и входящие, и исходящие токены, потому что провайдер берет деньги за оба направления.
| Уровень лимита | Что защищает | Типичный порог | Идентификатор |
|---|---|---|---|
| Per-IP | Незалогиненный трафик, боты | 5-20 запросов/мин | IP-адрес |
| Per-user | Конкретный аккаунт от abuse | 20-100 токенов/час | user_id или session_id |
| Global | Весь сервис от массовой атаки | Дневной бюджет в токенах | нет, считается по всему трафику |
Передача user_id или session_id в сам запрос к AI-провайдеру, отдельно от вашего внутреннего рейт-лимита, тоже помогает: OpenAI и Anthropic используют этот параметр, чтобы находить злоупотребления на своей стороне и не банить весь ваш API-ключ за поведение одного нарушителя.
Что если к AI-сервису обращается не человек, а агент?
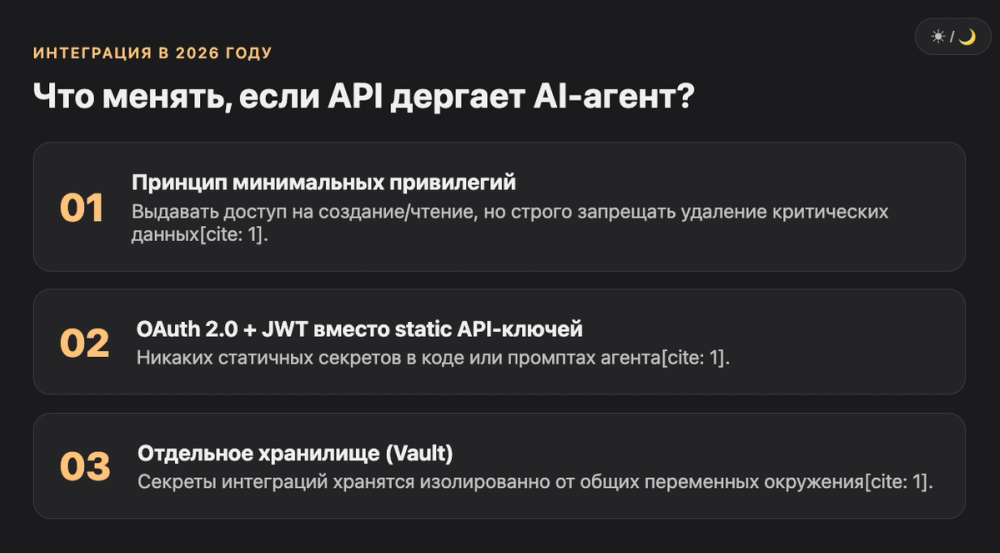
Если ваш API дергает не браузер, а AI-агент через MCP или другой инструмент, обычного per-user лимита мало. Агенту стоит выдавать урезанные права: например, доступ на создание и редактирование записей, но не на удаление, и обязательно OAuth 2 с JWT-токеном вместо статичного API-ключа в коде. Секреты для таких интеграций лучше хранить в отдельном vault, а не в переменных окружения общего доступа.
Если вы собираете такую агентную интеграцию через Claude Code или Cursor, закладывайте рейт-лимит и разграничение прав сразу в архитектуру, а не добавляйте постфактум после первого инцидента.
Сколько стоит rate limiting на Redis в 2026 году?
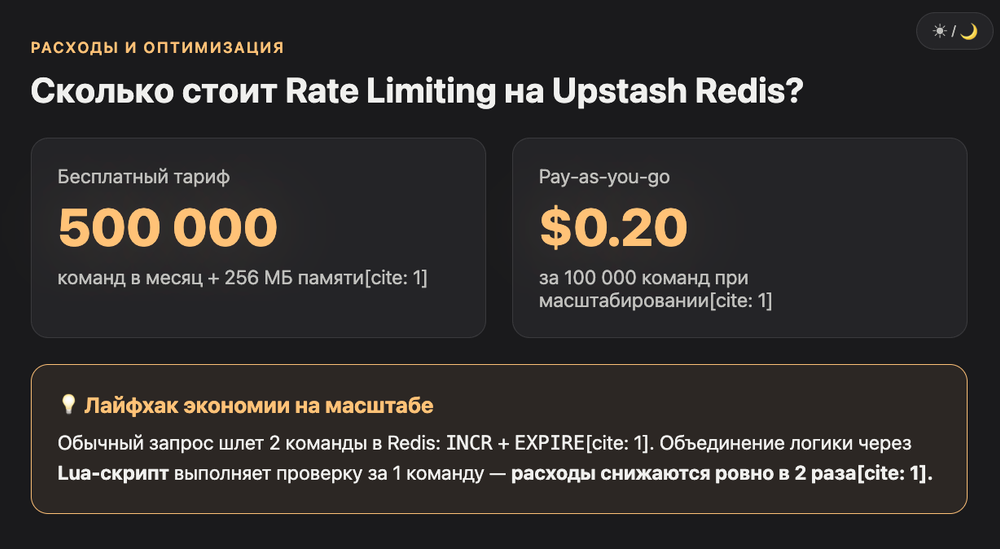
Upstash Redis остается самым дешевым стартом для рейт-лимита: бесплатный тариф закрывает 500 000 команд в месяц, дальше тариф pay-as-you-go по $0.20 за 100 000 команд.
Один запрос к API обычно тратит две Redis-команды: INCR и EXPIRE. При 10 000 активных пользователей и 500 запросах в день на человека набегает около 10 миллионов команд в сутки, это уже выход за бесплатный тариф. По данным Upstash, free-тариф в 2026 году дает 500 000 команд и 256 МБ памяти без карты, а фиксированные планы стартуют от $10 в месяц за 250 МБ без метринга по командам.
Для небольшого AI-сервиса на старте бесплатного тарифа хватает надолго. Проблема начинается на масштабе: SaaS с несколькими тысячами активных пользователей в сутки легко упирается в счет за рейт-лимитинг размером в сотни долларов, если считать наивно INCR плюс EXPIRE на каждый чих. Решение простое: батчить проверки лимита через Lua-скрипт в одну команду вместо двух, это сразу режет расход пополам.
| Тариф Upstash | Лимит | Цена |
|---|---|---|
| Free | 500 000 команд/мес, 256 МБ | $0 |
| Pay-as-you-go | без потолка | $0.20 за 100 000 команд + $0.25/ГБ |
| Fixed от 250 МБ | без метринга команд | от $10/мес |
| Fixed до 500 ГБ | без метринга команд | до $1 500/мес |
Для сравнения, экономия на дешевой модели тоже часть защиты кошелька. Claude Haiku 4.5 стоит $1 за миллион входных и $5 за миллион выходных токенов, а DeepSeek V3.2 еще дешевле, около $0.28 и $0.42. Если основная часть запросов не требует топовой модели, разумный лимит плюс маршрутизация на бюджетную модель экономят сильнее, чем любая оптимизация Redis-команд.
Что делать кроме rate limiting для полной защиты от abuse?
Rate limit закрывает только часть периметра. Дополнительно нужны защита от SQL-инъекций и XSS, детект ботов и фильтр чувствительных данных в промптах.
Rate limiting логично комбинировать с общей защитой API, потому что дорогой AI-эндпоинт привлекает не только спамеров, но и обычные атаки вроде SQL-инъекций и XSS. Инструменты класса Arcjet объединяют рейт-лимит на базе token bucket с WAF-щитом, детектом ботов и проверкой на утечку персональных данных прямо в middleware, без развертывания собственного Redis-кластера под капотом.
Отдельная головная боль, это боты, которые изображают живых пользователей и обходят наивную защиту по User-Agent. По документации Arcjet о защите от ботов, для AI-приложений это особенно критично: автоматический клиент, эксплуатирующий бесплатный тариф, наносит прямой финансовый ущерб, а не просто мусорит трафик.
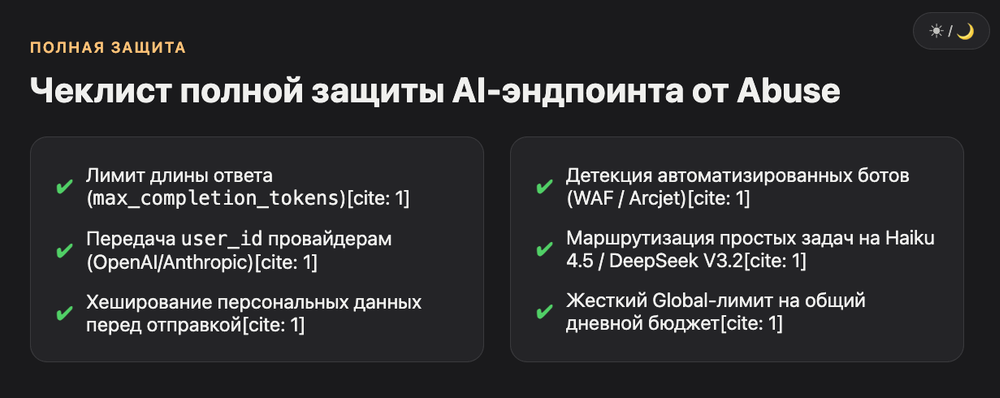
Практичный чеклист для AI-эндпоинта: ограничить длину ответа через max_completion_tokens, передавать user_id провайдеру, хешировать email и телефон перед отправкой в промпт, включить детект ботов и держать отдельный global-лимит на дневной бюджет. Ни один из пунктов не заменяет остальные, работает только сумма.
Частые вопросы про rate limit для AI-сервиса
Какой rate limit ставить для бесплатного тарифа AI-сервиса? Обычно 5-20 запросов в минуту на IP плюс дневной лимит в токенах на пользователя. Точная цифра зависит от стоимости вашей модели и маржи на бесплатном тарифе.
Что вернуть пользователю при превышении лимита? HTTP-статус 429 с телом ответа, где указано время до сброса лимита. Хорошая практика, показывать это в UI, а не просто ронять запрос молча.
Нужен ли rate limit, если у меня уже есть авторизация? Да. Авторизация не спасает от скомпрометированного аккаунта, зацикленного скрипта или пользователя, который случайно отправляет запросы в цикле без задержки.
Чем per-user лимит отличается от global? Per-user останавливает одного нарушителя. Global защищает весь бюджет сервиса, если атака размазана по множеству аккаунтов или трафик вырос легитимно, но резко.
Можно ли обойтись без Redis? Для одного сервера in-memory счетчик подойдет, но при масштабировании на несколько инстансов без общего хранилища лимиты начнут расползаться и переставать работать корректно.
Как оценить лимит в токенах, если ответ модели заранее неизвестен? Считайте примерную длину входа и ставьте жесткий потолок через max_completion_tokens на выход. Точную оценку выхода без вызова модели все равно не получить, поэтому лимит всегда с запасом.
Стоит ли использовать готовый сервис вроде Arcjet вместо своего Redis-лимитера? Если нужен рейт-лимит плюс защита от ботов и утечки данных без отдельной инфраструктуры, готовое решение экономит время. Свой Redis-лимитер оправдан, когда логика лимитов нестандартная или объем трафика делает готовые тарифы дороже собственного сервера.
Если строите AI-сервис с нуля и не уверены, каким инструментом писать бэкенд, посмотрите каталог AI-инструментов на VibeCoderz. Там же собраны обзоры Cursor и Claude Code для тех, кто вайбкодит такие API самостоятельно.
Для devops-задач вроде настройки инфраструктуры и мониторинга rate limit в проде можно опереться на готовые промпты в каталоге AI-агентов.
Если нужен разбор конкретно вашей архитектуры и расчет лимитов под реальный бюджет, запишитесь на консультацию к Максиму.
Обновлено: октябрь 2026.