
Почти любая рабочая мультиагентная система, которую вы встретите в 2026 году, собрана из трёх ролей: планировщик, исполнитель и ревьюер. Планировщик разбивает задачу на шаги, исполнитель делает конкретную работу, ревьюер проверяет результат независимым взглядом. В статье разберем, что делает каждая роль, как настроить системный промпт под неё и как это выглядит на сквозном примере с фичей.
Три роли AI-агентов - планировщик, исполнитель, ревьюер - закрывают три разные функции: декомпозицию, выполнение и контроль качества. Разделение ролей снижает число ошибок и делает систему предсказуемее одного большого промпта. Дальше - конкретные формулировки для системного промпта каждой роли.
Зачем вообще разделять роли, если можно дать всё одной модели?
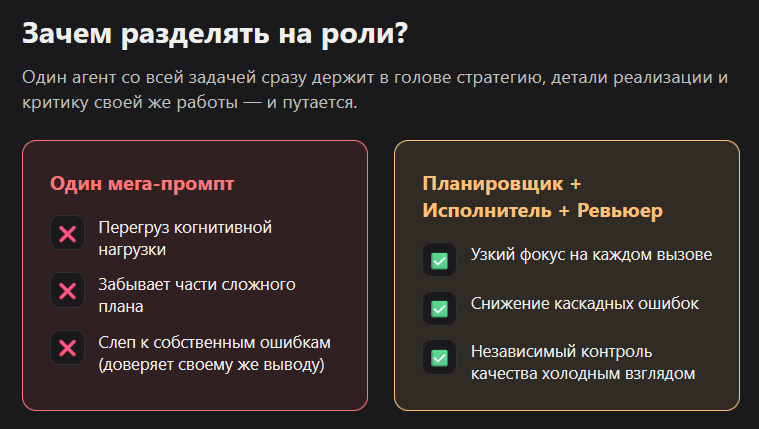
Один агент со всей задачей сразу держит в голове стратегию, детали реализации и критику своей же работы - и путается. Разделение на роли снижает когнитивную нагрузку на каждый вызов модели и уменьшает число каскадных ошибок.
Один сплошной промпт заставляет модель одновременно планировать, писать код и оценивать качество своей же работы. Это работает на простых задачах. На сложных начинаются проблемы: модель забывает часть плана, теряет фокус на середине выполнения, а собственную ошибку не замечает, потому что только что сама её сделала.
Индустрия к 2026 году сходится к одному и тому же выводу. Систематический обзор архитектур agentic-систем в разработке ПО отмечает, что специализация ролей по схеме планировщик-исполнитель-ревьюер стала доминирующим архитектурным паттерном, где ревьюер обеспечивает проверяемость через исполняемые обратные связи. Разные команды называют роли по-разному, критик, ревьюер, судья, но смысл один: отделить того, кто решает, от того, кто делает, и от того, кто проверяет.
Максим: «У Нейроскрайба ждали от разработчика неделю-две-три. У Нейроштата целая команда работала - ждали целую фичу месяцами. Получили - и разочаровались, потому что время реализации критично.»
Это тот самый сценарий, где роли в AI-агентах решают проблему в разы быстрее, чем команда людей: планировщик и исполнитель проходят цикл за минуты, а не месяцы, если система настроена правильно.
Что делает планировщик и почему он не выполняет работу сам?
Планировщик декомпозирует исходную задачу на конкретные шаги до того, как к делу приступят остальные агенты. Он не пишет код и не создаёт контент, а определяет, что и в каком порядке нужно сделать. Ошибка на этом этапе тянется через всю систему.
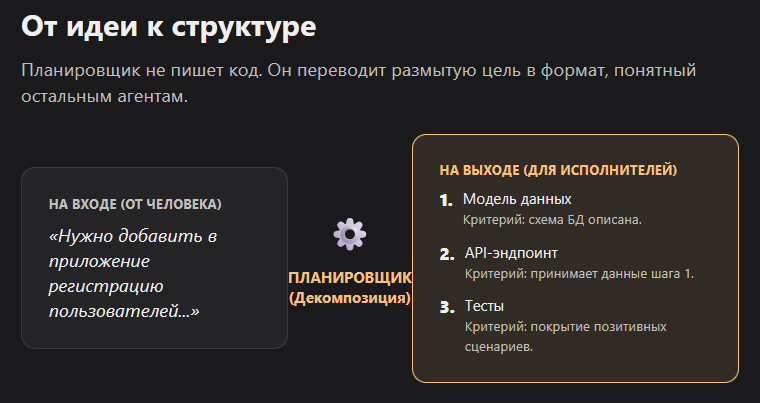
Планировщик получает от человека расплывчатую цель и превращает её в структурированный план. Один из обзоров паттернов 2026 года описывает эту роль так: планировщик переводит размытую цель в структурированный план, определяет критерии приёмки, распределяет работу и расставляет контрольные точки.
Ключевая ошибка новичков - просить у планировщика свободный текстовый план. Модель выдаёт красивое, но неструктурированное описание, которое дальше некому передать программно. Правильный формат вывода - пронумерованный список шагов, каждый с чёткой границей: что считается выполненным этим конкретным шагом.
Есть и второй режим работы планировщика: он может пересматривать план на лету, если исполнение конкретного шага провалилось. Планировщик определяет ход действий и адаптирует его, а исполнители выполняют конкретные шаги, возвращая результаты для мониторинга, контроля и повторного планирования. Без этой обратной связи система просто упрямо доводит до конца план, который устарел ещё на втором шаге.
Что делает исполнитель и почему у него нет доступа ко всему плану?
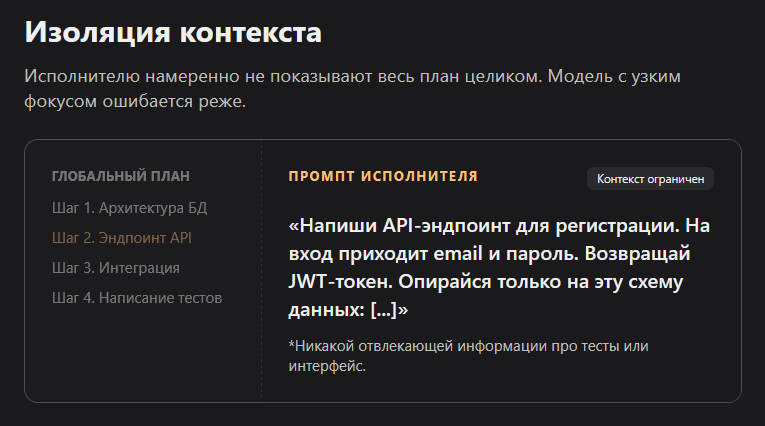
Исполнитель выполняет один конкретный шаг плана и генерирует итоговый результат: код, текст, данные. Ему намеренно не показывают весь план целиком, чтобы не отвлекать от узкой текущей задачи.
На исполнителя приходится основной объём вычислений. Именно эта роль пишет функцию, собирает отчёт или формирует ответ пользователю. Часто исполнитель разбивается на нескольких параллельных копий, если шаги плана независимы друг от друга.
Академическое исследование архитектур верификации формулирует это ограничение прямо: исполнитель решает свою подзадачу на основе инструкций от планировщика и не имеет доступа к исходной глобальной задаче, что ограничивает область его рассуждений и снижает сложность. Звучит как лишение контекста, а на практике - защита от отвлечения. Модель, которая держит в фокусе только «напиши эндпоинт для регистрации», ошибается реже той, что параллельно думает про архитектуру всей фичи.
В Claude Code эта роль реализуется через субагентов - изолированных помощников с собственным контекстом, которые не тащат за собой историю переписки основного диалога. Изоляция контекста здесь работает как раз на предотвращение влияния предыдущих взаимодействий на текущий узкий шаг.
Зачем нужен ревьюер, если исполнитель и так проверяет свою работу?
Ревьюер независимо проверяет результат исполнителя на соответствие плану и отсутствие ошибок. Ценность роли - именно в независимости взгляда: модель, которая не писала код, замечает больше проблем, чем та же модель, только что его написавшая.
Здесь работает конкретное когнитивное искажение генеративных моделей: они склонны доверять собственному только что сгенерированному выводу. Свежая модель без этого контекста смотрит на результат холодно, без привязанности к своему же решению.
Разработчики паттернов 2026 года прямо предупреждают о слабом месте этого подхода: схема ломается, если критикующий агент использует те же слепые пятна, что и генератор - ревьюер, обученный на похожих предположениях, не поймает те же самые ошибки. Поэтому для ревью стоит брать другую модель или хотя бы менять системный промпт настолько сильно, чтобы роль реально ощущалась как чужой взгляд, а не тот же голос в другой шляпе.
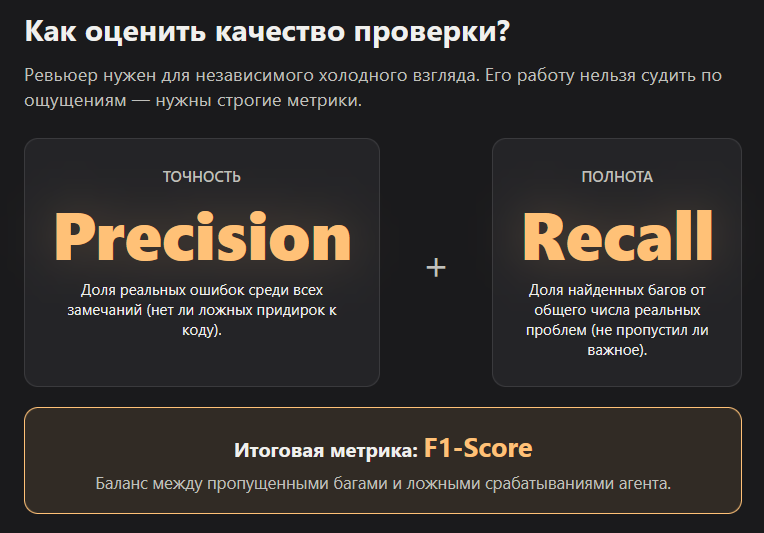
Практическая деталь: судить работу ревьюера тоже нужно метриками, а не ощущением. Для критикующих агентов подходят Precision, Recall и их комбинация - F1-score: сколько реальных проблем ревьюер поймал и сколько ложных срабатываний он выдал сверху. Без этих метрик легко получить ревьюера, который либо пропускает баги, либо заваливает придирками рабочий код.
Как настроить системный промпт под каждую роль?
Три роли требуют трёх принципиально разных промптов. Общая ошибка - написать один универсальный «промпт для агента» и просто менять пару слов. Это не работает: у ролей разные задачи, разный объём контекста и разные требования к формату вывода.
Как сформулировать промпт для планировщика?
Планировщику нужно явно требовать структурированный вывод: пронумерованный список шагов с полями «что сделать», «критерий готовности», «зависимости от других шагов». Свободное текстовое описание плана - главная причина, почему систему потом невозможно автоматизировать: программно передать исполнителям нечего.
Полезно добавить в промпт инструкцию декомпозировать задачу до уровня, на котором каждый шаг можно поручить одному исполнителю без дополнительных уточнений. Если шаг звучит расплывчато - «улучшить производительность» - планировщик обязан раздробить его дальше, до конкретного действия.
Как сформулировать промпт для исполнителя?
Исполнителю в промпт передаётся только его конкретный шаг, без остального плана и без истории обсуждения фичи в целом. Формулировка должна быть узкой и однозначной: что сделать, какие есть ограничения, что считается результатом.
Здесь же уместна логика из практики построения AI-навыков: если шаг хрупкий и должен выполняться идеально одинаково каждый раз, например расчёт в отчёте, доверять его свободной генерации модели рискованно. Такие шаги стоит закрывать не инструкцией для LLM, а детерминированным скриптом, который модель просто вызывает. Скрипт не тратит контекстное окно и даёт одинаковый результат при каждом запуске, в отличие от импровизации модели.
Как сформулировать промпт для ревьюера?
Ревьюеру нужен явный чек-лист критериев проверки, а не общая просьба «проверь на ошибки». Общая формулировка даёт непредсказуемый и неполный результат: модель проверяет то, что первым пришло в голову, и может пропустить то, что критично именно для вашей задачи.
Чек-лист стоит формулировать в терминах исходного плана: «соответствует ли результат шагу N плана», «есть ли краевые случаи, не учтённые в задаче», «нарушены ли явные ограничения из промпта планировщика». Такой формат превращает ревью в воспроизводимую процедуру, а не в вольную оценку.
Как выглядят три роли на сквозном примере с фичей?
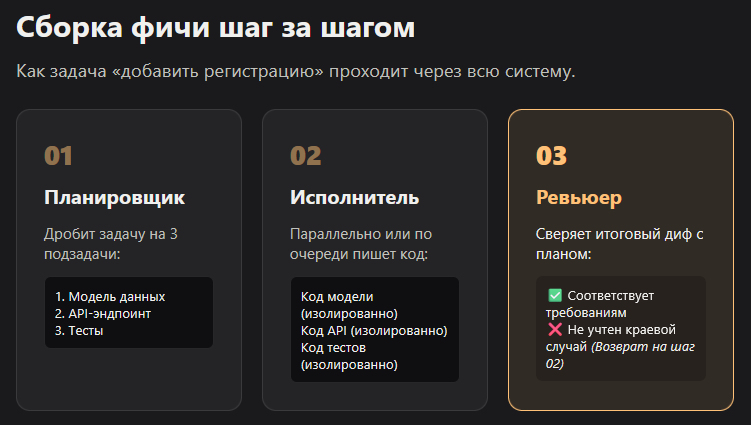
На практике задача «написать фичу» проходит через все три роли последовательно: планировщик дробит её на подзадачи, исполнитель пишет каждую часть, ревьюер сверяет итог с исходным планом до показа человеку.
Возьмём типовую задачу: добавить в приложение регистрацию пользователя. Планировщик получает эту цель и превращает её в три подзадачи: создать модель данных пользователя, написать API-эндпоинт регистрации, написать тесты на оба предыдущих шага. Каждая подзадача получает критерий готовности.
Исполнитель берёт первую подзадачу, модель данных, и пишет код, не зная деталей будущего эндпоинта - ему это и не нужно на этом шаге. Затем такой же изолированный вызов исполнителя пишет эндпоинт, опираясь только на готовую модель данных и описание задачи. Третий вызов пишет тесты.
Ревьюер получает итоговый диф и исходный план целиком, без истории о том, как каждый шаг создавался. Он сверяет: модель данных соответствует требованиям, эндпоинт использует эту модель верно, тесты покрывают заявленные сценарии. Если находит расхождение - возвращает конкретный шаг на доработку, а не всю задачу заново.
В Claude Code этот цикл собирается через субагентов и скиллы: скилл описывает процедуру ревью кода как повторяемый навык, субагент-ревьюер запускается в изолированном контексте, а хуки автоматически шлют уведомление в Telegram, когда система решила, что нужно вмешательство человека.
Сколько стоит держать мультиагентную систему и как снизить расходы?
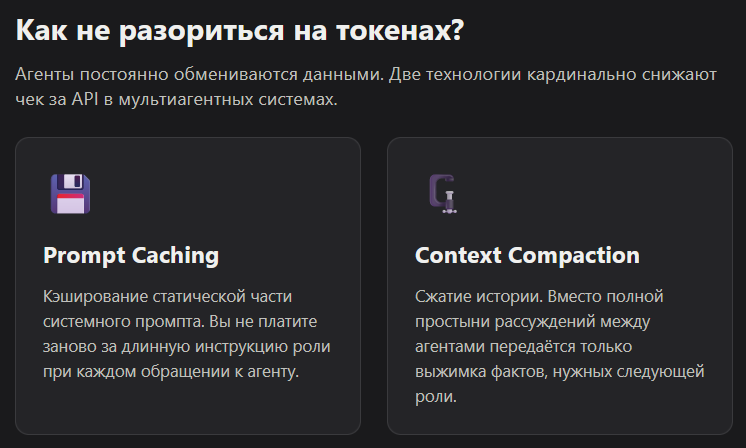
Стоимость мультиагентных систем обычно недооценивают: агенты постоянно обмениваются данными и повторно пересылают части промптов друг другу. Две техники снижают расходы заметнее всего: кэширование промптов и сжатие контекста между агентами.
Каждая передача результата от планировщика к исполнителю и от исполнителя к ревьюеру - это токены, за которые вы платите заново. Если статическая часть системного промпта одна и та же на каждом вызове роли, prompt caching избавляет от повторной оплаты этой статики при каждом обращении.
Context compaction решает вторую проблему - раздутие объёма данных, которые агенты передают друг другу. Вместо полной истории рассуждений между агентами передаётся сжатая выжимка: только то, что реально нужно следующей роли для работы. Комбинация этих двух техник в системах на несколько ролей ощутимо снижает счёт за API без потери качества результата.
Отдельно стоит оценивать систему на двух уровнях: компонентном, насколько хорошо каждая роль справляется со своей узкой задачей, и сквозном, насколько хорош финальный результат всей цепочки. LLM-как-судья и синтетические тестовые стенды позволяют автоматизировать оба вида проверки, не запуская вручную реальную задачу каждый раз при изменении промпта одной из ролей.
Какие ошибки чаще всего мешают связке из трёх ролей работать?
Первая типичная ошибка - слишком длинный промпт исполнителя, куда по инерции скопировали весь план целиком. Исполнитель начинает держать в голове чужие шаги вместо своего и путается. Оставляйте только то, что нужно для конкретной подзадачи.
Вторая ошибка - ревьюер той же модели с тем же системным промптом, что и у планировщика. Формально роль отдельная, а по сути это одна и та же точка зрения, которая не увидит собственные слепые пятна.
Третья ошибка - отсутствие детерминированных скриптов там, где они реально нужны. Если шаг требует точного и повторяемого результата, расчёт, форматирование, валидация, доверять его модели каждый раз заново - лишний риск и лишние токены.
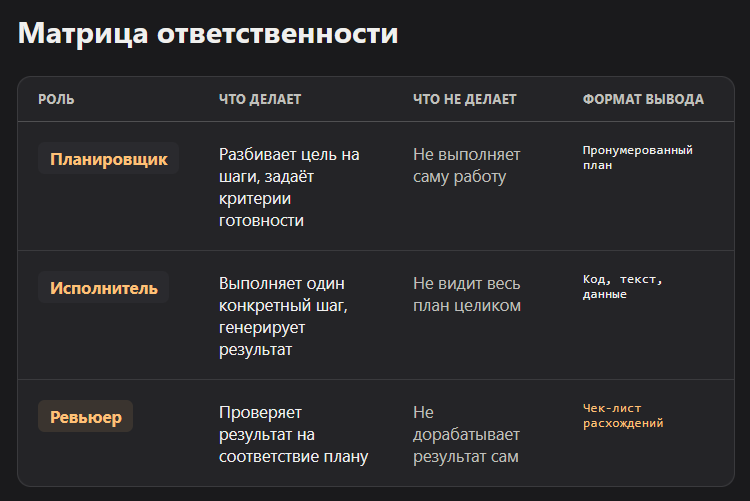
Таблица: три роли AI-агентов и их зона ответственности
| Роль | Что делает | Что не делает | Формат вывода |
|---|---|---|---|
| Планировщик | Разбивает цель на шаги, задаёт критерии готовности | Не выполняет саму работу | Пронумерованный структурированный план |
| Исполнитель | Выполняет один конкретный шаг, генерирует результат | Не видит весь план целиком | Код, текст или данные по узкому шагу |
| Ревьюер | Проверяет результат на соответствие плану | Не дорабатывает результат сам | Чек-лист с конкретными расхождениями |
FAQ: частые вопросы про роли AI-агентов
Можно ли обойтись без ревьюера, если исполнитель хорошо справляется?
Можно, но риск растёт вместе со сложностью задачи. На простых, коротких шагах ревью иногда избыточно. На фичах с несколькими зависимыми шагами независимая проверка почти всегда окупает лишний вызов модели.
Обязательно ли использовать три разные модели для трёх ролей?
Нет, но для ревьюера рекомендуется хотя бы сильно отличающийся системный промпт от промпта исполнителя. Разная модель даёт более независимый взгляд, но это вопрос бюджета, а не жёсткое требование.
Что делать, если планировщик регулярно строит план, который не подходит под задачу?
Добавьте в промпт планировщика явные примеры хорошей декомпозиции для похожих задач и требование указывать критерий готовности у каждого шага. Расплывчатые шаги без критерия - главный признак слабого плана.
Как понять, что задача вообще требует трёх ролей, а не одного агента?
Если задачу можно решить одним чётким промптом за один вызов, роли не нужны, это overengineering. Роли оправданы, когда задача многошаговая, шаги зависят друг от друга и цена ошибки высока.
Чем субагенты в Claude Code отличаются от отдельных ролей в самописной системе?
Принцип тот же самый: изоляция контекста и узкая специализация. Субагент в Claude Code технически проще настроить, потому что изоляция контекста и вызов навыков уже встроены в инструмент.
Сколько стоит держать такую систему из трёх ролей в месяц?
Зависит от объёма задач и выбранных моделей, но prompt caching и context compaction обычно снижают счёт заметнее, чем выбор более дешёвой модели для одной из ролей.
Нужен ли ревьюеру доступ ко всей истории диалога с планировщиком?
Нет, и лучше без неё. Ревьюеру нужен только финальный план и финальный результат. История обсуждения только добавляет шума и риск, что ревьюер унаследует те же допущения, что и остальные роли.
Глоссарий
Планировщик - роль AI-агента, которая декомпозирует задачу на шаги до начала выполнения.
Исполнитель - роль AI-агента, выполняющая один конкретный шаг плана.
Ревьюер - роль AI-агента, независимо проверяющая результат на соответствие плану.
Субагент - изолированный AI-помощник с собственным контекстом, не связанный с историей основного диалога.
Context compaction - сжатие данных, которыми обмениваются агенты, до минимально необходимого объёма.
Prompt caching - кэширование статической части системного промпта, чтобы не оплачивать её повторно при каждом вызове.
MCP (Model Context Protocol) - протокол, через который модель подключается к внешним сервисам как к собственным инструментам.
Настроить связку из трёх ролей проще на инструменте, который уже поддерживает субагентов и скиллы из коробки, обзор Claude Code - хороший старт, если ещё не пробовали. Полный каталог AI-инструментов для сборки таких систем - в каталоге VibeCoderz. Если задача сложнее шаблонной и нужна помощь с архитектурой ролей под конкретный проект, запишитесь на консультацию к Максиму.
Обновлено: сентябрь 2026.