Статический анализ кода - это проверка программы на ошибки и уязвимости без её запуска: специальная утилита разбирает исходники, строит из них дерево или граф и ищет в нём подозрительные конструкции. Метод существует больше 20 лет и стоит в одном ряду с code review и тестированием. Разберём, какие методы статического анализа используются на практике, что такое SAST и почему в 2026 году к классическим анализаторам добавились AI-модели, которые понимают не паттерн, а смысл кода.
В статье: классический подход к статическому анализу, разбор SAST, реальные примеры багов и то, что меняется с приходом AI-native инструментов вроде Semgrep Guardian и Snyk Code.
Что такое статический анализ кода простыми словами?
Статический анализ кода - это автоматизированная проверка исходников на ошибки, уязвимости и нарушения стандартов без выполнения программы. Работает как code review, только его делает не человек, а программа.
Формально статический анализ определяют как процесс выявления дефектов, уязвимостей и других проблем в исходном коде без его реального выполнения. Разработчики PVS-Studio сравнивают его с автоматизированным обзором кода: в первом случае эксперт - это человек, во втором - программа, которую тоже обучил человек.
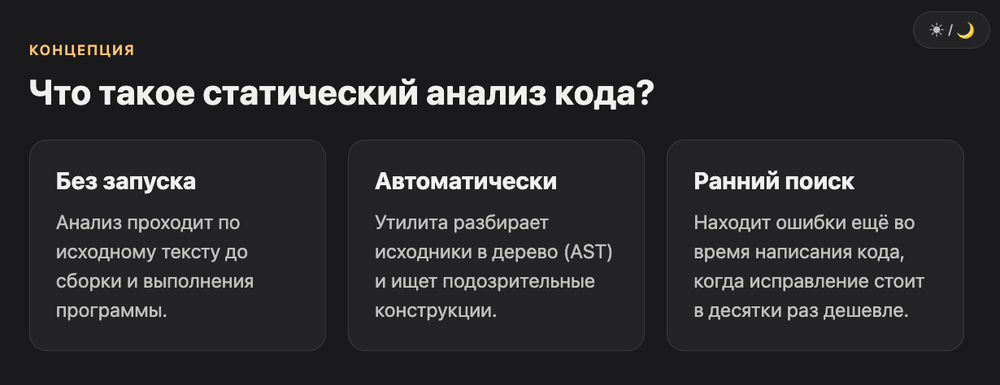
Инструмент читает файлы проекта, строит внутреннее представление кода и прогоняет его через набор правил или диагностик. Находит опечатку, скопированный кусок логики, неинициализированную переменную, потенциальную SQL-инъекцию. Всё это до того, как код попадёт в тестирование или в продакшен, где цена исправления окажется в разы выше.
Чем статический анализ кода отличается от динамического анализа?
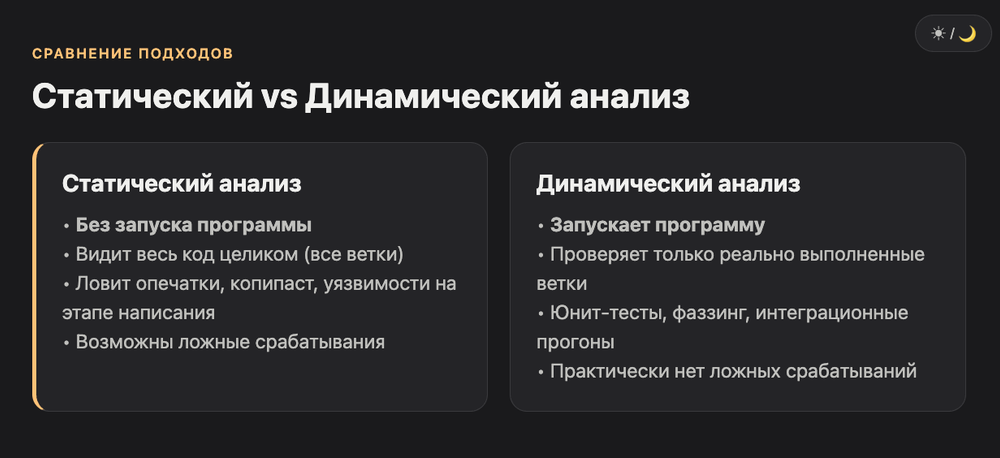
Статический анализ проверяет код без запуска и находит потенциальные проблемы на любом пути выполнения. Динамический анализ запускает программу и смотрит на её реальное поведение, поэтому ловит меньше ложных срабатываний, но не покрывает код, который не выполнился при тесте.
Разница в 40 словах: статический подход видит весь код целиком, включая ветки, которые редко выполняются, а динамический - только то, что реально прогналось во время запуска. Именно поэтому в зрелых проектах используют оба метода параллельно, а не выбирают один.
Разработчики нередко путают статический анализ со статистическим - это совсем разные вещи, хотя термины звучат похоже. Статистический анализ работает с данными и вероятностями, статический - с текстом программы как со структурой.
На практике связка выглядит так: статический анализ ловит дефект ещё на этапе написания кода, а динамический (юнит-тесты, фаззинг, интеграционные прогоны) проверяет, что программа действительно ведёт себя правильно в реальных сценариях. Одна методология никогда не закрывает всё в одиночку - это подтверждают доклады инженеров PVS-Studio и JetBrains на профильных конференциях.
Что такое SAST и откуда он взялся?
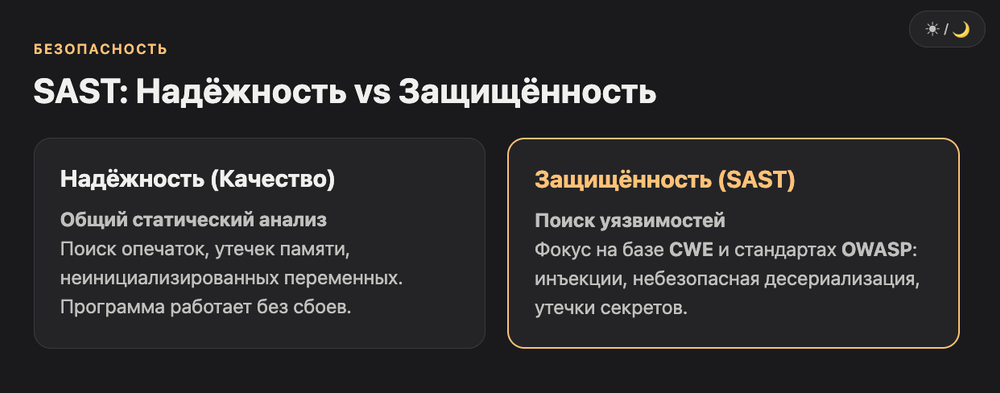
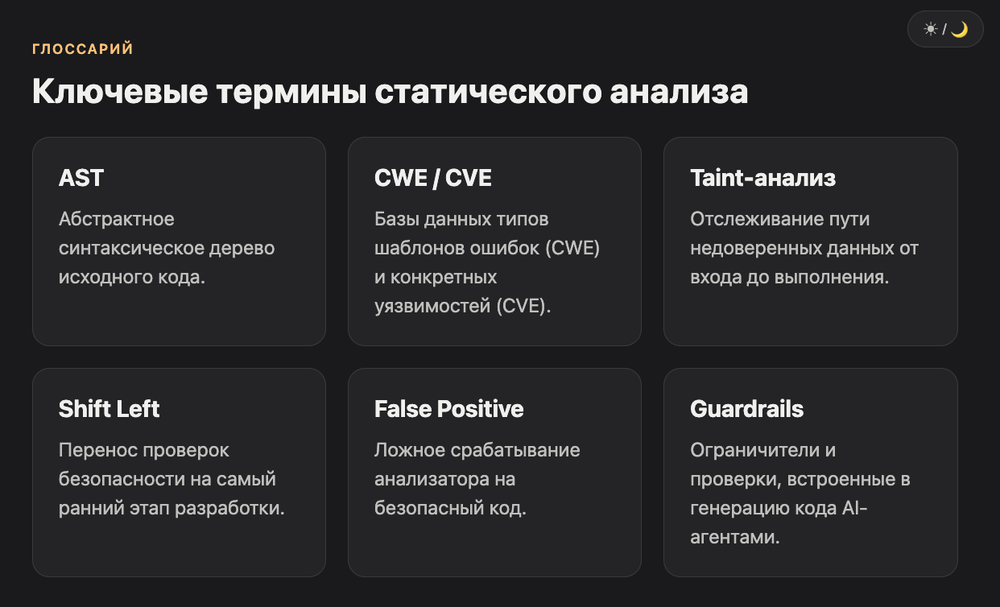
SAST (Static Application Security Testing) - это статический анализ, заточенный именно под поиск уязвимостей, а не под общее качество кода. Проверяет исходники на паттерны, которые открывают дверь для атак: инъекции, небезопасную десериализацию, утечки секретов.
SAST стоит воспринимать как отдельную ветку статического анализа. Если классический анализатор ищет любые дефекты, от опечаток до архитектурных проблем, то SAST-инструмент целится в конкретный класс проблем - уязвимости из базы CWE (Common Weakness Enumeration), каталога типовых шаблонов ошибок безопасности.
Здесь важно различать надёжность и защищённость приложения. Надёжность - это про то, что программа сама по себе работает без сбоев, это ближе к машиностроительным стандартам качества. Защищённость - про устойчивость к внешним атакам, и тут ориентируются на стандарты вроде OWASP. SAST решает вторую задачу: находит паттерны из CWE до того, как они превратятся в реальную уязвимость из базы CVE.
Какие методы статического анализа используются в реальных инструментах?
Современный статический анализатор комбинирует четыре технологии: сопоставление по абстрактному синтаксическому дереву, анализ типов через аннотации, анализ потока данных и символьное выполнение. Каждая закрывает свой класс ошибок и имеет свою цену по производительности.
Ниже - таблица с кратким описанием каждого метода. Она пригодится, если вы выбираете анализатор под конкретную задачу, а не берёте первый попавшийся из топа поисковика.
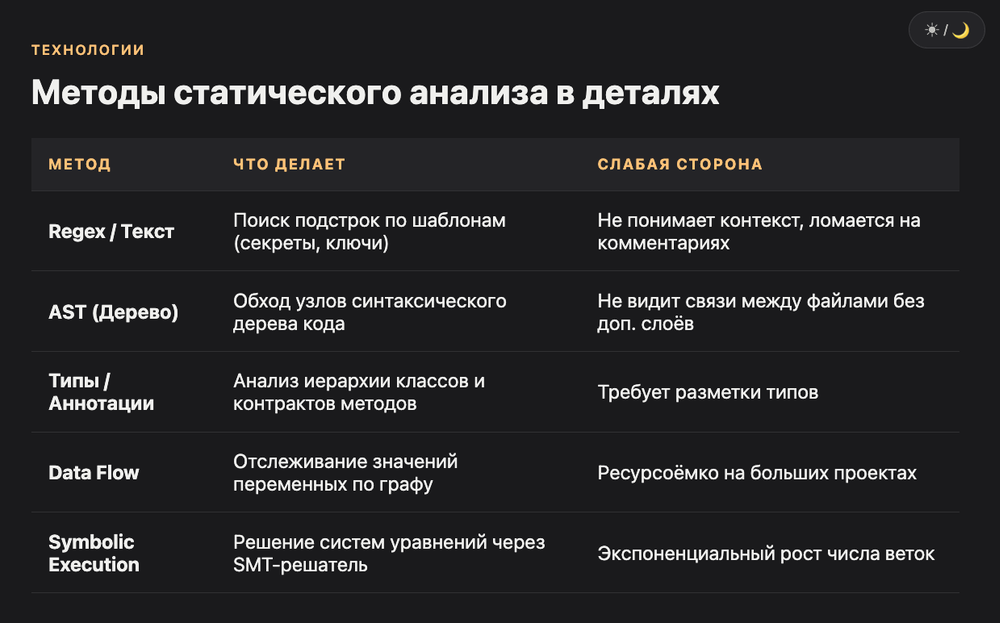
| Метод | Что делает | Хорошо ловит | Слабое место |
|---|---|---|---|
| Regex / текстовый поиск | Ищет подстроки по шаблону | Секреты, токены, ключи в коде | Ломается на комментариях, не понимает контекст |
| AST (синтаксическое дерево) | Строит дерево из кода, обходит узлы | Опечатки, копипаст, неверное использование методов | Не видит связи между файлами без доп. слоёв |
| Типы и аннотации | Знает иерархию классов и контракты методов | Бессмысленные вызовы, несовместимые типы | Требует ручной или автоматической разметки |
| Data flow / поток данных | Отслеживает значения переменных по коду | Разыменование null, выход за границы массива | Дорого по производительности на больших графах |
| Symbolic execution | Решает систему уравнений вместо конкретных значений | Деление на ноль, недостижимый код | Экспоненциальный рост числа веток |
Синтаксические деревья и разметка типов
AST - это база, вокруг которой строится почти любой статический анализатор. Инструмент бегает по узлам дерева и ищет знакомые паттерны: например, сравнение переменной саму с собой в условии, а не с другим значением. Отдельно к дереву добавляют семантическую информацию о типах: анализатор знает, что метод принимает коллекцию одного типа объектов, и подсвечивает бессмысленный вызов, если ему передали объект из другой иерархии.
Data flow и symbolic execution
Data flow-анализ вычисляет диапазон возможных значений переменной в конкретной точке программы. Если анализатор видит условие x > 3, он понимает, что дальше по коду x лежит в диапазоне от 4 до максимума, и на основе этого решает, ругаться на следующую строчку или нет. Symbolic execution идёт дальше: строит систему уравнений из переменных и проверяет её на решаемость через SMT-решатель. Это самый ресурсоёмкий метод: количество путей исполнения растёт экспоненциально с каждым новым условием в коде.
Чем статический анализ лучше и хуже code review?
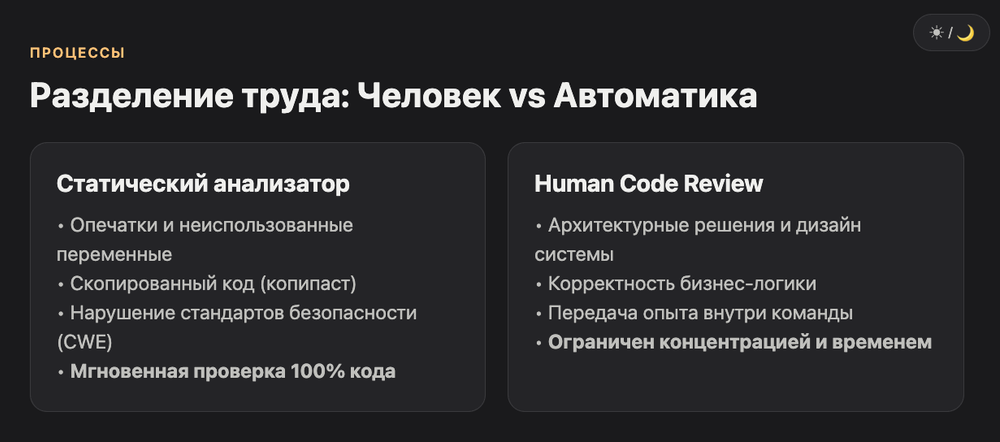
Code review находит ошибки высокого уровня и заодно обучает команду, но отнимает рабочее время нескольких человек. Статический анализ разгружает ревью от рутины вроде копипаста и опечаток, оставляя людям архитектурные вопросы.
У code review масса плюсов: ревьюер ловит логические ошибки, которые не бросаются в глаза, а джуны через процесс перенимают знания о проекте у более опытных коллег. Но у метода есть цена. Ревью одной задачи может занять и 15 минут, и два часа, а уставший рецензент теряет концентрацию и пропускает то, что легко бы заметил на свежую голову.
Статический анализ забирает на себя именно ту часть работы, где человеческое внимание расходуется впустую: опечатки, скопированные куски логики, неверное использование стандартных функций. Ревьюер в итоге тратит время на архитектуру и бизнес-логику, а не на поиск лишней запятой в условии.
Какие реальные баги находит статический анализ?
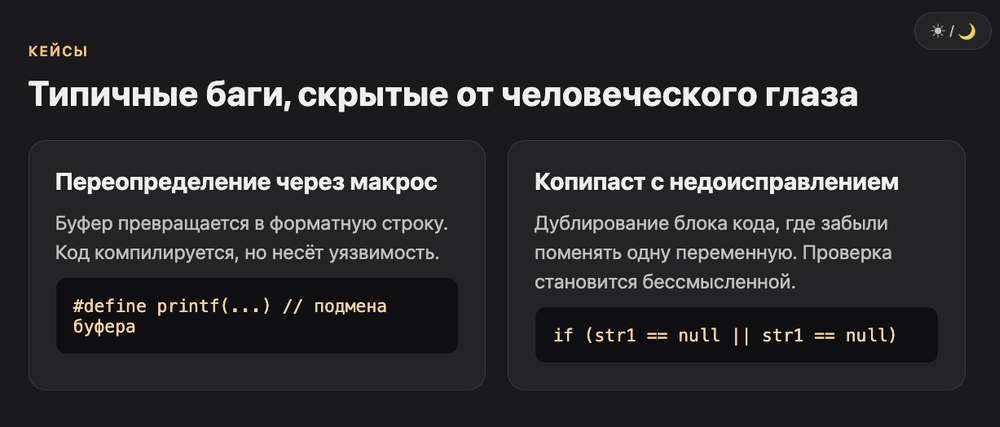
Классические примеры: макрос, который незаметно переопределяет printf и превращает буфер в форматную строку, или функция проверки токена, которая всегда возвращает true из-за неверной сигнатуры. Оба бага компилируются и работают, что и делает их опасными.
В одном реальном кейсе разработчик переопределил стандартную функцию форматированного вывода через макрос. Код компилировался и выглядел правильно, но переменная, которая должна была быть буфером, на деле становилась форматной строкой. Анализатор подсветил использование переменной как неинициализированной, хотя формально она была инициализирована - просто не той сущностью, для которой писался код.
Другой частый паттерн - копипаст с недоисправлением. Разработчик берёт блок кода, дублирует его для похожей переменной и забывает поменять одну ссылку. Один из докладов о PVS-Studio показывает именно такой случай: переменная-строка, которую нужно было заменить при копировании, осталась прежней, и проверка на пустоту стала бессмысленной. Копипаст-ошибки статистически тяжелее всего искать глазами при ревью и легче всего - через сравнение AST-поддеревьев.
Как AI меняет статический анализ кода в 2026 году?
AI-модели не заменяют классический data flow-анализ, а добавляют слой семантического понимания: могут объяснить, почему предупреждение ложное, найти уязвимость в бизнес-логике и предложить готовый фикс. Рынок 2026 года делит инструменты на AI-assisted и AI-native SAST.
По итогам независимого обзора рынка 2026 года лидерами по покрытию и интеграции в рабочий процесс называют Checkmarx One, Semgrep Code и GitHub CodeQL. При этом отмечается: AI-SAST теперь совмещает детерминированный поиск паттернов с семантическими рассуждениями через LLM, и гибридная схема снижает число ложных срабатываний, сохраняя полноту поиска.
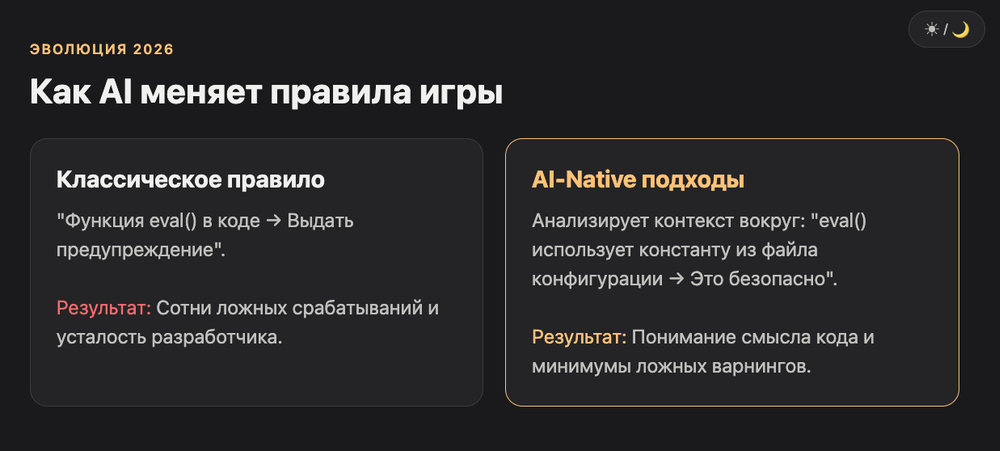
Ключевая разница со старым подходом простая. Классический анализатор знает: "здесь используется функция eval, это опасно". AI-модель способна прочитать пять файлов вокруг вызова, понять, откуда реально приходят данные, и сказать: "eval здесь безопасен, потому что аргумент жёстко зашит в код на предыдущей строке". Это снимает часть той самой усталости от предупреждений, о которой на конференциях годами жаловались разработчики.
Почему код, сгенерированный AI, ломает старые правила SAST?
Формальное исследование 3500 фрагментов кода от семи крупных LLM показало среднюю долю уязвимого кода 55,8%. Классический SAST рассчитан на код человека с понятным автором, а не на поток из десятков коммитов от AI-агента без чёткой авторской ответственности.
Цифра действительно выглядит тревожно, и источник здесь не маркетинговый: формальная верификация через SMT-решатель на 3500 артефактах кода у семи моделей зафиксировала среднюю долю уязвимых ответов 55,8%, у GPT-4o этот показатель доходил до 62,4%, а у самой аккуратной модели из выборки всё равно держался на уровне 48,4%. Даже прямое указание "пиши безопасный код" в промпте снижало долю уязвимостей всего на 4 процентных пункта.
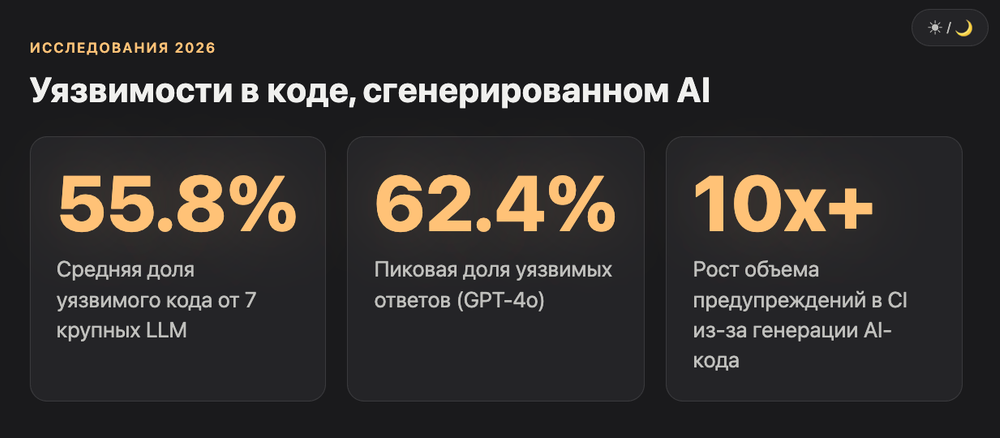
Отдельное исследование по 733 реальным сниппетам из GitHub Copilot, CodeWhisperer и Codeium нашло проблемы безопасности в 29,5% Python-фрагментов и 24,2% JavaScript-фрагментов, суммарно из 43 разных категорий CWE. В командах, где AI активно генерирует код, объём находок статического анализа за месяц вырастает с типичной тысячи предупреждений до десяти тысяч и выше - просто потому что кода стало физически больше, а его происхождение размылось между десятками автогенераций.
Максим: «Мог просто засесть до пяти ночи и просто там править одну какую-то функцию, которая не работала. Если бы не терпение, я бы просто всё это закрыл. Но я понимал, что это можно решить и нужно решить, чтобы идти дальше.»
AI-assisted или AI-native SAST - в чём разница?
AI-assisted SAST оставляет детерминированный движок поиска и добавляет AI только в приоритизацию и объяснение находок. AI-native SAST использует LLM или ML прямо как основной механизм детекции, что расширяет охват, но снижает предсказуемость результата.
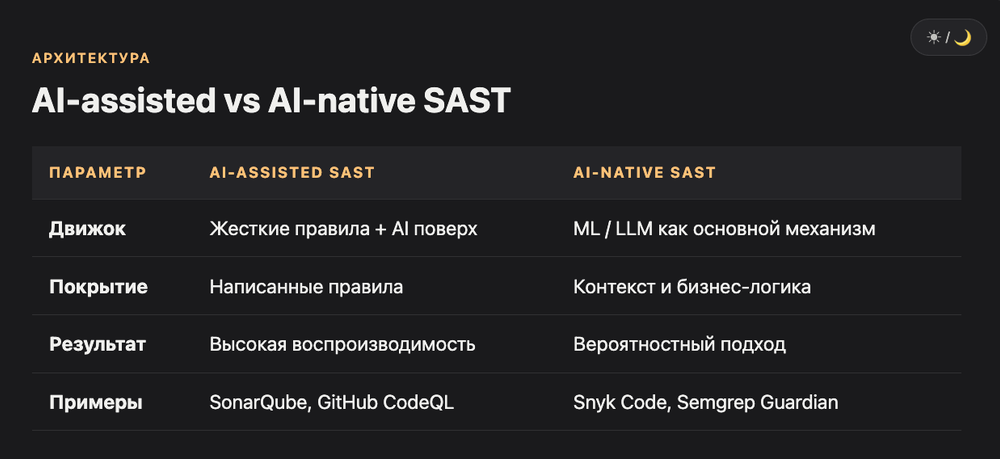
Разница касается не маркетинга, а архитектуры. В AI-assisted схеме (SonarQube, Veracode, GitHub CodeQL) правила остаются жёсткими и написанными людьми, а модель работает уже поверх результата: группирует находки, объясняет их и предлагает патч. В AI-native схеме (например, Snyk Code, обученный на 25+ млн кейсов потока данных) сама модель решает, что считать уязвимостью, опираясь на контекст, а не только на шаблон.
| Параметр | AI-assisted SAST | AI-native SAST |
|---|---|---|
| Механизм детекции | Детерминированные правила | ML или LLM как основной движок |
| Нужен парсер под язык | Да | Обычно нет |
| Покрытие | Ограничено написанными правилами | Расширяется до бизнес-логики |
| Воспроизводимость результата | Высокая, детерминированная | Ниже, есть элемент вероятности |
| Примеры | SonarQube, Checkmarx One, GitHub CodeQL | Snyk Code, Black Duck Signal |
Разработчики Semgrep Guardian прямо говорят: инструмент теперь ищет и чинит уязвимости в коде, который в реальном времени пишут агенты вроде Claude Code, Cursor и Windsurf, прямо в процессе генерации, а не постфактум в CI. Это и есть смещение статического анализа из разряда "проверка перед релизом" в разряд "guardrail внутри самого промптинга".
Какие инструменты статического анализа актуальны в 2026 году?
Для классических проектов на C++/C#/Java хорошо работает PVS-Studio, для мультиязычных open source и security-команд - Semgrep и GitHub CodeQL, для AI-native подхода с автофиксами - Snyk Code и Checkmarx One.
Выбор конкретного инструмента сильно зависит от языка, размера кодовой базы и того, ищете вы баги качества или уязвимости. Ниже - ориентир по актуальным на 2026 год инструментам разных категорий.
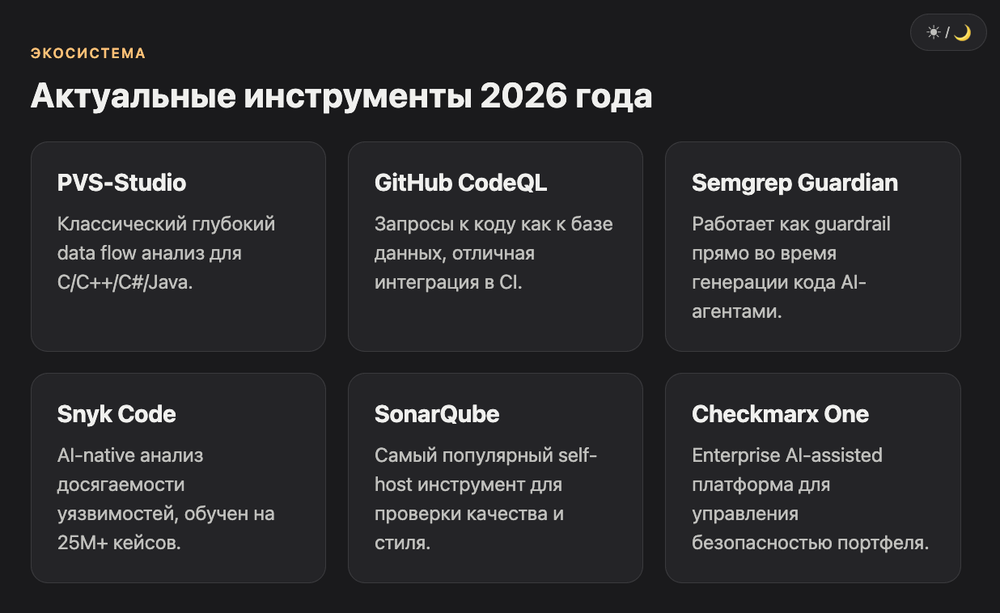
| Инструмент | Тип | Сильная сторона |
|---|---|---|
| PVS-Studio | Классический, C/C++/C#/Java | Глубокий data flow-анализ, десятки лет диагностик |
| GitHub CodeQL | AI-assisted, семантические запросы | Query-язык для собственных правил безопасности |
| Semgrep Code / Guardian | Гибрид, кастомные правила | Быстрая интеграция в CI, работа прямо с AI-агентами |
| Snyk Code | AI-native | Контекстный анализ достижимости уязвимости |
| SonarQube | Классический, бесплатный self-host | Порог входа ниже всего, подходит для старта |
| Checkmarx One | AI-assisted, enterprise | Governance и отчётность на уровне портфеля проектов |
Если вы пишете код с помощью AI IDE, встроенный линтер редактора - это только первый слой защиты. Отдельный обзор Cursor, Claude Code и GitHub Copilot на VibeCoderz показывает, какие из этих инструментов уже умеют подключать внешние SAST-плагины прямо в рабочий цикл, а не только подсвечивать синтаксис.
Как внедрить статический анализ без тысячи предупреждений в первый день?
При первом запуске анализатор на legacy-проекте обычно выдаёт тысячи предупреждений. Правильный путь - подавить существующие через файл разметки одним кликом и анализировать только новый или изменённый код.
Резкое погружение в тысячи старых предупреждений - плохая стратегия: через час-два внимание падает, и всё уходит в долгий ящик. Рабочий подход выглядит иначе: весь текущий список находок отправляется в специальный файл-разметку, который коммитится в систему контроля версий вместе с проектом. С этого момента анализ идёт с нулём предупреждений, а новые находки появляются только на изменённом коде - то есть именно там, где их дешевле всего исправить.
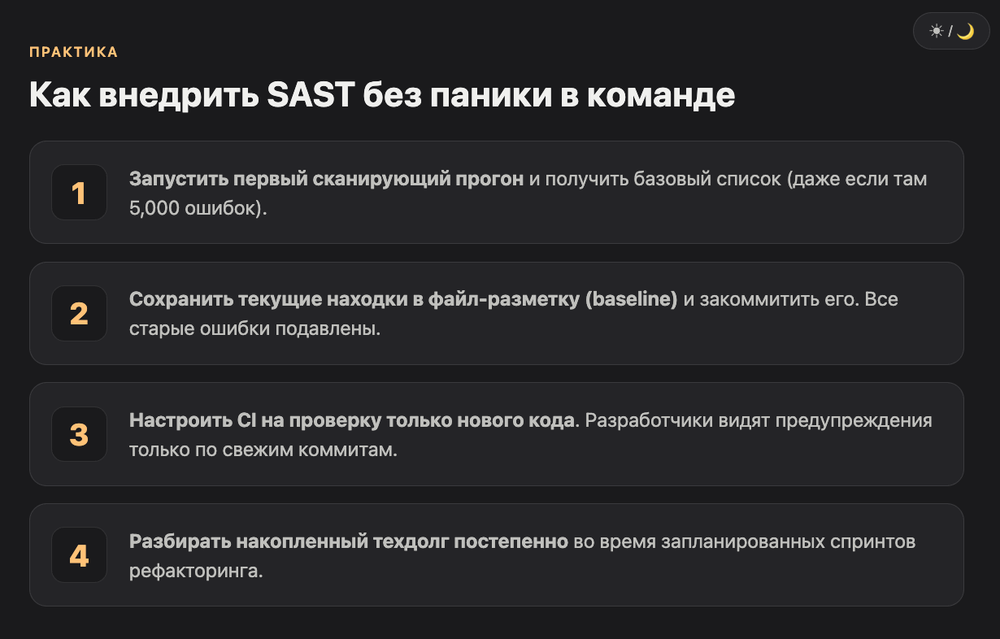
К накопленному техдолгу возвращаются постепенно, отдельным спринтом или по мере рефакторинга модуля. Такой сценарий описывают инженеры из нескольких докладов про внедрение SAST независимо друг от друга - подход стал негласным стандартом индустрии для legacy-кода.
Сильные и слабые стороны статического анализа кода
Статический анализ дёшево масштабируется и находит дефекты до релиза, но не заменяет полноценное ревью и иногда ошибается на запутанном коде. Сила метода - в регулярности запуска, а не в разовой проверке перед сдачей проекта.
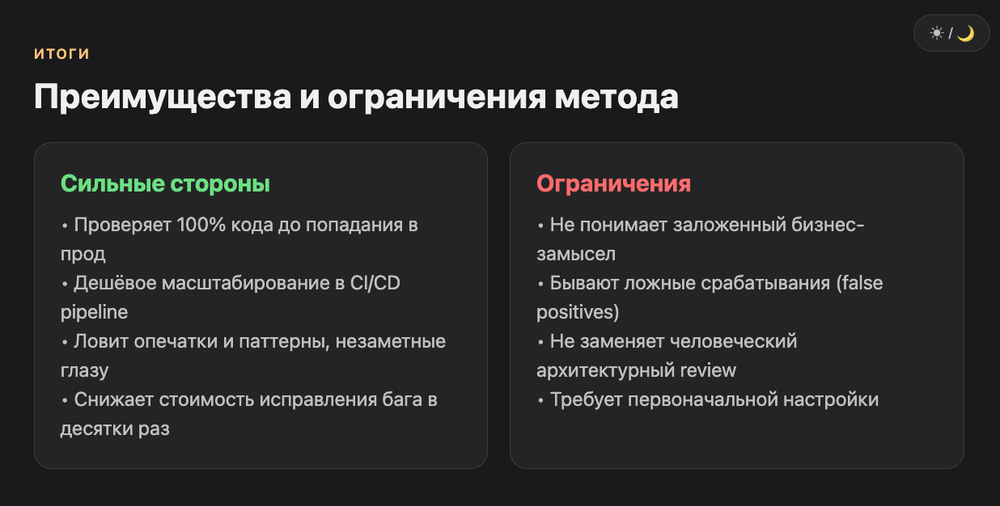
Сильные стороны. Анализатор работает без устали и в любое время, покрывает редко выполняемые ветки кода, которые тестами закрыть неоправданно дорого, и ловит именно те скучные, но опасные баги вроде копипаста или пропущенной проверки, которые человек на ревью видит хуже всего. Стоимость исправления дефекта, найденного на этапе написания кода, в десятки раз ниже, чем у того же бага, пойманного уже после релиза.
Слабые стороны. Высокоуровневые архитектурные ошибки анализатор находит плохо: он видит структуру кода, а не бизнес-замысел. Ложные срабатывания реальны, особенно на запутанном или нестандартном коде, и разбор такого предупреждения тоже стоит времени разработчика. Наконец, статический анализ никогда не заменит полноценный обзор кода человеком - он его дополняет и разгружает.
Стоит ли вайбкодеру разбираться в статическом анализе?
Да, особенно если продукт создаётся быстро и в основном силами AI-агента. Чем меньше кода вы пишете руками, тем важнее хотя бы один автоматический слой контроля перед тем, как фича уйдёт в прод.
VibeCoderz собирал портал за неделю тремя скриптами голосом в Claude Code - скорость впечатляющая, но именно на таких скоростях статический анализ и линтеры в CI становятся не формальностью, а страховкой от банальных дыр. Если вы вайбкодите продукт, который принимает платежи или пользовательские данные, минимум один SAST-проход перед деплоем стоит потраченных пяти минут в pipeline.
Для тех, кто отвечает за DevOps-часть таких запусков, на портале есть отдельная подборка практик и промптов в разделе агентов для DevOps. Если нужна помощь с настройкой конкретно под ваш стек, можно записаться на консультацию к Максиму.
Частые вопросы про статический анализ кода
Чем статический анализ отличается от линтера? Линтер обычно проверяет стиль и базовые ошибки синтаксиса. Полноценный статический анализатор идёт дальше: строит data flow, ищет логические баги и уязвимости, а не только форматирование кода.
Можно ли полностью заменить тестирование статическим анализом? Нет. Статический анализ находит потенциальные проблемы без запуска кода, но не проверяет, что программа реально решает бизнес-задачу правильно. Тесты и статический анализ работают вместе, а не вместо друг друга.
Как часто нужно запускать статический анализ? Ежедневно, в идеале на каждый коммит или пул-реквест. Разовый прогон перед релизом даёт результат хуже, чем регулярный анализ на протяжении всего цикла разработки.
AI-инструменты дают больше ложных срабатываний, чем классические? Наоборот, при правильной настройке гибридные AI-SAST снижают число ложных срабатываний за счёт понимания контекста вокруг подозрительного места в коде.
Нужен ли статический анализ для маленького pet-проекта? Строгий смысла нет, но бесплатный self-host инструмент вроде SonarQube или встроенный линтер AI IDE лишним не будет даже на небольшом проекте, особенно если код пишет в основном AI-агент.
SAST и статический анализ качества кода - это одно и то же? Нет. SAST - это подмножество статического анализа, заточенное именно на уязвимости из базы CWE. Общий статический анализ ищет любые дефекты, включая архитектурные и стилистические.
Что делать, если анализатор выдал тысячу предупреждений на старом проекте? Подавить текущие находки через файл-разметку и анализировать только новый код. Возвращаться к техдолгу постепенно, а не пытаться закрыть всё разом.
Если статья была полезной, посмотрите каталог AI-инструментов на VibeCoderz - там собраны обзоры AI IDE и агентов с разбором того, какие из них уже встраивают проверки безопасности в сам процесс генерации кода. А для точечной настройки статического анализа под конкретный стек всегда можно написать Максиму.