Автоматическое сжатие контекста работает так: когда история диалога с агентом подходит к лимиту окна, модель не обрывает сессию, а сжимает старые сообщения в краткую сводку и продолжает работу дальше. Обновлено: октябрь 2026. Ниже разберем, как эта суммаризация диалога устроена внутри Claude Code и других инструментов, что при этом реально теряется и как настроить процесс руками, а не отдавать решение модели.
Автоматическое сжатие контекста запускается, когда история диалога приближается к лимиту окна LLM, обычно на 90-95% заполнения. Модель заменяет старые сообщения короткой сводкой, теряя часть деталей вроде путей к файлам и промежуточных ошибок. Дочитав статью, вы сможете настроить компакцию вручную и продлить контекст без ручного пересказа задачи заново.
Что такое сжатие контекста и зачем оно вообще нужно?
Сжатие контекста, или компакция, это замена старой части диалога сжатой сводкой, чтобы освободить место под новые токены. Без него сессия просто упирается в потолок и агент перестает отвечать.
Контекстное окно, то есть общий объем токенов, который модель держит в памяти одновременно, у большинства продуктовых инструментов ограничено сильнее, чем у самой модели. Например, Claude Code работает в окне на 200 000 токенов, даже когда за ним стоит модель с окном на миллион.
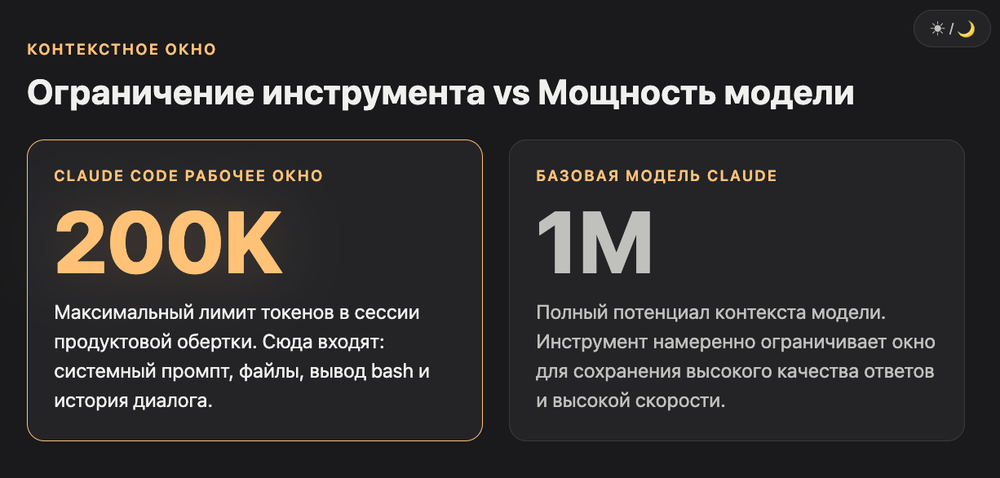
Проблема в том, что окно заполняется не только сообщениями. Системный промпт, описания инструментов, файлы, которые прочитал агент, вывод команд bash и grep. Все это конкурирует за одно и то же пространство. Когда места не остается, у инструмента два варианта: остановиться или сжать историю. Второй вариант и называется компакцией.
Как работает автоматическое сжатие контекста в LLM?
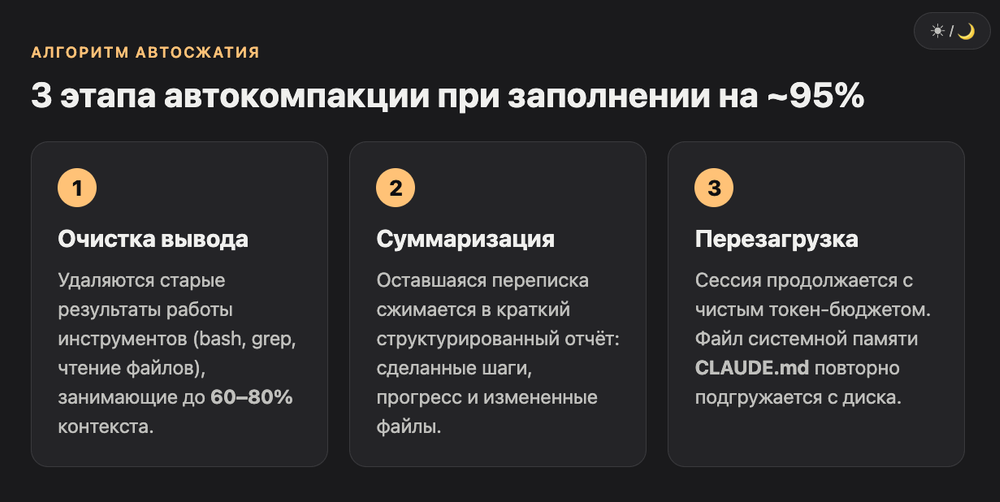
Автокомпакция срабатывает при заполнении окна примерно на 95% и проходит в три шага: очистка вывода инструментов, суммаризация переписки, продолжение сессии с сохраненными файлами памяти.
По данным разбора механики Claude Code, автокомпакция включается при достижении около 95% лимита в 200 000 токенов (источник). Процесс идет так.
Сначала убирается вывод инструментов: старые результаты чтения файлов, grep и bash. Именно они, по тем же данным, занимают 60-80% всего контекста в долгой сессии. Затем оставшаяся переписка сжимается в структурированную сводку: что сделано, что в процессе, какие файлы менялись. И только после этого сессия продолжается с чистым токен-бюджетом, а CLAUDE.md подгружается заново с диска.
Звучит удобно. Но у автоматики есть одна особенность: что сохранить, а что выбросить, решает не человек.
Что теряется при суммаризации диалога?
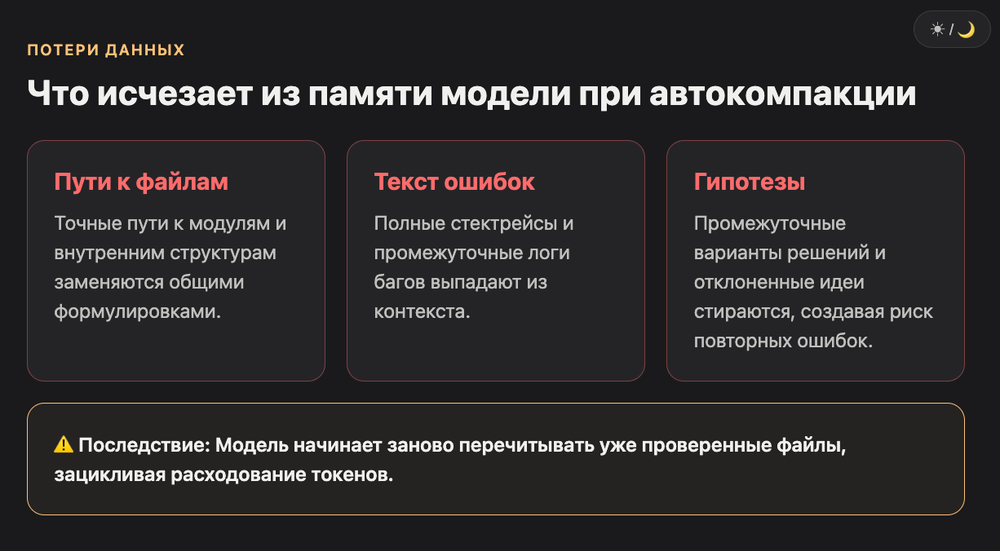
При автоматической суммаризации чаще всего теряются пути к файлам, точный текст ошибок и промежуточные гипотезы, которые не попали в финальную сводку. Модель начинает заново перечитывать код, чтобы восстановить контекст, и это съедает еще больше токенов.
Представьте: вы сорок минут разбирали баг. Агент держит стектрейс, упавший тест, три измененных файла и план фикса. Тут срабатывает автокомпакция, все это сжимается в фразу вроде "разобрал баг с авторизацией и поправил мидлвары" - и агент фактически начинает заново.
Это не выдумка, а зафиксированный сценарий из технических разборов Claude Code. После такого сжатия модель нередко тратит время на повторное чтение уже проверенных файлов, лишь бы восстановить утраченную картину. Круг замыкается: чем чаще срабатывает автокомпакция, тем быстрее снова заполняется контекст, потому что агент заново гоняет токены на восстановление.
Есть и более фундаментальная проблема. Исследование Chroma Research под названием "Context Rot" показало на 18 моделях, включая семейство Claude, что качество ответов падает неравномерно задолго до физического лимита окна (источник). То есть даже без компакции модель начинает хуже использовать данные, которые лежат в середине длинного диалога.
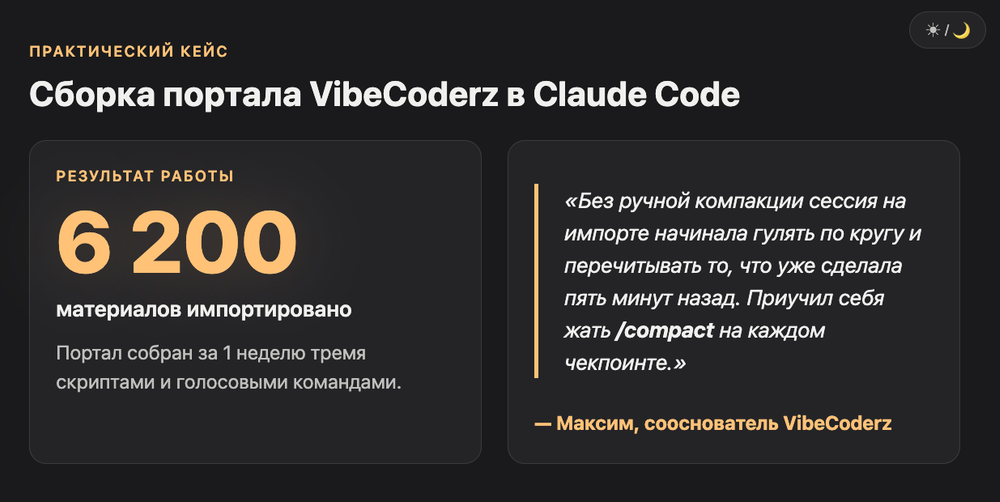
Максим: «Портал VibeCoderz мы собрали за неделю тремя скриптами, голосом, в Claude Code, вышло 6 200 материалов. Без ручной компакции сессия на импорте начинала гулять по кругу и перечитывать то, что уже сделала пять минут назад. Приучил себя жать /compact на каждом чекпоинте, а не ждать, пока сработает автоматика.»
Ручная суммаризация или автокомпакция: что выбрать?
Ручная компакция через /compact дает контроль над тем, что сохранить, автоматическая срабатывает без спроса и может обрезать важные детали. Для рабочих сессий выгоднее компактить руками на checkpoint.
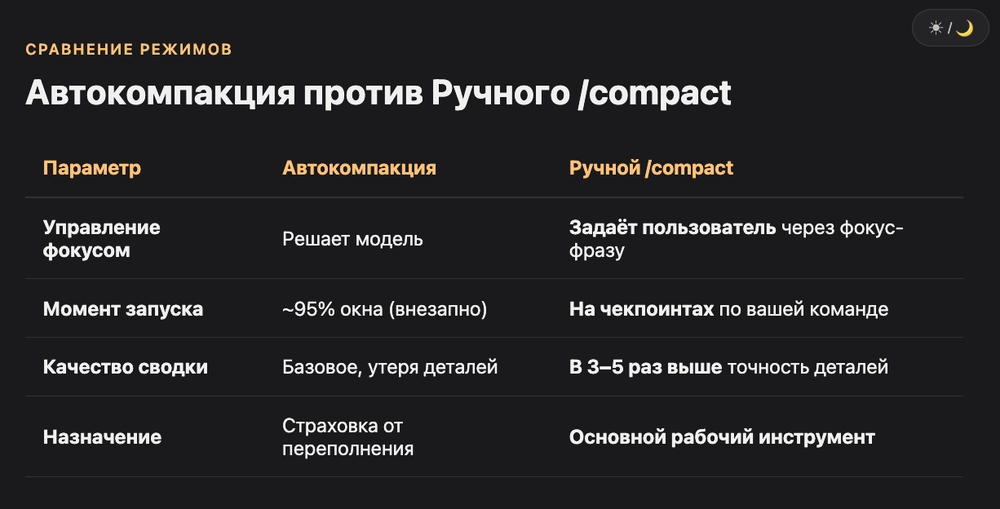
| Параметр | Автокомпакция | Ручной /compact |
|---|---|---|
| Кто решает, что сохранить | Модель | Пользователь через фокус-фразу |
| Момент срабатывания | ~95% окна, без предупреждения по сути | В любой момент по команде |
| Риск потери деталей | Выше | Ниже, если задать фокус |
| Скорость | Мгновенно, но неожиданно | Занимает время, но предсказуемо |
| Когда уместно | Как страховка на крайний случай | На границе задач, на чекпоинтах |
Ручной режим позволяет указать модели, что именно важно сохранить: /compact focus on текущее состояние лаборатории. Модель тогда суммирует все остальное, но детально держит именно нужный фрагмент. Разница в качестве сводки, по независимым замерам, доходит до 3-5 раз в пользу ручного вызова относительно дефолтной автокомпакции.
Как настроить сжатие контекста в Claude Code пошагово?
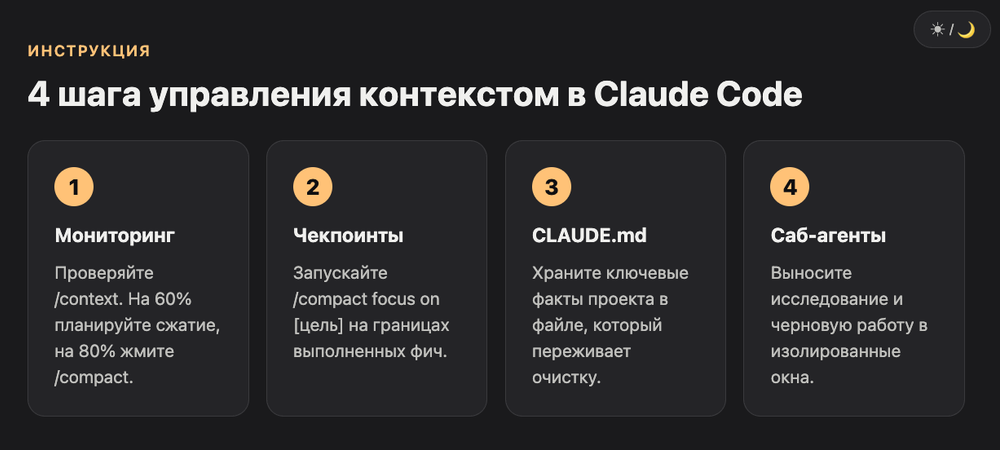
Настройка сводится к четырем шагам: следить за процентом заполнения, компактить на чекпоинтах, выносить критичные факты в CLAUDE.md и снижать нагрузку через саб-агентов и скиллы.
Ниже рабочий алгоритм, который используют вайбкодеры, чтобы продлить контекст LLM и не терять нить задачи.
Шаг 1. Следите за процентом заполнения
Команда /context показывает разбивку: сколько занимает системный промпт, CLAUDE.md, память, описания скиллов и сама переписка. Правило из практики: на 60% заполнения уже стоит думать о суммаризации, на 80% делать ее вручную немедленно, не дожидаясь автоматики.
Шаг 2. Компактите на границах задач, а не посреди них
Закончили фичу и переходите к следующей? Самое время для /compact. Если задача та же, но контекст распух, компактьте с фокус-фразой, чтобы не потерять рабочее состояние. Если задача совсем новая и старая переписка только мешает, честнее выполнить /clear и начать с нуля, забрав нужное в файл заранее.
Шаг 3. Держите критичные факты в CLAUDE.md, а не в переписке
CLAUDE.md и файлы автопамяти переживают и компакцию, и очистку истории. Один из проверенных приемов: прямо в CLAUDE.md прописать инструкцию вида "когда контекст превышает 50%, предложи компакцию или запуск суб-агента для независимой части задачи". Модель тогда сама подскажет момент, а не будет ждать красной зоны.
Шаг 4. Разгружайте контекст саб-агентами
Саб-агенты работают в изолированном окне и возвращают в основную сессию только итоговую сводку. В одном из разборов запуск study-guide через general-purpose саб-агента не сдвинул заполнение основного контекста ни на процент: было 19%, осталось 19%. Всю черновую работу агент проделал у себя, а не в общем окне.
Чем компакция отличается от команды очистки контекста?
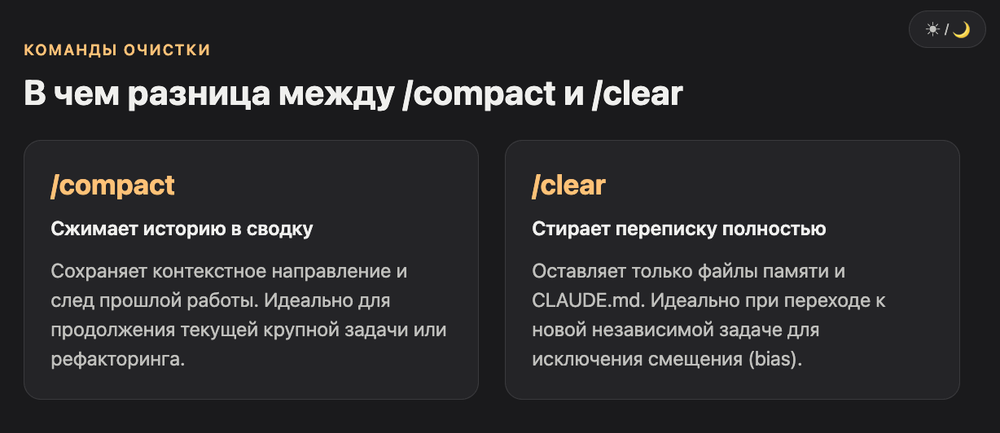
Компакция сжимает историю в сводку и оставляет след прошлой работы, очистка стирает переписку полностью и оставляет только файлы памяти. Выбор зависит от того, нужен ли еще след старой задачи.
Разница простая, но ее часто путают. /compact оставляет сжатый пересказ того, что было, /clear не оставляет ничего, кроме CLAUDE.md и памяти на диске. Если вы продолжаете тот же большой рефакторинг, компакция logичнее: сохранится общее направление. Если начинаете независимую задачу в том же проекте, старая переписка работает как шум и создает смещение (bias) в новых решениях модели, поэтому очистка честнее.
Как еще продлить контекст LLM без потери качества?
Продлить контекст можно не только суммаризацией: сокращение CLAUDE.md, вынос повторяющихся блоков в скиллы, отключение неиспользуемых MCP-серверов и работа с большими файлами через вложение, а не вставку текста, экономят десятки процентов места.
Вот подборка приемов из практики разбора реальных Claude Code-сессий, отсортированная по эффекту.
- Урежьте CLAUDE.md. Даже небольшая чистка от лишних правил экономит заметный процент контекста на каждой без исключения сессии, потому что файл грузится при каждом запуске.
- Выносите повторяющиеся инструкции в скиллы. По замерам из практики, обычный CLAUDE.md на задачу занимал около 45% контекста, тот же процесс через скилл, где полное содержимое подгружается только при активации, около 27%.
- Используйте файлы-шаблоны вместо вставки текста в каждый скилл. Ссылочные файлы против дублирования содержимого дали разницу порядка 25% против 31% занятого контекста.
- Прикрепляйте большие файлы, а не вставляйте текст в сообщение. Один и тот же файл как вложение занял около 38% контекста, тот же файл, вставленный как текст прямо в промпт, около 71%.
- Отключайте неиспользуемые MCP-серверы. Каждый подключенный сервер по умолчанию грузит описания своих инструментов в контекст, даже если вы им не пользуетесь в этой сессии.
Отдельный неочевидный момент: переключение на модель с более широким окном не столько увеличивает контекст, сколько снижает долю фиксированных накладных расходов вроде системного промпта. В одном сравнении фиксированные части занимали около 9% при работе на модели с окном побольше и больше 30% на модели с окном поменьше, при абсолютно одинаковом наборе инструкций.
Сколько токенов держат разные модели по состоянию на 2026 год?
Наглядно, почему тема сжатия контекста вообще актуальна: даже у моделей с окном в миллион токенов продуктовые обертки часто урезают лимит ради стабильности и скорости ответа.
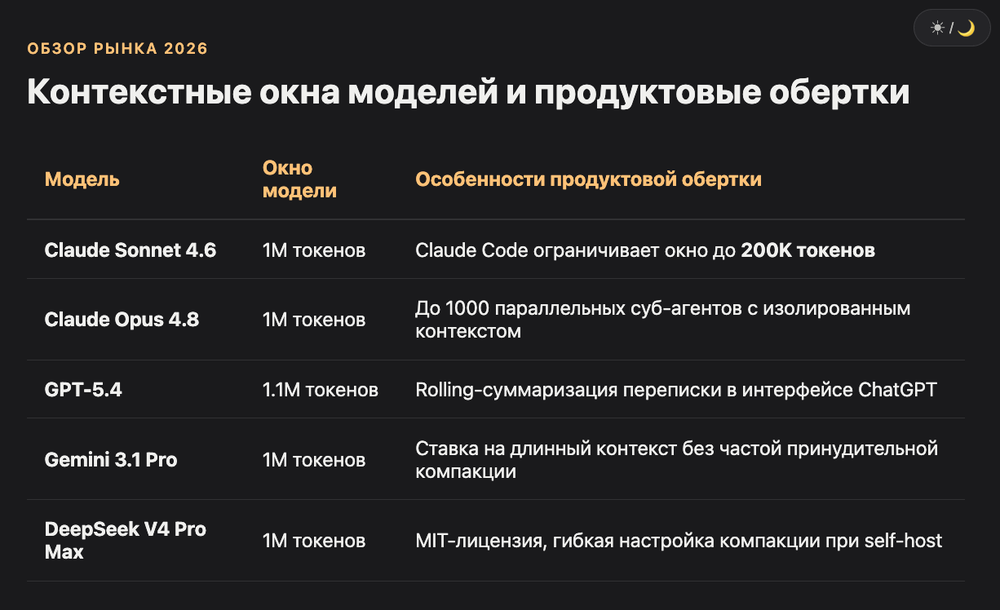
| Модель | Окно контекста (модель) | Особенность продуктовой обертки |
|---|---|---|
| Claude Sonnet 4.6 | 1M / вывод до 64K | Claude Code ограничивает рабочее окно до 200K токенов |
| Claude Opus 4.8 | 1M / вывод до 128K | Поддерживает до 1000 параллельных суб-агентов с изолированным контекстом |
| GPT-5.4 | 1.1M / вывод до 128K | Rolling-суммаризация переписки в интерфейсе ChatGPT |
| Gemini 3.1 Pro | 1M / вывод до 66K | Ставка на длинный контекст без частой принудительной компакции |
| DeepSeek V4 Pro Max | 1M / вывод до 384K | MIT-лицензия, можно настроить компакцию под себя при self-host |
Отдельно стоит сказать про ChatGPT: там нет прямого аналога /compact, который пользователь запускает руками. Вместо этого действует слой памяти поверх модели: часть фактов сохраняется как "saved memories", а старая переписка со временем просто перестает попадать в активное окно. Разработчики самого OpenAI прямо разделяют эти два механизма в документации, поэтому "ChatGPT все помнит" и "у ChatGPT большое окно контекста" - это, по сути, два разных утверждения.
Итог: что важно унести из этой статьи
Сжатие контекста не баг и не признак того, что модель "устала". Это инженерный компромисс между размером окна и стабильностью ответов, и чем раньше вы возьмете компакцию под ручное управление, тем меньше будете терять важные детали задачи. Три вещи работают почти всегда: следить за процентом через /context, компактить на границах задач с явным фокусом, и держать критичные факты не в переписке, а в CLAUDE.md.
Если работаете с Claude Code на больших проектах, разница между ручным и автоматическим сжатием контекста ощущается уже на второй-третьей долгой сессии. У Cursor логика похожая, хотя интерфейс управления окном спрятан немного иначе. Полный разбор инструментов для вайбкодинга и их особенностей по работе с контекстом смотрите в каталоге AI IDE на VibeCoderz.
Часто задаваемые вопросы
Что такое суммаризация диалога простыми словами? Это когда вместо всей истории переписки с моделью остается только короткий пересказ главного: что обсуждали, что решили, что сделали. Экономит место, но что-то из деталей неизбежно теряется.
Чем автоматическое сжатие контекста отличается от команды /compact? Автоматика срабатывает сама, обычно около 95% заполнения окна, и решает, что сохранить, без вашего участия. Команда /compact запускаете вы сами, в любой момент, и можете указать фокус, что сохранить максимально подробно.
Теряет ли LLM данные после компакции? Да, частично. Чаще всего пропадают точные пути к файлам, полный текст ошибок и промежуточные гипотезы, которые не попали в итоговую сводку. Модель может заново перечитывать код, чтобы восстановить картину.
Как понять, что пора сжимать контекст вручную? Ориентируйтесь на команду /context. При заполнении около 60% стоит начать думать о компакции, при 80% лучше сделать ее сразу, не дожидаясь автоматического срабатывания.
Поможет ли просто увеличение окна контекста вместо суммаризации? Частично. Исследование Chroma Research показало, что качество ответов падает неравномерно задолго до физического лимита окна, поэтому даже миллион токенов не гарантирует ровное качество на всей длине диалога.
Можно ли вообще отключить автоматическое сжатие контекста? Полностью выключить нельзя, это защитный механизм от переполнения окна. Но можно снизить частоту его срабатывания: чистить CLAUDE.md, использовать скиллы вместо длинных инструкций и разгружать задачи через суб-агентов.
Суб-агенты лучше компакции или это разные инструменты? Это разные слои. Компакция сжимает уже накопленную историю в основном окне. Суб-агенты вообще не дают контексту накапливаться в основном окне, потому что выполняют черновую работу в изолированном пространстве и возвращают только итог.
Разбираетесь с контекстом на конкретном проекте и не понимаете, где именно теряются токены? Запишитесь на консультацию к Максиму, разберем сессию и настроим CLAUDE.md под задачу.
Обновлено: октябрь 2026.