Технический долг AI кода — это не абстракция про "плохой код", а конкретная сумма, которую платит команда каждый раз, когда AI-агент пишет что-то почти правильное вместо правильного. Почти правильный код проходит ревью, проходит тесты и полгода спустя ломает продакшн — именно поэтому он дороже полностью сломанного кода, который отваливается сразу. Ниже — три измеримые метрики долга, признаки момента, когда пора переписывать, и данные Veracode 2026 по безопасности AI-кода.
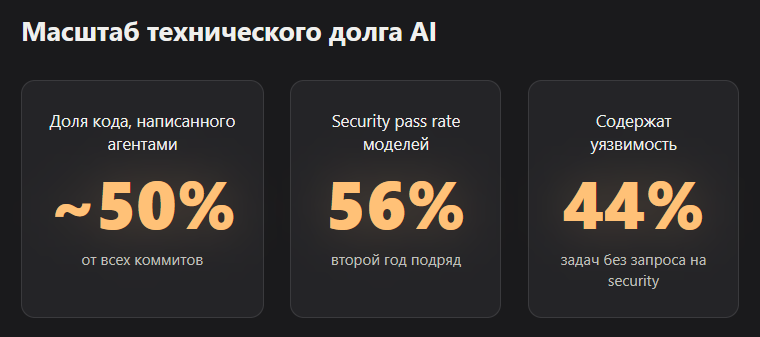
В 2026 году AI-агенты пишут примерно половину коммитируемого кода, а средний security pass rate моделей держится на 56% второй год подряд. Около 44% задач без явного запроса на безопасность порождают уязвимость. В статье — три метрики оценки долга, критерии "рефакторить самому или просить AI переписать" и три вопроса для ревью AI-кода.
Что такое технический долг AI кода и чем он отличается от обычного
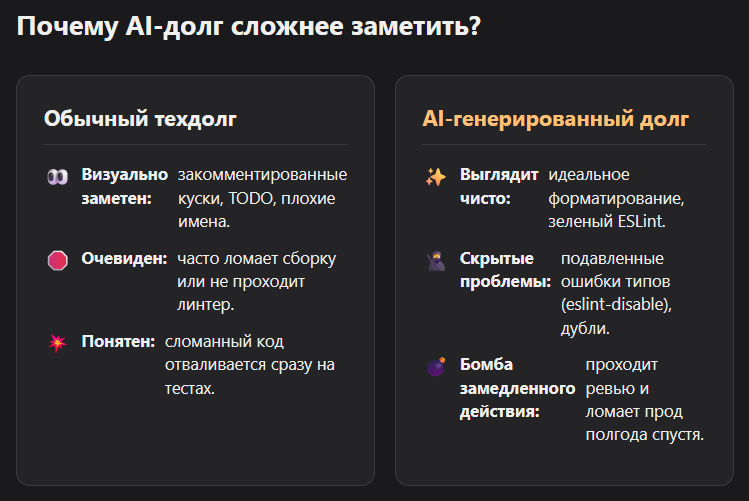
Технический долг AI кода — это код, который работает и проходит тесты, но скрывает нерешенные проблемы: подавленные ошибки, дубликаты логики, несоответствие конвенциям проекта. Отличие от обычного долга в том, что его сложнее заметить визуально.
Обычный технический долг оставляет следы: закомментированный кусок, TODO, странное имя переменной. AI-код выглядит чисто. TypeScript собирается, ESLint зеленый, тесты проходят — а внутри лежит подавленная ошибка типов или дублирующая функция форматирования дат под другим именем.
В одном разобранном кейсе senior-инженер одобрил PR с чистым на вид кодом. При детальном ревью в файле нашлось 11 директив eslint-disable-next-line, а по всему проекту — больше 200, добавленных за три месяца использования AI-инструментов. Модель не чинила ошибки типов, а глушила предупреждения. Через две недели один из подавленных типов привел к продакшн-багу. Разница с обычным долгом простая: сломанный код ловится сразу, почти правильный копится тихо.
Тут работает правило: AI не знает конвенций конкретного проекта, он знает усредненные "конвенции интернета". Отсюда PascalCase рядом с camelCase, три разных типа UserData, UserInfo, UserResponse для одной и той же сущности, дублирующиеся утилиты форматирования дат в разных модулях.
Максим: «У Нейроштата целая команда ждала одну фичу месяцами, и когда получили — разочаровались, потому что время реализации оказалось критично. С AI-агентами обратная проблема: скорость есть, а цена за нее прячется в коде, который никто толком не читал перед мерджем.»
Какие метрики реально показывают размер долга
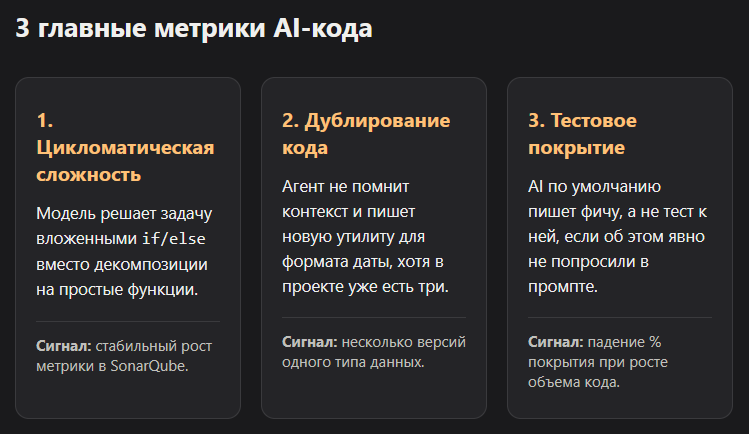
Три измеримых показателя: цикломатическая сложность функций, процент дублирования кода и динамика тестового покрытия. По отдельности каждый ничего не значит, вместе они показывают тренд.
Цифра долга без контекста бесполезна — 30% дублирования в одном проекте норма, в другом катастрофа. Смотреть нужно не на абсолютное число, а на то, растет оно или падает от спринта к спринту.
Цикломатическая сложность считает количество независимых путей выполнения через функцию: каждый if, else, while, case добавляет ветку. AI-агенты, работающие без контекста всей кодовой базы, склонны решать задачу вложенными условиями вместо декомпозиции на более простые функции — потому что вложенный if проще сгенерировать, чем спроектировать три отдельные функции с понятной ответственностью. Инструменты вроде SonarQube считают эту метрику автоматически на каждый PR.
Процент дублирования кода растет у AI-агентов быстрее, чем у людей, по простой причине: у модели нет памяти между сессиями, и она не видит, что похожая утилита уже есть в другом файле. Итог — три реализации форматирования даты и четыре определения типа пользователя в одном проекте. Проверка простая: перед тем как принять новый кусок кода, стоит спросить себя, не существует ли уже в кодовой базе аналогичной функции — если да, старый код удаляется, а не дублируется.
Тестовое покрытие падает у AI-кода быстрее, чем у человеческого, если тесты не запрашивались явно на каждом шаге. Модель по умолчанию решает поставленную задачу, а не пишет тест на нее, если тест не входил в промпт.
| Метрика | Что измеряет | Тревожный сигнал |
|---|---|---|
| Цикломатическая сложность | Число независимых путей через функцию | Стабильный рост без декомпозиции на подфункции |
| Дублирование кода | Повтор логики в разных местах проекта | Несколько версий одной утилиты или типа |
| Тестовое покрытие | Доля кода, накрытого тестами | Падение при росте объема AI-коммитов |
Когда почти правильный код становится легаси
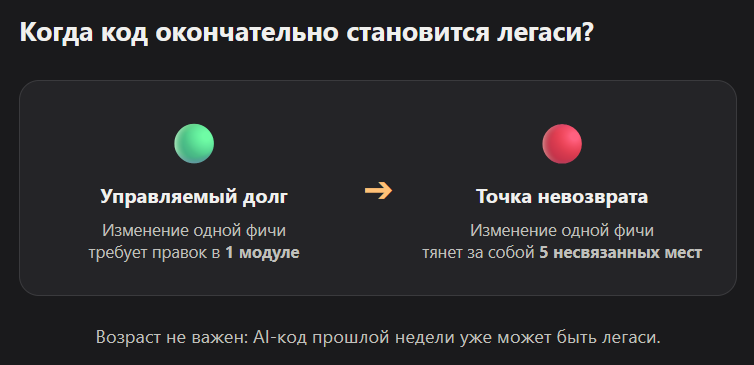
Код превращается в легаси, когда добавление одной фичи стабильно требует правок в пяти и более несвязанных местах, или когда AI-агент начинает противоречить сам себе в одном файле между сессиями. Возраст кода тут не главный признак.
Легаси — не про возраст. Код, написанный на прошлой неделе, вполне может быть легаси, если в нем уже накопились подавленные ошибки и дубли, а команда не понимает, почему он устроен именно так. Переломный момент один и тот же и для человеческого, и для AI-кода: изменение перестает быть локальным.
Пока правку можно сделать в одном модуле — долг управляем. Как только правка одной фичи тянет за собой изменения в пяти несвязанных на первый взгляд файлах, это сигнал, что архитектура развалилась на скрытые зависимости. Второй признак специфичен именно для AI: агент, вернувшись к тому же файлу в новой сессии, предлагает решение, которое противоречит собственному коду из прошлой сессии, потому что не удержал контекст.
Дублирование, подавленные ошибки и рассинхрон конвенций работают как проценты по кредиту: каждый повторяющийся баг и каждый лишний час на разработку — это выплата процентов, а не тела долга.
Рефакторить самому или просить AI переписать
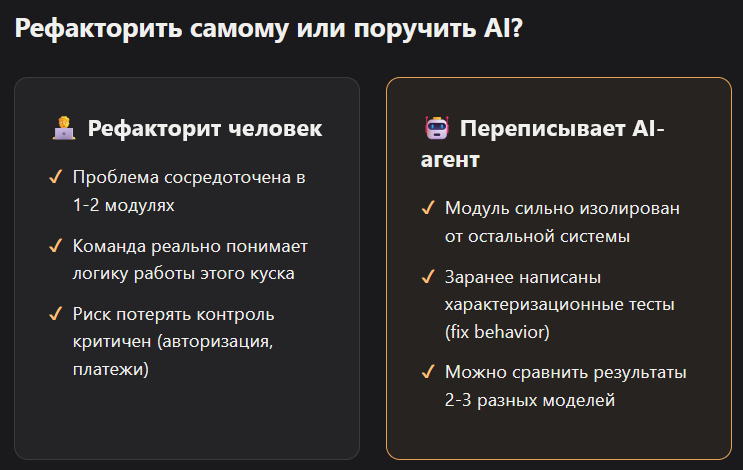
Рефакторить вручную стоит, когда долг локализован в 1-2 модулях и команда понимает архитектуру. Просить AI переписать имеет смысл, когда модуль изолирован и есть характеризационные тесты, фиксирующие текущее поведение до изменений.
Универсального процента долга, после которого «пора переписывать», не существует — порог зависит от размера команды, критичности модуля и того, кто будет это поддерживать дальше. Но два практических критерия работают почти всегда.
Рефакторинг своими руками имеет смысл, когда проблема сосредоточена в одном-двух модулях и хотя бы один человек в команде реально понимает, зачем код устроен так, а не иначе. Здесь риск потерять контроль над решением минимален.
Поручать переписывание AI стоит там, где модуль изолирован от остальной системы и заранее написаны характеризационные тесты — тесты, фиксирующие текущее поведение, а не то, каким оно должно быть в теории. Без этой страховки AI-переписывание легаси легко превращается в новую версию той же проблемы: код снова будет выглядеть чисто и снова прятать нерешенное.
При работе с несколькими AI-инструментами сравнение результатов на одной и той же задаче тоже снижает риск: на одном тесте рефакторинга легаси-функции модели показывали разное качество разбора одной и той же проблемы, вплоть до обнаружения побочных эффектов юникода в проверках длины строки, которые часть моделей просто не заметила.
Три вопроса для ревью AI-сгенерированного кода
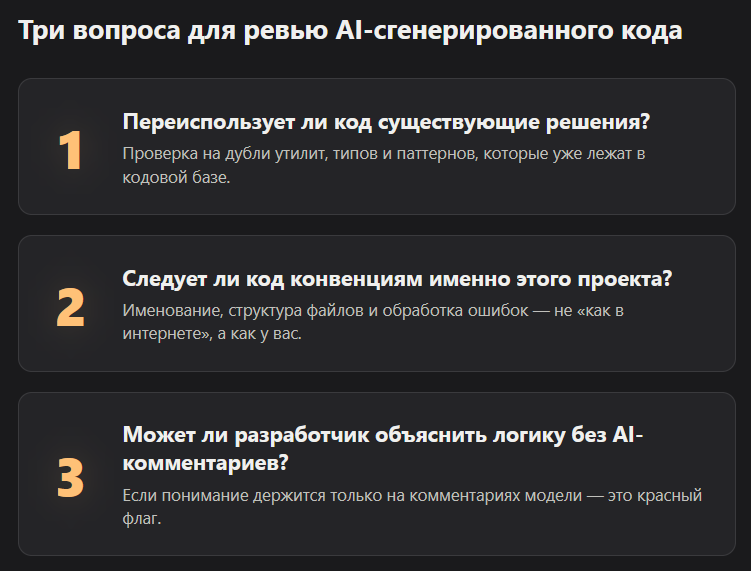
Рабочий фреймворк ревью — три вопроса к каждому PR: переиспользует ли код существующие решения, следует ли конвенциям проекта, может ли разработчик объяснить его без чтения комментариев AI. Если хотя бы один ответ "нет" — нужен более внимательный разбор.
Смысл фреймворка в том, чтобы относиться к AI-агенту как к талантливому подрядчику, который никогда раньше не видел ваш код: он может писать хорошо в вакууме и плохо вписываться в конкретный проект.
Переиспользует ли это? Проверка на дубли утилит, типов и паттернов, которые уже есть в кодовой базе.
Следует ли это конвенциям? Именование, обработка ошибок, структура файлов — так, как принято именно в этом проекте, а не «как в среднем по интернету».
Может ли разработчик объяснить это без чтения комментариев AI? Если объяснение держится только на сгенерированных комментариях, а не на понимании автора PR, это красный флаг вне зависимости от того, кто писал код.
Команды, которые действительно быстро разрабатывают — не те, кто выпускает больше всего кода, а те, чей код остается последовательным и предсказуемым спустя месяцы.
Что говорит Veracode о безопасности AI кода в 2026 году
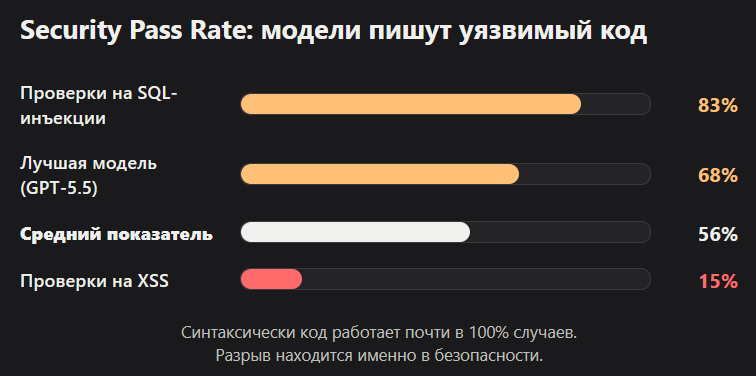
Отчет Veracode 2026 GenAI Code Security Report показал средний security pass rate моделей на уровне 56% второй год подряд. Около 44% задач без явного запроса на безопасность порождают уязвимость, а лидер рейтинга — GPT-5.5 — все равно проваливает почти треть проверок.
Технический долг и безопасность связаны напрямую: непроверенный AI-код почти всегда несет оба риска одновременно. Отчет Veracode за лето 2026 протестировал 11 новых моделей на 80 задачах и подтвердил: средний security pass rate держится на 56%, почти не изменившись год к году. При этом синтаксически рабочий код модели выдают практически в 100% случаев — разрыв именно в безопасности, а не в работоспособности.
Лидер рейтинга, GPT-5.5, набрал 68% и все равно проваливает почти треть задач на безопасность. Шесть из одиннадцати протестированных моделей оказались в диапазоне 50-53%. По отдельным типам уязвимостей разброс еще резче: проверки на SQL-инъекции проходят в 83% случаев, а на межсайтовый скриптинг (XSS) — только в 15%.
Это системная причина, почему AI-код нуждается в ревью раньше, чем накопится измеримый долг, а не после того, как метрики покажут проблему. Модели умеют писать компилируемый код почти всегда, но не умеют по умолчанию писать безопасный.
| Показатель Veracode 2026 | Значение |
|---|---|
| Средний security pass rate (100+ моделей) | 56% |
| Доля задач с уязвимостью без запроса на безопасность | 44% |
| Лучшая модель (GPT-5.5) | 68% |
| Пройденные проверки на SQL-инъекции | 83% |
| Пройденные проверки на XSS | 15% |
Частые вопросы
Можно ли доверять AI-агенту рефакторинг без ревью человека?
Нет, особенно для модулей, завязанных на остальную систему. Даже с характеризационными тестами стоит проверять итог по трем вопросам: переиспользование, конвенции, объяснимость без AI-комментариев.
Есть ли универсальный процент долга, после которого пора переписывать проект?
Нет. Порог зависит от критичности модуля, размера команды и того, кто будет его поддерживать. Ориентир — не число, а количество несвязанных мест, которые приходится трогать ради одной фичи.
Почему AI-код выглядит чище человеческого, но содержит больше скрытых проблем?
Потому что модель оптимизирует под прохождение автоматических проверок (линтер, тесты, компиляция), а не под понимание архитектуры проекта. Подавленная ошибка типа выглядит так же чисто, как исправленная.
Какой инструмент лучше всего справляется с рефакторингом легаси-кода?
Однозначного лидера нет — на разных задачах лучше показывают себя разные модели, поэтому сравнение результатов 2-3 инструментов на одной задаче снижает риск пропустить проблему вроде побочных эффектов юникода в строковых операциях.
Что делать, если в проекте уже больше 100 подавленных ошибок линтера?
Разбить на партии по модулям, начать с самых критичных путей (авторизация, платежи, работа с пользовательскими данными), для каждой партии писать характеризационные тесты перед тем, как включать проверки обратно.
Как часто нужно пересчитывать метрики долга?
На каждый PR для цикломатической сложности и дублирования через статический анализатор, раз в спринт — для тренда тестового покрытия по всему проекту.
Помогает ли Claude Code снизить накопление технического долга по сравнению с другими агентами?
Инструмент с более длинным контекстом окна и памятью о структуре проекта реже дублирует существующий код, но конвенции проекта и ревью по трем вопросам все равно остаются на стороне команды — сравнение подходов разобрано в обзоре Claude Code.
Технический долг AI-кода не решается заменой одного инструмента на другой — он решается дисциплиной ревью, которая раньше применялась к джуниор-разработчикам, а теперь нужна для каждого PR от агента. Разбор конкретного процесса ревью AI-кода на PR — в статье AI код-ревью с Claude Code и GitHub. Полный каталог AI-инструментов для вайбкодинга — на vibecoderz.ru/ide, а разбор своего проекта на технический долг можно обсудить на консультации с Максимом.
Обновлено: октябрь 2026.