
Тестирование AI кода в 2026 году через TDD и Playwright
Тестирование AI кода строится по другой логике, чем ручная проверка: тесты пишутся до реализации, агент останавливается после каждого шага, а Playwright закрывает то, что юнит-тесты физически не видят. Ниже — рабочая методология с конкретными промптами, трёхуровневой стратегией тестов и настройкой автозапуска в CI. Обновлено: октябрь 2026.
В статье: как заставить агента писать тест раньше кода, чем Playwright полезнее обычных юнит-тестов, и почему тесты от того же агента не гарантируют отсутствие ошибок в его коде.
Это продолжение базовой статьи о тестировании AI-сгенерированного кода — там чеклист и общий обзор инструментов. Здесь — конкретная методология TDD в связке с агентом для тех, кто уже пробовал автогенерацию тестов и столкнулся с её слабыми местами.
Почему тесты после кода не работают с AI-агентом?
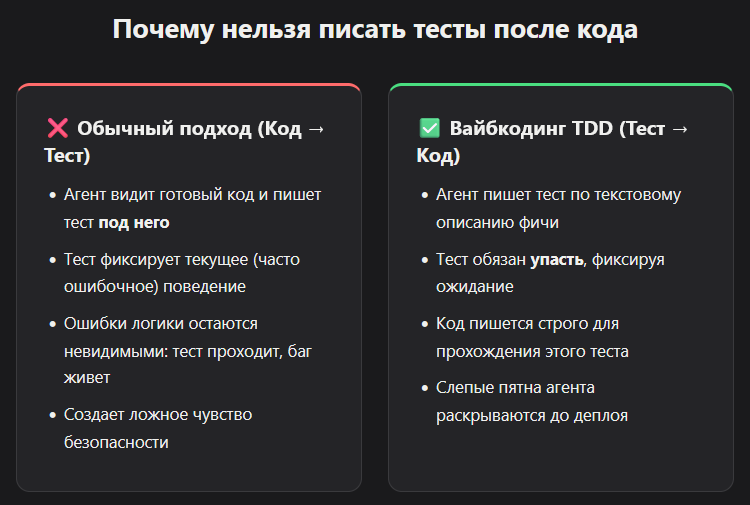
Обычный порядок "код, потом тесты" с AI-агентом превращается в тесты, подогнанные под уже написанный код. Они проходят, но не ловят реальные проблемы.
Один инженер с 20-летним опытом TDD разобрал это на практике: попросил агента покрыть тестами метод в 100 строк, тесты выглядели отлично, а при проверке вручную оказалось — часть проверок слишком мягкие, часть не добавляет покрытия вообще, часть стабов возвращает значение независимо от переданных аргументов. Это ключевая причина держать порядок TDD: сначала тест, потом код.
Логика простая. Когда агент видит готовый код, он пишет тест под то, что уже есть, а не под то, что должно быть. Тест фиксирует текущее поведение, а не ожидаемое. Ошибка остаётся невидимой, потому что тест её не проверяет.
Разворот порядка меняет всё. Сначала описываете фичу, агент пишет тест, который падает. Тест фиксирует ожидание. Только потом агент пишет код, который должен этот тест пройти. Тест перестаёт подстраиваться под реализацию, потому что реализации ещё нет.
Как работает цикл red green refactor с AI-агентом?
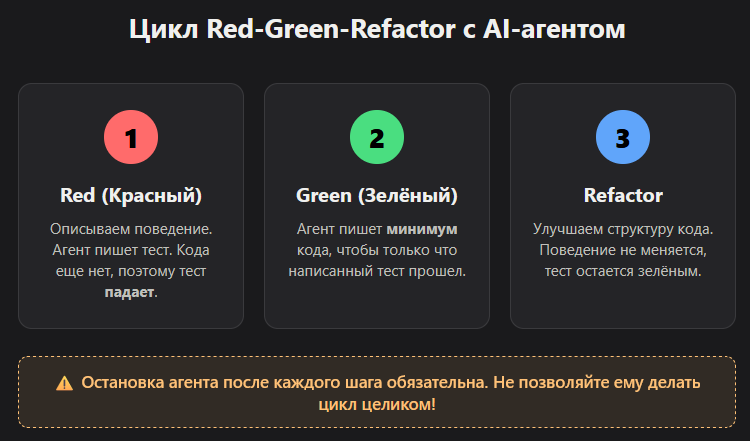
Красный шаг: тест написан и падает. Зелёный шаг: код написан, тест проходит. Рефакторинг: код улучшается, тест не трогается. Агент останавливается после каждого шага для проверки человеком.
Три шага без остановки превращаются в цикл, где агент реализует больше, чем нужно, теряет список тестов между промптами или закомментирует упавшую проверку вместо того чтобы её чинить. Пауза после каждого шага — единственное, что удерживает процесс под контролем.
Красный шаг. Описываете поведение через тест до того, как код существует. Тест обязан упасть — и упасть именно по той причине, которую вы ожидали, а не из-за опечатки в импорте.
Зелёный шаг. Агент пишет минимум кода, чтобы тест прошёл. Не больше. Если агент реализует сразу три фичи вместо одной — это сигнал вернуть его к границам задачи.
Рефакторинг. Улучшаете структуру кода, поведение не меняется, тест остаётся зелёным. Если после рефакторинга тест упал — либо сломали логику, либо (что бывает чаще) агент незаметно подправил сам тест под новый код. Это нужно проверять руками каждый раз.
Держите физический список тестов в отдельном файле — например, tests.md. Без него список тестов "теряется" между промптами уже на третьей-четвёртой итерации, и агент начинает придумывать порядок сам.
Как написать промпт для генерации теста до кода?
Промпт для красного шага описывает поведение, а не реализацию, и явно требует от агента остановиться после написания теста — до всякого кода.
Возьмём конкретную фичу: форма регистрации с проверкой email и обязательным паролем от 8 символов. Вот как выглядят промпты по шагам.
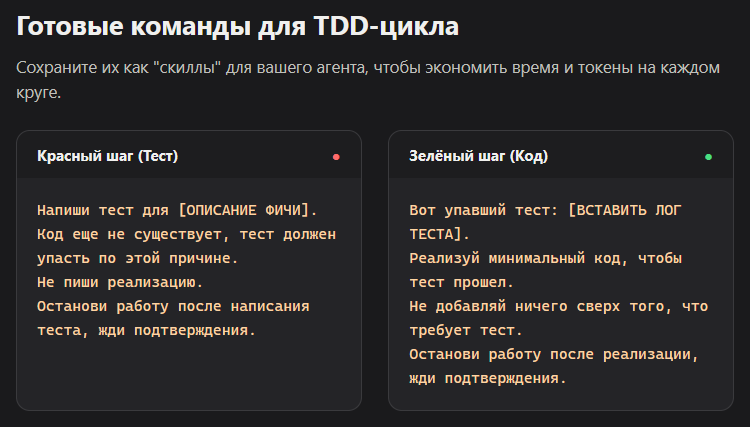
Промпт для красного шага (тест до кода):
Напиши тест для формы регистрации: поле email обязательно
и должно содержать @, пароль обязателен и не короче 8 символов.
Код формы ещё не существует, тест должен упасть по этой причине.
Не пиши реализацию. Останови работу после теста, жди подтверждения.
Промпт для зелёного шага (код под тест):
Вот упавший тест: [вставить тест].
Реализуй минимальный код формы регистрации, чтобы тест прошёл.
Не добавляй ничего сверх того, что требует тест.
Останови работу после реализации, жди подтверждения.
После зелёного шага запускаете тест сами — не просите агента запускать его за вас. Это быстрее и экономит токены, а заодно вы видите реальный результат, а не пересказ агента.
Скилл под каждый шаг ускоряет цикл: один вызов на "следующий тест", один на "реализовать под тест", один на "отметить тест завершённым". Дублирование в промптах исчезает, а цикл красный-зелёный-рефакторинг превращается в пару команд.
Чем Playwright плюс AI сильнее обычных юнит-тестов?
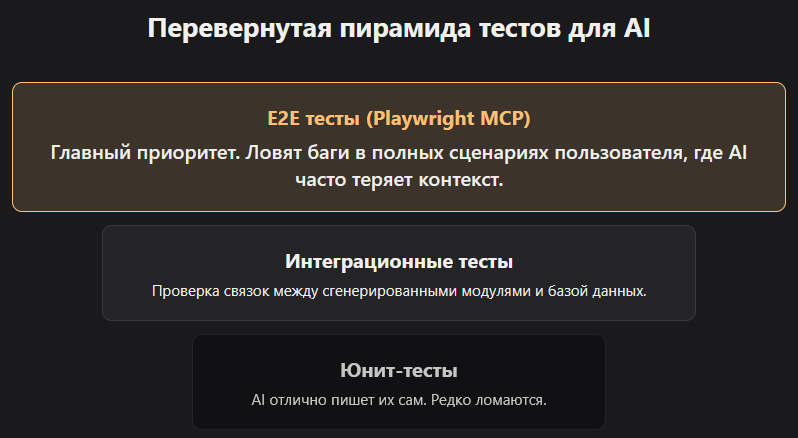
Юнит-тесты хороши на мелких деталях, где агент и так редко ошибается. E2E и интеграционные тесты через Playwright ловят то, что раньше требовало часов ручной проверки — полный путь пользователя в реальном браузере.
Пирамида тестирования для AI-разработки перевёрнута относительно классической. Обычно пишут много юнит-тестов, немного интеграционных, единицы E2E — потому что E2E дорогой и медленный для человека. С агентом дорогое и медленное как раз то, что стоит автоматизировать: юнит-тесты агент и сам почти не ломает на мелочах, а вот путь "зарегистрировался, поменял настройки, чат пропал" — баг, который поймать может только полный прогон сценария.
Playwright MCP даёт агенту доступ к реальному браузеру через протокол MCP: агент открывает страницу, кликает, получает снапшот DOM в ответ и решает следующий шаг. По сравнению с обычным Playwright codegen разница в том, что агент работает по accessibility-дереву страницы, а не по записи кликов — локаторы получаются семантически осмысленными, а не хрупкими селекторами по CSS-классам.
Playwright MCP или Playwright Codegen — что выбрать?
Классический Playwright codegen (встроенная запись кликов) остаётся быстрее для простого сценария из трёх шагов — три с половиной минуты ручной записи против нескольких минут диалога с агентом. Playwright MCP выигрывает там, где нужно описать сценарий словами и не тратить время на ручную запись, либо когда тест генерируется как часть более крупного цикла разработки фичи.
Файл с инструкциями testing.md в корне проекта — обязательная деталь: без него агент не знает, какая база данных нужна для запуска, какие переменные окружения использовать и какого тестового пользователя создавать перед прогоном.
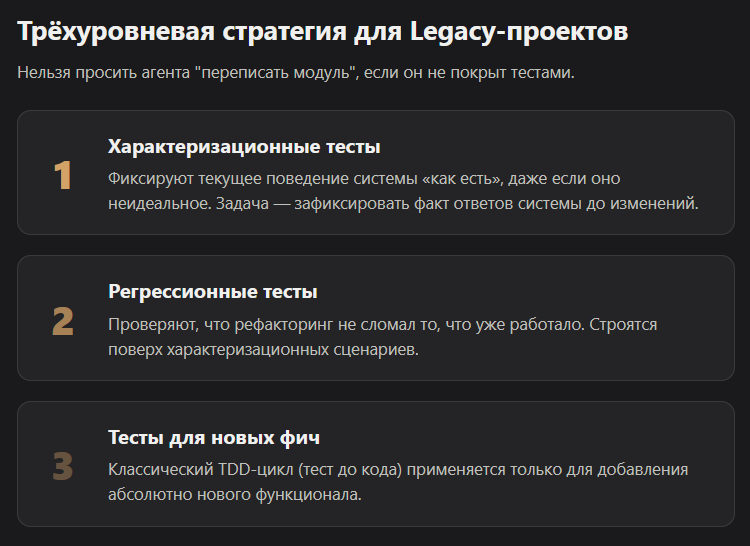
Что такое трёхуровневая стратегия тестов для legacy и новых проектов?
Сначала характеризационные тесты фиксируют текущее поведение системы как есть. Потом регрессионные проверяют, что старая функциональность не сломалась. Потом — тесты для новых фич.
Для нового проекта с нуля порядок красный-зелёный-рефакторинг работает без вопросов. Для существующего кода, который уже в проде и без тестов, порядок другой.
Уровень 1. Характеризационные тесты. Фиксируют, что система делает сейчас, до всяких изменений, даже если поведение неидеальное. Задача не оценить код, а зафиксировать факт: "на этот вход система отвечает этим выходом".
Уровень 2. Регрессионные тесты. Проверяют, что изменения не сломали то, что уже работало. Строятся поверх характеризационных, часто из тех же сценариев, но с проверкой конкретных бизнес-правил, а не просто факта поведения.
Уровень 3. Тесты для новых фич. Здесь снова работает обычный цикл TDD: тест до кода, потом реализация.
Пропуск первого уровня — частая ошибка при вайбкодинге legacy-проекта. Агенту дают задачу "перепиши модуль" без характеризационных тестов, он меняет поведение незаметно, а разница всплывает только у пользователей.
Как настроить автозапуск тестов в CI на каждый коммит?
Автозапуск в CI закрывает главный риск вайбкодинга: код, который выглядит рабочим в моменте, но ломается через несколько итераций агента без сигнала об этом.
Есть два базовых подхода к организации тестов в CI, и оба встречаются в реальных командах.
| Подход | Где лежат тесты | Когда запускаются |
|---|---|---|
| Тесты в репозитории с кодом | Папка test/ внутри dev-репозитория | На pull request, до слияния |
| Тесты в отдельном QA-репозитории | Отдельный репозиторий, вызывается из dev-пайплайна | На pull request или после мержа |
| Тесты на локальном хосте | В той же среде, где собирается код | До деплоя на любое окружение |
| Тесты на staging после деплоя feature-ветки | На promежуточном окружении | После деплоя, до мержа в master |
Для вайбкодинг-проекта без выделенной DevOps-команды практичнее всего первый вариант: тесты живут рядом с кодом, пайплайн триггерится на каждый pull request, юнит-тесты идут первым шагом, Playwright-сценарии — вторым. Если что-то падает — сборка помечается как failed, и мерж в master блокируется автоматически.
Настройка через GitHub Actions требует установки зависимостей для тестового окружения отдельно от продакшн-зависимостей — это частая причина, почему тесты "работают локально, но падают в CI". Убедитесь, что переменные окружения для тестового прогона объявлены в секретах репозитория, а не захардкожены в коде.
Гарантируют ли тесты от того же агента отсутствие ошибок?
Нет. Тесты, которые агент пишет для собственного кода, ловят то, что он сам считает нужным проверить — а не то, что он не предусмотрел.
Это честное ограничение, а не формальность. Если агент не подумал о граничном случае при написании кода, велика вероятность, что он не подумает о нём и при написании теста для этого же кода — слепое пятно одно и то же. Именно поэтому красный шаг важен: тест пишется под описание поведения, которое задаёте вы, а не под то, что агент уже реализовал.
Дополнительная страховка — второй независимый прогон. Часть найденных багов в интеграционных сценариях всплывает только на повторных запусках, потому что первый прогон проходит случайно. Тест, который прошёл один раз, не то же самое, что тест, который проходит стабильно.
Максим: «Мог просто засесть до пяти утра и просто там править одну какую-то функцию, которая не работала. Если бы не терпение — в моменте я уже испотел, и мне хотелось просто всё это закрыть. Но я понимал, что это можно решить и нужно решить, чтобы идти дальше.»
Кому подходит методология TDD с AI-агентом?
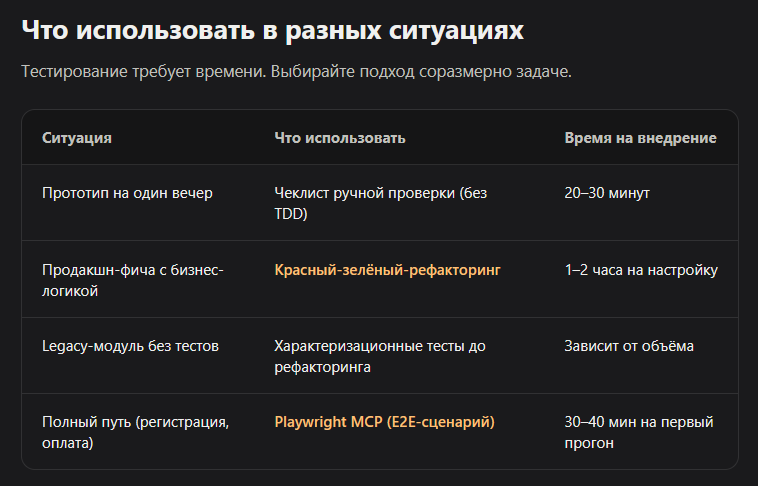
Подходит тем, кто уже пробовал автогенерацию тестов постфактум и получил ложное чувство покрытия. Не обязателен для быстрого прототипа, где важнее скорость, чем надёжность.
| Ситуация | Что использовать | Время на внедрение |
|---|---|---|
| Прототип на один вечер | Чеклист из 7 шагов, без TDD | 20–30 мин |
| Продакшн-фича с бизнес-логикой | Красный-зелёный-рефакторинг + Claude Code | 1–2 часа на настройку |
| Legacy-модуль без тестов | Характеризационные тесты первым делом | Зависит от объёма модуля |
| Полный путь пользователя (регистрация, оплата) | Playwright MCP, E2E-сценарий | 30–40 мин на первый прогон |
| Изучаете TDD с нуля | Пишите тест руками, код отдаёте агенту | — |
Для новичков, которые только осваивают TDD, есть отдельная модификация: тест пишется вручную, а агенту отдаётся только реализация. Это медленнее, зато фокус смещается на то, какой тест писать под конкретное поведение — а это как раз тот навык, который иначе прокачать сложно.
FAQ
Нужно ли писать тесты до кода вручную, если использую AI-агента?
Нет, если вы уже понимаете принцип TDD. Агент пишет тест сам по промпту с описанием поведения. Ручное написание теста полезно только на этапе обучения самому TDD.
Что делать, если агент реализовал больше, чем требовал тест?
Откатить изменение и повторить промпт с явным ограничением: "реализуй только то, что нужно для прохождения этого теста, ничего сверх". Это одна из самых частых причин, почему цикл разваливается уже на второй итерации.
Можно ли использовать Playwright MCP без знания кода?
Да. Команды формулируются на обычном языке: "зайди на страницу, нажми кнопку, проверь что появилось сообщение". Агент сам переводит это в вызовы Playwright.
Чем характеризационный тест отличается от обычного?
Обычный тест проверяет, что система делает то, что должна. Характеризационный фиксирует, что система делает сейчас, независимо от того, правильно это или нет — он нужен как страховка перед изменением кода без тестов.
Сколько раз нужно прогонять интеграционный тест, чтобы доверять результату?
Минимум дважды. Один успешный прогон может быть случайностью — особенно для сценариев, зависящих от тайминга или внешних вызовов.
Как понять, что тест падает по правильной причине?
Прочитать сообщение об ошибке до конца, а не просто увидеть красный статус. Тест должен падать именно на той проверке, которую вы писали, а не на опечатке в настройке окружения.
Нужен ли отдельный файл с инструкциями для Playwright MCP?
Да, обязательно. Без файла с описанием окружения (переменные, тестовый пользователь, база данных) агент либо не сможет запустить сценарий, либо будет угадывать конфигурацию заново при каждом промпте.
Источник по настройке Playwright MCP и документации — playwright.dev. Больше практики по тестированию AI-кода — в базовой статье о чеклисте перед деплоем и в обзоре Claude Code на VibeCoderz. Разобраться с настройкой TDD-цикла под свой проект можно на консультации с Максимом.
Статья подготовлена командой VibeCoderz. Обновлено: октябрь 2026.