
Какую векторную базу данных выбрать в 2026 году для RAG
Если вы уже держите проект на Postgres, для старта хватает pgvector в Supabase: не нужен новый сервис, не нужен отдельный счет. Специализированная векторная база данных вроде Pinecone или Qdrant нужна тогда, когда объем перевалил за несколько миллионов векторов или запросы должны укладываться в единицы миллисекунд. Ниже разберем, чем pgvector, Pinecone и Qdrant отличаются на практике, сколько это стоит в 2026 году и как не промахнуться с выбором на старте.
Векторная база данных хранит эмбеддинги и ищет похожие по смыслу объекты за миллисекунды. pgvector в Supabase закрывает большинство RAG-проектов на старте бесплатно. Pinecone берет от $50 в месяц за управляемость без инфраструктуры, Qdrant дает контроль и низкую задержку на своем железе. В статье: таблица сравнения, реальные цены и критерий выбора под три сценария.
Что такое векторная база данных простыми словами
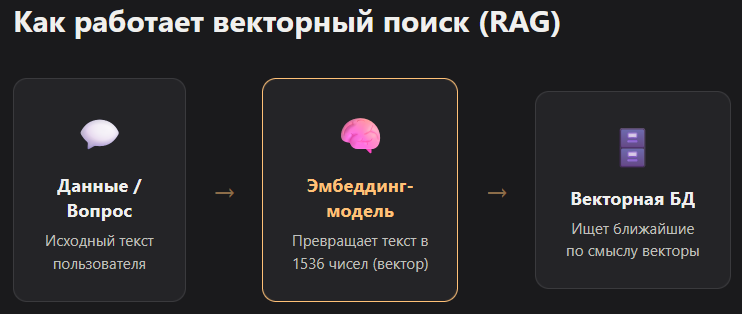
Векторная база данных хранит эмбеддинги, длинные наборы чисел, которые описывают смысл текста, картинки или аудио, и ищет ближайшие по смыслу записи за миллисекунды.
Эмбеддинг — это результат работы модели вроде text-embedding-3-small от OpenAI. Она превращает предложение в вектор из 1536 чисел. Похожие по смыслу тексты получают похожие векторы, и это дает возможность искать не по словам, а по смыслу.
Такой поиск лежит в основе RAG (Retrieval Augmented Generation), семантического поиска и рекомендательных систем. Пользователь задает вопрос, вопрос превращается в вектор, база данных находит ближайшие соседи. Сложность в том, чтобы делать это быстро на миллионах записей. Точный перебор для этого слишком медленный, поэтому все четыре кандидата из этой статьи используют приближенный поиск ближайших соседей.
Чем отличаются HNSW и IVF в векторном поиске
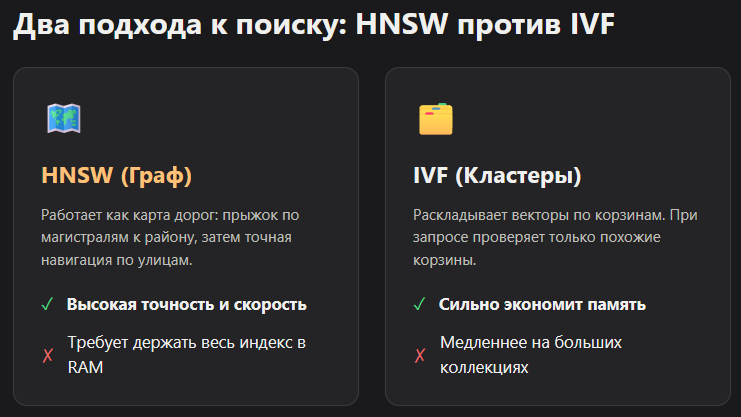
HNSW строит граф-навигатор из связей между векторами и быстрее находит соседей, но требует больше памяти. IVF группирует векторы в кластеры и ищет только в нужных, экономя память ценой скорости.
HNSW (Hierarchical Navigable Small World) работает как карта дорог: сначала прыжок по магистралям к нужному району, потом точная навигация по локальным улицам. IVF (Inverted File Index) заранее раскладывает векторы по корзинам и на запросе проверяет только релевантные корзины, пропуская остальные.
На практике разница ощутима. HNSW дает более высокую точность и скорость запроса, но требует держать весь индекс в оперативной памяти. IVF компактнее по памяти, но проигрывает в скорости на больших коллекциях. Supabase перевела pgvector на HNSW-индекс в 2026 году именно из-за этого разрыва, а до этого стандартом был IVFFlat.
Понимание разницы между HNSW и IVF объясняет большую часть расхождений в бенчмарках, на которые вы наткнетесь при выборе базы. Если в описании инструмента не сказано, какой алгоритм используется по умолчанию, стоит проверить документацию отдельно.
pgvector в Supabase — когда обычного Postgres достаточно
pgvector — расширение PostgreSQL, которое добавляет векторный тип данных и HNSW-индекс прямо в существующую базу. Для проекта, который уже сидит на Supabase, это самый дешевый путь без новой инфраструктуры.
Если у вас уже есть Postgres, включаете расширение и добавляете колонку типа vector. Индекс создается той же командой CREATE INDEX, что и обычный B-tree, только с методом hnsw. Похожесть считается оператором <->, и это обычный SQL, который можно комбинировать с WHERE, JOIN и транзакциями.
Автор pgvector после того, как расширение выстрелило, присоединился к команде Supabase, и с тех пор проект получил заметное ускорение: добавили HNSW-индекс, а по внутренним замерам Supabase pgvector на HNSW обходит IVFFlat по точности и скорости с большим отрывом. При этом ранние сравнения показывали, что специализированные базы вроде Qdrant по чистой скорости запроса могут опережать pgvector в разы, если тот настроен на устаревшем индексе.
Главное ограничение всплывает не на объеме, а на нагрузке: тяжелая фильтрация по метаданным вместе с высоким write throughput кладет одиночный узел Postgres быстрее, чем распределенную систему. Для стартапа с несколькими тысячами документов и умеренным потоком запросов это некритично. Для сотен параллельных агентов, пишущих в базу без остановки, уже стоит присматриваться к альтернативам.
Разработчик Supabase Пол Копплстоун демонстрировал на живом примере, как хранить эмбеддинги рядом с обычными таблицами пользователей и заказов, чтобы получать все данные одним запросом без похода во внешний сервис. Документация Supabase по AI и векторам подробно описывает этот подход, включая партиционирование для сегментации данных.
Pinecone — сколько стоит serverless и кому подходит
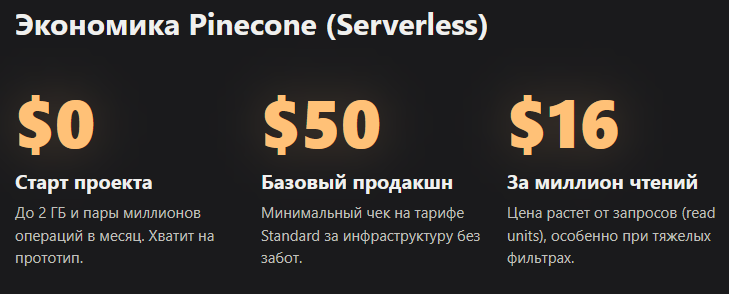
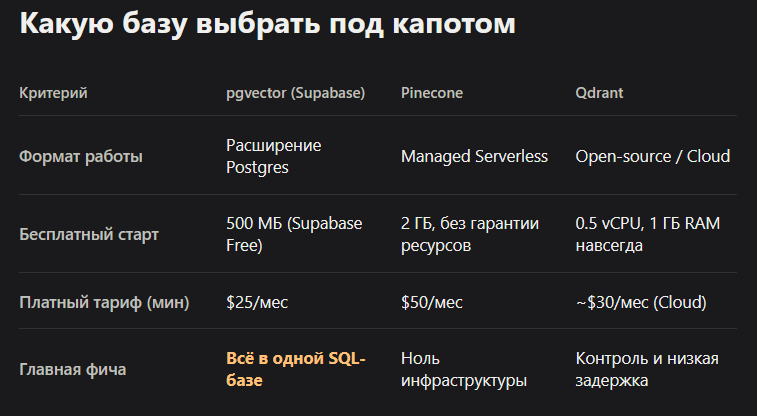
Pinecone — полностью управляемая serverless векторная база. Не нужно поднимать сервер, платите за хранение и операции. Старт бесплатный, продакшн на Standard начинается от $50 в месяц.
Модель оплаты у Pinecone состоит из четырех частей: write units, read units, хранение и капасити-фии на устойчивой нагрузке. Хранение стоит $0,33 за гигабайт в месяц, чтение стартует от $16 за миллион read units, запись от $4 за миллион write units. Free-тир дает 2 ГБ хранения и по несколько миллионов операций в месяц, этого хватает на прототип с сотней тысяч векторов.
Философия Pinecone простая: вы никогда не трогаете инфраструктуру. Индекс создается через API, кластера не масштабируете вручную, алертов о падении ноды не получаете. Это удобно для команды, которая хочет выпустить RAG-фичу быстро и не нанимать человека под администрирование базы данных.
Плата за эту простоту — счет, который может расти неожиданно. Один запрос с фильтрацией по метаданным может стоить 5-10 read units вместо одной, и при миллионе запросов в день это уже $250-500 в месяц только на чтение. AI-агенты, которые пишут в базу на каждой итерации цикла, упираются в write units быстрее, чем в read units, и типичный RAG-калькулятор недооценивает такие сценарии в 3-5 раз.
Qdrant — когда нужен контроль и низкая задержка
Qdrant — открытая векторная база на Rust с нативной фильтрацией и гибридным поиском. Self-hosted версия бесплатна всегда, управляемое облако дает free-тир на 1 ГБ RAM и почасовую оплату сверх этого.
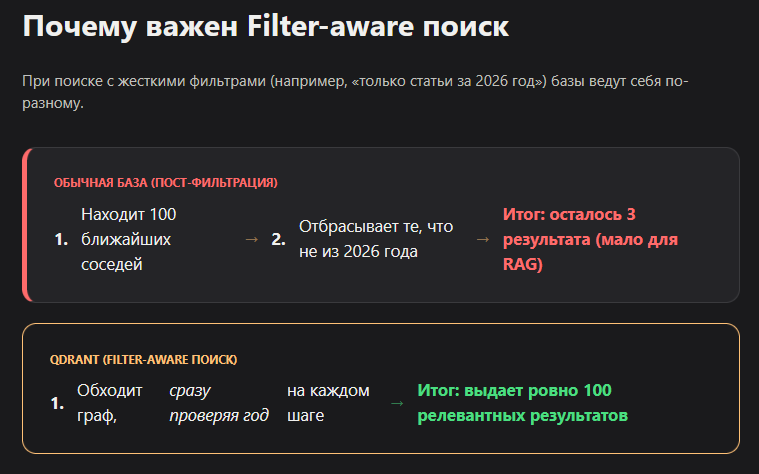
Ключевое отличие Qdrant от Pinecone — фильтрация встроена в сам обход графа HNSW, а не выполняется постфактум. В наивных системах база сначала находит ближайших соседей, а потом отбрасывает те, что не подошли по фильтру, и на узкой выборке результатов может не хватить. Filter-aware поиск Qdrant проверяет условие прямо во время обхода и сохраняет полноту результатов.
По деньгам расклад такой: self-hosted Qdrant на VM за $80-200 в месяц при 5+ миллионах векторов выходит на 70-85% дешевле управляемого Pinecone, но требует своего DevOps-времени на обслуживание. Managed Qdrant Cloud начинается с бесплатного кластера на 0,5 vCPU и 1 ГБ RAM, для прода дальше идет почасовая тарификация от резервируемых ресурсов.
По бенчмарку Timescale картина неоднозначная: pgvector на одном узле может держать более высокий write throughput, а Qdrant стабильно выигрывает по tail latency, то есть по самым медленным запросам из выборки, и лучше масштабируется горизонтально. На малых и средних объемах разница между всеми участниками сравнения почти не заметна, она проявляется только под серьезной нагрузкой.
Pinecone vs Qdrant vs pgvector — таблица сравнения
| Критерий | pgvector (Supabase) | Pinecone | Qdrant |
|---|---|---|---|
| Модель | Расширение Postgres | Managed serverless | Open-source + managed cloud |
| Free-тир | Входит в Supabase Free (500 МБ БД) | 2 ГБ хранения, до 2M write units/мес | 0,5 vCPU, 1 ГБ RAM, 4 ГБ диск, бессрочно |
| Старт платного тарифа | $25/мес (Supabase Pro) | от $50/мес (Standard) | от ~$30-96/мес (Standard) или self-host от $80 |
| Индекс по умолчанию | HNSW | Проприетарный, serverless | HNSW |
| Фильтрация по метаданным | SQL WHERE, JOIN | Поддерживается, увеличивает read units | Filter-aware поиск во время обхода графа |
| Инфраструктура | Не нужна отдельная | Полностью управляемая | Self-host или managed |
| Сильная сторона | Одна база вместо двух сервисов | Zero-ops, быстрый старт | Контроль, низкая tail latency, гибрид |
Сколько стоит каждый вариант на реальных объемах
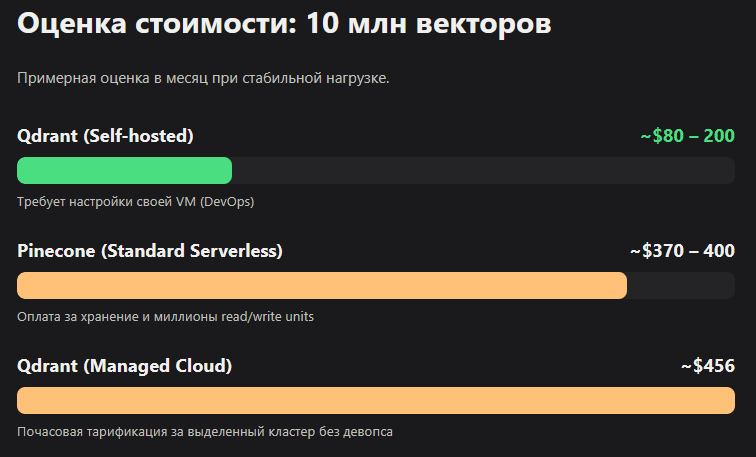
На 100 тысячах векторов все три варианта практически бесплатны. На 10 миллионах Pinecone Standard выходит около $370-400 в месяц, Qdrant Cloud около $456, а self-hosted Qdrant при наличии инженера в команде обгоняет обоих по цене.
Для прототипа на 100 тысяч embeddings 1536-мерности любой из трех вариантов укладывается в бесплатный тир. Разница появляется на масштабе: при 10 миллионах векторов Pinecone Serverless обходится примерно в $370-400 в месяц, managed Qdrant Cloud с той же нагрузкой держится около $456. На 50 миллионах Qdrant Cloud уже выигрывает у Pinecone на треть, а self-hosted Qdrant на VM за $200 в месяц оказывается кратно дешевле обоих, если в команде есть кто-то, готовый следить за кластером.
Supabase Pro стоит $25 в месяц и включает не только базу, но и авторизацию, файловое хранилище и edge-функции, так что для проекта, где векторный поиск лишь одна из фич, экономия считается не по одной строке, а по всему стеку сервисов, которые pgvector заменяет собой.
Максим: «Веб-версию GoBanana собрали за три часа сразу после выхода новой модели. Шесть-восемь часов суммарно на продукт, который принес 12 миллионов рублей выручки. Мы не выбирали инфраструктуру неделями, брали то, что было под рукой, и шли дальше.»
Какую векторную базу выбрать под три сценария
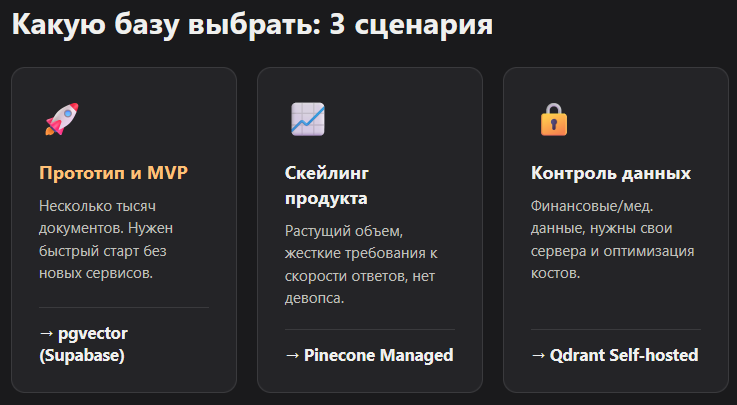
Прототип и малый RAG-проект — pgvector в Supabase, экономит время и деньги. Продакшн с растущим объемом и требованиями к скорости — Qdrant self-hosted или Pinecone managed. Проект с юрисдикционными требованиями к данным — Qdrant self-hosted на своих серверах.
Раскладка простая, если убрать шум из маркетинговых страниц:
- Прототип или MVP с несколькими тысячами документов. Берите pgvector в Supabase. База уже под рукой, новый сервис не нужен, миграция позже не потеряет данные, потому что это все тот же SQL.
- Продакшн с растущим объемом и требованиями к latency. Если команда готова администрировать инфраструктуру, self-hosted Qdrant дает лучший контроль над ценой. Если приоритет — скорость выпуска фичи без найма DevOps, Pinecone managed закрывает это за счет более высокого счета.
- Проект с жесткими требованиями к размещению данных. Qdrant self-hosted на собственных серверах или Hybrid Cloud дает полный контроль над тем, где физически лежат данные, это критично для медицинских и финансовых ниш.
Для телеграм-мини-аппов на Supabase этот выбор особенно приятный: backend и векторный поиск живут в одном месте, подробнее разбирали в гайде по Telegram Mini App на Supabase.
Как не переплатить и не сломать миграцию
Оборачивайте вызовы векторной базы за тонким интерфейсом в коде, а не разбрасывайте их по всему проекту. Это единственный способ поменять базу без переписывания половины приложения.
Паттерн называется Retriever Factory: весь код, который знает про конкретного провайдера, живет в одном модуле, а остальное приложение обращается к общему интерфейсу вроде search(query, filters). Смена бэкенда сводится к правке переменной окружения, а не к рефакторингу RAG-пайплайна целиком.
Есть нюанс, о котором часто забывают: смена модели эмбеддингов требует полного пересоздания индекса, потому что векторы от разных моделей несовместимы по геометрии. Если планируете переход, скажем, с text-embedding-3-small на более новую модель, закладывайте время на реиндексацию заранее, а не в момент, когда старая модель уже отключена у провайдера.
Для тех, кто собирает RAG-пайплайн с нуля и еще не определился с архитектурой поиска, у нас есть отдельный разбор: RAG для вайбкодеров простым языком. Собирать сам пайплайн быстрее через AI-ассистента в коде, например через Cursor или Claude Code: они хорошо понимают SQL-миграции и обвязку над Retriever Factory без ручного написания boilerplate.
Частые ошибки при выборе векторной базы данных
Три ошибки повторяются в разных командах чаще остальных.
Первая: выбор базы данных в одно вечернее заседание без замера реальной нагрузки. Команда смотрит на маркетинговую страницу, а не на свои цифры write throughput и query latency, и через полгода переезжает с сожалением.
Вторая: использование Chroma DB в продакшене. Это удобный инструмент для разработки, SQLite под капотом не рассчитан на конкурентные записи и высокую нагрузку запросов. Строить пайплайн на нем можно, но перед продакшном бэкенд стоит поменять.
Третья: постфильтрация вместо filter-aware поиска. Если база сначала ищет ближайших соседей и только потом отбрасывает те, что не прошли фильтр по метаданным, на узкой выборке результатов может не хватить до нужного количества. Qdrant и Pinecone решают это по-разному, но оба лучше наивной постфильтрации.
Глоссарий
- Эмбеддинг — числовое представление текста, картинки или звука, где похожий смысл дает похожие числа.
- HNSW — алгоритм приближенного поиска ближайших соседей через граф-навигатор, быстрый, но требователен к памяти.
- IVF — алгоритм кластеризации векторов по корзинам для экономии памяти на поиске.
- RAG (Retrieval Augmented Generation) — подход, при котором модель сначала находит релевантные документы через векторный поиск, а потом отвечает на их основе.
- Write throughput — сколько операций записи в секунду выдерживает база данных.
- Query latency — время ответа на один поисковый запрос.
- Tail latency — время ответа на самые медленные запросы из выборки, а не в среднем.
- Filter-aware search — поиск, который применяет фильтр по метаданным во время обхода индекса, а не после.
Часто задаваемые вопросы
Хватит ли pgvector для продакшн-проекта или это только для тестов?
Хватит для большинства RAG-проектов на старте и среднем масштабе. Ограничения появляются при тяжелой фильтрации вместе с высоким write throughput на одном узле, тогда стоит смотреть на Qdrant или Pinecone.
Можно ли перейти с Pinecone на Qdrant без потери данных?
Да, если эмбеддинги сохранены отдельно от индекса, например в объектном хранилище. Тогда переезд сводится к повторной индексации, а не к пересчету векторов заново.
Почему Qdrant называют быстрее pgvector, если бенчмарки показывают обратное?
Смотря что мерить. pgvector на одном узле может выигрывать по write throughput, а Qdrant стабильно выигрывает по tail latency и масштабированию под нагрузкой. Оба утверждения верны одновременно для разных метрик.
Нужна ли отдельная векторная база, если у меня 50 тысяч документов?
Почти наверняка нет. pgvector в Supabase закроет такой объем на бесплатном или базовом платном тарифе без отдельного сервиса.
Что дешевле в 2026 году, Pinecone или self-hosted Qdrant?
На малом объеме Pinecone дешевле за счет бесплатного тира. На 5+ миллионах векторов self-hosted Qdrant обходится дешевле при наличии инженера, готового администрировать кластер.
Что произойдет, если я поменяю модель эмбеддингов?
Индекс нужно пересоздать полностью, потому что векторы от разных моделей несовместимы между собой. Старые данные придется прогнать через новую модель заново.
Подходит ли Chroma DB для продакшена?
Нет, это инструмент для разработки. SQLite внутри плохо держит конкурентные записи, перед продакшном стоит поменять бэкенд на pgvector, Qdrant или Pinecone.
Если собираете RAG-пайплайн и не уверены, какую архитектуру закладывать сразу, а какую можно отложить, весь каталог AI-инструментов для вайбкодинга собран в каталоге VibeCoderz. Разбор конкретно вашего стека и архитектуры можно обсудить на консультации с Максимом.