
vLLM — это open-source библиотека для инференса больших языковых моделей, заточенная под одну задачу: обслуживать десятки и сотни одновременных запросов к одной модели с максимальной пропускной способностью GPU. В отличие от Ollama и LM Studio, которые удобны для личного использования, vLLM решает другую задачу — production serving. Разберем, чем именно отличается назначение этих инструментов, как работает алгоритм PagedAttention, как поднять vLLM в Docker за 15 минут и когда переход на него оправдан, а когда это просто лишняя сложность.
vLLM дает до 24 раз выше пропускную способность, чем стандартные HuggingFace Transformers, за счет PagedAttention и continuous batching. Инструмент подходит, когда модель обслуживает реальный поток пользователей, а не одного человека в чате. В статье: установка через Docker, сравнение с Ollama по цифрам и критерий когда переход оправдан.
Что такое vLLM и чем он отличается от Ollama?
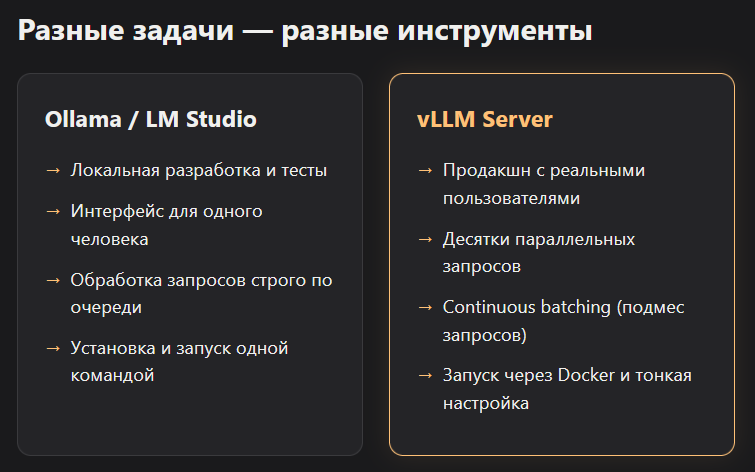
vLLM — это движок инференса для продакшн-нагрузки, а Ollama и LM Studio — инструменты для личного использования одним человеком. Задачи разные, поэтому сравнивать их напрямую некорректно.
vLLM разработан в Sky Computing Lab при Berkeley и с самого начала спроектирован под обслуживание множества параллельных запросов к модели. Ollama и LM Studio оптимизированы под сценарий "один человек, разговор за разговором" — простая установка, удобный интерфейс, минимум настроек.
Ollama запускается одной командой и отлично подходит для прототипа или личного помощника. Но как только к модели одновременно обращаются 10, 50 или 100 пользователей, инструменты для личного использования упираются в потолок пропускной способности — они для этого не проектировались. vLLM решает именно эту задачу: держит модель постоянно загруженной и подмешивает новые запросы в уже идущую генерацию, вместо того чтобы обрабатывать их по очереди.
На практике команда, которая строит внутренний AI-сервис с реальными пользователями, обычно приходит к связке: Ollama или LM Studio для локальной разработки и тестов, vLLM для боевого окружения.
Как работает PagedAttention простыми словами?
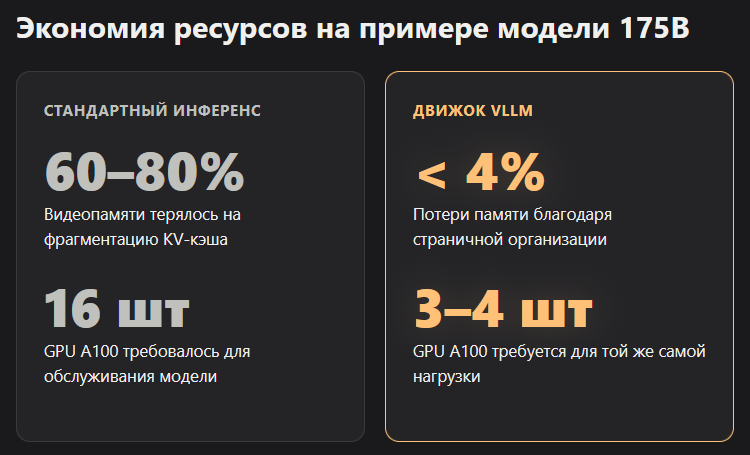
PagedAttention решает проблему фрагментации памяти GPU. Вместо одного большого блока памяти под каждый запрос движок делит KV-кэш на маленькие страницы и переиспользует их между запросами, как виртуальная память в операционных системах.
Без PagedAttention системы теряли 60-80% видеопамяти на фрагментацию при обслуживании модели OPT 175B. С PagedAttention эти потери падают ниже 4%, а число нужных GPU A100 для той же модели снижается с 16 до 3-4 штук.
Смысл проще, чем кажется. Когда LLM генерирует ответ, ей нужно хранить в памяти KV-кэш — промежуточные вычисления внимания для уже сгенерированных токенов. Раньше под каждый запрос выделяли один непрерывный блок памяти "с запасом", потому что заранее неизвестно, насколько длинным будет ответ. Часть этого блока почти всегда простаивала.
PagedAttention поступает иначе: режет KV-кэш на фиксированные блоки, например по 16 токенов, и хранит таблицу, которая сопоставляет логический порядок блоков с их физическим расположением в памяти. Свободные страницы сразу уходят под новые запросы. Отсюда же берется Prefix Sharing — если у нескольких запросов совпадает начало промпта (общий системный промпт, например), они переиспользуют одни и те же страницы памяти вместо дублирования.
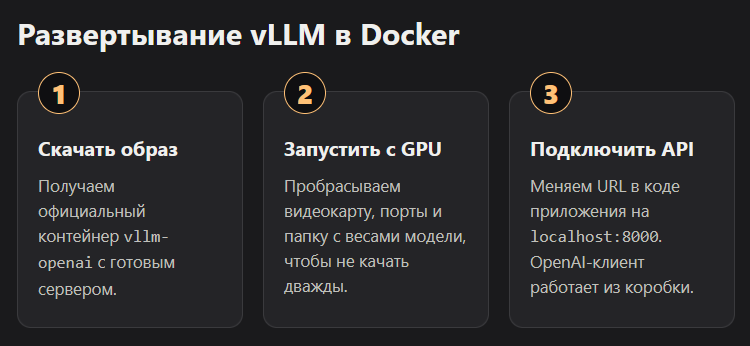
Как запустить vLLM в Docker за 15 минут?
Официальный образ vllm/vllm-openai разворачивает сервер с OpenAI-совместимым API одной командой. Дальше нужно только указать модель, лимит видеопамяти и папку для весов.
Минимальный запуск через Docker занимает один вызов docker run с флагом --gpus all и названием модели. Сервер поднимает эндпоинт на порту 8000, совместимый с клиентом OpenAI, поэтому существующий код на openai-python подключается без переписывания.
Быстрый старт без docker compose:
docker pull vllm/vllm-openai:latest

docker run --runtime nvidia --gpus all \
    -v ~/.cache/huggingface:/root/.cache/huggingface \
    -p 8000:8000 \
    --ipc=host \
    vllm/vllm-openai:latest \
    --model openai/gpt-oss-20b
Для постоянного окружения удобнее docker-compose.yml: там же задается gpu-memory-utilization (обычно 0.9-0.95, чтобы не занимать всю VRAM), директория для скачанных весов, чтобы не грузить модель заново при каждом перезапуске, и shm-size порядка 64 ГБ под параллельные тензорные операции. Флаг --ipc=host критичен для мультигпу-конфигураций — без него процессы не смогут нормально обмениваться данными.
После первого запуска модель качается один раз и хранится в примонтированной папке. Логи стоит держать под рукой командой watch -n 1 docker compose logs vllm — так видно, на каком этапе загрузки весов застрял контейнер, если что-то пошло не так.
Максим: «Мог просто засесть до пяти ночи и просто там править одну какую-то функцию, которая не работала. Если бы не терпение, в моменте я уже испотел и мне хотелось просто всё это закрыть. Но я понимал, что это можно решить и нужно решить, чтобы идти дальше.»
Настройка Docker Compose для vLLM редко идет гладко с первого раза, обычно правишь порты, память и переменные окружения по кругу. На третьей итерации обычно все встает на место.
vLLM или Ollama: что реально быстрее под нагрузкой?
По независимым бенчмаркам vLLM обходит Ollama в разы при параллельных запросах, но проигрывает в простоте установки. Для одного пользователя разница почти не ощущается.
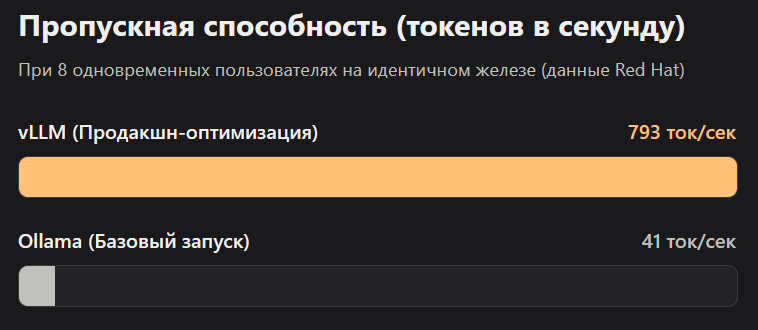
Red Hat в своем тесте зафиксировал у vLLM около 793 токенов в секунду на пике против 41 у Ollama на идентичном железе, а P99-задержка составила 80 мс против 673 мс. При восьми одновременных пользователях vLLM показал прирост пропускной способности примерно в 2,3 раза.
| Критерий | vLLM | Ollama | LM Studio |
|---|---|---|---|
| Назначение | Продакшн-serving | Локальная разработка | GUI для личного использования |
| Пропускная способность (пик) | ~793 ток/с | ~41 ток/с | Сопоставимо с Ollama |
| Параллельные запросы | Сильная сторона | Слабое место | Не рассчитан на нагрузку |
| Установка | Docker, требует настройки | Одна команда | Графический установщик |
| OpenAI-совместимый API | Есть | Есть | Есть |
| Кому подходит | Реальный поток пользователей | Прототип, один человек | GUI без терминала |
Разница особенно заметна при генерации со структурой output, например, когда модель обязана вернуть валидный JSON. На некоторых инференсах скорость в этом режиме падает кратно, а vLLM держит просадку минимальной за счет батчинга запросов с похожей структурой.
Когда переходить на vLLM, а когда это лишняя сложность?
Если модель обслуживает одного человека, тесты или редкие запросы небольшой команды, Ollama и LM Studio полностью достаточны. vLLM оправдан, когда есть реальный поток параллельных запросов и цена простоя GPU высока.
Разворачивать vLLM для личного use case, где нет параллельной нагрузки, это избыточное усложнение: настройка сервера, мониторинг видеопамяти и Docker-инфраструктуры не окупятся приростом скорости, которого никто не заметит.
Честный критерий такой. Личное использование, прототипирование, редкие запросы небольшой команды — берите Ollama или LM Studio, разница в скорости для одного диалога не стоит усилий на настройку. Продакшн-сервис, который реально держит поток запросов от пользователей приложения или сайта, где важны пропускная способность и стоимость GPU-часа, это ровно тот сценарий, ради которого vLLM создавался.
Есть и промежуточный вариант: часть команд запускают Ollama локально для разработки и переключаются на vLLM только при деплое в боевое окружение. Такой подход снимает вопрос выбора одного инструмента навсегда.
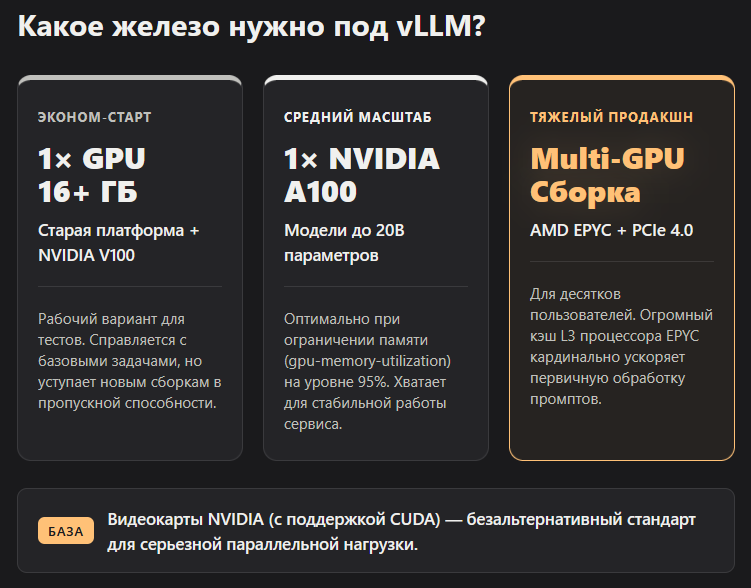
Какое железо нужно под vLLM-сервер?
Для запуска достаточно одной GPU с 16+ ГБ видеопамяти, но под серьезную параллельную нагрузку нужны видеокарты NVIDIA с поддержкой CUDA и процессор с большим кэшем L3.
Один A100 закрывает задачи среднего масштаба, например модель на 20 млрд параметров с ограничением gpu-memory-utilization на уровне 95%. Для продакшн-нагрузки с десятками параллельных пользователей команды чаще берут связку из нескольких GPU и материнской платы с поддержкой PCIe 4.0.
NVIDIA остается предпочтительным вариантом за счет поддержки CUDA и экосистемы вокруг нее. Для собранного своими руками сервера подойдут платформы на базе AMD EPYC 7-й или 9-й серии с DDR4/DDR5 и материнскими платами уровня Supermicro H12-H14: большой кэш L3 у процессора ускоряет обработку промптов. Экономварианты вроде связки старой платформы с картой уровня V100 тоже рабочие, но проигрывают в пропускной способности новым сборкам.
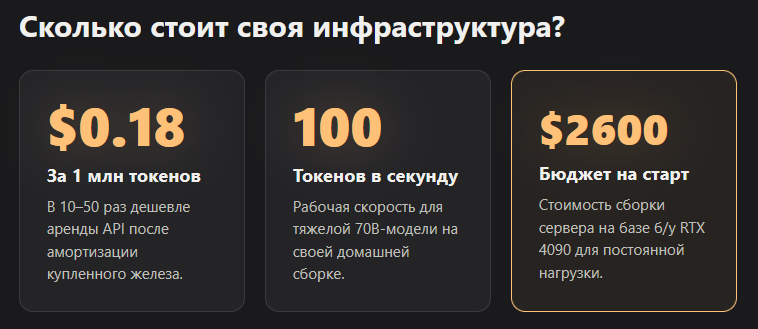
Сколько стоит своя инфраструктура на vLLM?
После амортизации железа локальный инференс через vLLM обходится примерно в 0,18-0,29 доллара за миллион токенов, что в 10-50 раз дешевле облачных API.
Собранный из пары б/у RTX 4090 сервер стоит порядка 2200-2600 долларов и вытягивает 4-битную 70B-модель на скорости около 100 токенов в секунду, что для команды с постоянной нагрузкой окупается быстрее, чем аренда API у внешнего провайдера.
Экономика простая: облачные API берут оплату за каждый токен независимо от загрузки, а собственный vLLM-сервер после покупки железа обходится в стоимость электричества и обслуживания. При стабильном высоком потоке запросов разница накапливается за недели, а не месяцы. Обзор полного локального AI-стека без затрат на подписки собран в статье локальный AI-стек для вайбкодинга за 0 рублей.
Сильные и слабые стороны vLLM
Сильные стороны:
- Пропускная способность в разы выше конкурентов за счет PagedAttention и continuous batching, подтверждено независимыми бенчмарками.
- OpenAI-совместимый API — переезд с облачного провайдера на свой сервер не требует переписывать код приложения.
- Предсказуемая задержка и полный контроль над стоимостью инференса без лимитов внешнего API.
Слабые стороны:
- Нужно управлять сервером самостоятельно: мониторинг видеопамяти, обновления образа, настройка Docker остаются на команде.
- Не каждая модель из Hugging Face сразу заводится под vLLM, иногда проще запустить ее на llama.cpp.
- Для одного пользователя выигрыш в скорости почти не ощущается, а сложность настройки выше, чем у Ollama.
Частые вопросы про vLLM
Нужен ли vLLM для домашнего использования?
Нет. Для личных задач и тестов Ollama или LM Studio проще в установке и дают сопоставимый опыт без настройки Docker и мониторинга GPU.
Какая минимальная видеокарта подходит для vLLM?
Ориентир — от 16 ГБ видеопамяти на NVIDIA-карте, для моделей на 20 млрд параметров и выше комфортнее работать на A100 или сопоставимом железе.
Работает ли vLLM с квантованными моделями?
Да, поддерживаются форматы с квантованием, но конкретная поддержка зависит от модели: не все версии из Hugging Face заводятся под vLLM сразу.
Чем vLLM лучше llama.cpp для продакшена?
vLLM сильнее в параллелизации запросов и держит меньшую просадку скорости при генерации со структурой output, например JSON. llama.cpp проще запускается, но хуже масштабируется под нагрузку.
Можно ли использовать vLLM бесплатно?
Да, это open-source проект, платить нужно только за железо или облачные GPU-инстансы, на которых он развернут.
Сколько времени занимает первый запуск vLLM?
Настройка Docker Compose и первый запуск занимают около 15 минут, но реальное время подготовки к работе зависит от скорости скачивания весов модели.
Обязательно ли использовать Docker для vLLM?
Нет, можно установить через pip install vllm и запустить Python API напрямую, но Docker упрощает воспроизводимость и изоляцию от зависимостей хоста.
Источники: официальный репозиторий vLLM на GitHub, документация vLLM.
Каталог AI-инструментов и IDE для вайбкодинга смотрите в каталоге на VibeCoderz. Если нужна помощь с выбором инфраструктуры под конкретный продукт, запишитесь на консультацию к Максиму.
Обновлено: октябрь 2026.