
Открываете каталог моделей на Hugging Face, вводите название модели — и видите не один файл, а десяток вариантов с припиской вроде Q4_K_M или Q8_0. Это не разные модели. Это одна и та же нейросеть, сохраненная с разной точностью хранения весов — и в этой статье разберем, что означает каждая буква и цифра в названии GGUF-файла и как выбрать конкретный уровень квантизации под свое железо.
В 2026 году система обозначений GGUF-квантизации единая для любой модели: Qwen, Llama, DeepSeek, Gemma. Q4_K_M остается стандартом по умолчанию для большинства пользователей, Q5_K_M — разумный компромисс при запасе видеопамяти, Q8_0 почти не отличим от полной точности, но требует заметно больше ресурсов. Ниже — расшифровка по частям, таблица сравнения и практическое правило выбора без сложных расчетов.
Что вообще означают буквы и цифры в названии GGUF-файла
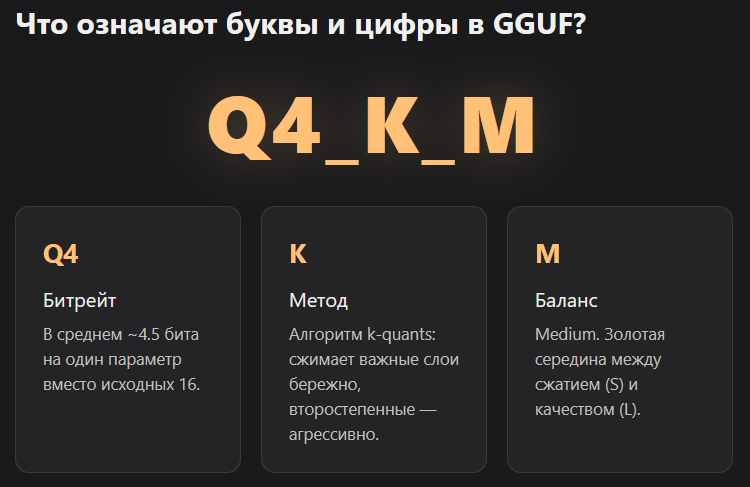
Название вида Q4_K_M состоит из трех частей: Q4 — количество бит на параметр после сжатия, K — метод квантизации с неравномерным распределением точности, M — конкретный вариант баланса внутри этого метода.
Разработчики llama.cpp сжимают исходную модель в несколько бит на параметр вместо изначальной точности FP16 или FP32. Чем меньше цифра после Q, тем компактнее файл и тем выше риск заметить потерю в качестве ответов.
Разберем по частям. Число после буквы Q — не точное, а среднее количество бит на параметр. У Q4 это около 4-4.5 бита, у Q5 около 5-5.5, у Q8 около 8. Буква K означает, что используется современный алгоритм k-quants: он распределяет точность неравномерно, важные для качества слои сжимает бережнее, второстепенные — агрессивнее. Без буквы K (как в старом Q4_0) сжатие идет одинаково по всем весам, и результат почти всегда хуже при том же размере файла.
Финальная буква — S, M или L — уточняет вариант внутри k-quants. S значит small, самое агрессивное сжатие. M — medium, золотая середина и выбор по умолчанию для большинства задач. L — large, максимум качества внутри этого битрейта ценой размера файла. Q4_K_M, например, хранит часть тензоров attention и feed-forward в более точном Q6_K, а остальное — в Q4_K, поэтому заметно обгоняет по качеству старый линейный Q4_0 при похожем размере.
Q4 против Q5 против Q8 — в чем практическая разница
Q4_K_M — компромисс по умолчанию: компактный файл, минимальная для большинства задач потеря качества. Q5_K_M чуть точнее ценой размера. Q8_0 почти неотличим от полной точности, но весит в разы больше и требует значительно больше видеопамяти.
Разница между уровнями — это всегда обмен: меньше бит на параметр значит меньше памяти и выше скорость генерации, но выше и шанс заметить деградацию на сложных задачах вроде длинного контекста или строгого JSON-формата.
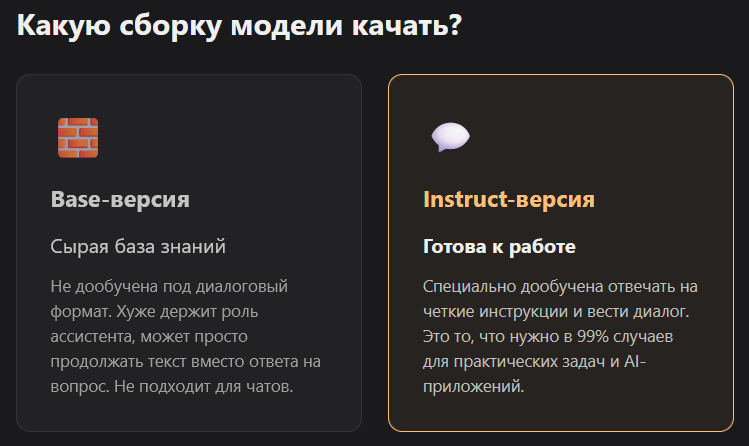
На практике для модели около 7B параметров разброс размеров выглядит так: Q4_K_M — около 3.8 ГБ, Q5_K_M — около 4.45 ГБ, Q6_K — около 5.15 ГБ, Q8_0 — уже почти вдвое больше Q4. При этом разница в качестве между Q4_K_M и Q8_0 на бытовых задачах — код, чат, суммаризация — часто незаметна на слух. А вот скорость генерации у Q4 обычно выше, потому что видеокарте и процессору нужно прочитать меньше данных из памяти за один проход.
| Уровень | Примерный битрейт | Размер (модель 7B) | Когда выбирать |
|---|---|---|---|
| Q3_K_M | ~3.3 бита | ~3.1 ГБ | Меньше 8 ГБ видеопамяти, простые задачи |
| Q4_K_S | ~4.3 бита | ~3.6 ГБ | Нужен запас памяти под контекст |
| Q4_K_M | ~4.5 бита | ~3.8 ГБ | Баланс по умолчанию, рекомендация для большинства |
| Q5_K_M | ~5.1 бита | ~4.45 ГБ | Есть 16+ ГБ видеопамяти, важна точность |
| Q6_K | ~6.0 бит | ~5.15 ГБ | Почти без потерь, но заметно тяжелее |
| Q8_0 | ~8 бит | ~7.5 ГБ | Максимум качества, память не проблема |
Источник методологии измерений: спецификация квантизации llama.cpp.
Почему почти все рекомендуют именно Q4_K_M
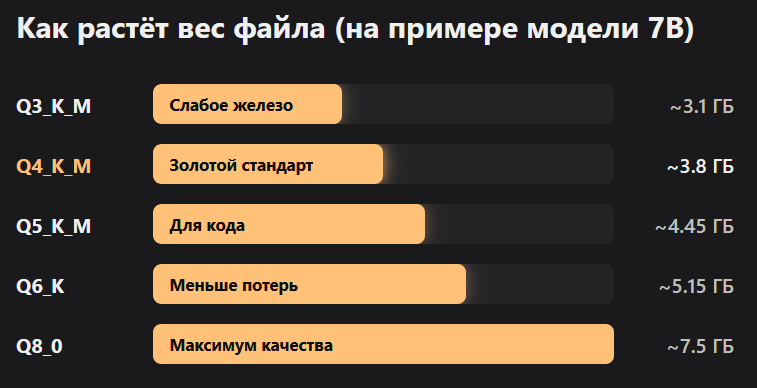
Q4_K_M чаще всего встречается в рекомендациях LM Studio, Hugging Face и сообщества llama.cpp — он дает лучший баланс между качеством, скоростью и объемом занятой памяти для большинства повседневных задач.
Дело не в том, что Q4_K_M — универсально лучший вариант. Дело в том, что для домашнего железа с 8-16 ГБ видеопамяти это точка, где модель еще помещается целиком, а качество ответов в программировании, анализе документов и обычном чате падает незначительно.
Разница ощущается на специфических сценариях: длинный контекст на 30 000+ токенов, строгая генерация JSON без единой ошибки в структуре, математика с длинными цепочками вычислений. Здесь Q5_K_M или Q6_K дают заметно более стабильный результат — но для стандартного рабочего чата с моделью переплата в память часто не окупается.
Q2_K и ниже — не бесполезное квантование, вопреки мифу. Оно годится, когда ресурсов критически мало или модель нужна только для простых задач вроде классификации короткого текста, где важнее скорость, а не глубина рассуждений.
Как читать название GGUF-файла на Hugging Face
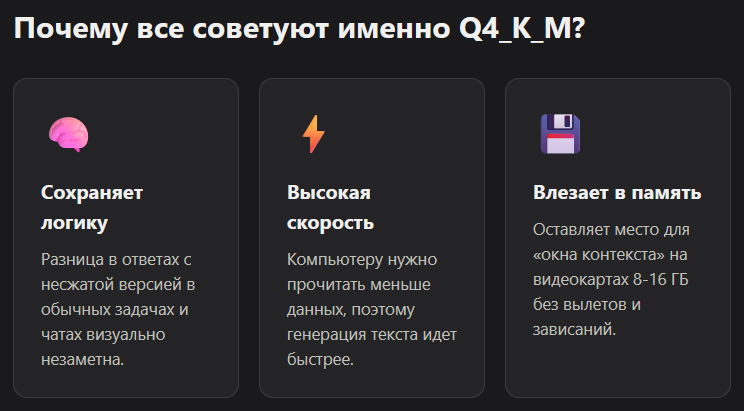
Полное имя файла обычно включает название модели, тип сборки (base или instruct) и уровень квантизации через нижнее подчеркивание, например Qwen3-7B-Instruct-Q4_K_M.gguf.
Перед скачиванием стоит проверить три вещи: тип сборки, реальный размер файла и метод компрессии.
Base-версия — это модель без дообучения под диалоговый формат, она хуже держит роль ассистента и часто не годится для чат-приложений напрямую. Instruct-версия дообучена отвечать на инструкции — это то, что нужно почти всегда для практических задач. Дальше стоит открыть карточку файла и свериться с реальным размером в гигабайтах, а не полагаться на цифру в названии: для моделей с архитектурой Mixture-of-Experts (MoE) 4-битная версия не всегда заметно легче 8-битной, потому что активных параметров там меньше, чем заявлено в общем счетчике.
Отдельно стоит смотреть на метод компрессии в описании репозитория. GGUF — не единственный формат: GPTQ, AWQ и EXL2 тоже квантуют модели, но заточены под другие движки (vLLM, ExLlama, TensorRT), а не под Ollama и LM Studio. Если модель планируется запускать локально через llama.cpp-совместимый инструмент — нужен именно GGUF.
Как квантизация влияет на скорость и качество ответов
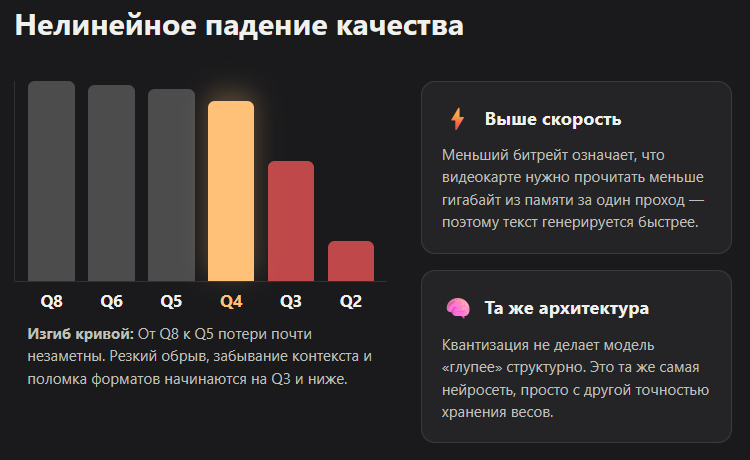
Меньший битрейт почти всегда означает более высокую скорость генерации, потому что видеокарта читает меньше данных из памяти за один проход. Качество при этом падает не линейно — до определенного порога потери почти незаметны, а дальше начинают резко расти.
Полезно представить это не как прямую линию, а как кривую с изгибом. От Q8 к Q5 качество почти не меняется, а от Q3 к Q2 деградация становится заметной: модель чаще забывает детали контекста, путается в инструкциях, слабее держит формат вывода.
Технология квантизации не меняет архитектуру модели — та же самая нейросеть, просто с другой точностью хранения весов. Поэтому корректнее говорить не о "более слабой модели", а о другом варианте хранения одной и той же модели. QAT (Quantization-Aware Training) — отдельный подход, где модель дообучают уже с учетом будущего сжатия, и такие версии обычно теряют меньше качества на том же битрейте по сравнению с обычным пост-тренинг квантованием.
Какую квантизацию выбрать под свое железо
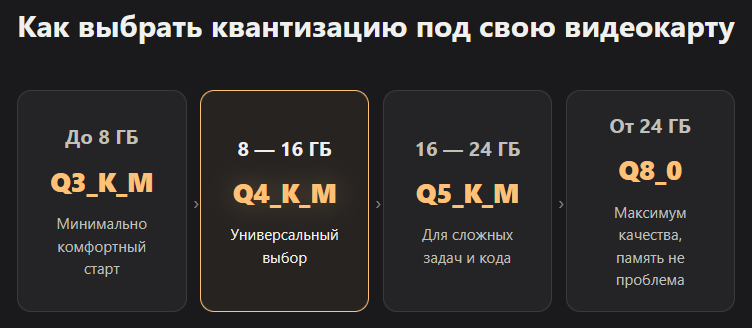
Правило без сложных расчетов: меньше 8 ГБ видеопамяти — берите Q3_K_M, 8-16 ГБ — Q4_K_M, 16-24 ГБ — Q5_K_M, от 24 ГБ — можно смело ставить Q6_K или Q8_0.
Это не абсолютная формула, а стартовая точка, которая почти всегда работает без экспериментов.
Отдельно стоит учитывать контекстное окно: чем длиннее диалог или документ, который загружается в модель, тем больше памяти уходит на KV-кэш поверх самих весов. Если модель на границе по памяти, лучше на один уровень квантизации ниже, чем упереться в нехватку памяти на середине генерации.
Максим: «Я один из первых в РФ начал гонять локальные модели через Windsurf и подобные штуки еще в Аргентине, когда делал первое приложение — голос в текст через Whisper на MacBook. Скорость и то, что все крутится у тебя на машине без интернета, реально решает задачу, когда нужно быстро и без ожидания ответа от внешнего API.»
Стоит ли всегда качать самую тяжелую версию
Нет. Больший размер файла не равно более умная модель — это лишь более высокая точность хранения тех же весов, а не расширение архитектуры или знаний модели.
Миф про Q8, который всегда лучше Q4, тоже не подтверждается на практике: на домашнем компьютере Q8 может работать заметно медленнее из-за нагрузки на память, а разницу в ответах пользователь часто вообще не замечает.
Правильный подход — выбрать квантизацию, которая максимально эффективно использует ресурсы конкретного компьютера, а не гнаться за самым тяжелым файлом в репозитории. Повышать уровень стоит только тогда, когда на конкретной задаче замечена реальная нехватка качества и есть запас видеопамяти под это.
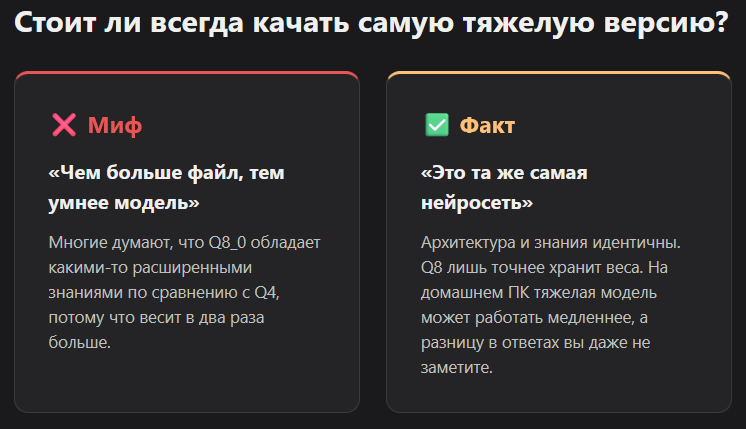
Таблица выбора по типу задачи
| Задача | Рекомендуемый уровень | Комментарий |
|---|---|---|
| Обычный чат, бытовые вопросы | Q4_K_M | Разница с Q8 почти не ощущается |
| Код и рефакторинг | Q4_K_M – Q5_K_M | На сложных функциях Q5 стабильнее |
| Длинный контекст, документы | Q5_K_M – Q6_K | Меньше ошибок на дальних токенах |
| Строгий JSON и структурированный вывод | Q6_K – Q8_0 | Меньше риска сломать формат |
| Слабое железо, до 8 ГБ VRAM | Q3_K_M | Минимальный комфортный вариант |
| Максимум точности, память не проблема | Q8_0 | Почти неотличимо от FP16 |
Часто задаваемые вопросы
В чем разница между Q4_K_M и Q4_0?
Q4_0 сжимает все веса модели одинаково. Q4_K_M использует k-quants — важные слои хранит точнее, второстепенные сжимает сильнее. При похожем размере файла Q4_K_M почти всегда дает более качественные ответы.
Можно ли поставить Q8_0, если видеопамяти впритык?
Не стоит. Модель либо не поместится целиком, либо часть весов уйдет в оперативную память, и скорость генерации резко упадет. Лучше взять Q4_K_M или Q5_K_M с запасом под контекст.
Q5_K_M заметно лучше Q4_K_M?
На обычных задачах разница минимальна. На длинном контексте, сложном коде и строгом JSON-формате Q5_K_M дает более стабильный результат за счет чуть большей точности хранения весов.
Что означает буква S, M или L после K в названии файла?
Это конкретный вариант баланса внутри k-quants на одном битрейте. S — сильнее сжатие и меньше размер, M — сбалансированный вариант по умолчанию, L — максимум качества на этом уровне ценой размера файла.
Нужно ли всегда скачивать instruct-версию модели?
Для чат-приложений и практических задач — да. Base-версия не дообучена следовать инструкциям и хуже работает как ассистент.
Влияет ли квантизация на архитектуру модели?
Нет. Архитектура и число параметров остаются теми же, меняется только точность хранения весов. Это другой способ хранения той же самой нейросети, а не другая модель.
Чем GGUF отличается от GPTQ и AWQ?
Все три — методы квантизации, но заточены под разные движки. GGUF работает с llama.cpp, Ollama и LM Studio. GPTQ и AWQ чаще используют с vLLM и ExLlama на серверных GPU. Для локального запуска на домашнем компьютере нужен именно GGUF.
Дальше по теме на портале: разбор DeepSeek Coder в формате GGUF на конкретном примере модели, GGUF без цензуры — что это значит технически, и llama.cpp — движок под капотом Ollama и LM Studio. Полный каталог AI-инструментов и IDE — в каталоге VibeCoderz. Если нужно разобраться со связкой инструментов под свои задачи — можно записаться на консультацию к Максиму.
Обновлено: октябрь 2026.