
GLM 5.3 Flash от Z.ai (бывшая Zhipu AI) вышла 26 августа 2026 и сразу стала самой дешевой моделью своего уровня для кода. Внутри 320 млрд параметров, из которых работают 18 млрд, открытая лицензия MIT, контекст 1 млн токенов и вход для картинок и видео. Старшая GLM 5.3 вышла чуть раньше, 14 августа, и целится в сложную инженерию и кибербезопасность. Ниже разберем характеристики обеих моделей, бенчмарки, реальные тесты из YouTube, цены и варианты доступа из России.
TL;DR. GLM 5.3 Flash стоит $0,15/$0,50 за 1M токенов, работает по MIT и понимает скриншоты, а по коду почти догоняет старшую GLM 5.3 (63,4 против 66,9 в DeepSWE). GLM 5.3 сильнее в больших репозиториях и безопасности, но в 9 раз дороже на вход. В статье: две таблицы сравнения, итоги тестов и карта выбора.
Что такое GLM 5.3 и GLM 5.3 Flash от Z.ai?
Это две модели одного поколения от китайской Z.ai. GLM 5.3 тяжелая и текстовая, GLM 5.3 Flash легкая, мультимодальная и почти в 10 раз дешевле.
GLM 5.3 вышла 14 августа 2026 и выросла из GLM 5.2 только за счет дообучения, без новой базовой модели. GLM 5.3 Flash появилась 26 августа 2026 как отдельная архитектура на 320 млрд параметров с гибридным вниманием. Обе модели держат 1 млн токенов контекста и до 128 тыс. токенов на выходе.
Z.ai раньше называлась Zhipu AI и работает на рынке с 2019 года. Ее модели GLM давно в топе открытых нейросетей для кода, а у нас на портале есть полный обзор экосистемы GLM.
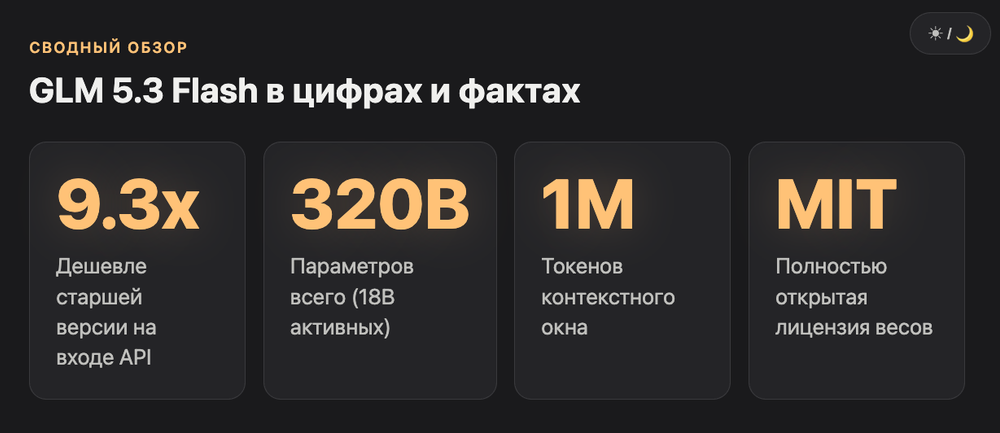
Летний релиз устроен так. Сначала вышла флагманская GLM 5.3 со ставкой на агентное программирование и поиск уязвимостей. Через 12 дней Z.ai выкатила Flash, которая берет другим: ценой, открытостью и тем, что видит картинки. Через пару недель добавилась FlashX, та же модель на более быстрой инфраструктуре.
Короче, сейчас у Z.ai три актуальные модели для кода. И выбирать между ними придется по задаче, а не по номеру версии.
Чем GLM 5.3 Flash отличается от GLM 5.3 по характеристикам?
Flash в два с лишним раза меньше, видит изображения и видео, распространяется по MIT. GLM 5.3 крупнее, работает только с текстом и идет под собственной лицензией.
По данным Z.ai и CometAPI, GLM 5.3 Flash содержит 320 млрд параметров при 18 млрд активных, а GLM 5.3 около 744 млрд при 40 млрд активных. Flash принимает текст, картинки, видео и файлы, GLM 5.3 только текст. Рассуждение у обеих включено всегда.
Главная инженерная фишка Flash в гибридном внимании: модель совмещает разреженное и линейное внимание. Z.ai пишет, что это первая открытая модель такого уровня с подобной схемой. На практике это дает в 3 раза меньше вычислений на внимание и в 4,4 раза меньший KV-кэш, чем у GLM 5.3. Для длинных контекстов разница ощутимая.
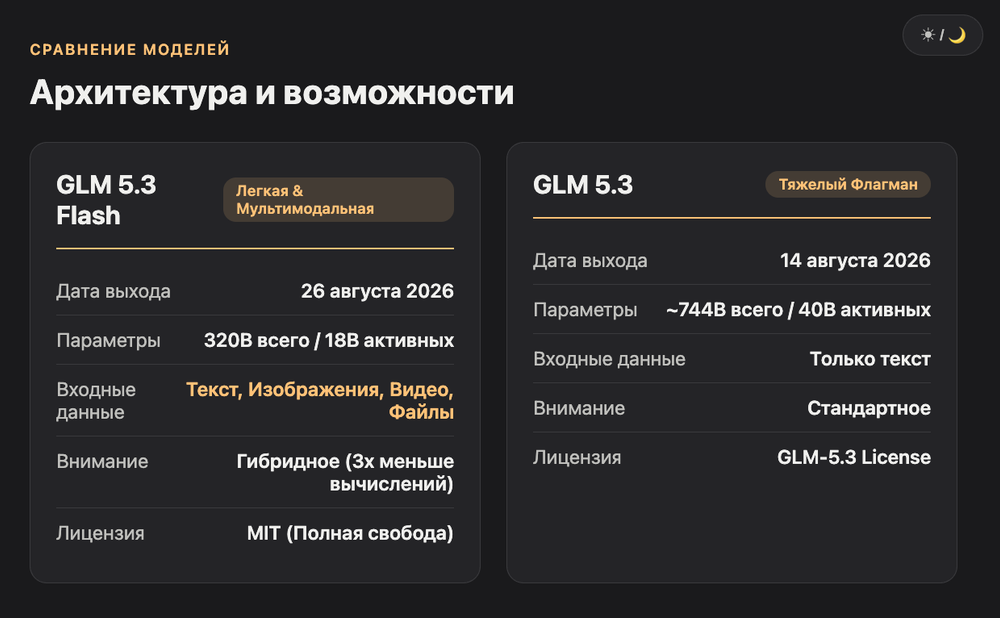
| Параметр | GLM 5.3 Flash | GLM 5.3 |
|---|---|---|
| Дата выхода | 26 августа 2026 | 14 августа 2026 |
| Параметры (всего / активных) | 320 млрд / 18 млрд | ~744 млрд / 40 млрд |
| Контекст / вывод | 1M / 128K | 1M / 128K |
| Вход | текст, изображения, видео, файлы | только текст |
| Лицензия весов | MIT | GLM-5.3 License |
| Отключение рассуждений | нельзя | нельзя |
С лицензией есть нюанс. Веса GLM 5.3 появились на Hugging Face 25 августа, но под собственной лицензией: компаниям с выручкой больше $10 млрд, которые продают доступ к модели, нужна проверка безопасности. Для вайбкодера это ничего не меняет, а вот MIT у Flash снимает любые вопросы с коммерческим использованием.
Что показывают бенчмарки GLM 5.3 ai и Flash?
Старшая GLM 5.3 выигрывает в чистой инженерии кода, Flash неожиданно обходит ее в работе с инструментами и автоматизации. Разрыв по коду небольшой, 3-4 пункта.
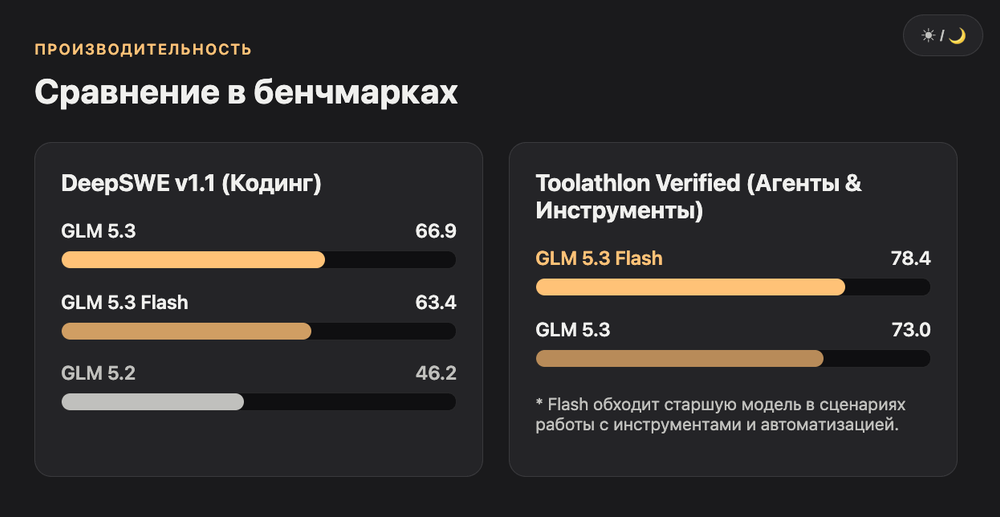
В DeepSWE v1.1 GLM 5.3 набирает 66,9, а GLM 5.3 Flash 63,4, тогда как прошлая GLM 5.2 давала 46,2. В Terminal-Bench 2.1 счет 88,2 против 84,3. Зато в Toolathlon Verified Flash впереди: 78,4 против 73,0. То есть легкая модель уверенно работает в агентных сценариях.
| Бенчмарк | GLM 5.3 Flash | GLM 5.3 | GLM 5.2 |
|---|---|---|---|
| DeepSWE v1.1 | 63,4 | 66,9 | 46,2 |
| Terminal-Bench 2.1 | 84,3 | 88,2 | нет данных |
| Terminal-Bench 3.0 | нет данных | 28,3 | 4,6 |
| Toolathlon Verified | 78,4 | 73,0 | нет данных |
| AutomationBench | 48,8 | 48,2 | 26,2 |
| CyberGym | нет данных | 84,5% | нет данных |
Данные из документации Z.ai и сводок сторонних агрегаторов, по состоянию на октябрь 2026.
Почему к цифрам стоит относиться осторожно
Один из англоязычных обзорщиков в нашей подборке видео подметил хорошую деталь. Terminal-Bench 2.1 и 3.0 дают для одной и той же GLM 5.3 результаты 88,2 и 28,3. Так что любой цифре нужна версия бенчмарка, иначе сравнение теряет смысл.
Часть замеров Z.ai сделала на своем закрытом ZAI Code Bench. Подглядеть ответы модель там не могла, но и проверить результат со стороны нельзя. Независимый индекс Artificial Analysis ставит GLM 5.3 на первое место среди 112 открытых моделей, и это, пожалуй, самая надежная оценка из всех.
Как GLM 5.3 Flash справляется с реальными проектами?
По тестам русско- и англоязычных блогеров Flash хорошо пишет игры, ботов и дашборды, но работает медленно и путается в сложной визуализации вроде воды и стекла.
Мы разобрали 10 видеообзоров GLM 5.3 и GLM 5.3 Flash, вышедших в августе-сентябре 2026. В прямом сравнении на клоне GTA Flash выдала лучший результат: машины по-разному разгоняются и тормозят, пешеходы уворачиваются. А на симуляторе цунами провалилась: вода осталась статичной и ничего не смывала.
Игры и симуляторы
В тесте «GLM 5.3 Flash vs GLM 5.3» автор дал обеим моделям четыре одинаковых промпта. На клоне GTA и симуляторе аварий младшая модель выиграла: физика машин живее, искры и частицы отрисованы лучше. Полиция у Flash, правда, работала с багами, а у GLM 5.3 гонялась как надо. Симулятор цунами не дался ни одной модели, но у Flash вода вообще не двигалась.
Веб, боты и мобильные приложения
В русскоязычном тесте Flash собрала лендинг с анимациями, мини-игру и приложение на Flutter для подбора фильмов. Но на мобильное приложение ушло больше часа. В 3D-аквариуме модель запуталась со слоями и стеклом, а бургер-меню на мобилке не открывалось, классическая болячка нейросетей.
Еще один автор писал Telegram-бота на Python и Aiogram. Простой бот, база на SQLite3, каталог товаров, викторина с рейтингом игроков: со всем справилась. Слабое место нашлось в HTML-разметке сообщений.
Лайфхак из видео: в промпте для бота сразу требуйте parse_mode=ParseMode.HTML. Без этого Flash периодически выводит теги текстом прямо в чат.
Сколько стоит GLM 5.3 нейросеть через API и Coding Plan?
Официальный API GLM 5.3 Flash стоит $0,15 за 1M входящих и $0,50 за 1M исходящих токенов. GLM 5.3 обойдется в $1,40 и $4,40, цена не изменилась с GLM 5.2.
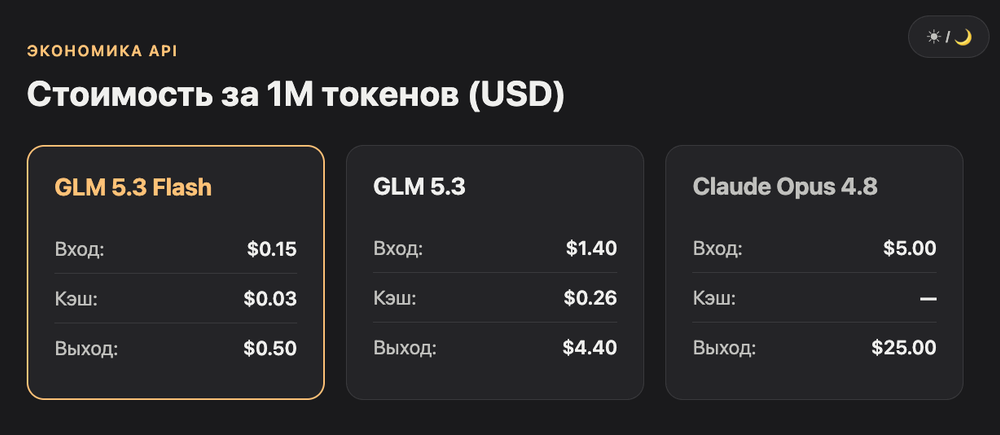
По прайсу Z.ai на октябрь 2026 GLM 5.3 Flash дешевле старшей GLM 5.3 в 9,3 раза на входе и в 8,8 раза на выходе. Для сравнения, Claude Opus 4.8 стоит $5/$25, DeepSeek V4 Pro $0,435/$0,87. По цене Flash играет в одной лиге с самыми бюджетными кодерами.
| Модель | Вход, $/1M | Кэш, $/1M | Выход, $/1M |
|---|---|---|---|
| GLM 5.3 Flash | 0,15 | 0,03 | 0,50 |
| GLM 5.3 FlashX | 0,37 | 0,075 | 1,25 |
| GLM 5.3 | 1,40 | 0,26 | 4,40 |
| DeepSeek V4 Pro | 0,435 | нет данных | 0,87 |
| Claude Opus 4.8 | 5,00 | нет данных | 25,00 |
Цены официального API, по состоянию на октябрь 2026. На OpenRouter у Flash около 29 провайдеров, и тарифы у них плавают, поэтому перед запуском проверьте актуальную страницу модели.
GLM Coding Plan и внепиковые часы
Подписка GLM Coding Plan стартует от $18 в месяц и работает на баллах. Flash расходует квоту в 3 раза медленнее, чем GLM 5.3. Во внепиковые часы, то есть в выходные и вне рабочего дня по Пекину (UTC+8), запросы стоят половину баллов.
Поделюсь лайфхаком: для Москвы пекинский рабочий день заканчивается примерно к 13:00. Длинные агентные задачи выгоднее ставить на вечер, и квоты хватит вдвое дальше. Блогеры в подборке советуют брать месячный план, а не годовой: модели обновляются слишком быстро.
В чем GLM 5.3 Flash сильна, а где буксует?
Сильные стороны Flash: цена, MIT, мультимодальность и агентные задачи. Слабые: скорость, сложная 3D-графика и ошибки в разметке, которые надо ловить вручную.
GLM 5.3 Flash выигрывает у GLM 5.3 в Toolathlon Verified (78,4 против 73,0) и стоит в 9 раз дешевле. Но по замерам Artificial Analysis она выдает около 50 токенов в секунду против 77 у старшей модели. Приставка Flash здесь означает легкость и цену, а не скорость ответа.
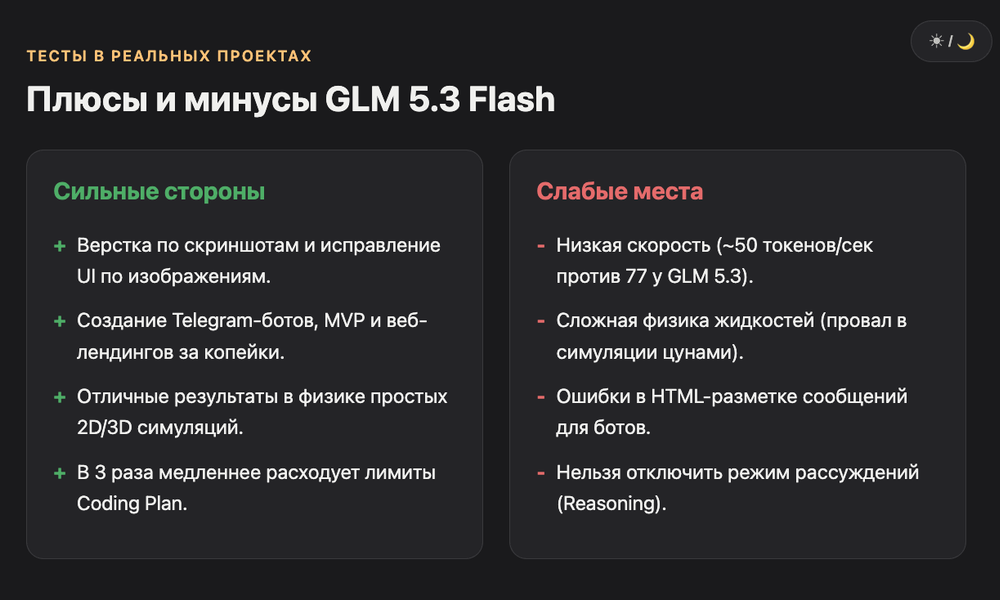
Сильные стороны
Первое, что бросается в глаза, это цена за задачу. Модель всегда рассуждает, но тратит на рассуждения меньше токенов, чем прошлое поколение, а сам токен стоит центы.
Мультимодальный вход полезнее, чем кажется. Flash может посмотреть скриншот своей же верстки или запись геймплея и исправить ошибку по картинке. Для фронтенда это экономит итерации, когда описать баг словами сложно.
MIT-лицензия позволяет встроить модель в свой продукт без юристов. Плюс открытые веса: никто не отключит вам доступ к модели завтра утром.
Слабые стороны
Медленная генерация. Сложные проекты в тестах шли больше часа, а выключить рассуждения нельзя. Есть FlashX на 200 токенов в секунду, но она в 2,5 раза дороже.
Спецэффекты и физика жидкостей проседают. Вода, стекло, прозрачные слои получаются хуже, чем у GLM 5.3 и западных флагманов.
Кибербезопасность и большие репозитории остаются территорией старшей модели. По этим задачам Z.ai сама рекомендует переключаться на GLM 5.3.
Как получить доступ к GLM 5.3 из России?
Прямой оплаты российскими картами нет ни у Z.ai, ни у OpenRouter. Рабочих путей три: зарубежная карта или крипта, подписка через посредника и запуск открытых весов на своем железе.
На октябрь 2026 Z.ai не публикует официальных ограничений для России, но и рублевых платежей не принимает. Открытые веса GLM 5.3 Flash лежат на Hugging Face по MIT, их можно развернуть через vLLM или SGLang у российского облачного провайдера. Тогда доступ к модели вообще не зависит от политики Z.ai.
Разложим варианты по сложности.
- Чат chat.z.ai. Самый простой способ потыкать модель руками. Доступность сайта из России может меняться, поэтому иногда понадобится VPN.
- API Z.ai или OpenRouter. Нужна зарубежная карта или пополнение криптой. OpenRouter удобен тем, что один ключ открывает сотни моделей, включая обе GLM 5.3.
- GLM Coding Plan через посредника. Блогеры в подборке покупают подписки на маркетплейсах вроде FunPay. Работает, но рискуете вы: аккаунт могут заблокировать.
- Свои веса. Для 320 млрд параметров в 4-битной квантизации нужно порядка 170-180 ГБ памяти по нашей оценке. Это Mac Studio с большим объемом памяти или сервер с несколькими GPU.
Для большинства вайбкодеров оптимален второй вариант. Подключили ключ в Claude Code, Cursor или Aider и работаете как обычно.
Какую модель выбрать, GLM 5.3 Flash vs GLM 5.3?
Flash берите для массовой автоматизации, фронтенда по скриншотам и прототипов на бюджете. GLM 5.3 нужна для сложной инженерии в больших кодовых базах и задач безопасности.
Логика выбора простая: если ошибка модели стоит дешевле, чем разница в цене, берите GLM 5.3 Flash. На 100 агентных прогонах экономия в 9 раз ощутима, а разрыв в DeepSWE всего 3,5 пункта. Если задача одна, сложная и дорогая в отладке, переплата за GLM 5.3 окупается.
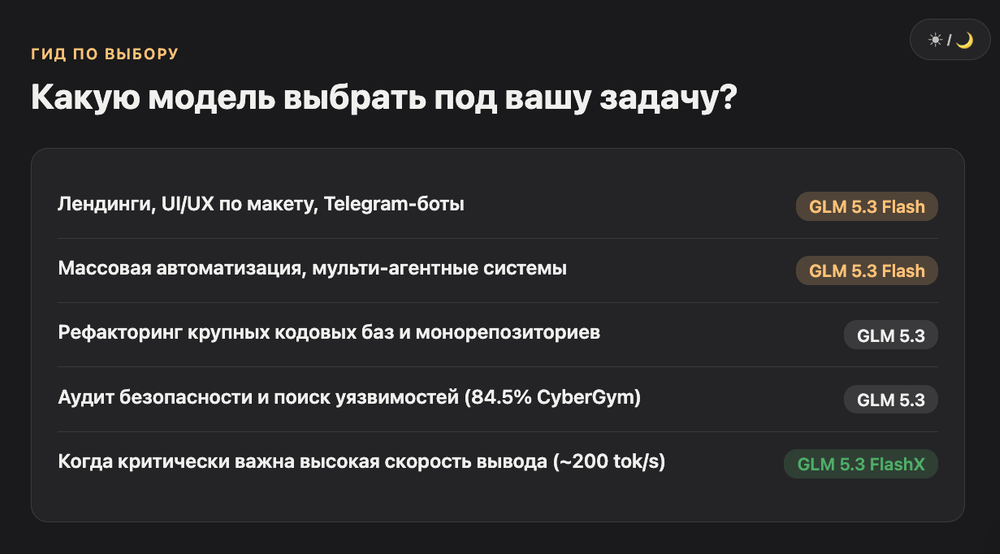
| Задача | Что брать | Почему |
|---|---|---|
| Лендинг, верстка по макету | GLM 5.3 Flash | видит скриншоты, дешево |
| Telegram-бот, MVP | GLM 5.3 Flash | хватает качества, цена копеечная |
| Массовая автоматизация, агенты | GLM 5.3 Flash | выигрывает в Toolathlon, 3x квоты |
| Рефакторинг большого репозитория | GLM 5.3 | выше DeepSWE и Terminal-Bench |
| Аудит безопасности кода | GLM 5.3 | 84,5% в CyberGym |
| Нужен ответ быстро | GLM 5.3 FlashX | около 200 токенов в секунду |
Мы в VibeCoderz пробуем каждую свежую модель в первые дни после релиза. Скорость реакции на новинку часто решает больше, чем идеальный выбор.
Максим: «Когда вышла новая модель, веб-версию GoBanana мы собрали за 3 часа. Суммарно на продукт ушло 6–8 часов, а принес он 12 млн руб. Ребят, это работает: дешевая модель плюс быстрый запуск дают больше, чем месяц выбора идеального стека.»
FAQ про GLM 5.3 нейросеть
GLM 5.3 Flash правда бесплатная? Веса бесплатные: их можно скачать с Hugging Face по лицензии MIT и запускать у себя. API платный, $0,15 за 1M входящих и $0,50 за 1M исходящих токенов на октябрь 2026. Бесплатные модели у Z.ai тоже есть, но это старые GLM-4.7-Flash и GLM-4.5-Flash.
Почему Flash работает медленнее старшей GLM 5.3? Слово Flash здесь про цену и легкость, а не про скорость. По замерам Artificial Analysis Flash выдает около 50 токенов в секунду, GLM 5.3 около 77. Модель всегда рассуждает перед ответом, поэтому сложные задачи тянутся долго. Если нужна скорость, берите FlashX: Z.ai заявляет около 200 токенов в секунду.
Можно ли подключить GLM 5.3 Flash к Claude Code или Cursor? Да. Через GLM Coding Plan модель работает в Claude Code, OpenCode и фирменном ZCode. В Cursor и Cline ее подключают через OpenAI-совместимый API Z.ai или OpenRouter. Привычный процесс не меняется, меняется только модель под капотом.
Можно ли запустить GLM 5.3 Flash на своем компьютере? Теоретически да, веса открыты. Но у модели 320 млрд параметров, и даже в 4-битной квантизации веса весят порядка 170-180 ГБ по нашей оценке. Это уровень Mac Studio с большим объемом памяти или сервера с несколькими GPU. Обычному ноутбуку такое не под силу.
Чем GLM 5.3 лучше прошлой GLM 5.2? Z.ai не меняла базовую модель, а прокачала дообучение. В итоге Terminal-Bench 3.0 вырос с 4,6 до 28,3, DeepSWE v1.1 с 46,2 до 66,9. Модель тратит меньше токенов на задачу, а цена API осталась той же: $1,40/$4,40 за 1M токенов.
Работает ли GLM 5.3 нейросеть из России без VPN? Z.ai не публикует официальной позиции по России, и доступность сайта может меняться. Главная сложность в оплате: российские карты не принимаются ни Z.ai, ни OpenRouter. Самый надежный вариант без зависимости от сервиса: скачать открытые веса и запускать их у себя или у российского облачного провайдера.
Что значат термины из этой статьи?
- MoE (Mixture of Experts) — это архитектура, где на каждый токен включается только часть параметров. У Flash из 320 млрд работают 18 млрд.
- Гибридное внимание — это сочетание разреженного и линейного внимания, которое экономит память и вычисления на длинном контексте.
- KV-кэш — это память, где модель хранит уже прочитанный контекст. Чем он меньше, тем дешевле длинные диалоги.
- Квантизация — это сжатие весов модели до 4 или 8 бит, чтобы запустить ее на меньшем объеме памяти ценой небольшой потери точности.
- Open weights — это модель, веса которой можно скачать и запустить у себя.
- Внепиковые часы — это время, когда Z.ai списывает за запросы половину баллов Coding Plan.
Стоит ли переходить на GLM 5.3 Flash прямо сейчас?
Да, если вы много генерируете и считаете деньги. GLM 5.3 Flash закрывает 80% повседневных задач вайбкодера по цене в разы ниже западных флагманов.
GLM 5.3 Flash стала одной из самых выгодных моделей для кода осенью 2026: MIT, 1M контекста, мультимодальность и $0,15/$0,50 за 1M токенов. Она отстает от GLM 5.3 на 3-4 пункта по коду и медленнее отвечает. Для сложной инженерии держите под рукой старшую модель.
Наш совет: подключите Flash как модель по умолчанию для прототипов и автоматизации, а GLM 5.3 или Claude оставьте на редкие тяжелые задачи. Такая связка срезает счет за токены в разы.
Сравнить GLM с другими нейросетями для кода можно в нашем каталоге AI-инструментов. А если хотите собрать свой стек под конкретный продукт, запишитесь на консультацию к Максиму, разберем вашу задачу и подберем модели.
Обновлено: октябрь 2026