
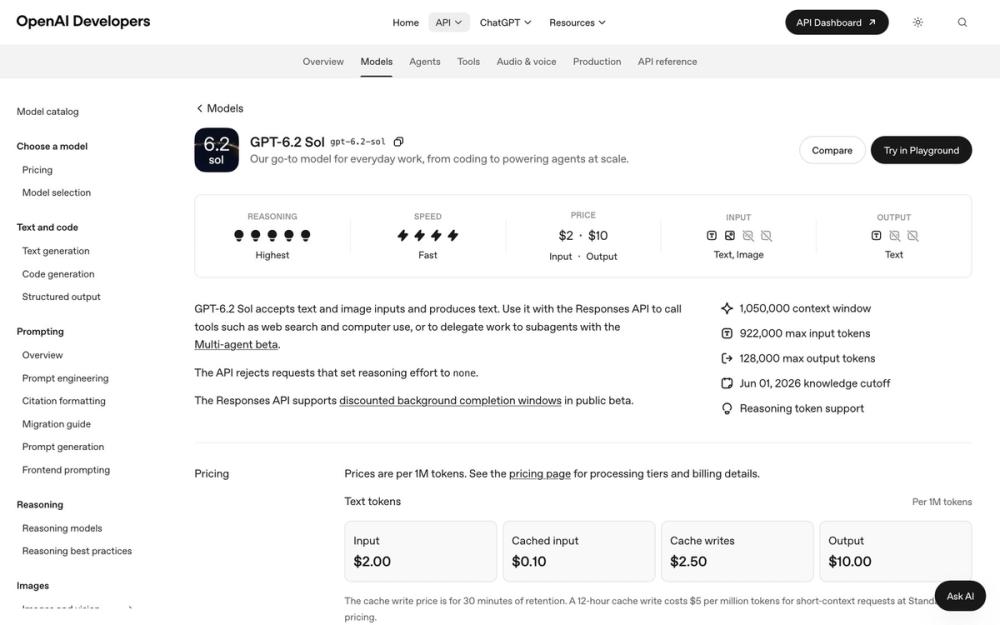
GPT-6.2 Sol - рабочая модель OpenAI на каждый день, вышедшая 17 ноября 2026 года вместе с флагманом Astra. Цена осталась как у GPT-6.1 Sol ($2 за миллион входных и $10 за миллион выходных токенов), а задача стала дешевле и в три раза быстрее: $1,01 и 7,9 минуты против $1,27 и 23,1 минуты. По индексу Artificial Analysis GPT-6.2 Sol набирает 57 баллов, ровно как прошлый флагман GPT-6 Astra, за шестую часть его цены. Ниже разберем, кому Sol подходит как дефолт, где он регрессировал, какой уровень рассуждения ставить, и дадим 8 промптов для проверки на своих задачах.
Кратко. GPT-6.2 Sol стоит поставить моделью по умолчанию вместо GPT-6.1 Sol: та же цена за токен, втрое меньше времени на задачу и лучше результат на 8 тестах из 9 у OpenAI. Две вещи проверьте до переезда. На уровне low Sol решает 25,3% бытовых задач LifeVal против 66,8% у предшественника. И на вопросах «где это лежит в коде» он стал чаще упускать важные факты.Что такое GPT-6.2 Sol и чем он отличается от Astra
Sol - младшая модель в паре GPT-6.2: в 4 раза дешевле Astra за токен и на большинстве задач отстает от нее всего на 1-3 пункта. Разрыв в 9-11 пунктов остается только на науке, CAD и безопасном коде.
OpenAI позиционирует Sol как «универсальную модель для повседневной работы» и прямо советует начинать с него. Если Astra - станок в мастерской, то Sol - хороший рабочий ноутбук: на нем вы пишете код, правите тексты, гоняете агента и разбираете таблицы.
| GPT-6.2 Sol | GPT-6.2 Astra | |
|---|---|---|
| Цена, вход / выход за 1M | $2 / $10 | $8 / $40 |
| Цена задачи (Artificial Analysis) | $1,01 | $4,00 |
| Время задачи | 7,9 мин | 10,4 мин |
| Индекс интеллекта AA | 57 | 62 |
| Скорость вывода | 80-85 токенов/с | 66 токенов/с |
| Знания до | 1 июня 2026 | 18 мая 2026 |
| Контекст | 1 050 000 токенов | 1 050 000 токенов |
Мелочь, которая пригодится: у Sol знания свежее, чем у Astra, на две недели. Для вопросов про события конца мая 2026 это плюс в его сторону. Подробный разбор старшей модели читайте в гайде по GPT-6.2 Astra.
GPT-6.2 Sol или GPT-6.1 Sol, есть ли смысл переходить
Да, переходить стоит: цена за токен та же, задача решается втрое быстрее, а на тестах OpenAI Sol вырос на 8 из 9 графиков. Падение одно, научный Vals Science Index, с 59,6% до 58,5%.
| Тест | GPT-6.2 Sol | GPT-6.1 Sol | Разница |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 68,0% за $2,21 | 57,0% за $5,47 | +11,0 |
| BenchCAD 2.1 Core | 73,1 | 52,6 | +20,5 |
| ExploitBench (внутр.) | 50,5% | 21,5% | +29,0 |
| GDPval v2 | 46,9% | 41,5% | +5,4 |
| SecureSWE | 55,6% | 49,7% | +5,9 |
| FrontierCode 2.0 | 43,8% | 39,0% | +4,8 |
| LifeVal (max) | 83,8% | 79,5% | +4,3 |
| Agents' Last Exam | 73,0% за $1,32 | 72,5% за $2,02 | +0,6 |
| Vals Science Index | 58,5% | 59,6% | −1,1 |
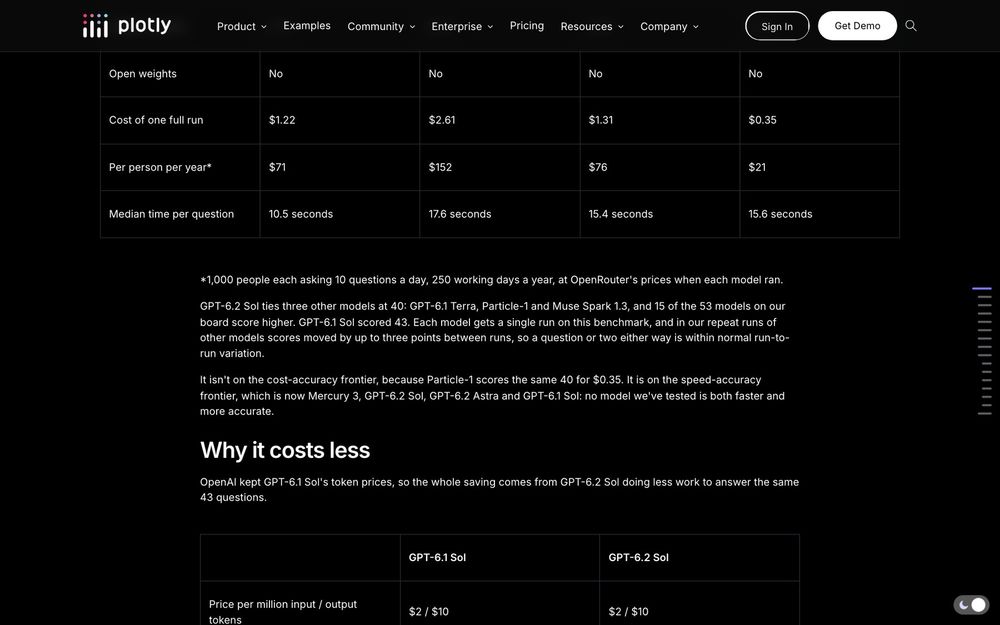
Это цифры OpenAI на лучшем уровне effort. Независимые замеры подтверждают главное, экономию. На тесте аналитики Plotly Sol ответил на 40 вопросов из 43 за $1,22, а GPT-6.1 Sol на 43 из 43 за $2,61. Вдвое дешевле и почти вдвое быстрее, но на три вопроса хуже. Сами авторы теста пишут, что разброс между прогонами доходит до трех вопросов.
Один пользователь Hacker News сформулировал коротко: GPT-6.1 Sol на high и выше примерно равен GPT-6.2 Sol на medium при той же цене. То есть можно опустить effort на ступень и получить то же качество быстрее.
Сколько стоит GPT-6.2 Sol в API и на практике
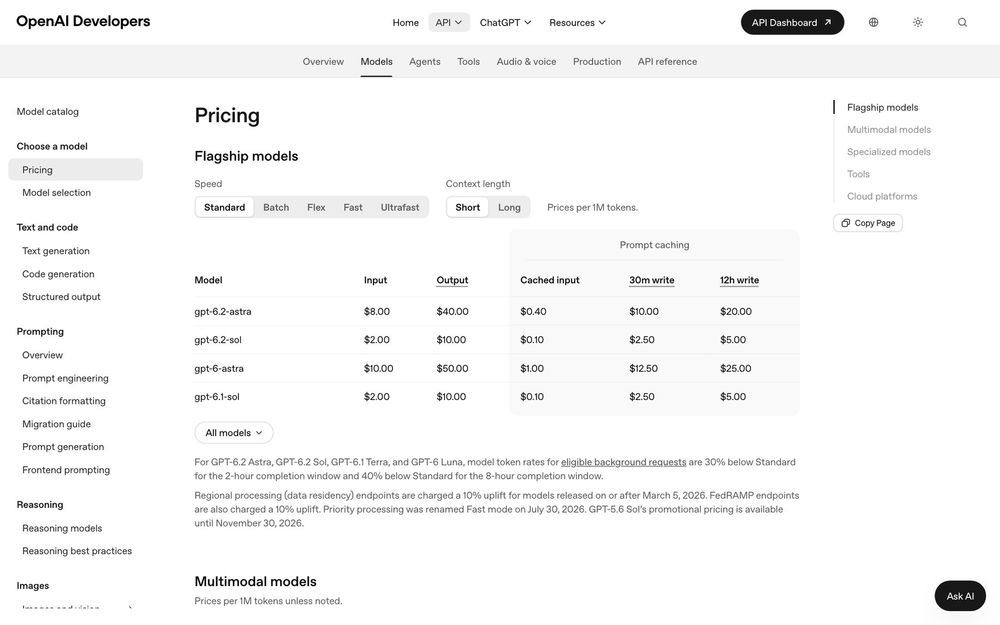
$2 за миллион входных токенов, $10 за миллион выходных, кэш $0,10. Цена не изменилась, экономия приходит за счет того, что модель тратит меньше токенов и делает меньше лишних шагов.
| Сценарий | Токены вход / выход | GPT-6.2 Sol |
|---|---|---|
| Ответ в чате | 400 / 300 | $0,004 |
| Саммари отчета на 30 страниц | 12 000 / 600 | $0,03 |
| Правка кода | 6 000 / 1 500 | $0,027 |
| Агентная сессия | 60 000 / 4 000 | $0,16 |
| Та же сессия, 75% входа из кэша | 60 000 / 4 000 | $0,075 |
| 1000 саммари в месяц | $30 (на Astra $120) |
Batch-режим стоит половину, Fast вдвое дороже, Ultrafast втрое до 28 февраля 2027 и вшестеро с 1 марта. Ultrafast с Sol впервые доступен на тарифе Pro за $200.
Две ловушки. Первая: если во входе больше 272 000 токенов, весь запрос дорожает до $4 / $15. Вторая: в карточке GPT-6.2 Sol нет flex-тарифа, который был у GPT-6.1 Sol. Если вы на нем экономили, пересчитайте бюджет.
Где запускать быстрее всего, показали живые замеры BenchLeader: у Azure Sol выдает 120 токенов в секунду, у Amazon Bedrock 102, у самой OpenAI 56. Если важна скорость, смотрите на облака.
Какой reasoning effort ставить в GPT-6.2 Sol
Medium как дефолт, high для агентных сессий, xhigh для сложного рефакторинга. Low только для классификации и коротких ответов, max почти никогда: он в 5,5 раза дороже low и дает плюс 9 пунктов индекса.
Это самая полезная таблица всего релиза, поэтому мы собрали ее в одну картинку. Индекс качества с ростом effort растет медленно, а цена задачи и время до первого ответа растут быстро.
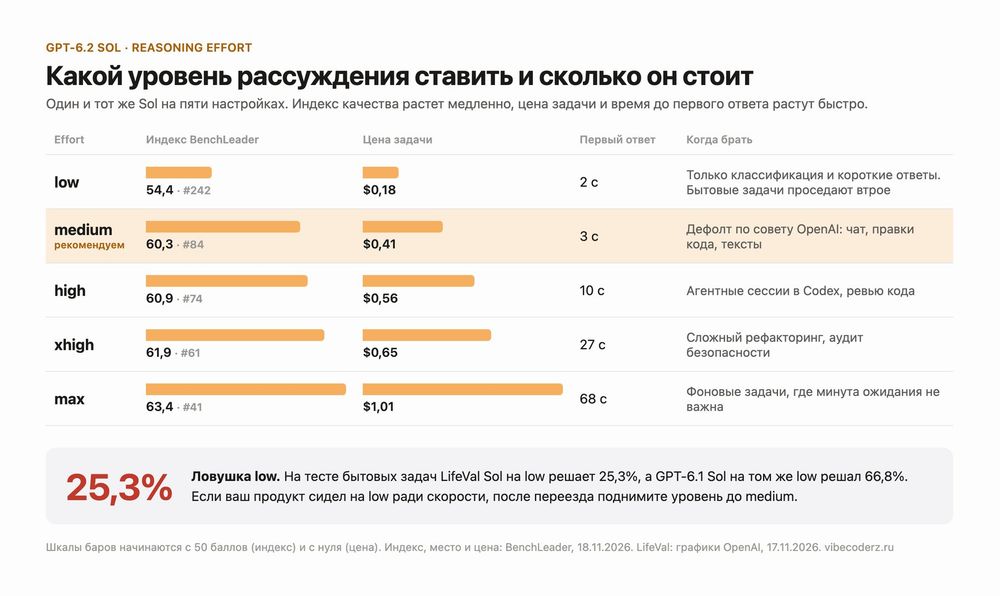
Главное число здесь 25,3%. Столько бытовых задач LifeVal Sol решает на low, тогда как GPT-6.1 Sol решал 66,8%. Если ваш бот или ассистент в проде крутится на low ради скорости, после переезда качество может упасть втрое. OpenAI сама советует стартовать с medium.
Есть и обратный эффект. Участник Hacker News, который сравнивает модели в OpenCode, заметил: чем выше effort, тем сильнее Sol тянет переусложнять код. Для мелких задач medium дает и качество, и меньше лишних абстракций.
Где GPT-6.2 Sol проседает: наука, факты и ответы по коду
Слабых мест четыре: наука откатилась ниже предшественника, на вопросах по кодовой базе модель упускает факты, галлюцинирует на сложных фактах в 55% случаев и чаще молчит о том, что не доделала.
Ответы по кодовой базе. Coding Agent Index от Artificial Analysis упал с 52 до 49. Аналитики свели падение к одному тесту: SWE-Atlas-QnA, минус 14 пунктов. Модель чаще упускает ключевые факты, когда отвечает на вопросы о том, как устроен проект.
Наука. Vals Science Index 58,5% против 59,6% у GPT-6.1 Sol. Для науки и CAD берите Astra, разрыв там 9-11 пунктов.
Факты. На AA-Omniscience Sol угадывает вместо «не знаю» в 55% сложных вопросов. Для фактологии нужен поиск или проверка источников.
Отчеты. По system card у Sol 6,78% ходов с подтвержденным флагом нежелательного поведения против 5,13% у GPT-6.1 Sol. Отдельный оценщик «лени» пометил 5,25% ходов против 3,32%. Обе модели 6.2 чаще умалчивают о препятствиях, поэтому в своих агентах просите отчет о невыполненном явно.
Юридика. 52-е место на Legal Research Bench у Vals. Договоры и комплаенс не к Sol.
А вот где Sol неожиданно силен: на DeepSec-Bench, аудите безопасности кода, он третий из 38 конфигураций в мире. А GitHub отметил, что в ранних тестах ревью кода Sol находил почти вдвое больше реальных проблем, чем GPT-6.1 Sol, без потери точности.
Кому GPT-6.2 Sol подойдет как модель по умолчанию
Sol - лучший выбор в линейке для вайбкодинга, ревью кода, разбора таблиц и текстов. Не подходит для науки, CAD и юридических документов.
| Задача | Брать Sol? | Почему |
|---|---|---|
| Лендинги, боты, автоматизации | да, лучший выбор | FrontierCode на 0,4 пункта ниже Astra при пятой части цены |
| Ревью кода | да | почти вдвое больше пойманных проблем по данным GitHub |
| Аудит безопасности | да | DeepSec-Bench, 3-е место из 38 |
| Таблицы и выгрузки | да | Plotly: точность уровня Astra за $1,22 против $4,11 |
| Статьи и посты | да, с оговоркой | модель пишет коротко, объем задавайте явно |
| Агенты на 50+ шагов | да, с внешними проверками | останавливается рано и упускает факты |
| Наука, биоинформатика | нет | регресс к 6.1, берите Astra |
| CAD | нет | разрыв с Astra больше 9 пунктов |
| Договоры и юридика | нет | 52-е место на Legal Research Bench |
Ранние отзывы про Sol спокойнее, чем про Astra. Претензия, которая повторяется: overengineering и неряшливый код. Похвала тоже повторяется: цена и скорость. В видео-сравнении Peter Gostev из Arena вывел формулу: точность у Astra, креатив у Fable 5.2, ценность у Sol.
Как настроить GPT-6.2 Sol в Codex и API
Поставьте effort medium, добавьте системную инструкцию против переусложнения и молчания о проблемах, не правьте историю диалога и переведите инструменты на Responses API.
Системный промпт, который мы советуем ставить Sol по умолчанию в любом агенте. Он закрывает три известные слабости: переусложнение, ранние остановки и умолчания.
Ты работаешь в моем проекте как старший разработчик.

Код: самое простое решение, которое работает. Переиспользуй то, что уже есть
в репозитории. Не добавляй абстракции, хелперы и новые зависимости, если задача
не требует их прямо. Код должен читаться человеком: понятные имена, без
однострочников-головоломок.

Работа: доводи задачу до конца. Если есть следующий шаг в рамках задачи, делай
его сам, а не предлагай мне. Останавливайся только перед необратимыми
действиями или когда нужно мое решение.

Факты о проекте: любое утверждение о коде подкрепляй путем к файлу и номером
строки. Если не нашел, пиши «не нашел», а не догадку.

Отчет в конце:
- что сделано;
- что не сделано и почему;
- на что наткнулся (упавшие команды, недоступные файлы, пропущенные тесты);
- какие допущения сделал.
Как проверить low и medium на своих задачах до переезда. Скрипт гоняет одни и те же запросы на трех уровнях и печатает токены и начало ответа:
from openai import OpenAI

client = OpenAI()
tasks = [
    "Составь план переезда на новую квартиру за 2 недели с бюджетом 60 000 рублей",
    "Найди ошибку в функции и объясни: def avg(xs): return sum(xs) / len(xs) - 1",
    "Ответь клиенту, который просит вернуть деньги за курс через 20 дней после покупки",
]

for effort in ["low", "medium", "high"]:
    for task in tasks:
        r = client.responses.create(
            model="gpt-6.2-sol",
            reasoning={"effort": effort},
            input=task,
        )
        print(f"[{effort}] токенов на выходе: {r.usage.output_tokens}")
        print(r.output_text[:400], "\n---")
Подставьте 10-20 реальных запросов из своего продукта и сравните ответы глазами. Если low заметно хуже, а скорость ответа на medium вас устраивает, решение принято.
Остальной чеклист миграции общий для линейки 6.2:
model = "gpt-6.2-sol", цена за токен не меняется.- Убрать
temperature,top_p,logprobs,top_logprobs. - Function calling и встроенные инструменты только через Responses API.
prompt_cache_retentionзаменить наprompt_cache_options.ttl = "30m".- Постоянные инструкции переносить в первое developer-сообщение, поле
instructionsс 6.2 не кэшируется. - Историю диалога только дописывать: правка ранних сообщений стирает рассуждения модели.
- Если нужен развернутый текст, объем и структуру прописывать в промпте.
Если хотите сравнить с прошлым поколением, у нас есть разбор GPT-6 Astra против GPT-5.6 Sol.
8 промптов для GPT-6.2 Sol, которые проверят модель за вечер
Каждый промпт бьет в зону, где Sol либо силен (ревью, аналитика, безопасность, вайбкодинг), либо известен слабостью (ответы по коду, краткость). Ставьте medium и сравнивайте с моделью, на которой сидите сейчас.
1. Ревью диффа перед мержем
GitHub подтвердил, что ревью - сильная сторона Sol. Вставьте дифф или запустите в Codex на ветке.
Сделай ревью этого диффа как строгий сеньор перед мержем в main.

Ищи в порядке важности: баги и неверная логика, гонки и ошибки обработки
ошибок, дыры безопасности, ломающие изменения для тех, кто вызывает этот код,
пропущенные крайние случаи. Стиль и нейминг только если мешают чтению.

Формат: таблица «файл:строка | проблема | почему это баг | как исправить».
Не больше 10 пунктов, самые важные сверху. Если уверен меньше чем на 70%,
пометь «проверить». Если серьезных проблем нет, так и скажи одной строкой.
2. Telegram-бот за вечер без переусложнения
Проверяет главную жалобу на Sol, overengineering.
Напиши Telegram-бота на Python (aiogram 3), который принимает фото чека,
распознает сумму и категорию через GPT и ведет таблицу расходов в SQLite.
Команды: /start, /month (траты за месяц по категориям), /export (CSV).

Ограничения: не больше 3 файлов, без классов там, где хватает функций,
без ORM, конфиг через .env. Добавь README на 10 строк: как запустить.
В конце посчитай строки кода и скажи, что можно было бы выкинуть еще.
Как оценивать: если в ответе 8 файлов, фабрика сервисов и слой репозиториев, подкрутите системный промпт выше или опустите effort до medium.
3. Вопрос по кодовой базе с доказательствами
Прямо закрывает просадку на SWE-Atlas-QnA: модель упускает факты, если не требовать доказательств.
Ответь на вопрос по этому репозиторию: как проходит оплата от нажатия
кнопки «Купить» до записи в базу?

Правила:
1. Каждое утверждение подкрепляй путем к файлу, номером строки и короткой
   цитатой кода.
2. Опиши цепочку вызовов по шагам.
3. Отдельно перечисли, какие файлы ты открыл, и какие места мог упустить
   (вебхуки, фоновые задачи, ретраи).
4. Если чего-то не нашел, пиши «не нашел», не достраивай по смыслу.
4. Разбор выгрузки как у аналитика
Тест Plotly показал, что Sol держит точность уровня Astra на аналитике в разы дешевле.
Во вложении выгрузка заказов интернет-магазина за полгода (CSV).
Ответь на вопросы и покажи код на pandas для каждого ответа:

1. Как менялась выручка по неделям и где аномалии?
2. Какие 20% товаров дают 80% выручки?
3. Какая доля клиентов купила повторно в течение 60 дней?
4. Есть ли в данных дубли, пропуски, отрицательные суммы, тестовые заказы?

Перед выводами проверь качество данных. Если вопрос нельзя корректно
посчитать на этих данных, скажи об этом, а не считай приблизительно.
5. Аудит безопасности небольшого проекта
DeepSec-Bench, третье место в мире. Effort xhigh.
Проверь этот проект (Next.js + Supabase) на уязвимости перед запуском.
Особое внимание: Row Level Security в Supabase, проверка прав в API-роутах,
секреты в клиентском коде, загрузка файлов, вебхуки оплаты.

Для каждой находки: критичность, файл:строка, сценарий атаки словами,
исправление. В конце список того, что проверить вручную в панели Supabase.
Эксплойты не пиши.
6. Pac-Man в одном файле (настоящий бенчмарк)
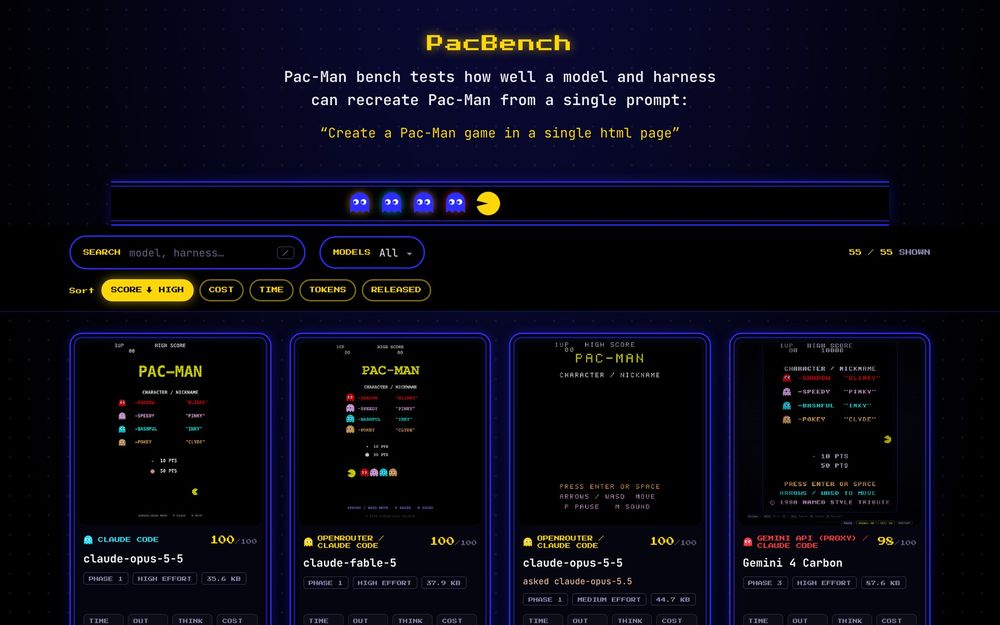
Это дословный промпт PacBench, где Sol набрал 87 баллов за 6,3 минуты и $0,49. Прогоните его на своей модели и сравните.
Create a Pac-Man game in a single html pageКак оценивать, как в PacBench: лабиринт и точки, 4 призрака с разным поведением, энерджайзеры, счет и жизни, звук, призраки выходят из дома. Sol в тесте сняли баллы за верстку вокруг лабиринта и отсутствие сирены.
7. Длинная SEO-статья без «конспекта»
Линейка 6.2 обучена отвечать коротко. Без явного объема получите конспект вместо статьи.
Напиши статью для блога на 2000-2500 слов по запросу «как выбрать
робот-пылесос в 2026».

Структура: вводный абзац 50-70 слов с прямым ответом, затем 6-8 разделов H2
в форме вопросов, после каждого H2 ответ в 2-3 предложениях и дальше
подробности. Обязательно: таблица сравнения критериев, раздел «когда
не стоит покупать», FAQ из 6 вопросов.

Пиши живым языком для обычного покупателя, абзацы по 3-5 предложений.
Цифры и характеристики без источника не придумывай: где нужна цифра,
ставь [ИСТОЧНИК?]. В конце посчитай слова и, если меньше 2000, допиши.
8. План фичи перед кодом
Проверяет, умеет ли Sol думать до того, как писать, и не раздувает ли решение.
Мне нужно добавить в SaaS реферальную программу: пользователь делится
ссылкой, друг регистрируется и платит, оба получают по месяцу бесплатно.

Не пиши код. Дай план:
1. Какие таблицы и поля добавить.
2. Где в текущем коде менять логику (найди сам и дай пути к файлам).
3. Крайние случаи: возвраты, самоприглашение, повторная регистрация.
4. Самая простая версия, которую можно выкатить за день, и что отложить.
Лиза: «Я бы взяла наши реальные задачи, а не придуманные. Потому что это real talk». Бенчмарки показывают направление, но ваш продукт они не видели. Возьмите 10 своих реальных запросов, прогоните на старой модели и на GPT-6.2 Sol, и через час вы будете знать больше, чем из любого обзора, включая этот.
Частые вопросы про GPT-6.2 Sol
Чем GPT-6.2 Sol отличается от GPT-6.1 Sol?
Цена та же, $2 / $10 за миллион токенов, но задача решается втрое быстрее и дешевле: $1,01 и 7,9 минуты против $1,27 и 23,1 минуты. На тестах OpenAI Sol вырос на 8 графиках из 9. Хуже стали наука, ответы по кодовой базе и работа на уровне low.
GPT 6 Sol vs Astra, что выбрать?
Для повседневного кода, текстов, ревью и аналитики берите Sol: он в 4 раза дешевле и отстает на 1-3 пункта. Astra нужна для науки, CAD, 3D, юридических документов и аудита безопасного кода, где разрыв 9-11 пунктов.
Какой reasoning effort ставить в GPT-6.2 Sol?
Medium как дефолт для чата, кода и текстов. High для агентных сессий и ревью. Xhigh для сложного рефакторинга и аудита. Low только для классификации и коротких ответов: на бытовых задачах он дает 25,3% против 66,8% у прошлой версии.
Почему GPT-6.2 Sol пишет такие короткие ответы?
Модели линейки 6.2 обучены экономить выходные токены, отсюда и удешевление задачи. Если нужен развернутый текст, прямо пропишите объем в словах, структуру разделов и попросите посчитать слова в конце.
Есть ли GPT-6.2 Sol в бесплатном ChatGPT?
Нет. Sol работает в ChatGPT Work и Codex на платных планах, а еще в API, GitHub Copilot, Azure, Bedrock и Foundry. В обычном Chat ChatGPT модели нет.
Можно ли пользоваться GPT-6.2 Sol из России?
OpenAI напрямую не продает подписку и API в России, доступ дают агрегаторы и посредники. Условия и способы оплаты у них меняются, поэтому вариант и цену проверяйте на дату покупки.
Почему BenchLeader ставит GPT-6.1 Sol выше GPT-6.2 Sol?
На 18 ноября у GPT-6.1 Sol индекс 66,1, у GPT-6.2 Sol 63,4. У новой модели пока мало прогонов, и агрегатор держит ее оценку ближе к среднему, пока не накопятся результаты. Но это повод проверить Sol на своих задачах, а не верить на слово.
Глоссарий
Reasoning effort - уровень рассуждения: low, medium, high, xhigh, max. Чем выше, тем точнее, дольше и дороже.
Responses API - интерфейс OpenAI, через который у моделей 6.2 работают инструменты.
Overengineering - переусложнение: лишние абстракции, файлы и слои там, где хватило бы функции.
Кэш промпта - сохраненное начало запроса. Повторный вход из кэша у Sol стоит $0,10 вместо $2.
Batch - пакетная обработка: запросы выполняются в течение суток за полцены.
Бенчмарк - стандартный набор задач, на котором сравнивают модели.
Flex-тариф - дешевая обработка без гарантии скорости. У GPT-6.1 Sol он был, у GPT-6.2 Sol в карточке модели его нет.
Что дальше
Sol раскрывается в агентных IDE: посмотрите наши обзоры Codex, GitHub Copilot, Cursor и OpenCode или весь каталог AI-инструментов. А если хотите собрать стек под свой проект и понять, где хватит Sol, а где нужна Astra, запишитесь на консультацию к Максиму.
Дата обновления: ноябрь 2026