LM Studio API появляется одним переключателем в интерфейсе привычного десктопного чата, и после него локальная модель на вашем компьютере начинает отвечать на запросы точно так же, как облачный OpenAI. Разбираем подробно: как включить серверный режим, что дает встроенный RAG для работы с документами, зачем нужен агентный режим с инструментами и как собрать из всего этого бесплатный бэкенд для разработки. Каждый шаг проверен на реальных запросах, с цифрами по скорости ответа.
LM Studio закрывает три задачи разом: OpenAI-совместимый сервер на localhost, встроенный RAG для документов без своей векторной базы и агентный режим с MCP-инструментами. Порт по умолчанию — 1234, эндпоинты/v1/chat/completions,/v1/models,/v1/embeddingsи новый/v1/responses. В статье — практическая связка: локальная разработка на LM Studio, продакшн на настоящем API.
Что такое серверный режим LM Studio и зачем он нужен?
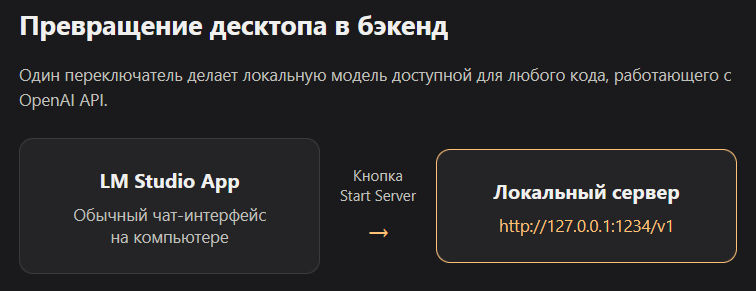
Серверный режим — это переключатель во вкладке Developer, который поднимает на вашем компьютере HTTP-сервер по адресу http://127.0.0.1:1234, отвечающий в формате OpenAI API.
Один клик превращает десктопное приложение в бэкенд: любой код, уже умеющий работать с OpenAI-совместимым клиентом, начинает стучаться в локальную модель, если поменять в нем только base_url. Никакого нового SDK, никакой переделки логики запросов.
Запускается это либо кнопкой Start Server во вкладке Developer, либо командой в терминале:
lms server start --port 1234По умолчанию LM Studio слушает порт 1234, но в Server Settings его можно поменять на любой другой, если этот занят другим процессом. Сервер работает в том же процессе, что и чат-интерфейс, поэтому окно приложения можно смело сворачивать. Из практики: пока модель загружается впервые, первый запрос может занять заметно больше времени, чем последующие, — это нормально, движок прогревает веса в памяти.
Какие эндпоинты доступны в LM Studio API?
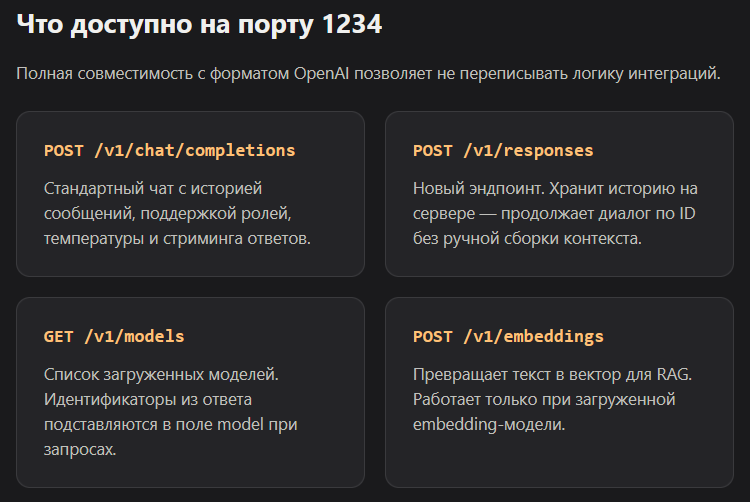
Основных пять, и у каждого своя роль.
GET /v1/models— список загруженных и доступных локально моделей. Id из ответа — это ключи, которые дальше подставляются в полеmodelзапроса.POST /v1/chat/completions— обычный чат с историей сообщений, температурой и стримингом.POST /v1/completions— текстовое автодополнение без ролей чата, ближе к тому, что в Cursor называют inline-подсказками.POST /v1/embeddings— превращение текста в вектор. Работает только если в LM Studio отдельно загружена embedding-модель, например nomic-embed-text, иначе прилетит ошибка 404.POST /v1/responses— новый эндпоинт, добавленный в версии 0.3.29. Позволяет продолжать диалог черезprevious_response_id, не пересобирая историю сообщений вручную на своей стороне.
Пример минимального запроса curl:
curl http://127.0.0.1:1234/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3-14b",
    "messages": [{"role": "user", "content": "2+2"}],
    "stream": false
  }'
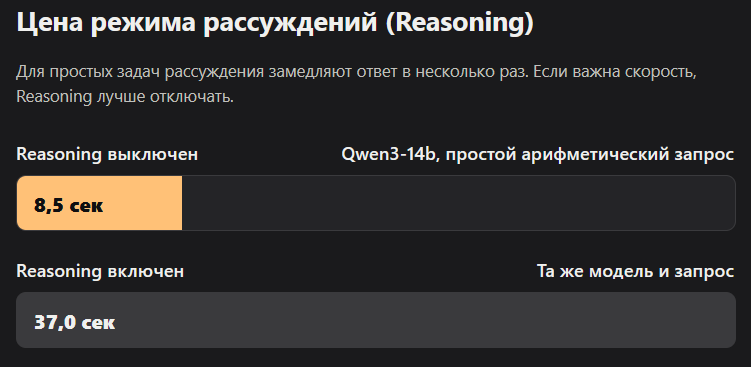
Один нюанс, который легко упустить при первом тестировании через Postman: если в запросе включен режим рассуждений (reasoning), ответ приходит ощутимо медленнее. На простом арифметическом вопросе разница была измерена напрямую — с рассуждениями модель отвечала 37 секунд, без них тот же вопрос закрывался за 8,5 секунды. Для рабочих сценариев, где скорость важнее развернутого рассуждения, reasoning стоит выключать в настройках модели.
Чем полезен эндпоинт /v1/responses для длинных сессий?
/v1/responses хранит историю на стороне LM Studio и позволяет продолжить диалог по id, не отправляя все прошлые сообщения заново с клиента.
Каждый ответ приходит с собственным response_id. Указав его как previous_response_id в следующем запросе, вы получаете модель, которая помнит контекст без ручной сборки массива messages. Полезно для агентных пайплайнов, где сообщения генерируются кодом, а не человеком в чате — меньше шансов случайно потерять кусок истории при сборке запроса.
Как совместимость с OpenAI API экономит время разработки?
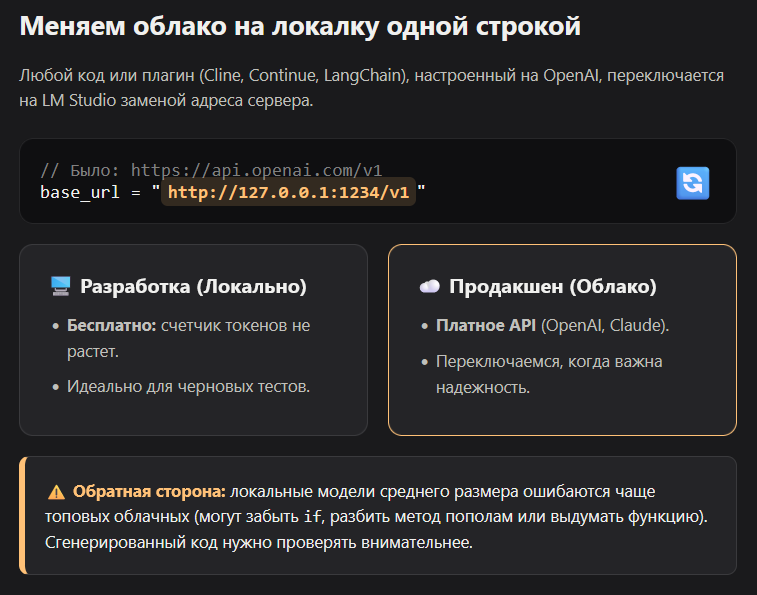
LM Studio отвечает в точности в формате OpenAI, поэтому существующий код с openai SDK работает без переписывания — меняется только адрес сервера.
Любой инструмент, уже настроенный на работу с OpenAI-совместимым провайдером (LangChain, кастомные обертки, IDE-плагины вроде Cline или Continue), подключается к LM Studio заменой одной строки в конфиге. Разница с реальным облаком — деньги: пока код гоняется на локальной модели, счетчик токенов не растет.
Практическая связка выглядит так: запустить LM Studio в серверном режиме → указать в клиенте base_url = http://127.0.0.1:1234/v1 вместо адреса OpenAI → разрабатывать и тестировать бесплатно, переключаясь на платный облачный API только на этапе, где важны надежность и качество продакшена. В IDE-плагинах вроде Cline это делается прямо в настройках провайдера: выбираете LM Studio, плагин сам подтягивает список загруженных моделей.
Есть и обратная сторона. В одном из тестов та же связка LM Studio плюс Cline на модели среднего размера сгенерировала рабочий, но не идеальный код: модель разбила метод пополам, забыла добавить if в условие и один раз вызвала несуществующий метод класса. Локальные модели меньшего размера чаще так ошибаются, чем платные топовые — это стоит закладывать в ожидания и проверять сгенерированный код внимательнее, чем при работе с облаком.
Максим: «Мог просто засесть до пяти ночи и просто там править одну какую-то функцию, которая не работала. Если бы не терпение, в моменте я уже испотел и мне хотелось всё это закрыть. Но я понимал, что это можно решить и нужно решить, чтобы идти дальше.»
Как работает встроенный RAG в LM Studio?
RAG в LM Studio включается одной кнопкой при добавлении файла в чат: модель эмбеддингов сама превращает документ в векторы и подмешивает релевантные куски в промт при ответе.
Если коротко про механику: любой текст, который получает модель, на входе разбирается на токены, а затем кодируется в вектор — набор чисел, в которых зашит смысл. RAG (Retrieval-Augmented Generation, генерация с усилением поиском) добавляет к этому процессу промежуточный шаг — поиск похожих векторов среди фрагментов загруженного документа перед тем, как отдать все это генеративной части модели.
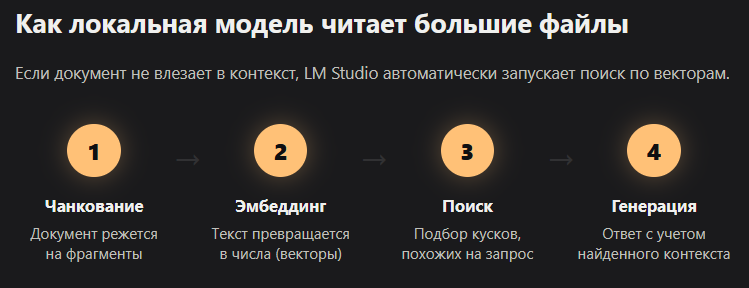
Технически цепочка выглядит так: документ режется на фрагменты → каждый фрагмент превращается в вектор через embedding-модель → векторы складываются в локальное хранилище → запрос пользователя тоже кодируется в вектор → система ищет похожие фрагменты → несколько ближайших кусков подмешиваются к промту → и только после этого промт с добавленным контекстом уходит в модель для генерации ответа. Важно, что это не дообучение модели — файлы остаются лежать отдельно, LM Studio просто добавляет контекст к уже готовым весам.
Если документ короткий и помещается в контекстное окно модели целиком, LM Studio вставит его в диалог без RAG — полностью. RAG включается автоматически, когда файл слишком большой для контекста.
Когда RAG в LM Studio реально меняет качество ответа?
Разница хорошо видна на конкретном сравнении: одному и тому же промту про адаптацию резюме под конкретную вакансию задали дважды — сначала без прикрепленного файла, потом с прикрепленным CV. Без документа ответ был общим: сфокусироваться на релевантности, подготовить историю, адаптировать сопроводительное письмо. С прикрепленным резюме ответ стал предметным — с отсылками к конкретным проектам, технологиям и опыту лидерства из самого файла, а не абстрактными советами.
Практический сценарий для вайбкодера: закрытые документы, которые нельзя загружать в облачный ChatGPT (NDA, внутренние баги, черновики продукта), можно скормить именно локальной модели через RAG в LM Studio — данные не покидают компьютер. Ограничение то же самое, что и у любой локальной модели: контекстное окно и объем токенов у маленьких моделей скромнее, чем у облачных, так что большие массивы данных придется дробить на несколько заходов.
Что умеет агентный режим и MCP в LM Studio?
Agents-режим подключает к локальной модели инструменты через MCP-серверы — файловую систему, браузер, работу с кодом — редактируется файлом mcp.json прямо в приложении.
MCP (Model Context Protocol) решает конкретную проблему: языковая модель хорошо работает с текстом, но не умеет напрямую дергать программные библиотеки или ходить в базу данных без лимита — любой такой запрос без ограничений мгновенно съедает весь контекст. MCP-сервер — это небольшая программа, которая при запуске сообщает модели список поддерживаемых инструментов с описанием и аргументами. Дальше это описание приклеивается к системному промту, и модель сама решает, когда и какой инструмент вызвать.
В LM Studio MCP подключается через вкладку Program → Install → Edit mcp.json, где используется тот же формат, что и в Cursor. Пример подключения стороннего сервера:
{
  "mcpServers": {
    "hf-mcp-server": {
      "url": "https://huggingface.co/mcp",
      "headers": { "Authorization": "Bearer YOUR_TOKEN" }
    }
  }
}
Сколько инструментов подключать к локальной модели одновременно?
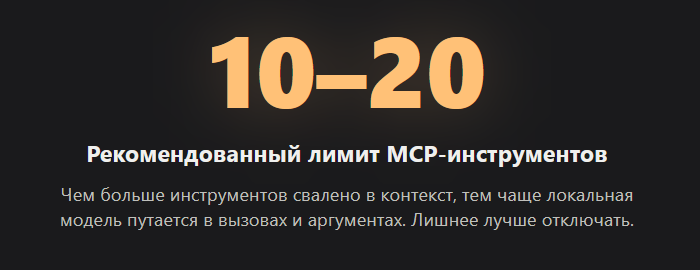
Рекомендованный диапазон — 10-20 инструментов на одну модель. Чем больше тулов свалено в контекст, тем чаще модель путается, какой из них вызвать и с какими аргументами, особенно на моделях среднего размера, которые физически помещаются на обычном ноутбуке. Неиспользуемые в текущей задаче инструменты лучше отключать вручную — это освобождает контекст под саму работу.
Практические примеры MCP-серверов для LM Studio: инструменты для чтения документации библиотек (условные Deep Wiki, Context), автоматизация браузера для поиска информации, работа с PDF (извлечение и вставка текста), интеграции с Google Docs и Sheets. Локальный агент на своем железе особенно уместен там, где не хочется передавать данные во внешний сервис — тот же принцип приватности, что и у RAG.
Как выглядит практический сценарий для вайбкодера?
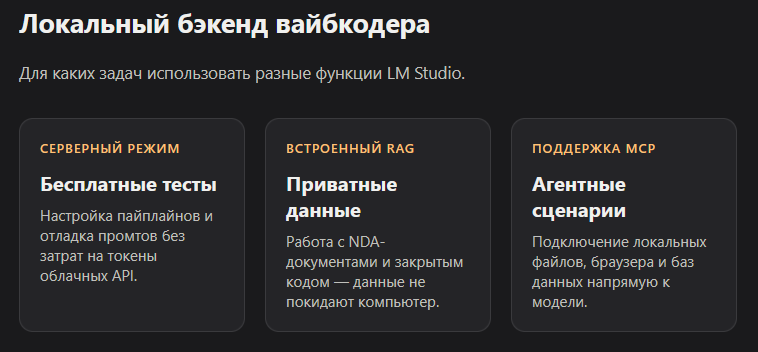
Разработка полностью на LM Studio, продакшн на облачном API — самая частая связка, которая экономит бюджет без потери качества там, где оно критично.
Собирается цепочка так: включить серверный режим в LM Studio → указать код на локальный base_url вместо облачного → отлаживать логику, промты и агентные сценарии бесплатно, сколько угодно раз → добавить RAG для работы с приватными документами прямо на этапе разработки → подключить пару MCP-инструментов, если сценарий агентный → и только когда логика проверена, переключить base_url обратно на настоящий облачный провайдер для продакшена, где важны стабильность и качество на сложных случаях.
| Компонент LM Studio | Что дает | Когда включать |
|---|---|---|
| Серверный режим | OpenAI-совместимый API на localhost | Локальная разработка и тесты без затрат на токены |
| Chat with Documents / RAG | Контекст из своих файлов без внешней базы данных | Работа с приватными или большими документами |
| Agents / MCP | Подключение инструментов (файлы, браузер, код) | Агентные сценарии, автоматизация |
| /v1/responses | Хранение истории на стороне сервера по id | Многошаговые диалоги без ручной сборки контекста |
Сильные и слабые стороны LM Studio как локального сервера
Сильная сторона — совместимость. Формат ответов один в один повторяет OpenAI, поэтому переключение между локальной и облачной моделью занимает буквально одну строку в конфиге, а не переписывание интеграции. Вторая сильная сторона — приватность из коробки: и RAG, и агентный режим работают на данных, которые физически не покидают компьютер, что закрывает вопрос с NDA-документами без дополнительной настройки шифрования или отдельного контура.
Слабая сторона — это все равно локальное железо, а не датацентр. Скорость инференса и объем контекста прямо зависят от того, что стоит в компьютере: на дискретной видеокарте инференс заметно быстрее, чем на обычном процессоре без ускорителей, а маленькие модели, которые помещаются в память ноутбука, чаще ошибаются в коде — путают методы, забывают условия, разбивают функции пополам. Второй минус — встроенный RAG удобен для личного использования, но менее гибкий, чем собственный production-пайплайн с полным контролем над чанкованием и рерангом.
Часто задаваемые вопросы про LM Studio API
Какой порт использует LM Studio по умолчанию?
По умолчанию сервер поднимается на порту 1234. Поменять его можно в Server Settings приложения или флагом при запуске через lms server start --port.
Нужен ли API-ключ для подключения к LM Studio?
Нет, локальный сервер не требует авторизации. В клиентских SDK поле api_key можно оставить пустым или заполнить любой строкой-заглушкой.
Почему /v1/embeddings отвечает ошибкой 404?
Чаще всего потому, что в LM Studio не загружена отдельная embedding-модель, например nomic-embed-text. Обычная чат-модель эмбеддинги не считает.
Можно ли использовать LM Studio вместе с Cursor или Cline?
Да, оба инструмента поддерживают кастомный base_url. Достаточно выбрать провайдера LM Studio в настройках и указать адрес локального сервера.
Чем RAG в LM Studio отличается от production RAG-пайплайна?
Встроенный RAG прячет всю инфраструктуру внутри приложения — векторное хранилище и эмбеддинги настраиваются автоматически. Это удобно для личного использования, но менее гибко и масштабируемо, чем собственный пайплайн с контролем над чанкованием, реиндексацией и рерангом.
Замедляет ли reasoning ответы в LM Studio API?
Да, заметно. На одном и том же простом запросе включенный reasoning увеличивал время ответа примерно в 4 раза по сравнению с отключенным.
Сколько MCP-инструментов можно подключить к одной модели?
Рекомендуется держать 10-20 активных инструментов одновременно — больше начинает путать модель при выборе нужного тула.
Локальный сервер удобен на этапе разработки, но выбор самой IDE и провайдера моделей задает потолок скорости всего пайплайна. Обзоры инструментов для вайбкодинга — в каталоге AI IDE VibeCoderz, а если нужна помощь со связкой локальных и облачных моделей под конкретный проект — запишитесь на консультацию к Максиму.
Материалы по теме: локальная нейросеть для программирования, LM Studio и LM Link на iPhone, RAG для вайбкодеров простым языком, MCP-сервер с Ollama и LM Studio.
Источники: документация LM Studio по OpenAI-совместимому серверу, документация LM Studio по RAG и Chat with Documents, анонс MCP в LM Studio 0.3.17.
Обновлено: октябрь 2026.