
Когда в системе работает не один AI-агент, а несколько, встает практический вопрос: кому именно отдать конкретный запрос. Маршрутизация задач между агентами — это слой логики, который решает эту задачу за доли секунды, до того как основная модель вообще увидит запрос. Ниже разберем три рабочих подхода, живой пример конфигурации для саппорт-системы и честный расчет, когда роутер окупается, а когда только добавляет расходов.
TL;DR. Три подхода к маршрутизации задач между агентами: жесткие правила, классификация моделью и балансировка нагрузки. Правила быстрые и предсказуемые, но требуют ручных обновлений. Классификатор гибче — распознает новые формулировки сам. Балансировка нужна, когда агентов-дублеров несколько. Ниже — конфигурация для саппорта и расчет окупаемости.
Что такое маршрутизация задач между агентами?
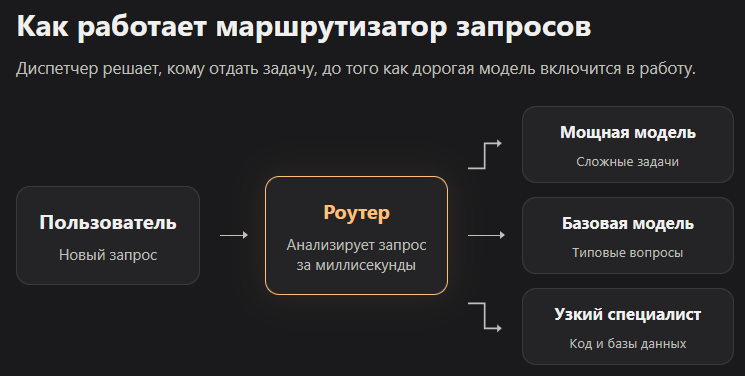
Маршрутизация — это точка принятия решения перед вызовом основной модели: система определяет тип запроса и направляет его нужному агенту или нужной модели.
Роутер работает как диспетчер: запрос приходит, диспетчер за миллисекунды решает, кому его передать, и только потом дорогая модель включается в работу. По оценке Anthropic, маршрутизация входит в пять базовых паттернов построения агентных систем, наряду с цепочкой промптов и оркестратором с воркерами.
Без роутера каждый запрос идет к одной и той же модели, независимо от сложности. Это просто и надежно на старте, но дорого на масштабе. Роутер добавляет промежуточный шаг: он смотрит на запрос и решает, куда его отправить. Иногда это одна строка кода с условием, иногда отдельная маленькая модель-классификатор.
Подробно про архитектуру агентных систем и паттерн Routing можно почитать в материалах Anthropic по построению эффективных агентов.
Чем маршрутизация отличается от команды с тимлидом?
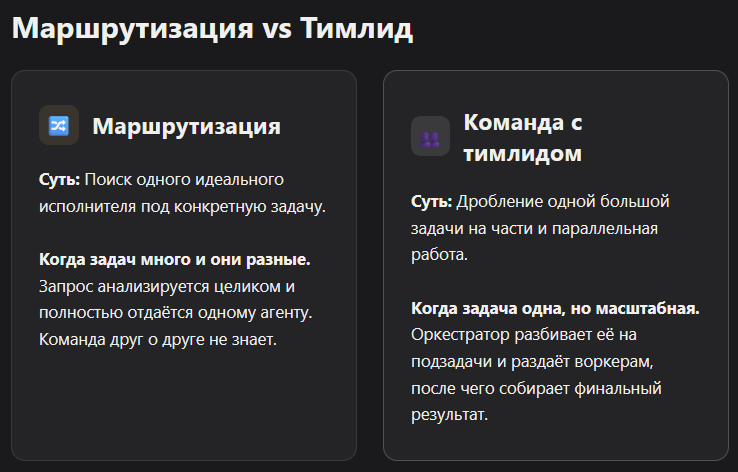
Маршрутизация выбирает одного исполнителя из нескольких вариантов. Команда с тимлидом дробит одну задачу на части и раздает их параллельно нескольким подчиненным агентам.
В командном режиме Claude Code тимлид разбивает задачу на подзадачи и раздает их подчиненным агентам, каждый из которых работает в своей сессии и не видит общую картину. Это паттерн оркестратор-воркеры, а не маршрутизация: там задача одна, просто поделена на части. У роутинга задача целиком уходит одному агенту или одной модели.
Различие простое: если задача одна и большая, ее делят на кусочки и раздают команде. Если задач много, разных и мелких, для каждой ищут подходящего исполнителя. Второй случай и есть маршрутизация. На VibeCoderz паттерн лидер-воркеры разобран отдельно, здесь фокус только на алгоритмической части выбора конкретного агента под конкретный запрос.
Какие три подхода к маршрутизации задач существуют?
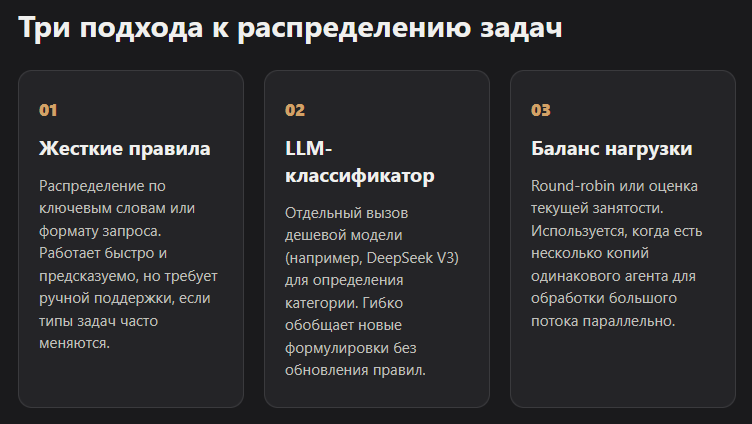
Жесткие правила проще всего реализовать, классификация моделью гибче под новые формулировки, балансировка нагрузки решает другую задачу — распределение одинаковых запросов между копиями одного агента.
Три подхода закрывают разные ситуации: правила для известных категорий запросов, классификатор для разнообразных формулировок, баланс нагрузки для параллельных однотипных агентов. Ниже — короткое сравнение, а затем разбор каждого подхода отдельно.
| Подход | Как решает | Когда использовать | Сложность внедрения |
|---|---|---|---|
| Жесткие правила | По ключевым словам или формату запроса | Мало категорий, границы четкие | Низкая |
| Классификация моделью | Отдельный вызов дешевой модели определяет тип | Много формулировок, границы размыты | Средняя |
| Балансировка нагрузки | Round-robin или по текущей занятости | Несколько копий одного агента работают параллельно | Средняя |
Как работают жесткие правила?
Жесткие правила — самый простой вариант из трех. Заранее прописано, какой тип запроса куда идет: запросы с кодом всегда попадают агенту-программисту, запросы на естественном языке уходят агенту общего назначения. Работает предсказуемо и без задержек.
Минус один, но существенный. При появлении нового типа задачи, не описанного заранее, правила приходится обновлять руками. Если ассортимент запросов меняется часто, поддержка списка условий превращается в отдельную работу.
Как классификатор решает, какому агенту отдать задачу?
Классификация запроса моделью работает иначе: перед основной задачей запускается отдельный, обычно легкий и быстрый вызов модели. Его единственная функция — определить категорию входящего запроса, не решая саму задачу.
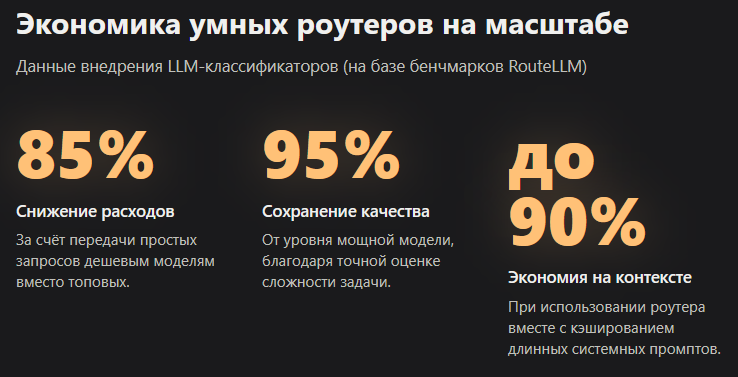
Гибкость здесь выше, чем у правил. Классификатору не нужно явно перечислять все возможные формулировки заранее, он обобщает на похожие, но ранее не встречавшиеся запросы. Именно эту идею в 2024 году формализовала команда LMSYS в открытом фреймворке RouteLLM: их обученные роутеры снижали расходы на MT-Bench более чем на 85%, сохраняя около 95% качества топовой модели. К 2026 году подход стал стандартом: по данным разбора Requesty, продакшн-роутеры на паре дешевая модель для классификации плюс мощная модель для синтеза дают 30-80% экономии в зависимости от нагрузки, в некоторых конфигурациях до 90% на кэшированных длинных системных промптах.
Когда нужна балансировка нагрузки между агентами?
Балансировка решает другую задачу. Она включается, когда несколько однотипных агентов способны выполнить одну и ту же работу и работают параллельно. Вопрос не "какой агент подходит", а "какому из одинаковых агентов отдать запрос прямо сейчас".
Простейший вариант — round-robin, по очереди. Более продвинутый вариант учитывает реальную загрузку каждого экземпляра в моменте и отправляет запрос тому, кто сейчас свободнее. На небольшом трафике разница между вариантами почти не заметна, на высокой нагрузке round-robin начинает перегружать отдельные агенты, пока другие простаивают.
Как настроить маршрутизацию для саппорт-системы на практике?
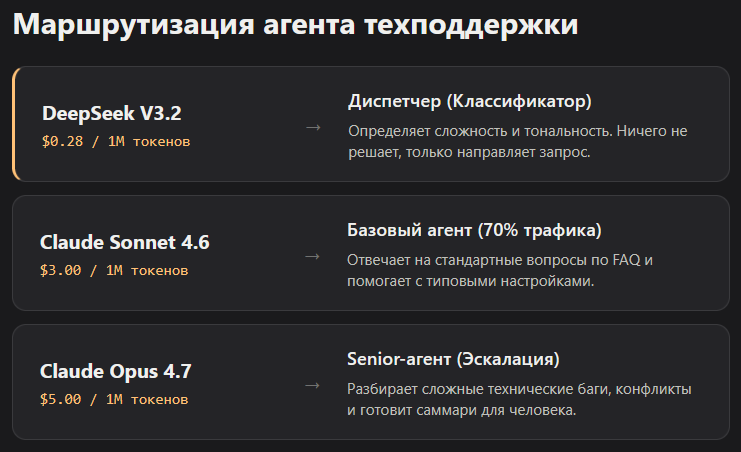
Классификатор на дешевой модели определяет сложность и тему обращения, простые вопросы уходят агенту с базовой моделью, сложные и эскалационные — агенту с мощной моделью.
В типовом сценарии саппорта классификатор на дешевой модели сортирует входящие вопросы, а до 70-80% простых обращений закрывает базовая модель, не трогая дорогую. Это практическая конфигурация, которую можно собрать за один вечер даже без своего сервера, например для агента техподдержки.
Схема такая. Классификатор на дешевой и быстрой модели определяет сложность и тему вопроса пользователя. Стандартные и частые вопросы по FAQ маршрутизируются агенту с базовой моделью и коротким системным промптом. Сложные технические вопросы или явно недовольные обращения уходят агенту с более мощной моделью и развернутыми инструкциями по эскалации к живому человеку.
Для примера сопоставления моделей с ролями пригодится актуальная таблица цен и качества на март 2026 года:
| Модель | Цена (input/output за 1M токенов) | Роль в схеме |
|---|---|---|
| DeepSeek V3.2 | $0.28 / $0.42 | Классификатор, простые ответы по FAQ |
| Claude Sonnet 4.6 | $3 / $15 | Базовый агент для стандартных обращений |
| Gemini 3.1 Pro | $2 / $12 | Работа с длинным контекстом переписки |
| Claude Opus 4.7 | $5 / $25 | Сложные и конфликтные обращения, эскалация |
Когда дополнительный шаг классификации не окупается?
Классификатор — это лишний вызов модели, который добавляет задержку и стоимость к каждому запросу. Он оправдан, только если экономия от простых запросов на дешевой модели превышает эту добавку.
На большом трафике классификация почти всегда окупается: экономия от направления легких запросов на дешевую модель перекрывает стоимость самого шага классификации в разы. На маленьком масштабе картина обратная: 10-20 запросов в день не создают экономии, способной покрыть даже минимальные накладные расходы на инфраструктуру роутера.
Здесь стоит честная оговорка. Классификация моделью — не универсально лучший вариант по умолчанию. При небольшом объеме трафика простые жесткие правила почти всегда практичнее: меньше движущихся частей, меньше точек отказа, ничего не нужно обучать или дообучать. Добавлять классификатор имеет смысл, когда объем запросов уже ощутимый и разнообразие формулировок реально мешает жестким правилам справляться.
Максим: «У Нейроскрайба ждали от разработчика неделю-две-три. У Нейроштата целая команда работала — ждали целую фичу месяцами. Получили — и разочаровались, потому что время реализации критично.»
Урок здесь простой. Чем сложнее архитектура, тем дольше ее собирать и тем больше шансов, что сложность не окупится результатом. Roутер стоит добавлять под реальный объем, а не про запас.
Частые вопросы про маршрутизацию задач между агентами
Что такое агент-роутер простыми словами?
Это программа или маленькая модель, которая смотрит на входящий запрос и решает, какому агенту или какой модели его передать. Сама задачу не решает, только направляет.
Обязательно ли использовать отдельную модель для классификации?
Нет. На старте достаточно жестких правил по ключевым словам или формату запроса. Отдельную модель-классификатор добавляют, когда правила перестают справляться с разнообразием запросов.
Какая модель лучше подходит на роль классификатора?
Дешевая и быстрая: DeepSeek V3.2 или аналогичный по классу вариант. Классификатору не нужна глубина рассуждений, нужна скорость и низкая цена за вызов.
Что делать, если классификатор ошибся с выбором агента?
Закладывать фолбэк на случай неуверенности: если классификатор сомневается, запрос уходит на более мощную модель по умолчанию, а не остается у слабой.
Работает ли маршрутизация в no-code сборках без своего сервера?
Да, схему классификатор плюс два-три агента можно собрать через n8n или Make.com, вызывая модели по API без своей инфраструктуры.
Чем балансировка нагрузки отличается от классификации?
Классификация выбирает, какой тип агента подходит задаче. Балансировка выбирает, какому именно экземпляру из одинаковых агентов отдать запрос прямо сейчас.
Стоит ли строить маршрутизацию для проекта с одним агентом?
Нет смысла. Роутинг нужен там, где реально есть выбор между несколькими агентами или моделями. Для одного агента это лишний слой без пользы.
Глоссарий терминов маршрутизации
- Маршрутизация (routing) — определение, какому агенту или модели передать конкретный запрос.
- Роутер — компонент, который принимает это решение: правило, модель-классификатор или их комбинация.
- Классификатор — легкая модель, определяющая категорию или сложность запроса перед его обработкой.
- Балансировка нагрузки — распределение однотипных запросов между несколькими копиями одного агента.
- Round-robin — простейший способ балансировки, запросы раздаются по очереди.
- Фолбэк — запасной сценарий на случай, если роутер не уверен в выборе или основной агент недоступен.
- Эскалация — передача запроса от слабого агента к более мощному или к живому человеку.
- LLM-шлюз (LLM Gateway) — сервис вроде Portkey или LiteLLM, который берет маршрутизацию между моделями на себя из коробки.
Если вы собираете команду агентов и не знаете, с какого подхода начать, посмотрите каталог AI-инструментов и IDE на VibeCoderz или запишитесь на консультацию к Максиму — разберем вашу конкретную схему.