
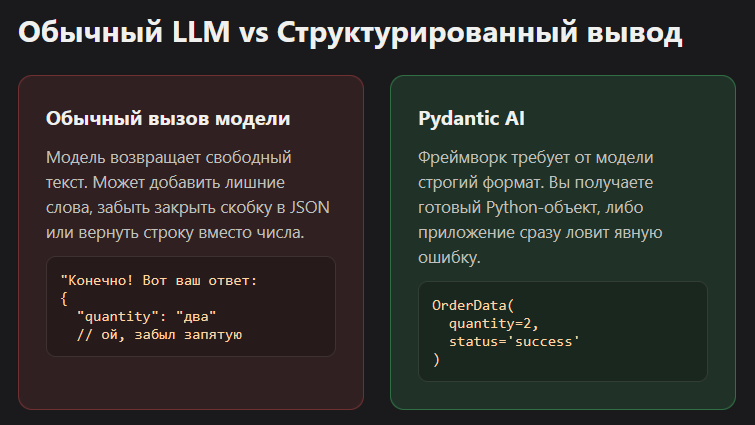
Pydantic AI — это Python-фреймворк от команды Pydantic, той же самой, что стоит за библиотекой валидации данных внутри FastAPI. Он решает одну конкретную проблему: обычный вызов языковой модели возвращает свободный текст, а приложению нужен предсказуемый JSON с нужными полями. Pydantic AI гарантирует, что агент либо вернет объект, который точно соответствует заданной схеме, либо явно сообщит об ошибке валидации.
Pydantic AI — это не замена LangGraph или CrewAI. Это инструмент для узкой, но критичной задачи: сделать так, чтобы ответ модели можно было безопасно передать дальше в код, не гадая, распарсится он или нет.
Дальше разберем, зачем вообще нужен типизированный вывод, чем он отличается от JSON Mode и function calling, покажем минимальный пример агента и честно скажем, где Pydantic AI не подходит.
Зачем нужен структурированный вывод, если модель и так пишет по-русски и по-английски?
Обычный текстовый ответ модели невозможно передать напрямую в код без риска, что парсинг сломается на непредсказуемых входных данных. Структурированный вывод превращает ответ в объект с заранее известными полями и типами.
Модель может написать «конечно, вот ответ в формате JSON» и потом забыть закрыть скобку. В демо это смешно, в продакшене — это упавший пайплайн в три часа ночи. Именно эту проблему называют production-разработчики главной причиной перехода на типизированный вывод: без него каждый ответ модели требует защитного кода с try/except на случай, что формат окажется не тем.
Тут есть нюанс, который редко объясняют новичкам. Языковая модель не «знает» JSON-схему заранее — она обучена генерировать правдоподобный текст. Поэтому просить модель «ответь строго в JSON» через обычный промпт — это просьба, а не гарантия. Модель может согласиться, а может на пятом поле решить, что было бы уместнее описание в свободной форме.
В Pydantic AI эта просьба заменяется на архитектурное ограничение. Разработчик описывает Pydantic-модель — обычный Python-класс с типами полей — и фреймворк требует от провайдера модели (OpenAI, Anthropic, Google и другие) вернуть данные, которые пройдут валидацию этой схемы. Если не проходят — Pydantic AI кидает явную ошибку вместо того, чтобы отдать битые данные дальше по цепочке.
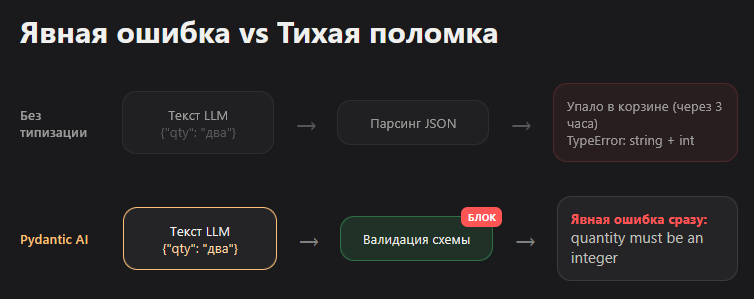
Чем плоха тихая поломка формата и почему явная ошибка валидации лучше
Тихая поломка — это когда модель ответила не в том формате, но приложение все равно попыталось работать с этим ответом и сломалось где-то дальше, в непредсказуемом месте. Явная ошибка валидации останавливает выполнение сразу там, где реально возникла проблема.
Разница кажется мелочью, пока не столкнешься с ней на реальном трафике. Допустим, агент извлекает из письма клиента данные заказа: имя, товар, количество, адрес доставки. Без типизации модель иногда вернет количество как строку «два», а не число 2. Код, который ждет integer, упадет — но не сразу, а где-нибудь в модуле расчета доставки, куда это значение долетело через три функции. Отладка такого бага занимает часы: нужно восстановить цепочку вызовов и понять, откуда взялась строка вместо числа.
С типизированным выводом Pydantic-модель для заказа описывает quantity: int. Если модель вернула «два» вместо 2, Pydantic AI ловит несоответствие сразу на границе между LLM и остальным кодом и явно говорит, где именно расхождение. Ошибка становится диагностируемой за секунды, а не за часы разбора логов. Это тот самый класс багов «модель ответила не в том формате», который сложно поймать на десяти тестовых примерах, но который регулярно всплывает на реальном разнообразии пользовательских запросов.
Есть и обратная сторона, о которой честно стоит сказать. Жесткая схема не защищает от смысловых галлюцинаций: модель может сгенерировать структурно валидный, но фактически неверный ответ. Разбор влияния ограничений на качество вывода на бенчмарках вроде GSM8K показывает: на задачах, которые требуют многошаговых рассуждений, слишком жесткие ограничения формата иногда снижают качество ответа, а вот на задачах классификации, где нужно просто выбрать один из вариантов, структурированный вывод, наоборот, помогает. Разработчику стоит закладывать это в архитектуру: не для любой задачи типизация одинаково полезна.
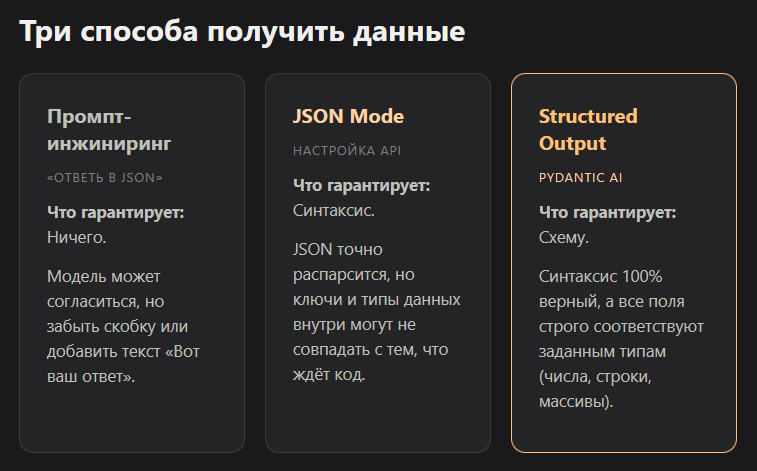
Structured output, JSON Mode и function calling — в чем разница
JSON Mode гарантирует только валидный синтаксис JSON, но не соответствие конкретной схеме. Function calling изначально создавался для вызова инструментов, а не для получения структурированных данных. Полноценный structured output гарантирует и синтаксис, и соответствие всем полям заданной схемы.
Эти три метода часто путают, а разница в них принципиальная для продакшена.
| Метод | Что гарантирует | Где ломается |
|---|---|---|
| Промпт-инжиниринг («ответь в JSON») | Ничего технически | Модель может не закрыть скобку или пропустить поле |
| JSON Mode | Синтаксически валидный JSON | Поля и типы могут не совпадать со схемой |
| Function calling | Вызов инструмента с параметрами | Изначально не для чистого извлечения данных |
| Structured output (Pydantic AI) | Синтаксис + соответствие схеме | Не защищает от смысловых галлюцинаций |
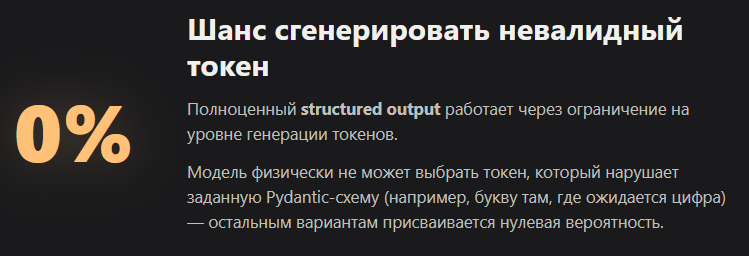
Под капотом полноценный structured output работает через ограничение генерации на уровне токенов: на каждом шаге модели разрешены только те токены, которые не нарушают заданную схему, остальным присваивается нулевая вероятность. Из-за этого у модели физически нет возможности сгенерировать невалидный по структуре токен — а как бонус, генерация чуть быстрее, потому что вероятности считаются для меньшего набора токенов.
Хорошая практика, которая снижает риск смысловых ошибок при жесткой схеме — все равно передавать модели саму схему в системном промпте, даже если технически это не обязательно. Так модель видит доступные варианты заранее, а не выбирает вслепую внутри уже наложенного ограничения.
Как выглядит минимальный агент с типизированным выводом
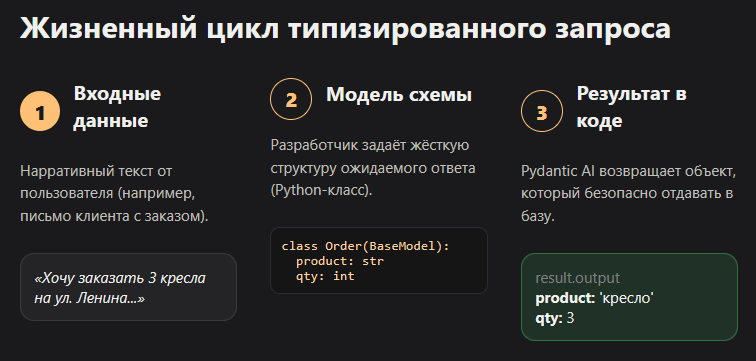
Минимальный пример — агент, который извлекает данные заказа из текста письма клиента: имя, товар, количество, адрес. Pydantic-модель описывает ожидаемые поля, и агент либо возвращает валидный объект, либо явно сообщает, что не смог извлечь нужные данные.
Разработчик описывает результат как обычный Python-класс с типами — примерно так, как описывают модель данных в FastAPI:
from pydantic import BaseModel
from pydantic_ai import Agent

class OrderData(BaseModel):
    customer_name: str
    product: str
    quantity: int
    delivery_address: str

agent = Agent(
    "openai:gpt-5.4",
    output_type=OrderData,
    system_prompt="Извлеки данные заказа из письма клиента.",
)

result = agent.run_sync(
    "Здравствуйте, меня зовут Ирина, хочу заказать 3 кресла "
    "с доставкой на ул. Ленина 12."
)

print(result.output)
Если письмо не содержит всех нужных данных, фреймворк не станет выдумывать правдоподобные, но неверные значения — вернет ошибку валидации, которую можно поймать и обработать явно, например попросить пользователя уточнить адрес. Это и есть разница между «модель постаралась угадать» и «модель честно сказала, что данных не хватает».
Pydantic AI, LangChain или CrewAI — что выбрать для проекта
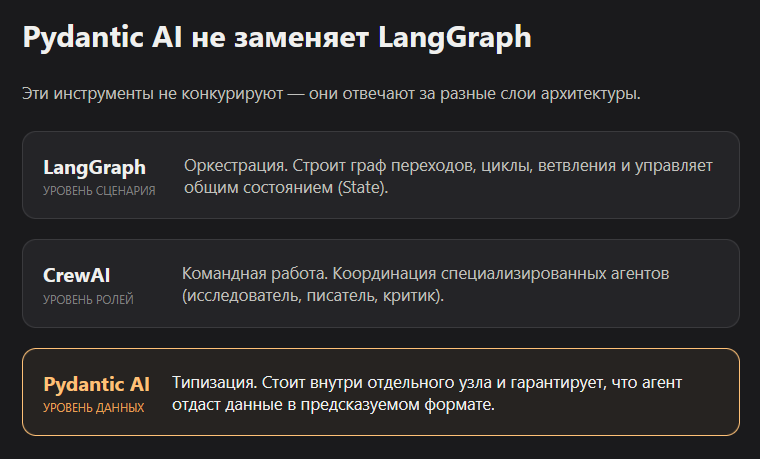
Pydantic AI не конкурирует с LangGraph или CrewAI напрямую — это разные слои задачи. LangGraph и CrewAI отвечают за оркестрацию многошаговых сценариев с несколькими агентами, а Pydantic AI — за то, чтобы ответ конкретного агента всегда приходил в предсказуемом формате.
Путаница возникает, потому что все три инструмента называют себя «фреймворками для AI-агентов». На практике задачи разные.
| Инструмент | Основная задача | Когда выбирать |
|---|---|---|
| Pydantic AI | Типизированный вывод, валидация, DI | Нужен предсказуемый формат ответа для дальнейшей обработки кодом |
| LangGraph | Оркестрация сценариев со множеством шагов и состоянием | Нужен граф переходов между узлами, ветвления, циклы |
| CrewAI | Координация нескольких агентов-ролей | Нужна командная работа нескольких специализированных агентов |
| Coding agent SDK (Claude Agent SDK, Codex SDK) | Быстрый личный агент поверх готовой модели | Персональный ассистент без строгих требований к формату |
На практике эти инструменты нередко комбинируют: LangGraph строит граф шагов сценария, а внутри отдельного узла, где нужен строгий JSON для передачи в базу данных или другой сервис, ставят агента на Pydantic AI. Про то, как в принципе устроена stateful-оркестрация через граф состояний, у нас есть отдельный разбор LangGraph — что это и зачем нужен.
Отдельная развилка — писать код агента руками или отдать это кодинг-агенту вроде Cursor или Claude Code. У Pydantic AI очень подробная документация, рассчитанная в первую очередь на то, чтобы ее «скормили» кодинг-агенту как контекст, а не читали построчно человеком. Разработчик описывает задачу и передает ссылку на документацию агенту, тот пишет код агента сам, ориентируясь на актуальные паттерны фреймворка.
Кому Pydantic AI точно не подходит
Pydantic AI не заменяет полноценный оркестратор мультиагентных сценариев и требует базового знания типов данных Python. Для простого личного бота без строгих требований к формату ответа это избыточно.
Если задача — быстрый Telegram-бот, который просто отвечает текстом на вопросы, типизированный вывод не нужен вообще: это лишняя сложность ради проблемы, которой еще нет. Pydantic AI раскрывается там, где ответ агента дальше идет в код: в базу данных, в API другого сервиса, в отчет с фиксированной структурой.
Второе ограничение честно стоит проговорить: чтобы описывать схемы, нужно понимать базовые типы данных Python — что такое int, str, list, optional-поле. Без этого фундамента даже с помощью кодинг-агента будет сложно понять, почему схема не проходит валидацию. Если пробел именно здесь, для начала стоит закрыть базу — у нас есть отдельный материал про типы данных в Python.
Третий момент — экономика токенов. Подробные Pydantic-модели с десятками полей и длинными системными промптами увеличивают расход входных и выходных токенов на каждый вызов. На локальных небольших моделях жесткая схема иногда ощутимо просаживает качество ответа — там, где ресурсов провайдера уровня GPT или Claude достаточно, разница почти не заметна.
Куда движется Pydantic AI дальше
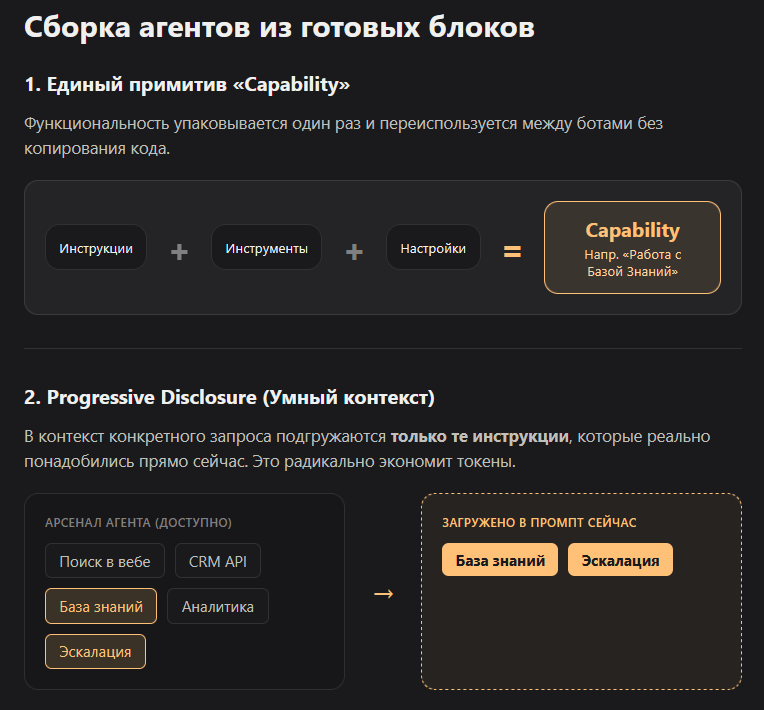
Свежий релиз фреймворка вводит единый примитив — capability, который объединяет инструкции агента, инструменты, хуки и настройки модели в одну переиспользуемую единицу. Это шаг к тому, чтобы собирать агентов из готовых блоков, а не переписывать логику для каждого нового бота.
Идея в том, чтобы функциональность агента — например работу со внутренней базой знаний или эскалацию проблемы на человека — можно было упаковать один раз и переиспользовать между разными ботами без копирования кода. Дополнительно framework поддерживает progressive disclosure: агенту можно выдать десятки возможностей одновременно, но в контекст конкретного запроса подгрузятся только те инструкции, которые реально понадобились.
Для вайбкодера, который строит не один микропродукт, а линейку, это снижает объем повторяющегося кода между проектами.
Сколько стоит Pydantic AI и что нужно для старта
Сам фреймворк распространяется бесплатно с открытым исходным кодом, платить нужно только за токены выбранного провайдера модели — OpenAI, Anthropic, Google или другой. Для отладки и трейсинга агентов у команды Pydantic есть отдельный сервис наблюдаемости Logfire с бесплатным личным тарифом и платными командными планами — но для первого агента он не обязателен, можно начать с локального логирования.
Для старта нужны: Python 3.10+, установленный пакет pydantic-ai, ключ API у любого поддерживаемого провайдера модели. Дальше — тот самый шаблон агента с Pydantic-моделью выше.
FAQ по Pydantic AI
Что такое Pydantic AI простыми словами?
Это Python-библиотека, которая заставляет ответ AI-модели соответствовать заранее описанной структуре — вместо текста разработчик получает готовый объект с нужными полями и типами.
Чем Pydantic AI отличается от обычного promt-инжиниринга с просьбой дать JSON?
Промпт — это просьба, а не гарантия: модель может ее нарушить. Pydantic AI ограничивает саму генерацию на уровне токенов, поэтому модель физически не может выдать структуру, которая нарушает схему.
Можно ли использовать Pydantic AI с локальными моделями?
Да, но не все локальные модели одинаково хорошо поддерживают ограниченную генерацию — современные модели вроде свежих версий Qwen справляются заметно лучше старых.
Pydantic AI заменяет LangGraph или CrewAI?
Нет. Pydantic AI решает задачу типизированного вывода одного агента, а LangGraph и CrewAI — задачу оркестрации нескольких шагов или нескольких агентов. Инструменты часто используют вместе.
Нужно ли знать Python, чтобы работать с Pydantic AI?
Базовое понимание типов данных нужно обязательно — без этого сложно составлять и читать Pydantic-модели, даже если сам код агента пишет за вас кодинг-агент.
Замедляет ли структурированный вывод ответ модели?
Нет, чаще наоборот — ограничение набора допустимых токенов немного ускоряет генерацию, потому что вероятности считаются для меньшего числа вариантов на каждом шаге.
Стоит ли использовать структурированный вывод для любой задачи?
Нет. Для задач классификации с ограниченным набором ответов он почти всегда полезен, а вот в задачах со сложным многошаговым рассуждением жесткая схема иногда снижает качество итогового ответа.
Если хотите не гадать, какой стек выбрать под конкретный продакшн-продукт, а сразу собрать рабочую архитектуру — загляните в каталог AI-инструментов на портале или запишитесь на консультацию к Максиму. А если уже строите AI-продукт и думаете, когда переписывать самодельный код на нормальный фреймворк — у нас есть разбор про технический долг в AI-коде.
Обновлено: октябрь 2026