
Qwen 3.8 это линейка моделей Alibaba, флагман которой построен на MoE-архитектуре с 2,4 трлн параметров. Анонс прошел 19 июля 2026 года на WAIC в Шанхае, API открыли 3 августа, а открытые веса обещание сдержали: в августе выложили и флагман, и компактные версии. Ниже разберем всю линейку (Max, 27B, Flash и Next), цены, бенчмарки, реальные тесты из YouTube и что из этого можно запустить у себя уже сегодня.
TL;DR. Qwen 3.8 Max стоит $2/$6 за 1M токенов и держит контекст 1M, но на SWE-bench Pro уступает Fable 5 (67,7 против 80,0 по данным Alibaba). Открытые веса доступны: 27B под Apache 2.0 идет на одной видеокарте, Flash-Next и 2.4T-флагман идут с ограничениями лицензии. В статье: таблица версий, цены, тесты и карта выбора.
Что такое Qwen 3.8 и когда он вышел?
Qwen 3.8 это четвертое за 2026 год поколение моделей Alibaba. Флагман вышел в API 3 августа, открытые веса появились в течение августа, обновленный снапшот Max-0902 вышел 2 сентября.
Alibaba показала превью Qwen 3.8 Max на World AI Conference в Шанхае 19 июля 2026 года. Через две недели, 3 августа, модель открыли в API через Model Studio. Компания заявила, что по сумме бенчмарков модель уступает только Claude Fable 5 от Anthropic. Открытые веса вышли в августе, хотя обещание «через неделю» сначала встретили скептически.
Хронологию собрал итальянский аналитический блог noze.it, а остальные даты мы сверили по карточкам моделей.
| Дата (2026) | Что вышло |
|---|---|
| 19 июля | Анонс Max Preview на WAIC в Шанхае |
| 3 августа | Max в API, контекст 1M токенов |
| 12 августа | Открытые веса флагмана Qwen3.8-2.4T-A95B |
| 14 августа | 27B, веса под Apache 2.0 |
| 26 августа | Flash в API и открытый Flash-Next |
| 2 сентября | Снапшот Qwen3.8-Max-0902 с улучшенным длинным кодингом |
Как устроена MoE-архитектура на 2,4 трлн параметров?
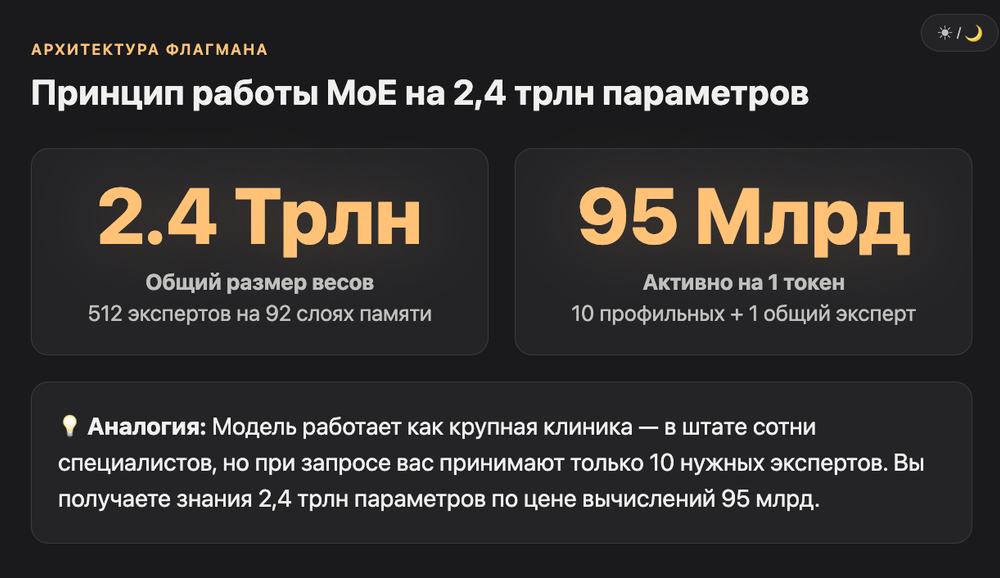
Флагман Qwen 3.8 хранит 2,4 трлн параметров, но на каждый токен включает около 95 млрд. Поэтому он работает быстрее и дешевле, чем подсказывает размер.
Открытый чекпоинт Qwen3.8-2.4T-A95B содержит 92 слоя и 512 экспертов. На каждый токен работают 10 экспертов плюс один общий, это примерно 95 млрд активных параметров. Нативный контекст 262 144 токена, с расширением он дотягивает до 1 010 000.
MoE (Mixture of Experts) удобно представить как поликлинику. В здании сотни врачей, но вас принимают двое-трое профильных. Модель «знает» много, а платите вы вычислениями только за тех экспертов, которых она позвала.
Есть нюанс. Открытая версия флагмана только текстовая и всегда работает в режиме рассуждений. Зрение, встроенные инструменты и режим без thinking остались в облачном Max. А запустить 2,4 трлн параметров дома нереально: это задача для серверной стойки, а не для рабочего ноутбука.
Что умеет Qwen 3.8 Max и сколько он стоит?
Qwen 3.8 Max стоит $2 за миллион входных токенов и $6 за выходные, кэш обходится в $0,25. Контекст 1M, вывод до 131 072 токенов, на входе текст и изображения.
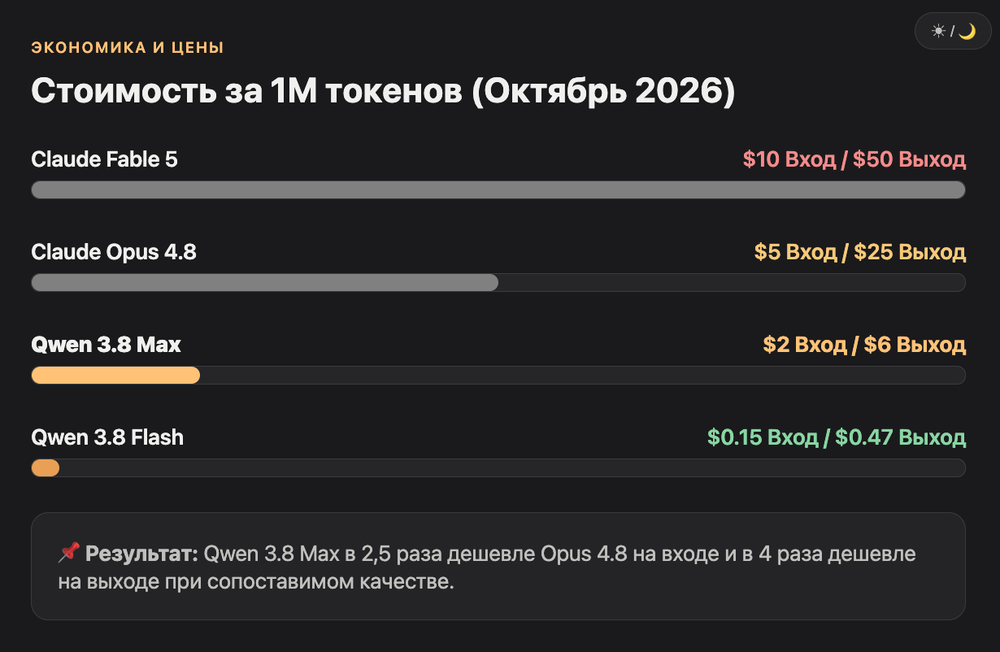
Облачный Max в 2,5 раза дешевле Claude Opus 4.8 на входе и в 4 раза на выходе. По данным pricepertoken.com, ставка $2/$6 за 1M токенов действует с 3 августа 2026 года. Для агентных задач с длинным контекстом это главный аргумент: Max дает уровень флагмана по цене модели среднего класса.
Модель позиционируют под долгие агентные сценарии: работа с целым репозиторием, исследовательские задачи на десятки шагов, управление интерфейсом компьютера. Встроенный vision-цикл позволяет Max смотреть на собственный UI-вывод и исправлять код по скриншоту.
Сколько стоит Max на фоне конкурентов
Цены по состоянию на октябрь 2026 года, за 1M токенов:
| Модель | Вход | Выход | Контекст |
|---|---|---|---|
| Claude Fable 5 | $10 | $50 | 1M |
| Claude Opus 4.8 | $5 | $25 | 1M |
| Max | $2 | $6 | 1M |
| Qwen 3.7 Max | $1,25 | $3,75 | 1M |
| Flash | $0,15 | $0,47 | 1M |
| DeepSeek V4 Flash | $0,14 | $0,28 | 1M |
Поделимся лайфхаком из видео-тестов. В Alibaba Cloud Model Studio для региона Сингапур дают бесплатную квоту около 1 млн токенов на каждую модель. Автор одного обзора прогнал на ней четыре проекта и сжег 2 млн токенов без ошибок. Почему лимит не сработал, непонятно, так что рассчитывать стоит на базовый миллион.
Насколько Qwen 3.8 Max отстает от Fable 5 и Opus 4.8?
На программировании Qwen 3.8 Max отстает от Fable 5 на 12 пунктов SWE-bench Pro. Зато в задачах управления компьютером и следования инструкциям он среди лидеров.
По собственным замерам Alibaba, Max-0902 набирает 67,7% на SWE-bench Pro против 80,0% у Fable 5. На OSWorld-Verified модель показывает 86,1%, на IFBench 82,8 против 72,7 у GPT-5.6 Sol. Это заявления вендора: независимые лаборатории на сентябрь 2026 года цифры еще не воспроизвели.
| Бенчмарк | Max | Конкурент |
|---|---|---|
| SWE-bench Pro | 67,7 | Fable 5: 80,0 |
| Terminal-Bench 2.1 | 86,6 | GPT-5.6 Sol: 88,8 |
| OSWorld-Verified | 86,1 | нет сравнения |
| PaperBench | 93,0 | GPT-5.6 Sol: 90,5 |
| GPQA Diamond | 92,6 | Qwen 3.7 Max: 92,4 |
| IFBench | 82,8 | GPT-5.6 Sol: 72,7 |
Для сравнения с прошлым поколением: Qwen 3.7 Max в июне набирал 60,6% на SWE-bench Pro, Claude Opus 4.8 показывал 69,2%. То есть новый Max почти догнал Opus 4.8 в кодинге при цене в разы ниже. А вот до Fable 5 дистанция заметная, и на сложном многофайловом рефакторинге она ощущается.
Как Qwen 3.8 Max показал себя в реальных тестах?
Блогеры дали Max десятки практических задач. Функционал модель собирает уверенно и быстро, а слабое место у нее в визуале: текстуры, мелкие баги верстки, физика.
В видеотестах Max собрал трекер финансов за 6 минут, симулятор криптобиржи за 10 минут и 3D-кубик Рубика за 10,5 минут. Сцена с физикой разрушения заняла почти 22 минуты и два ручных вмешательства. Функционал почти везде работал, а вот дизайн и текстуры авторы называли простенькими.
Что получилось хорошо
Самый показательный эпизод: в тесте 3D-аквариума модель сама добавила кормление рыб, хотя в промпте этого не было. Рыбы плыли к корму, у каждой появилось имя. Лендинг в превью-версии ломался, текст перекрывал декоративный фонарик. В релизе тот же промпт дал аккуратную страницу с адаптивом и 3D-объектом, который следует за курсором.
Где модель ошибается
Один автор подключил превью-версию к агенту для миграции данных и правки чужого проекта. Модель не заметила поломанный русский текст в интерфейсе и некликабельную кнопку, хотя отчиталась об успехе. Вывод простой: проверяйте мобильную версию, консоль и кириллицу руками. Отчету агента верить на слово не стоит.
На что способен Qwen 3.8 27B на домашней видеокарте?
Qwen 3.8 27B это плотная модель на 27 млрд параметров под Apache 2.0. В кванте Q4 она помещается в 24 ГБ видеопамяти, а урезанные кванты работают даже на картах с 16 ГБ.
Qwen 3.8 27B вышел 14 августа 2026 года под лицензией Apache 2.0, то есть его можно использовать в коммерции без отдельного договора. По данным Alibaba, модель набирает 61,7% на SWE-bench Pro и 90,3% на LiveCodeBench v6. Для сравнения: это уровень, который год назад показывали только облачные флагманы.
Архитектурно новая 27B повторяет Qwen 3.6 27B: те же 64 слоя, гибрид из линейного и полного внимания. Специалисты, тестировавшие обе версии, получили одинаковую скорость генерации. Разница в весах: интерфейсы у 3.8 заметно аккуратнее, а память между сессиями в чат-боте модель реализовала без подсказок.
Сколько памяти нужно 27B
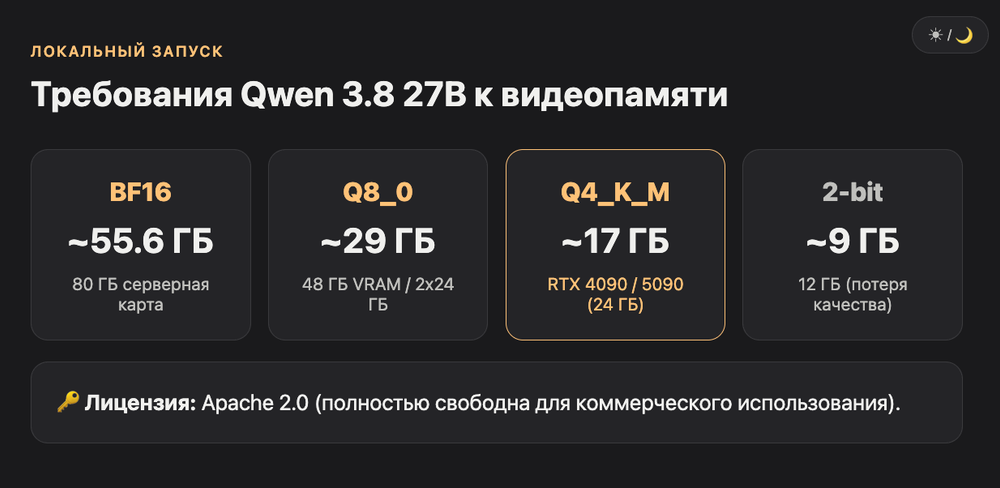
| Формат | Объем | Под какую карту |
|---|---|---|
| BF16 | ~55,6 ГБ | 80 ГБ серверная |
| Q8_0 | ~29 ГБ | 48 ГБ |
| Q4_K_M | ~17 ГБ | 24 ГБ (RTX 4090, 5090) |
| 2-битный | ~9 ГБ | 12 ГБ, с потерей качества |
Практика из тестов на RTX 5090: для контекста в 133 тысячи токенов берите квант Q5, иначе упретесь в память и потеряете скорость. На 16 ГБ золотой серединой оказался UD-Q3_K_XL, а UD-IQ4_XS выбирают, когда качество кода важнее запаса памяти.
Чем Qwen 3.8 Flash отличается от Qwen 3.8 Next?
Qwen 3.8 Flash это облачная API-модель за $0,15/$0,47. Qwen3.8-Flash-Next это ее открытая основа на 125 млрд параметров с 6 млрд активных, которую можно развернуть у себя.
Обе версии вышли 26 августа 2026 года. Flash-Next содержит 125 млрд основных параметров, еще 51 млрд N-gram эмбеддингов и активирует всего 6 млрд на токен. Alibaba прямо пишет в карточке, что Flash это официальная версия на базе Flash-Next с продакшен-функциями: контекстом 1M по умолчанию, интерпретатором кода и веб-поиском.
Qwen 3.8 Flash в API
Flash принимает текст и изображения, держит 1 млн токенов контекста и до 131 072 на выходе. За $0,15 на входе это одна из самых дешевых мультимодальных моделей 2026 года. Ее разумно ставить на массовые задачи: разбор документов, анализ кодовой базы, простые агентные шаги. Карточка модели есть на OpenRouter.
Qwen 3.8 Next для локального запуска
Суффикс Next в названии означает новую архитектуру: N-gram слои и эмбеддинги на уровне слоя (PLE), которые Alibaba обкатывает перед Qwen 4. Нативный контекст 262 144 токена, до 1M через YaRN.
По документации Unsloth, 4-битной версии нужно 96-114 ГБ оперативной или унифицированной памяти. Это уровень Mac Studio или сервера, а не игровой видеокарты. Зато 6 млрд активных параметров дают скорость около 170 токенов в секунду на RTX 6000 PRO с включенным MTP.
Какие открытые веса Qwen 3.8 можно использовать в коммерции?
Без ограничений в коммерции можно использовать только 27B под Apache 2.0. Флагман и Flash-Next идут под собственными лицензиями Alibaba с условиями для крупных сервисов.
Лицензии в линейке Qwen 3.8 разные, и это стоит проверить до того, как строить на модели продукт. Для 2.4T-флагмана отдельная лицензия нужна компаниям с выручкой выше $50 млн за 12 месяцев, если они продают модель как сервис или AI-ассистента. Внутреннее использование под ограничение не попадает, пишет eWeek.
| Модель | Веса | Лицензия | Коммерция |
|---|---|---|---|
| 27B | Открытые | Apache 2.0 | Свободно |
| Qwen3.8-2.4T-A95B | Открытые | Qwen3.8-Max License | Отдельный договор при выручке от $50 млн |
| Qwen3.8-Flash-Next | Открытые | Qwen Community License 1.0 | Нужен договор для хостинга и AI-ассистентов |
| Max / Flash (API) | Закрытые | Условия Qwen Cloud | Только через API |
Для инди-разработчика и небольшой студии в России это хорошая новость. Модель уровня 27B можно запустить у себя, не отправляя данные клиента в облако, и не думать о лицензионных отчислениях.
Какие сильные и слабые стороны у Qwen 3.8?
Главный плюс линейки в выборе: от бесплатного локального 27B до облачного Max. Главный минус в отставании от Fable 5 на сложном коде и простеньком визуале.
Qwen 3.8 закрывает весь диапазон задач одной экосистемой: Max за $2/$6 для сложных агентов, Flash за $0,15/$0,47 для объема, 27B под Apache 2.0 для локального запуска. Ни Anthropic, ни OpenAI такого набора с открытыми весами не дают. Слабость в том, что все бенчмарки пока вендорские.
Сильные стороны
- Цена флагмана. Max дешевле Opus 4.8 в 2,5 раза на входе и в 4 раза на выходе, а по SWE-bench Pro отстает лишь на полтора пункта.
- Открытые веса для всех размеров. От ноутбука до серверной стойки, причем 27B идет под Apache 2.0.
- Агентность и компьютерное зрение. OSWorld-Verified 86,1% и vision-цикл, который ловит баги интерфейса по скриншоту.
- Инициатива в задачах. В тестах модель сама добавляла логичные функции вроде кормления рыб в аквариуме.
Слабые стороны
- Отставание от Fable 5 в кодинге. Минус 12,3 пункта на SWE-bench Pro и минус 15,3 на FrontierSWE.
- Визуал. Текстуры, 3D-окружение и физика часто требуют 2-3 итераций правок.
- Невнимательность к кириллице. Агент может не заметить поломанный русский текст и отчитаться об успехе.
- Вендорские цифры. Независимых замеров по 27B и Flash-Next на момент публикации нет.
Как подключить Qwen 3.8 к Claude Code, Cline или OpenCode?
Qwen 3.8 подключается к любому агенту, который принимает OpenAI-совместимый API. Нужен ключ Alibaba Cloud Model Studio или OpenRouter, а для 27B хватит локального сервера.
Через OpenRouter модель встает в Cline, Kilo Code и OpenCode как обычный провайдер, это 2-3 минуты настройки. Для Claude Code понадобится прокси с совместимым API. Блогеры в тестах использовали именно OpenCode с официальным ключом Alibaba.
Последовательность такая:
- Зарегистрируйтесь в Alibaba Cloud и выберите регион Сингапур в Model Studio, там есть бесплатная квота.
- Создайте API-ключ и пропишите его в агенте как OpenAI-совместимый эндпоинт.
- Укажите модель: qwen3.8-max для сложных задач, qwen3.8-flash для объема.
- Для локального 27B поднимите сервер через vLLM или llama.cpp и укажите адрес localhost. Температуру в тестах ставили 0,6.
Есть нюанс с посредниками. Автор одного из обзоров сначала тестировал Max через сторонний сервис и получил заметно худшие результаты, чем потом через официальный ключ. Если модель ведет себя странно, проверьте, кто реально отвечает на запросы.
Максим: «Ребят, у меня был случай с GoBanana. Веб-версию мы собрали за 3 часа после выхода модели, а суммарно на продукт ушло 6–8 часов. И он принес 12 млн руб. Поэтому на релизы вроде Qwen 3.8 я смотрю просто: не ждать идеальных бенчмарков, а пробовать в первую же неделю.»
Кому подойдет какая версия Qwen 3.8?
Если модель помещается в вашу видеокарту, берите 27B. Для дешевого объема через API подходит Flash, для сложного рассуждения и длинных агентов нужен Max-0902.
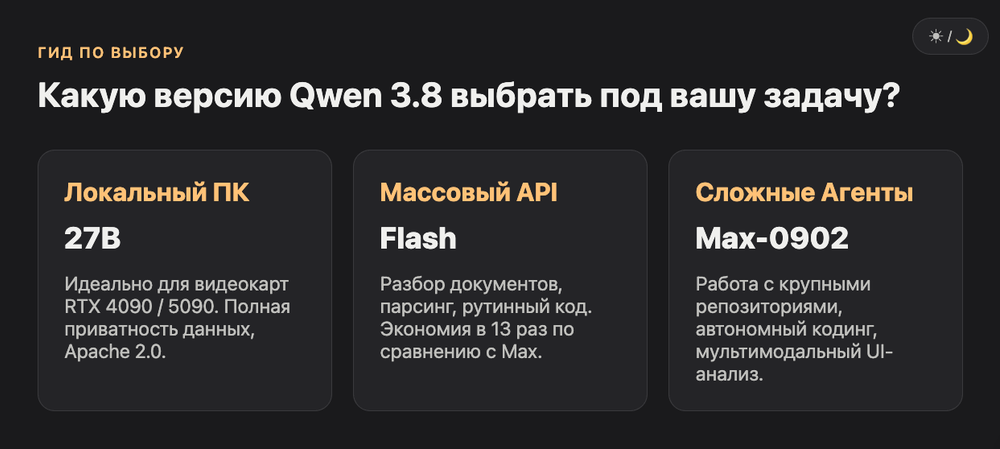
Простое правило выбора внутри линейки такое: 27B для локального запуска, Flash для массовых API-задач, Max для сложного кода и агентов на десятки шагов. Flash-Next и открытый флагман нужны тем, у кого есть серверное железо и требования к хранению данных у себя.
| Ваша задача | Версия | Почему |
|---|---|---|
| Локальный ассистент на RTX 4090/5090 | 27B | Apache 2.0, ~17 ГБ в Q4 |
| Массовый разбор документов и кода | Flash | $0,15/$0,47, контекст 1M |
| Агент по большому репозиторию | Max-0902 | 1M контекста, сильный длинный кодинг |
| Данные не должны покидать сервер | Flash-Next или 2.4T | Открытые веса, своя инфраструктура |
| Максимум качества в коде | Claude Fable 5 | Отрыв на SWE-bench Pro все еще большой |
Мы бы советовали начать с бесплатной квоты Max на реальной задаче вашего проекта. Если результат устраивает, переводите рутину на Flash и экономьте в 13 раз на входных токенах. Сравнить Qwen с другими инструментами можно в каталоге AI-инструментов VibeCoderz, а если вы DevOps и думаете о локальном развертывании, загляните в подборку агентов для DevOps.
Глоссарий
MoE (Mixture of Experts): архитектура, где модель состоит из множества «экспертов», а на каждый токен включаются только несколько из них.
Активные параметры: часть параметров, которая реально работает при генерации одного токена. У флагмана это около 95 млрд из 2,4 трлн.
Открытые веса (open weights): файлы модели, которые можно скачать и запустить на своем железе.
Квантование: сжатие весов модели до 8, 4 или меньше бит, чтобы она поместилась в видеопамять. Платить приходится частью качества.
SWE-bench Pro: бенчмарк, где модель исправляет реальные баги в реальных репозиториях. Сейчас главный тест для кодинга.
OSWorld-Verified: тест на управление компьютером через интерфейс: клики, окна, приложения.
YaRN: метод расширения контекстного окна модели сверх нативного, например с 262K до 1M токенов.
MTP (Multi-Token Prediction): предсказание нескольких токенов за шаг, которое ускоряет генерацию до 1,7 раза.
FAQ
Qwen 3.8 правда опенсорсный?
Частично. Открытые веса выложены для 27B, Flash-Next и 2.4T-флагмана. Но свободная коммерческая лицензия Apache 2.0 есть только у 27B. Облачные Qwen 3.8 Max и Flash остаются закрытыми и доступны только через API.
Можно ли запустить Qwen 3.8 Max у себя дома?
Нет, если речь про полный флагман на 2,4 трлн параметров: ему нужна серверная инфраструктура. Дома реально запустить 27B, в кванте Q4 он занимает около 17 ГБ и идет на RTX 4090 или 5090.
Сколько стоит Qwen 3.8 Max через API?
На октябрь 2026 года $2 за миллион входных токенов и $6 за миллион выходных, кэшированный вход стоит $0,25. В Alibaba Cloud для региона Сингапур есть бесплатная квота около 1 млн токенов на модель.
Что лучше для кода, Qwen 3.8 Max или Claude Opus 4.8?
По заявленным цифрам они близки: 67,7% против 69,2% на SWE-bench Pro. Зато Max дешевле в 2,5-4 раза. Если бюджет ограничен, Qwen выглядит выгоднее, но на сложном рефакторинге Opus и тем более Fable 5 надежнее.
Чем Qwen 3.8 Flash отличается от Flash-Next?
Flash это облачная API-версия с контекстом 1M, веб-поиском и интерпретатором кода. Flash-Next это ее открытая основа на 125 млрд параметров для самостоятельного развертывания, с контекстом 262K и без встроенных инструментов.
Работает ли Qwen 3.8 из России?
Через Alibaba Cloud и OpenRouter доступ зависит от способа оплаты. Локальная версия 27B работает без ограничений, ее веса скачиваются с Hugging Face или ModelScope. Это самый надежный вариант, если важно не зависеть от облака.
Подойдет ли Qwen 3.8 новичку в вайбкодинге?
Да, если подключать его через готовый агент вроде Cline или OpenCode. Модель хорошо собирает рабочий функционал с первого промпта. Будьте готовы к 2-3 итерациям правок по дизайну и проверяйте результат сами.
Что дальше
Qwen 3.8 стал первой линейкой, где открытые веса есть у моделей любого размера, от ноутбука до дата-центра. Если хотите разобраться, какая модель и какой агент подойдут под ваш проект, загляните в обзоры инструментов VibeCoderz или запишитесь на консультацию к Максиму.
Обновлено: октябрь 2026