
FLUX Kontext от Black Forest Labs делает редактирование изображения по тексту точечным: модель меняет ровно тот фрагмент, который вы описали в промпте, а фон, лицо и остальные детали оставляет нетронутыми. В этой статье разберем, как это работает под капотом, чем Kontext отличается от обычной генерации с нуля, сколько стоит доступ в 2026 году и как запустить модель локально через ComfyUI.
FLUX Kontext правит только указанный фрагмент фото по текстовому промпту, сохраняя фон и лицо без изменений. Модель работает через API от $0,04 за изображение или локально в ComfyUI бесплатно. В статье: как это работает, сравнение с Nano Banana Pro, пошаговый запуск и честный разбор слабых мест.
Что такое FLUX Kontext и как он редактирует изображение по тексту?
FLUX Kontext — это модель Black Forest Labs для точечного редактирования: она принимает фото и текстовую инструкцию, а на выходе меняет только описанный элемент.
Модель вышла 29 мая 2025 года и быстро стала стандартом для редактирования изображений по тексту, первой из массовых моделей, которая понимала, что именно нужно оставить нетронутым, а что переписать. К 2026 году у нее три версии: Pro для быстрых правок, Max с усиленной типографикой и консистентностью, Dev, open-weight, ее можно скачать и запустить на своем железе.
Разработчики называют главную фишку character consistency: лицо и фигура персонажа остаются узнаваемыми, даже когда меняется сцена вокруг. Девушка на пляже, потом та же девушка в снегу, черты лица не плывут. Для обычной генерации с нуля это почти невозможно, там каждый запуск дает новое лицо.
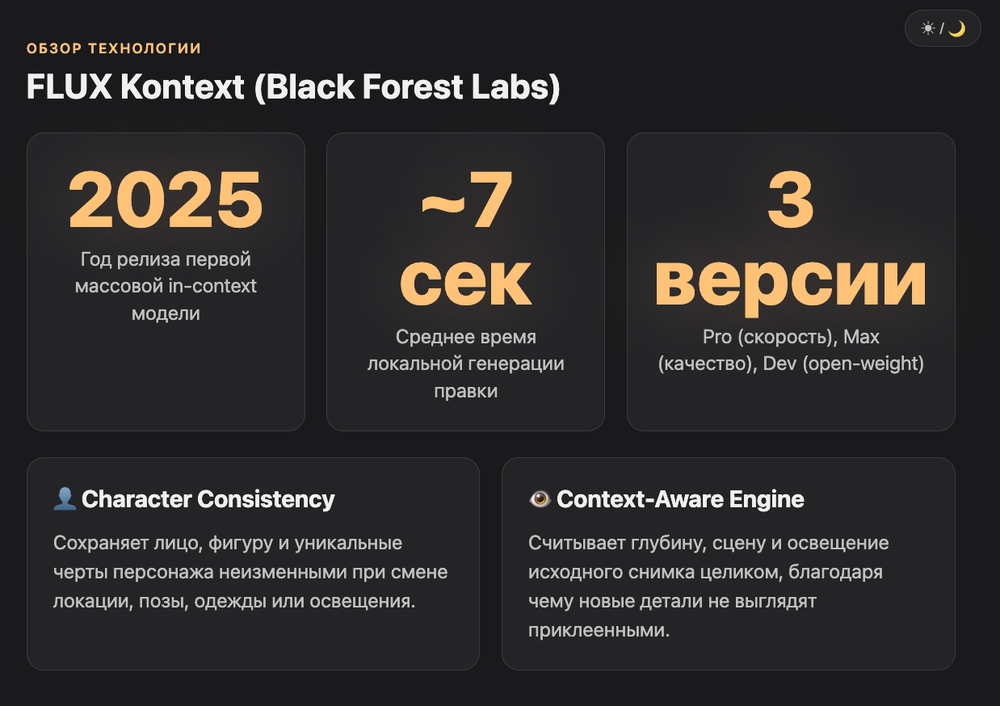
Второй кит модели, понимание контекста изображения целиком, а не отдельных пикселей. Kontext сначала «читает» сцену, потом применяет правку так, чтобы она выглядела органично, а не приклеенной сверху.
Как работает точечное редактирование по тексту в FLUX Kontext?
Модель анализирует изображение и промпт вместе, находит нужную область и меняет только ее, это называется in-context editing, в отличие от обычного инпейнтинга по маске.
Классический инпейнтинг требует нарисовать маску руками: выделить область, а потом просить нейросеть заполнить именно ее. Kontext убирает этот шаг. Вы пишете «убери солнцезащитные очки» или «смени фон на закат» текстом, и модель сама находит границы объекта.
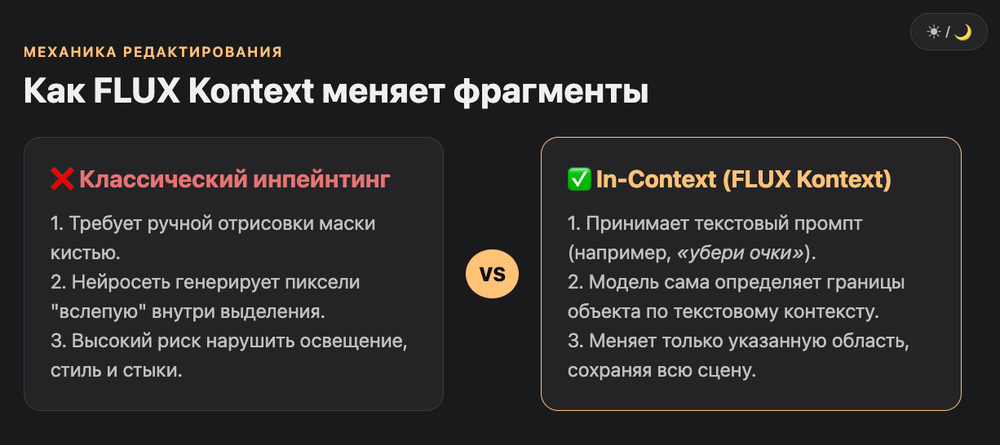
Под капотом это диффузионная модель, дообученная на парах «изображение до, изображение после, текстовая инструкция». Она научилась отличать команды на локальное изменение («поменяй куртку на красную») от команд на изменение всей сцены («перенеси персонажа в музей»).
Отсюда и разница результатов: если промпт точечный, меняется пиксельная область вокруг объекта. Если промпт описывает новую сцену целиком, модель перестраивает окружение, но держит консистентность персонажа. Разработчики каналов на YouTube, которые тестировали модель в ComfyUI, отмечают: результат стабильнее, чем при похожих правках через ChatGPT, где риск «поплывшего» лица заметно выше.
Мультираундовое редактирование и объединение изображений
Kontext поддерживает и последовательные правки: сделали одну генерацию, уточнили промпт, получили следующую версию того же фото, не начиная с нуля. Так можно довести картинку до нужного результата за 3-4 итерации вместо повторной генерации всей сцены заново.
Отдельная функция, объединение нескольких входных изображений в одну сцену. Загружаете фото двух людей и просите «поместите их в одну сцену, они обнимаются», модель компонует персонажей вместе, сохраняя черты лица каждого.
Чем редактирование в FLUX Kontext отличается от обычной генерации с нуля?
Text-to-image создает картинку заново по одному промпту. FLUX Kontext берет готовое фото как основу и переписывает только указанную часть, остальное остается пиксель в пиксель прежним.
Разница ощущается на практике сразу, как только нужно не «нарисовать что-то новое», а поправить существующий кадр.
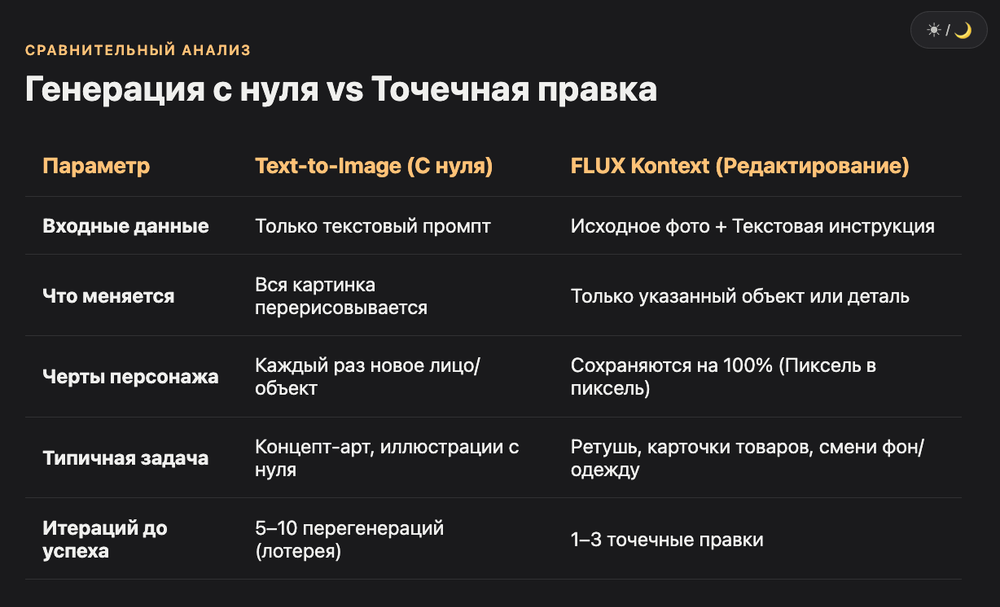
| Параметр | Обычная генерация (text-to-image) | FLUX Kontext (редактирование по тексту) |
|---|---|---|
| Вход | Только текстовый промпт | Фото + текстовая инструкция |
| Что меняется | Вся картинка целиком | Только указанный фрагмент |
| Лицо/объект | Каждый раз новое | Сохраняется между генерациями |
| Типичная задача | Создать иллюстрацию с нуля | Поправить готовое фото товара, персонажа, интерьера |
| Число итераций до результата | Часто 5-10 перегенераций | 1-3 точечные правки |
Практический вывод простой: если у вас уже есть удачный кадр и не устраивает одна деталь, генерация с нуля, это лотерея, придется перебирать варианты, пока случайно не получится похоже. Kontext решает эту же задачу за одну правку, потому что не трогает то, что и так работает.
Что лучше редактирует фото, FLUX Kontext или Nano Banana Pro?
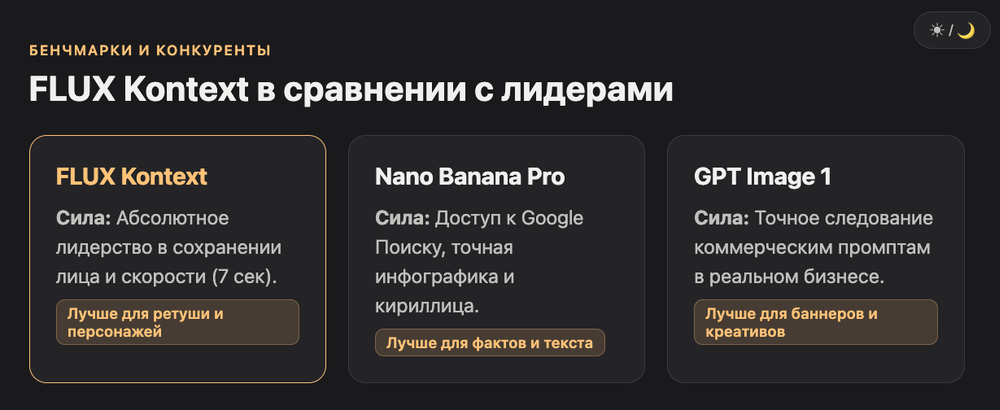
По тестам KontextBench Kontext лидирует в сохранении лица персонажа и работе с текстом на изображении. Nano Banana Pro от Google точнее следует сложным промптам и умеет опираться на веб-поиск для фактов на картинке.
Прямое сравнение зависит от задачи. На независимых бенчмарках Kontext занимает первое место по консистентности персонажа и редактированию текста на изображении, сказывается узкая специализация модели именно под правки, а не генерацию с нуля (Black Forest Labs technical report, разбор Knowara).
Nano Banana Pro в тестах на сложные композиции (например, инфографика с реальными фактами) выигрывает за счет доступа к поиску Google, модель может свериться с реальными данными, а не додумывать детали. На типографике и читаемом мелком тексте Nano Banana Pro тоже стабильнее.
Скорость на стороне Kontext: по тестам сторонних площадок правка генерируется в среднем за 7 секунд, тогда как у некоторых конкурентов счет идет на десятки секунд. Для пайплайна, где нужно прогнать сотни карточек товара, это ощутимая разница в часах работы.
Один из обзорщиков на YouTube, которого мы разбирали для этой статьи, честно признал: несмотря на высокое место Kontext в LM Arena, на реальных бизнес-задачах (баннеры для бургерной, карточки бьюти-бренда) GPT Image 1 в его тестах обошел все три модели. Хайп вокруг новых релизов не всегда совпадает с результатом на конкретной задаче, стоит тестировать на своих кейсах, а не верить только рейтингам.
Сколько стоит FLUX Kontext и можно ли работать без VPN?
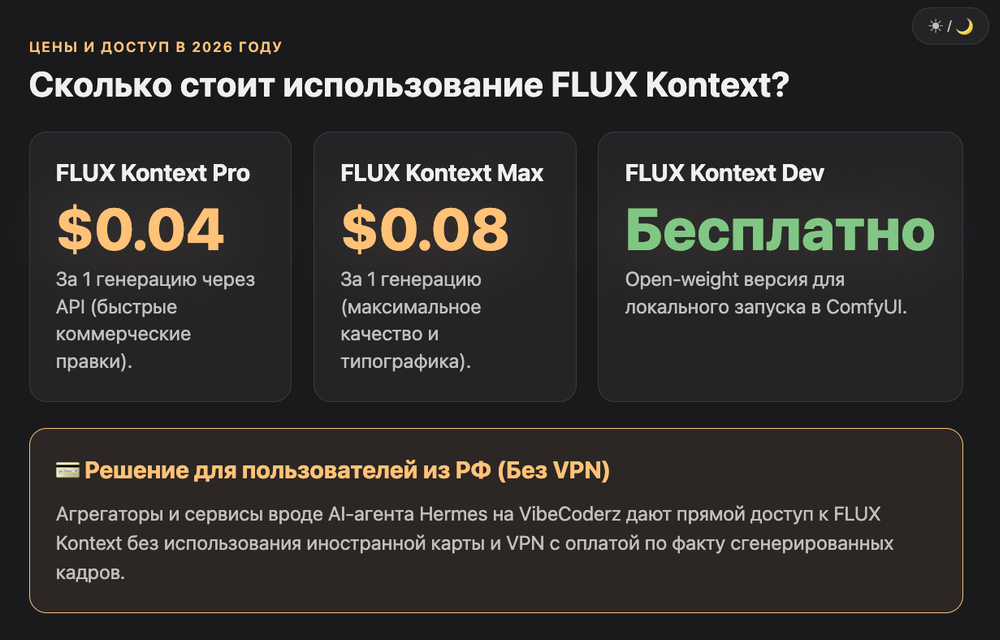
Kontext Pro стоит около $0,04 за изображение, Kontext Max, около $0,08. Dev-версия открытая и бесплатная для локального запуска, коммерческое использование требует лицензии.
Официальный тариф Black Forest Labs держится в районе $0,04 за правку на Pro и $0,08 на Max (bfl.ai/pricing). Сторонние API-провайдеры вроде Together AI или Fal предлагают доступ по похожим ставкам, некоторые реселлеры продают токены дешевле официальной цены, около $0,025-0,05 за изображение.
Dev-версия, open-weight, ее можно скачать бесплатно и запустить на своей видеокарте. Но у нее отдельная лицензия: для некоммерческого использования доступ свободный, для встраивания в коммерческий продукт нужна отдельная лицензия от Black Forest Labs.
Для российской аудитории это особенно важный вопрос, большинство карт не работает с зарубежными сервисами напрямую.
Максим: «Для GoBanana веб-версию мы собрали за 3 часа после выхода модели. Ключевой момент для России, без VPN, без зарубежных карт, платишь ровно столько, сколько сгенерировал. На этом принципе построена вся продуктовая история с генерацией фото через ИИ.»
Практический вариант для тех, кто не хочет разбираться с зарубежными платежами самостоятельно: агрегаторы вроде AI-агента Hermes на портале VibeCoderz дают доступ к FLUX и другим моделям генерации изображений через единый российский счет, без карты другой страны.
Какие задачи реально решает FLUX Kontext на практике?
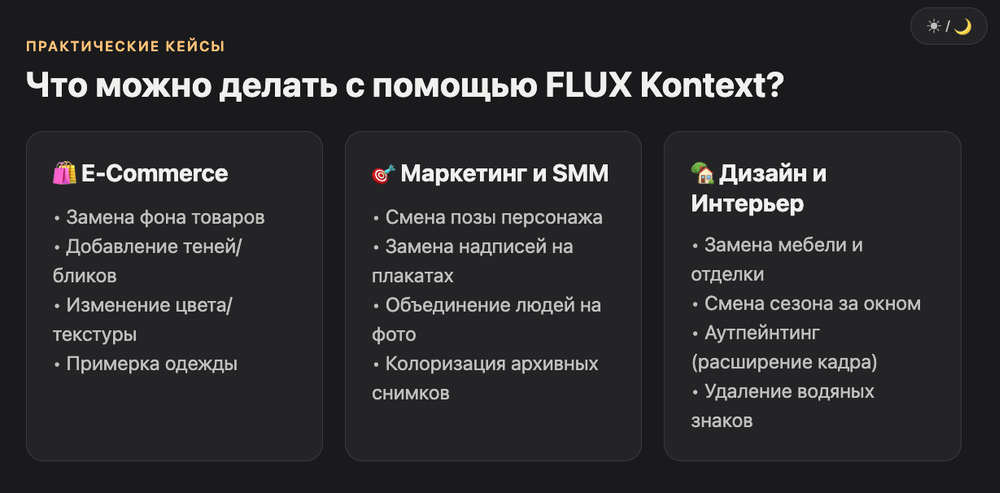
От ретуши лица до восстановления старых фото, авторы каналов про ComfyUI насчитывают около 20 рабочих приемов на базе Kontext, большинство автоматизируется через готовые пресеты.
Список задач куда шире, чем «поменять фон». Разберем по группам.
Для фотографов и e-commerce
Ретушь без Photoshop: убрать дефект кожи, поправить свет, добавить тень под товаром. Предметная съемка карточек, можно снять товар на белом фоне и попросить модель перенести его в готовую сцену: кухню, витрину, руки модели. Изометрия и ракурс тоже можно менять текстом, без пересъемки.
Для маркетинга и соцсетей
Телепортация объекта или персонажа в любую сцену без потери деталей, смена позы с сохранением стиля и освещения, объединение двух персонажей в одном кадре для рекламного визуала. Отдельный прием, колоризация черно-белых архивных фото и восстановление старых снимков, что полезно для юбилейных кампаний и историй бренда.
Для дизайна интерьеров и продукта
Смена дизайна интерьера прямо на фото комнаты, удаление лишней мебели, смена времени года за окном, аутпейнт, расширение кадра за исходные границы, когда нужно достроить сцену слева или справа.
Отдельно стоит upravление текстом на картинке: удаление водяных знаков, замена надписи на баннере, создание постера с новым текстом поверх готового макета, то, с чем обычная генерация справляется заметно хуже.
Как запустить FLUX Kontext локально в ComfyUI?
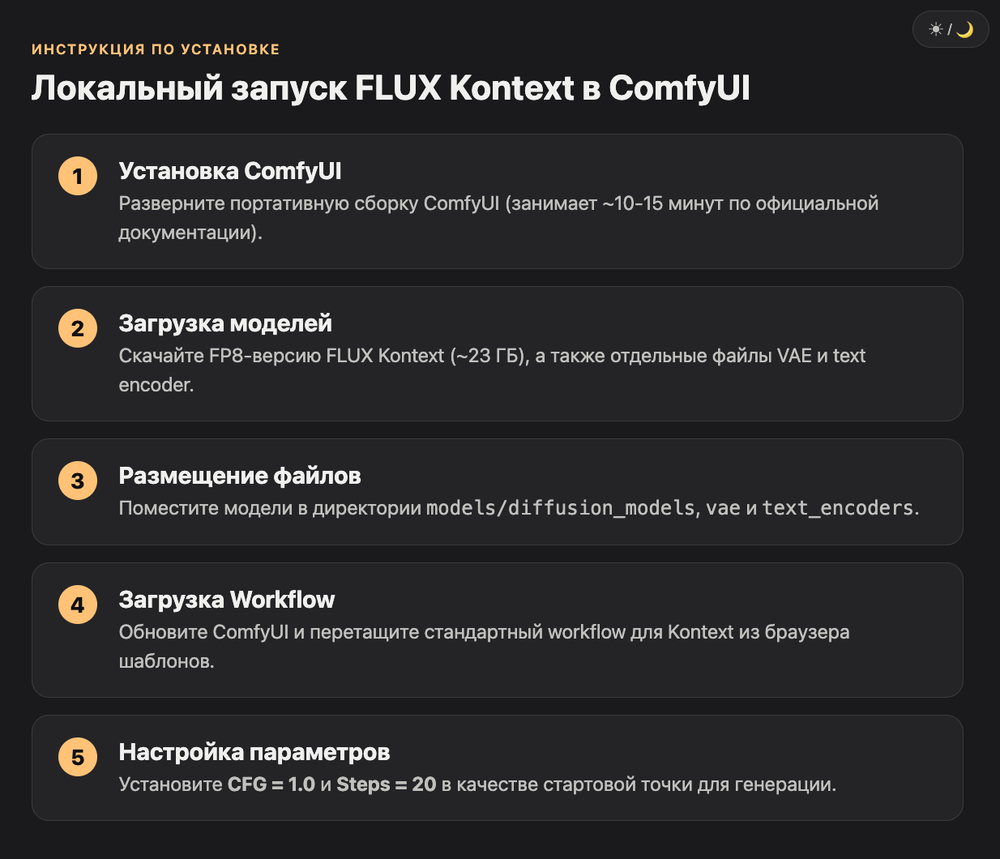
Для локального запуска нужна видеокарта от 8 ГБ VRAM, файлы модели, VAE и text encoder, по инструкции с официальной документации ComfyUI процесс занимает около получаса.
Локальный запуск полезен вайбкодерам, которые хотят встроить генерацию в свой продукт без постоянных расходов на API. Вот минимальный путь.
- Установите ComfyUI. Портативная сборка ставится за 10-15 минут, инструкции есть в официальной документации проекта.
- Скачайте модель. FP8-версия весит около 23 ГБ, есть квантованные варианты для слабых карт. Нужны отдельно VAE и text encoder.
- Разложите файлы по папкам. Diffusion models, VAE и text encoders, в соответствующие директории ComfyUI, точные пути указаны в документации.
- Обновите ComfyUI. После обновления в браузере шаблонов появляются готовые workflow для Kontext, их можно просто перетащить на рабочее пространство.
- Настройте параметры генерации. Разработчики рекомендуют CFG около 1 и 20 шагов как стартовую точку, дальше подбирается под задачу.
На видеокарте с 8 ГБ VRAM одна генерация занимает около 2,5 минут, на 24 ГБ VRAM и 32 ГБ RAM, около минуты. Ускорить процесс можно квантованными Nunchaku-моделями (быстрее почти в 2 раза) и SageAttention 2.2, который добавляет около 30% скорости при наличии Triton.
Для вайбкодеров, которые собирают вокруг генерации целый продукт с API и очередью задач, писать интеграционный слой удобно в Cursor, автодополнение хорошо понимает типовые SDK для работы с очередями изображений.
Какие есть ограничения у FLUX Kontext?
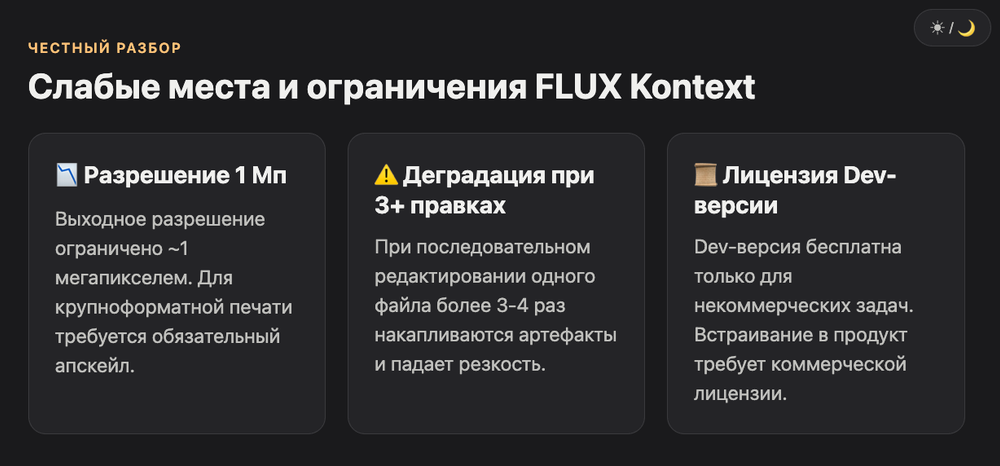
Выходное разрешение ограничено примерно 1 мегапикселем, качество проседает после нескольких последовательных правок, а для коммерческого использования нужна отдельная лицензия.
Честно: Kontext не идеален. Разрешение на выходе заметно ниже, чем у топовых генераторов с нуля, около 1 мегапикселя, для карточки в интернет-магазин достаточно, для крупного баннера уже маловато без апскейла.
Если делать пять-шесть правок подряд одну за другой, качество постепенно деградирует: появляются артефакты, теряется резкость. Практический лайфхак, не больше 2-3 итераций на одном изображении, дальше проще начать с исходника заново.
На слабой видеокарте локальный запуск медленный, а некоторые прикладные тесты показывают, что на реальных бизнес-задачах модель уступает GPT Image 1 и Nano Banana Pro по строгому следованию сложным промптам. Для сценариев, где важна юридическая чистота (инфографика с фактами, тексты с цифрами), лучше свериться руками, а не полагаться на модель полностью.
Кому подходит FLUX Kontext в 2026 году?
Kontext закрывает нишу быстрых точечных правок фото. Для генерации с нуля, сложных композиций с текстом или юридически значимых фактов на картинке лучше подходят другие модели.
| Сегмент | Задача | Что выбрать |
|---|---|---|
| Фотографы, e-commerce | Ретушь, смена фона, карточки товара | FLUX Kontext Pro через API |
| Маркетологи, SMM | Баннеры, замена текста, коллажи персонажей | Kontext Max или Nano Banana Pro для сложной типографики |
| Вайбкодеры, разработчики | Встраивание генерации в свой продукт, экономия на масштабе | Kontext Dev локально через ComfyUI |
| Дизайнеры интерьеров | Смена стиля комнаты на фото без пересъемки | FLUX Kontext Pro |
Если задача, не редактировать существующее фото, а создать иллюстрацию с нуля по подробному текстовому описанию с точным текстом внутри, присмотритесь к Nano Banana Pro или GPT Image 1.5, там точность следования промпту исторически выше.
Какие термины нужно знать про редактирование изображений нейросетью?
In-context editing — редактирование, при котором модель понимает контекст всего изображения и меняет только описанную часть, без ручной маски.
Инпейнтинг — классический способ локального редактирования: сначала выделяется область маской, потом нейросеть заполняет именно ее.
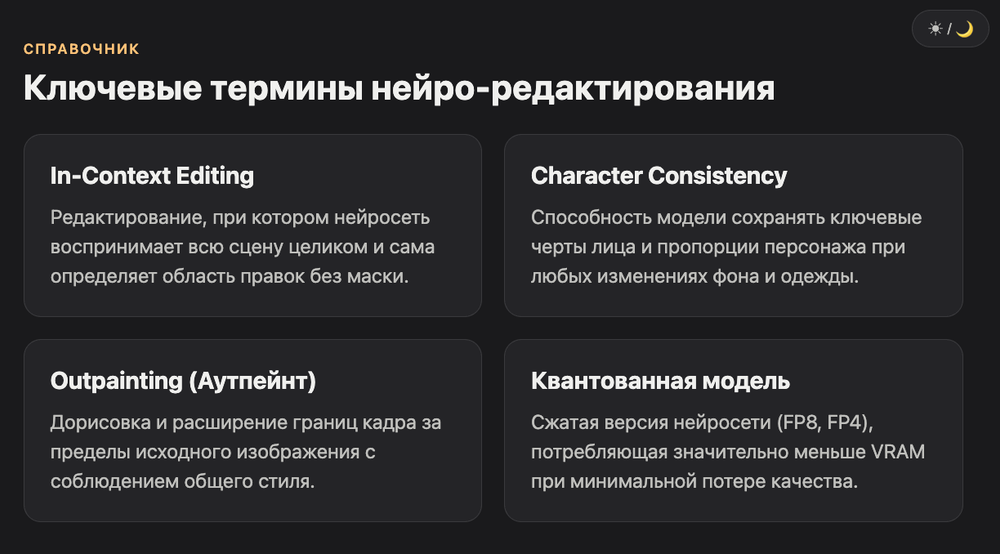
Аутпейнтинг (outpaint) — расширение кадра за исходные границы фото, достройка сцены по краям.
Character consistency — способность модели сохранять черты персонажа или объекта неизменными при смене сцены вокруг.
Квантованная модель — сжатая версия весов нейросети (FP8, FP4, Int4), которая занимает меньше видеопамяти и работает быстрее ценой небольшой потери качества.
LoRA — небольшой дообученный модуль поверх базовой модели, который добавляет узкий навык: конкретный стиль, позу или эффект.
Частые вопросы про FLUX Kontext
Можно ли редактировать фото через FLUX Kontext бесплатно? Да, если запускать Dev-версию локально на своей видеокарте, это бесплатно для некоммерческого использования. Через облачное API оплата идет за каждое изображение, обычно от $0,025 до $0,08.
Чем FLUX Kontext отличается от инпейнтинга в Photoshop? В Photoshop нужно вручную выделять область и подбирать инструменты. Kontext находит нужный фрагмент сам по текстовому описанию и сразу генерирует правку без ручного выделения.
Работает ли FLUX Kontext с русским текстом на изображении? Базовая версия Kontext лучше справляется с латиницей. Для кириллического текста на картинке точнее показывают себя более новые модели семейства FLUX.2 и Nano Banana Pro.
Сколько раз можно редактировать одно и то же фото подряд? Технически без ограничений, но на практике качество заметно падает после 3-4 последовательных правок. Лучше делать не больше двух-трех итераций, а потом начинать с исходного файла.
Нужна ли лицензия для коммерческого использования FLUX Kontext? Да, для встраивания модели в коммерческий продукт официально нужна отдельная лицензия Black Forest Labs. Работа через платное API уже покрывает коммерческое использование в рамках тарифа.
Можно ли объединить двух разных людей на одном фото через Kontext? Да, эта функция называется multi-input editing, вы загружаете несколько фото, и модель компонует персонажей в одной сцене, сохраняя черты лица каждого.
Подойдет ли FLUX Kontext для продакшена в интернет-магазине? Для карточек товара и предметной съемки, да, это один из основных сценариев использования модели. Для баннеров с точным крупным текстом лучше проверить результат вручную перед публикацией.
Если хотите разобраться, какая модель редактирования подойдет под конкретный продукт, загляните в каталог AI-инструментов VibeCoderz или запишитесь на консультацию к Максиму, разберем ваш кейс и стек под задачу.
Обновлено: сентябрь 2026.