Стратегия sol fable 5 вместе строится на одном принципе: Fable 5 проектирует решение, а GPT-5.6 Sol его реализует и проверяет. По расчетам на реальных фичах связка обходится примерно в $0.06 за фичу против $0.15, если отдать всю работу одному Fable 5. Разберем, как настроить роутинг между моделями, какие задачи куда отправлять и сколько это реально экономит.
Коротко: лучшие AI-команды в 2026 году не выбирают между Sol и Fable 5, а комбинируют их: Fable 5 держит архитектурные решения, Sol берет на себя терминал, тесты и объем. Экономия при таком роутинге доходит до 50-60% против сценария "все на Fable 5". В статье: матрица роутинга, расчет на кейсе и готовый промпт-роутер.
Зачем вообще комбинировать модели, а не выбрать одну?
Потому что Sol и Fable 5 сильны в разных вещах: Sol дешевле и лучше держит терминал и объем задач, Fable 5 точнее на реальных архитектурных багах. Комбинация закрывает слабые места каждой модели по отдельности.
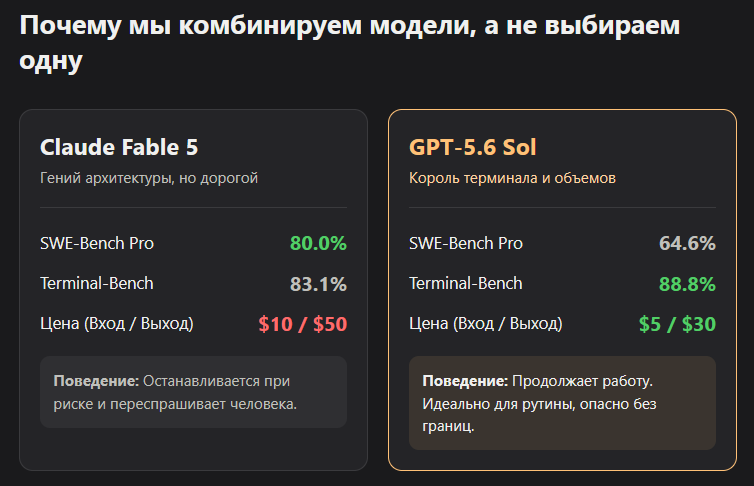
Fable 5 обходит Sol на SWE-Bench Pro (реальные баги из GitHub) с разрывом в 15,4 пункта: 80% против 64,6%. Зато Sol выигрывает Terminal-Bench 2.1 (88,8% против 83,1%) и стоит примерно в два раза дешевле по входным и выходным токенам. Разница в подходе к риску тоже играет роль: Fable 5 останавливается и переспрашивает, Sol продолжает работу даже там, где стоило бы уточнить.
На практике это значит: одна модель хороша там, где вторая слабее. Отдать все задачи одной модели, будь то ради простоты или из принципа "мы на Anthropic" или "мы на OpenAI", означает переплачивать либо терять качество. Роутинг закрывает оба риска сразу.
Мы в VibeCoderz сами прошли этот путь на десятках задач по порталу и ботам. И вот что заметили: экономия не в том, что Sol "хуже, но дешевле". Она в том, что 70-80% рабочих задач вообще не требуют уровня Fable 5, а Sol с ними справляется быстрее и дешевле.
Чем принципиально отличаются Sol и Fable 5?
Sol дешевле, быстрее в терминале и лучше держит браузинг и computer use. Fable 5 точнее на архитектуре и недоопределенных задачах, но стоит в два раза дороже за токен.
По данным OpenAI, GPT-5.6 Sol стоит $5 за 1M входных токенов и $30 за выходные, а Claude Fable 5 (по данным Anthropic) стоит $10 и $50 соответственно. При этом Sol лидирует в Coding Agent Index от Artificial Analysis (80 против 77,2 у Fable 5), а Fable 5 сохраняет преимущество на задачах с реальным продакшен-кодом.
| Параметр | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|
| Цена вход/выход (за 1M токенов) | $5 / $30 | $10 / $50 |
| Контекст | 1,05M | 1M |
| Terminal-Bench 2.1 | 88,8% | 83,1% |
| SWE-Bench Pro | 64,6% | 80% |
| Agents' Last Exam | 52,7% | 40,5% |
| Поведение при риске | продолжает работу | останавливается, уточняет |
| Реальный кейс (кафе-приложение) | $7 | $62 |
Разница в поведении при риске важна не меньше цифр в таблице. Sol доведет задачу до конца, даже если по пути стоило бы остановиться и спросить. Для терминальных операций и объемных прогонов это плюс. Для архитектурных решений, где цена ошибки высокая, это минус: тут выгоднее модель, которая тормозит и уточняет.
Как построить роутинг-матрицу: какую задачу к какой модели?
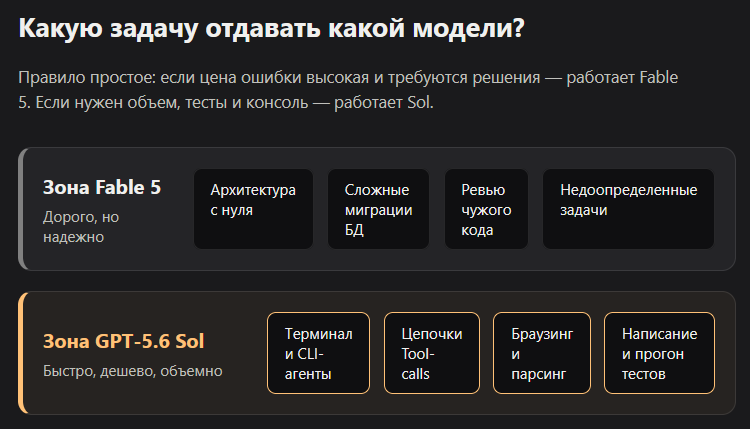
Fable 5 берет архитектуру, миграции и недоопределенные задачи. Sol забирает терминал, объем tool-calls, браузинг и параллельных агентов. Правило простое: цена ошибки высокая, дороговизна оправдана, значит Fable 5.
Матрица роутинга не про "лучше/хуже", а про то, где каждая модель окупает свою цену.
| Тип задачи | Модель | Почему |
|---|---|---|
| Архитектурные решения, миграции | Fable 5 | точнее на реальных GitHub-багах, +15,4 к SWE-Bench Pro |
| Недоопределенные задачи, открытая постановка | Fable 5 | лучше держит риск, переспрашивает вместо угадывания |
| Терминальные операции, CLI-агенты | Sol | +5,7 к Terminal-Bench, дешевле за токен |
| Много tool-calls подряд | Sol | ниже цена за задачу при сравнимом качестве |
| Браузинг и computer use | Sol | +6,1 к BrowseComp, +7,8 к OSWorld 2.0 |
| Параллельные агенты (Ultra) | Sol | режим Ultra создан именно под эту нагрузку |
| Верификация кода после Fable 5 | Sol | дешевый способ перепроверить дорогой вывод |
Ключевой инсайт для бюджета: раз Sol дешевле, его можно ставить верификатором на выходе Fable 5. Модель спроектировала архитектуру, вторая, более дешевая модель прогнала тесты и проверила швы. Это не понижает качество решения, а просто убирает переплату за проверку, которая не требует уровня Fable 5.
Сколько реально можно сэкономить: расчет на кейсе
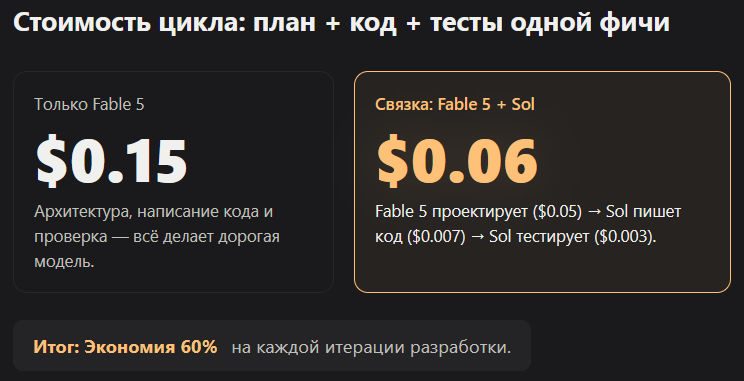
На фиче "спроектировать + реализовать + проверить" связка Fable 5 + Sol стоит около $0.06. Тот же объем работы целиком на Fable 5 обходится в $0.15. Экономия 60%.
Возьмем команду из трех человек, которая ведет продукт итерациями. Раскладка по ролям в такой связке выглядит так:
- Fable 5 проектирует архитектуру фичи и оформляет PRD: около $0,05 за документ.
- Sol реализует код по плану: около $0,007 за файл.
- Sol же проверяет результат тестами: около $0,003 за прогон.
Итого на фичу уходит примерно $0,06. Если бы всю цепочку, от проектирования до проверки, вела одна Fable 5, расход вырос бы до $0,15 за фичу. Разница в 60% не разовая: она масштабируется на каждую следующую фичу и каждый следующий спринт.
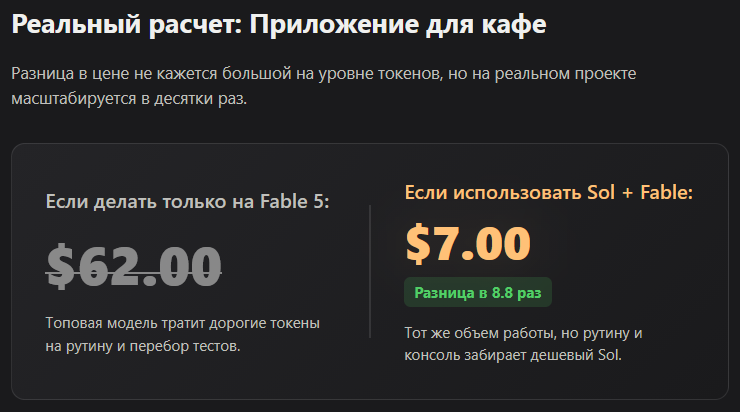
На больших объемах разница еще заметнее. Независимый разработчик собрал приложение для кафе на Sol за $7. Та же задача на одном Fable 5 обошлась в $62. Восьмикратная разница на конкретном, не самом сложном проекте.
Максим: «Мы GoBanana собрали за 6-8 часов суммарно, веб-версию, за 3 часа после выхода модели. Продукт принес 12 миллионов рублей. Если бы каждую мелкую правку гоняли через самую дорогую модель, времени и бюджета ушло бы в разы больше. Роутинг задач по стоимости, это не экономия ради экономии, это способ успевать быстрее».
Как выглядит рабочий процесс на практике?
Рабочий цикл строится в три шага: Fable 5 создает план, Sol реализует его в агентском режиме, Fable 5 же ревьюит результат и возвращает на доработку максимум два раза.
Процесс, который используют опытные команды, разбивается на четыре стадии.
- Интервью. Fable 5 задает уточняющие вопросы по задаче, прежде чем предлагать план. Это отсекает ситуации, где модель придумывает требования, которых не было.
- Планирование. Fable 5 формирует пошаговый план и критерии готовности. План, а не код, потому что архитектурные решения, это именно то, где Fable 5 сильнее.
- Реализация. План передается Sol (например, через Codex) в агентском режиме. Sol пишет код, запускает тесты, итерирует самостоятельно в рамках заданных границ.
- Ревью. Fable 5 проверяет результат Sol. Если находит проблемы, дает Sol до двух итераций на исправление. Если и это не помогает, дорабатывает сама.
Важная деталь: без явных границ Sol будет продолжать работу даже там, где стоило бы остановиться. Поэтому в системный промпт стоит закладывать четкое разделение: что делать без спроса, а что требует подтверждения.
Для запросов "объясни/проанализируй/проверь": инспектируй и докладывай.
Не вноси изменения, если явно не попросили.

Для запросов "сделай/почини/построй": делай изменения в рамках задачи
и запускай неразрушающие тесты без дополнительного спроса.

Подтверждение обязательно для: внешних записей, удаления файлов,
покупок, расширения объема задачи за пределы исходного описания.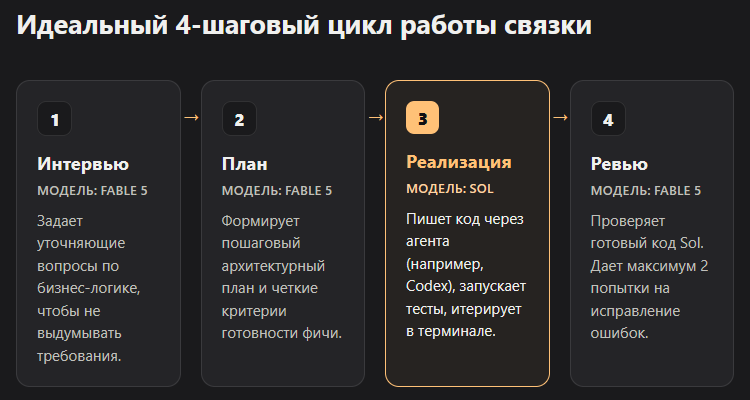
Какой промпт использовать для роутера моделей?
Роутер, это отдельный промпт, который принимает описание задачи и выдает рекомендацию: какую модель использовать и сколько это будет стоить на объеме.
Если задач много и разбирать их вручную неудобно, роутинг можно делегировать самой модели. Вот шаблон, который подходит и для Claude Code, и для Codex.
Я получил задачу: [описание].

Какую модель использовать: GPT-5.6 Sol, GPT-5.6 Terra или Claude Fable 5?

Критерии:
- сложность задачи (1-5)
- обратимость ошибки (высокая/низкая цена промаха)
- нужны ли параллельные агенты
- есть ли зависимость от MCP-инструментов

Дай рекомендацию с расчетом стоимости на 1000 подобных задач.
Такой промпт полезен не только на старте проекта. Раз в 2-3 недели стоит прогонять через него типовые задачи заново: цены и бенчмарки меняются, и модель, которая вчера была оптимальным выбором, сегодня может уже не быть таковой.
Sol или Terra: когда экономии мало?
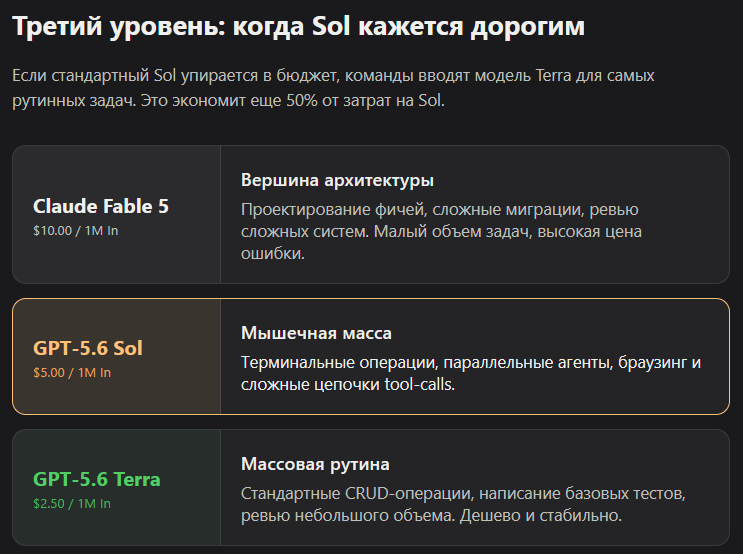
Если и Sol кажется дорогим для рутинных задач, промежуточным звеном становится GPT-5.6 Terra: она стоит примерно вдвое дешевле Sol и почти не уступает ему на стандартных фичах.
Для команд, где даже связка Sol + Fable 5 упирается в бюджет, есть третий уровень. Terra держит качество, близкое к GPT-5.5, но стоит $2,50 за 1M входных токенов против $5 у Sol. На стандартных CRUD-фичах, коде-ревью среднего объема и написании тестов разница в качестве почти не заметна, а расход токенов падает вдвое.
Полноценный Sol в этой схеме остается для терминальных операций, браузинга и параллельных агентов, там, где Terra объективно слабее.
Сильные и слабые стороны связки Sol + Fable 5
Сильные стороны:
- Экономия 50-60% на типовом цикле "спроектировать, реализовать, проверить" по сравнению с работой одной дорогой моделью.
- Меньше риска архитектурных ошибок: за критичные решения отвечает модель, которая переспрашивает, а не додумывает.
- Sol быстрее закрывает терминальные и объемные задачи, что ускоряет весь цикл разработки.
Слабые стороны:
- Настройка роутинга требует времени на старте: нужно прописать границы для Sol и критерии передачи задач.
- Два инструмента вместо одного усложняют онбординг новых людей в команде.
- Sol продолжает работу даже при риске, если границы прописаны небрежно, это может привести к нежелательным изменениям в коде.
- Ценообразование и бенчмарки у обеих моделей меняются быстро, матрицу роутинга нужно пересматривать регулярно.
Частые вопросы про стратегию Sol и Fable 5
Что такое роутинг между Sol и Fable 5 простыми словами?
Это правило, по которому команда решает, какой модели отдать задачу. Дорогие и рискованные решения, архитектуру, миграции, отдают Fable 5. Объемные и терминальные задачи, Sol. Экономия получается за счет того, что не каждая задача требует самой дорогой модели.
Нужны ли отдельные подписки на обе модели?
Да, если работать через API или разные приложения. Sol доступен через ChatGPT Plus и API, Fable 5, через Claude и API Anthropic. Часть команд подключает обе модели через агентские инструменты вроде Claude Code и Codex одновременно.
Можно ли обойтись без Fable 5 и работать только на Sol?
Можно, но на архитектурных задачах и реальных продакшен-багах Fable 5 показывает заметно лучший результат: разрыв в 15,4 пункта на SWE-Bench Pro. Для таких задач экономия на модели может выйти дороже в виде переделок.
Сколько времени уходит на настройку роутинга?
На старте: несколько часов, чтобы прописать границы для Sol и критерии передачи задач Fable 5. Дальше это шаблон, который переиспользуется на новых фичах без доработки.
Какие задачи нельзя доверять Sol без присмотра?
Все, что связано с внешними записями, удалением данных, изменением конфигов окружения и расширением объема задачи за исходные рамки. Sol продолжает работу даже при риске, поэтому такие шаги нужно явно выносить в блок "требует подтверждения".
Заменит ли Terra связку Sol + Fable 5?
Частично. Terra хорошо закрывает рутинные задачи вместо Sol и экономит еще примерно половину бюджета на них. Но для архитектурных решений с высокой ценой ошибки Fable 5 пока остается более надежным выбором.
Как проверить, что роутинг реально экономит деньги?
Сравнить расход токенов и итоговую стоимость на одинаковом объеме задач до и после внедрения роутинга. На кейсе с фичами разница дошла до 60%, но точная цифра зависит от структуры задач конкретной команды.
Что дальше
Начать проще всего с одной фичи: прогнать ее через промпт-роутер, отдать план Fable 5, реализацию Sol, а дальше сравнить расход токенов с тем, что было бы при работе на одной модели. Разница обычно видна уже на первом цикле.
Каталог AI IDE и инструментов для вайб-кодинга, включая Claude Code и Cursor, собран в каталоге AI-инструментов VibeCoderz. Если нужна помощь с настройкой роутинга под конкретный проект, запишитесь на консультацию к Максиму.
Источники: OpenAI, анонс GPT-5.6, OpenAI, превью Sol, Terra и Luna, независимый бенчмарк-разбор CodeRabbit.
Обновлено: октябрь 2026.