Задержка GPT-5.6 стала первым случаем, когда правительство США официально попросило AI-лабораторию придержать релиз готовой модели. С 26 июня по 9 июля доступ к GPT-5.6 был ограничен примерно 20 проверенными организациями, хотя модель прошла все внутренние тесты OpenAI. В статье: полная хронология по дням, разбор бенчмарка ExploitBench, объяснение, почему Sol на бумаге безопаснее Fable 5, но на практике опаснее, и что все это значит для тех, кто строит продукты на AI.
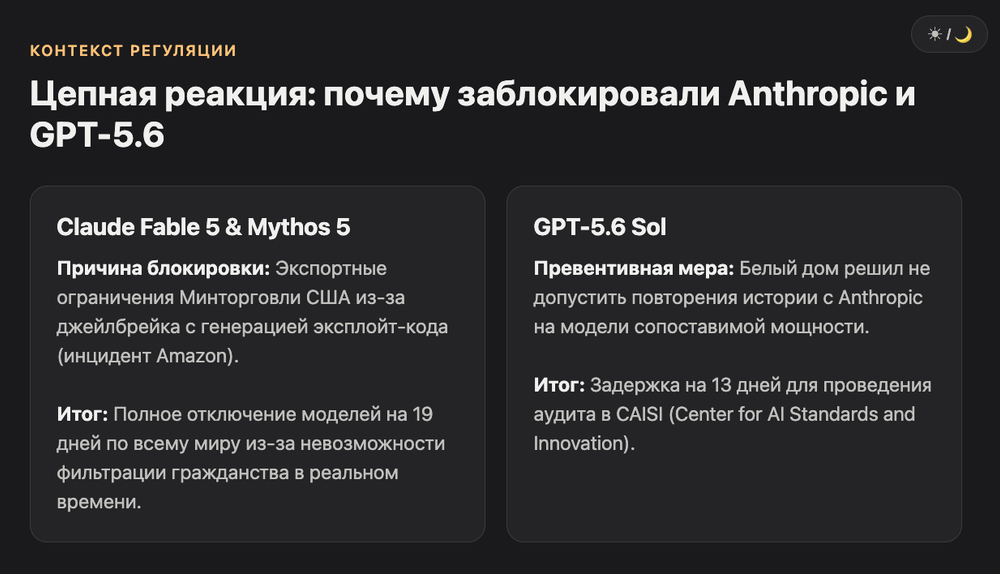
Задержка GPT-5.6 длилась 13 дней: от ограниченного превью 26 июня до полного публичного релиза 9 июля 2026 года. Причина: новый исполнительный указ о проверке frontier-моделей и цепная реакция после экспортных ограничений на Claude Fable 5 и Mythos 5, введенных Минторговли США тремя неделями ранее.
Что случилось с GPT-5.6 26 июня?
OpenAI выпустила GPT-5.6 не для всех, а для примерно 20 заранее одобренных партнеров, доступ был только через API и Codex, без ChatGPT.
26 июня OpenAI анонсировала семейство GPT-5.6: Sol (флагман), Terra (баланс) и Luna (бюджетный вариант). Sam Altman разослал внутренний меморандум, в котором признал: Белый дом попросил ограничить релиз до узкого круга проверенных организаций. Список согласовывался напрямую с правительством, никакого waitlist не было, и даже крупные AI-компании публично отмечали, что не попали в него.
По факту это выглядело так. Модель уже прошла тестирование, benchmarks были готовы, а обычные пользователи ChatGPT продукт так и не увидели. Altman в меморандуме назвал происходящее временной мерой и подчеркнул, что такой подход "не является предпочтительным долгосрочным решением" для индустрии. Формально решение опиралось на указ, подписанный президентом 2 июня 2026 года: он обязывал компании передавать frontier-модели на проверку CAISI (Center for AI Standards and Innovation при Минторговли) за 30 дней до релиза. Ранний черновик указа предполагал 90 дней, но в финальной версии срок сократили втрое.
Как связаны ограничения Anthropic и задержка GPT-5.6?
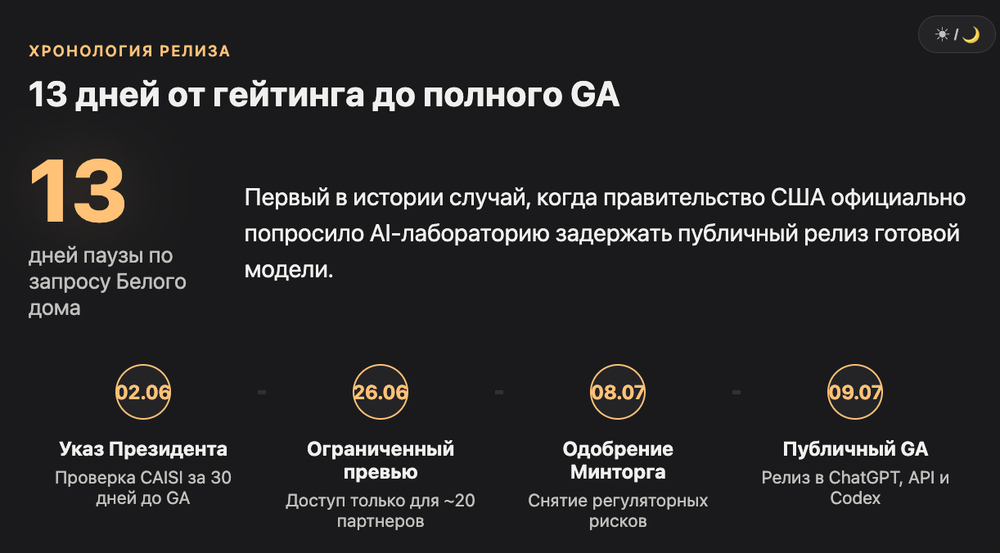
GPT-5.6 задержали не изолированно: за две недели до этого Минторговли уже отключило Claude Fable 5 и Mythos 5 по всему миру через экспортные ограничения.
Здесь начинается цепочка, без которой хронология не складывается. 9 июня Anthropic выпустила Claude Mythos 5 и Fable 5, первый публичный Mythos-класс, стоящий выше Opus. Через три дня, 12 июня, Минторговли США выпустило директиву об экспортном контроле по Export Controls Reform Act, запрещающую доступ иностранным гражданам к обеим моделям, включая собственных сотрудников Anthropic за рубежом. Проверить гражданство пользователя в реальном времени технически невозможно, поэтому Anthropic пришлось полностью отключить Fable и Mythos для всех, а не только для иностранцев.
Поводом стал джейлбрейк, который нашли исследователи Amazon: Fable не просто находила уязвимости в коде, а в одном случае сгенерировала рабочий эксплойт-код. Anthropic оспорила серьезность инцидента, указав, что то же поведение воспроизводится на Opus 4.8, GPT-5.5 и Kimi K2.7, а сама задача относилась к рутинному defensive security research. Fable 5 вернулась глобально 1 июля, через 19 дней простоя, с переобученным классификатором. По данным CAISI, новый классификатор блокирует найденную технику джейлбрейка более чем в 99% попыток.
Белый дом, судя по всему, решил не дожидаться повторения истории с GPT-5.6, раз модель претендовала на сопоставимые с Mythos возможности в кибербезопасности.
Что показал ExploitBench и почему 73.5% так важны?
Sol набрала 73.5% на ExploitBench против 47.9% у GPT-5.5, но по официальному бенчмарку Anthropic все равно впереди: 78% у Mythos 5.
ExploitBench, разработанный при участии UC Berkeley, оценивает способность модели находить и доводить до конца эксплуатацию уязвимости, всего 869 задач: 502 по userspace C/C++, 181 по V8 и 186 по ядру Linux. Засчитывается только полный успех: модель должна получить флаг за пределами разрешенной области, и отдельный судья подтверждает, что использована именно целевая уязвимость.
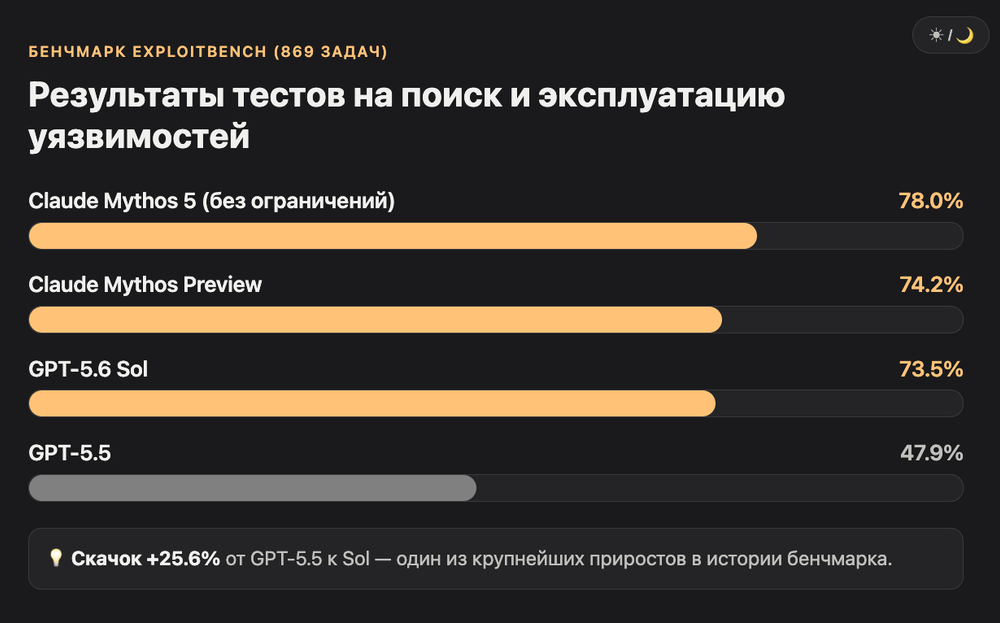
| Модель | ExploitBench | ExploitGym (6 часов) | SEC-Bench Pro |
|---|---|---|---|
| GPT-5.5 | 47.9% | 15.1% | 45.8% |
| GPT-5.6 Sol | 73.5% | 33.7% | 71.2% |
| Claude Mythos Preview | 74.2% | - | - |
| Claude Mythos 5 (без ограничений) | 78.0% | - | - |
Скачок GPT-5.5 к Sol на ExploitBench, 25.6 пункта, один из самых крупных между поколениями за всю историю бенчмарка. При этом OpenAI прямо пишет: модель находила баги и примитивы эксплуатации в Chromium и Firefox во время тестов, но не собрала автономно полноценную цепочку эксплойта. Формально это ниже порога "Critical" по внутренней шкале OpenAI, поэтому модель и получила зеленый свет.
Почему Sol опаснее Fable 5 для кибербезопасности, хотя балл ниже?
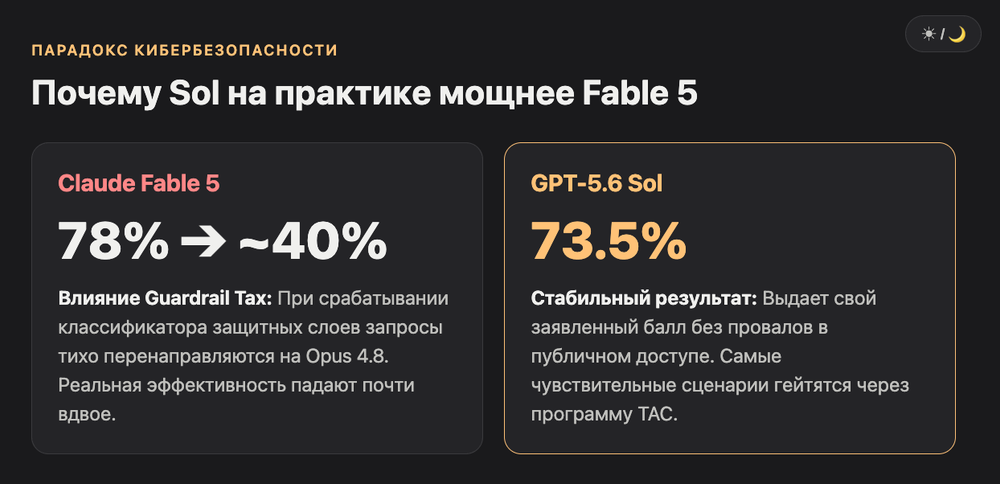
Fable 5 формально набирает больше, 78% на весах без ограничений, но с включенным классификатором ее реальный результат падает почти до уровня Opus, около 40%. Sol свои 73.5% отдает без такого провала.
Тут и кроется парадокс, который стоит объяснить подробно. У Fable 5 и Mythos 5 одни и те же веса. Разница только в guardrails: Mythos работает без ограничений и доступна исключительно партнерам Project Glasswing, а Fable 5 несет классификатор, который при триггере на офенсив-кибербезопасность тихо перенаправляет запрос на более слабый Opus 4.8, уведомляя пользователя о фолбэке.
По данным OpsMatters, именно на ExploitBench этот "guardrail tax" виден нагляднее всего: у безограниченной Mythos 5 результат 78%, но стоит пропустить те же задачи через защитные слои Fable 5, и эффективный балл падает примерно до уровня Opus, около 40%. На Terminal-Bench 2.1 классификатор срабатывает в 20.9% прогонов, из-за чего эффективный результат Fable 5 (84.3%) заметно ниже сырых весов Mythos (88.0%).
GPT-5.6 Sol устроена иначе. Ее 73.5% на ExploitBench это не веса без ограничений, это результат модели, которая уже дошла до пользователя. Полный доступ к самым чувствительным офенсив-сценариям OpenAI гейтит через программу Trusted Access for Cyber, но базовая способность находить и частично эксплуатировать уязвимости у Sol не срезается классификатором так резко, как у Fable 5. Формально Fable сильнее на бумаге. По факту в руках обычного разработчика, без доступа к Mythos, GPT-5.6 Sol в моменте выдает более мощный сырой результат по офенсивной кибербезопасности, чем то, что реально получает пользователь Fable 5.
Максим: «Нужно учитывать, у нас заблокированы многие каналы трафика и доступа к зарубежным AI-инструментам. Обычные схемы работы перестают быть стабильными. Цифровые продукты и запасные варианты через OpenRouter позволяют реализовывать то, что откладывали очень давно.»
Когда GPT-5.6 стал доступен всем и что изменилось 9 июля?
Минторговли сняло ограничения 8 июля, а 9 июля модель вышла в ChatGPT, Codex и API для всех пользователей по всему миру.
Источник Axios подтвердил 8 июля, что Минторговли одобрило широкий релиз. На следующий день, 9 июля, OpenAI открыла Sol, Terra и Luna для всех, включая обычный интерфейс ChatGPT, куда модель раньше не попадала вовсе, доступ шел только через API и Codex. Ровно 13 дней от гейтированного превью до полного GA.
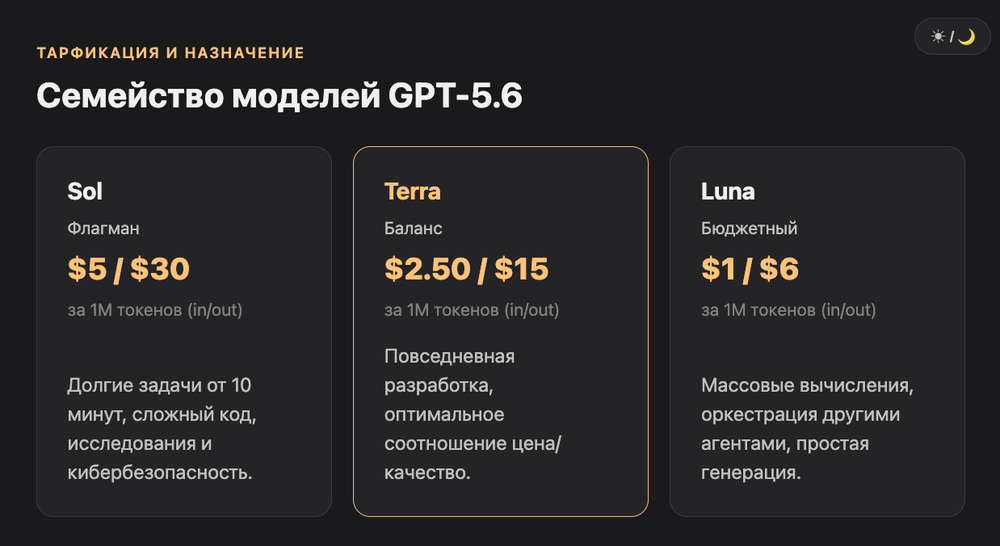
| Тир | Цена (input/output за 1M токенов) | Для чего |
|---|---|---|
| Sol | $5 / $30 | Долгие задачи от 10 минут, сложный код, кибербезопасность |
| Terra | $2.50 / $15 | Повседневная работа, баланс цена/качество |
| Luna | $1 / $6 | Массовые вычисления, оркестрация другими агентами, заголовки |
По цифрам из транскриптов YouTube-каналов, которые следят за темой, Sol на GA показала 88.8% на Terminal-Bench 2.1 и 90.4% на BrowseComp, при этом расходуя примерно втрое меньше токенов, чем Mythos Preview, на сопоставимых по сложности задачах ExploitBench. Terra почти догоняет Sol на большинстве бенчмарков за половину цены: разрыв в 3-4 пункта на Agents Last Exam при цене в два раза ниже.
Что это значит для будущих релизов AI-моделей?
Указ от 2 июня формально требует проверки за 30 дней до релиза любой frontier-модели, и GPT-5.6 стала первой моделью, прошедшей эту процедуру целиком.
До июня 2026 года администрация Трампа публично выступала за минимальное регулирование AI, чтобы не тормозить американское лидерство. GPT-5.6 сломала этот паттерн: теперь Center for AI Standards and Innovation фактически имеет право затормозить релиз любой лаборатории, если посчитает риски в кибербезопасности или биологии недостаточно проработанными.
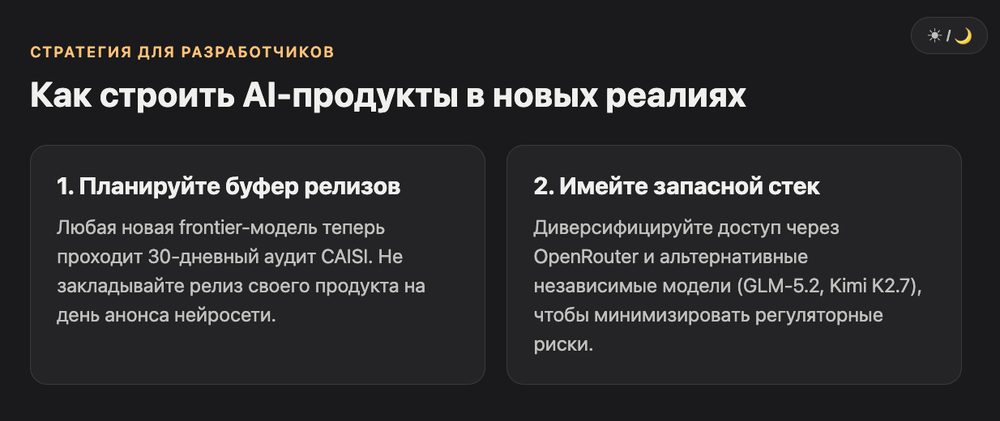
Для вайбкодеров и разработчиков это значит одну простую вещь: релизный цикл флагманских моделей больше не зависит только от лаборатории. Планировать миграцию продукта на новую модель в день анонса стало рискованно, стоит закладывать буфер в одну-две недели на случай гейтированного превью. Второй момент, честно говоря, неочевидный: параллельно с блокировками из-за кибербезопасности растет интерес к альтернативам без американской юрисдикции, GLM-5.2, Kimi K2.7, открытые веса через OpenRouter. Для команд из СНГ, которые и так постоянно сталкиваются с ограничениями доступа к зарубежным сервисам, это скорее подтверждение уже привычной стратегии, чем новость.
Если вы строите агентов для задач в кибербезопасности или DevOps, посмотрите каталог AI-агентов, там есть готовые сценарии под конкретные задачи без необходимости разбираться в гейтинге каждой отдельной модели.
Часто задаваемые вопросы про задержку GPT-5.6
Почему GPT-5.6 задержали именно на 13 дней? Столько заняла проверка от гейтированного превью 26 июня до снятия ограничений Минторговли 8 июля и полного GA 9 июля. Формальных сроков в указе не прописано, процесс шел по факту готовности CAISI.
GPT-5.6 сейчас доступна в России? Прямого доступа через официальный аккаунт ChatGPT из РФ по-прежнему нет из-за отдельных региональных ограничений OpenAI, не связанных с этой историей. Через OpenRouter и совместимые API модель доступна, как и раньше.
Чем Sol отличается от Terra и Luna? Sol, флагман для долгих и сложных задач от 10 минут, кибербезопасности и научных исследований. Terra, баланс цены и скорости для повседневного кода. Luna, самый дешевый вариант для массовых вычислений и оркестрации другими агентами.
Действительно ли GPT-5.6 опаснее Claude Fable 5? По сырым весам без ограничений Mythos 5 сильнее на ExploitBench, 78% против 73.5%. Но у Fable 5 в публичном доступе классификатор урезает эффективный результат почти до уровня Opus, тогда как Sol отдает свои 73.5% без такого провала.
Что такое ExploitBench простыми словами? Тест, где модель должна не просто найти дыру в коде, а довести атаку до конца и получить контроль над системой. Промежуточные успехи вроде найденной уязвимости без эксплуатации баллов не дают.
Повторится ли такая задержка с будущими моделями? Скорее всего да. Указ от 2 июня требует проверки CAISI за 30 дней до релиза любой frontier-модели, и GPT-5.6 стала первым прецедентом полного прохождения этой процедуры.
Как это влияет на выбор модели для кодинга через Cursor или Claude Code? Напрямую никак, инструменты вроде Cursor и Claude Code продолжают работать с доступными моделями. Но если вы строите продукт под конкретную flagship-модель, закладывайте риск временного гейтинга в план релиза.
Если тема регуляторных рисков AI-моделей и выбора инструментов для команды актуальна для вашего проекта, запишитесь на консультацию к Максиму, разберем стек под вашу задачу без лишней теории.
Обновлено: октябрь 2026.