400 000+ органических переходов за 3 месяца. Со-основатель GoBanana (231K пользователей, 12+ млн ₽ без рекламы) и NeuroScribe (65K пользователей). SEO/GEO-стратегии для AI-поисковиков, 1 700+ единиц контента, 17+ реализованных стратегий.
Об авторе →Claude Code: новый CLI-агент от Anthropic
Anthropic выпустила Claude Code — терминальный AI-агент для разработчиков. Инструмент работает прямо в командной строке и умеет писать, редактировать и запускать код.
Zcode AI: Полный гид по визуальному интерфейсу для Claude Code и AI-агентов
Узнайте, как использовать Zcode для управления Claude Code, Gemini и Codex в едином GUI. Настройка провайдеров, MCP-серверов и визуальный вайбкодинг.
YouTube-канал с монетизацией из любой точки мира: Пошаговый гайд 2026
Инструкция по созданию YouTube-канала: обход блокировок SMS, настройка расширенных функций через виртуальные номера и правила безопасности для монетизации.
Windsurf Code Maps: Как глубоко понимать архитектуру проекта перед написанием кода
Полный гайд по Windsurf Code Maps, модели Sway 1.5 и Sway Grep. Узнайте, как визуализировать архитектуру кода и ускорить разработку в 13 раз.
Vk Fast Cash Strategy
Аудитория ВКонтакте — это те же люди, что и в Instagram, но 'социальный контракт' площадки другой. Если Instagram — это 'дорогой ресторан' с демонстрацией успеха, то VK — это 'душевная шашлычная'. Здесь не работает глянцевый 'успешный успех
Короткий ответ: нейросеть для текста на русском языке редко ошибается в падежах напрямую, но почти всегда выдаёт себя порядком слов и лишними связками, скопированными с английского синтаксиса. GigaChat и YandexGPT звучат живее в бытовой речи, а Claude и GPT сильнее в сложных рассуждениях, но иногда пишут по-русски слишком правильно для живого человека. Ниже разберём, почему так происходит и как проверить конкретную модель на своих текстах.
Нейросети редко путают падежи в прямом смысле: чаще они выдают себя порядком слов, избыточным пассивным залогом и оборотами, скопированными с английского. GigaChat и YandexGPT чувствуют бытовую русскую речь живее, Claude и GPT сильнее в сложных текстах. В статье: техническая причина неестественности, честное сравнение отечественных и западных моделей и практический тест на живую речь.
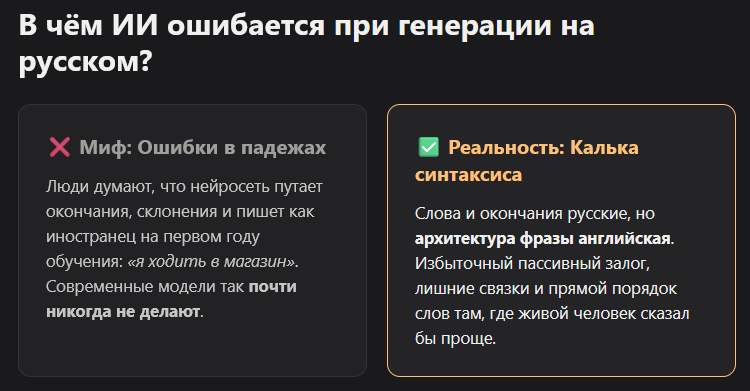
Дело не в словаре, а в архитектуре фразы: модель строит предложение по логике английского синтаксиса, даже когда все слова русские.
Большинство топовых моделей обучены на массиве данных, где качественного русского текста в разы меньше, чем английского. Отсюда конструкции с "быть" и пассивным залогом там, где живой человек сказал бы проще, и порядок слов, формально не ошибочный, но режущий слух.
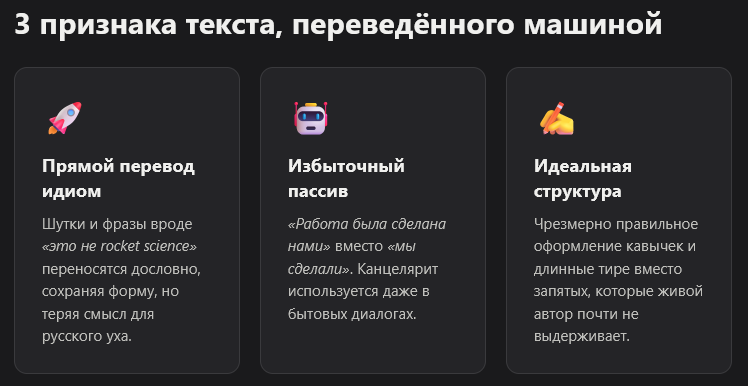
Разработчики ютуб-канала про нейросети сформулировали это через конкретные маркеры: длинные тире вместо запятых, дословно переведённые английские идиомы ("это не rocket science" вместо "тут думать не надо") и шутки, у которых есть форма, но нет смысла для русского уха. Ещё один маркер из той же серии наблюдений: избыточно правильное оформление диалогов и кавычек, которое живой автор почти никогда не выдерживает на всей странице.
Заметить это проще на бытовой речи, чем на деловом тексте. Формальный документ прощает кальку, разговорный диалог, где герой должен звучать как сосед по лестничной клетке, а не как переведённая методичка, ошибки сразу подсвечивает.
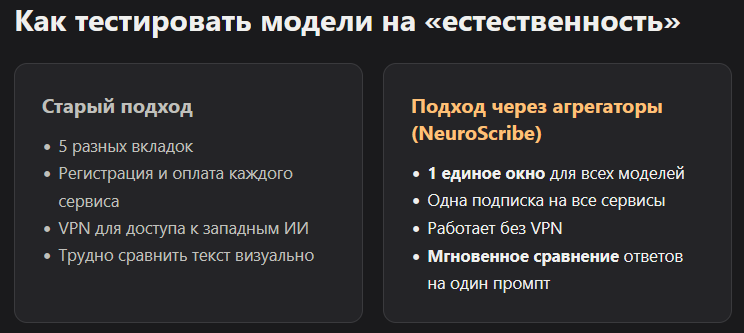
NeuroScribe даёт доступ к нескольким моделям под одной подпиской, поэтому один и тот же текст можно прогнать через них подряд и сравнить именно качество русского языка, а не интерфейсы.
Идея простая: не заводить отдельный аккаунт на каждый сервис ради одного теста. NeuroScribe уже сравнивали как площадку, где разные модели с разным характером собраны в одном окне, потому что каждая живёт на своём сайте со своей подпиской и интерфейсом, из-за чего сравнение растягивается на несколько вкладок и логинов.
Для проверки естественности речи это удобно чисто технически: берёте один и тот же промт с разговорным диалогом, прогоняете через доступные модели подряд и сравниваете результат на одном экране. Разница в построении фразы становится заметна почти сразу, особенно если один из вариантов явно звучит как перевод.
Это не значит, что NeuroScribe сама по себе гарантирует идеальный русский. Инструмент даёт только скорость сравнения, финальную оценку всё равно делает человек.
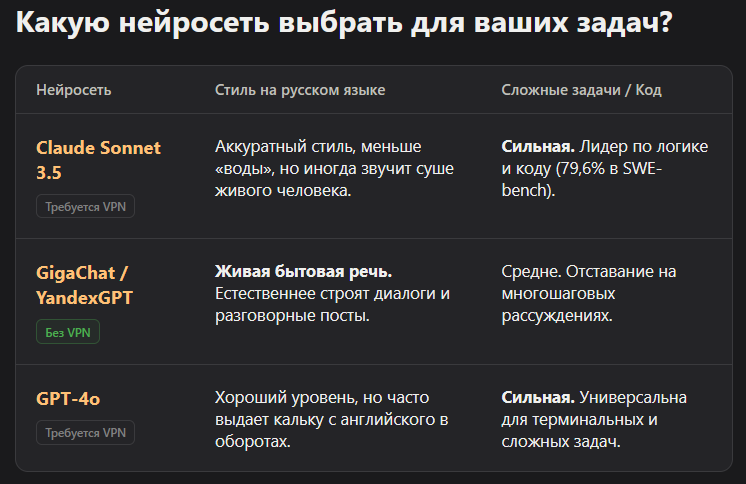
Да, но с оговоркой: отечественные модели звучат естественнее в бытовой речи, а на сложных многошаговых задачах чаще уступают топовым западным моделям в глубине рассуждения.
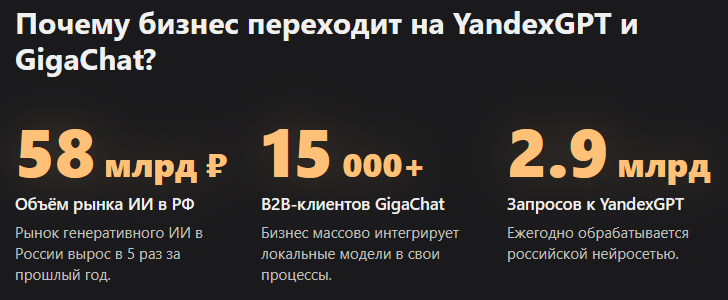
Рынок генеративного ИИ в России за прошлый год вырос в пять раз и достиг 58 миллиардов рублей, и это не абстрактная цифра, а следствие того, что бизнес массово переходит на локальные модели. GigaChat обслуживает больше 15 тысяч бизнес-клиентов, а YandexGPT обрабатывает 2,9 миллиарда запросов в год.
Причина такого спроса не только в отсутствии VPN и блокировок. Обе модели обучены на массиве данных с заметно большей долей качественного русского языка, и это даёт им преимущество именно в естественности бытовой и разговорной речи.
Честный компромисс здесь такой: на бенчмарке MERA отечественные модели показывают отставание примерно на 25 пунктов от GPT-5 на сложных задачах, требующих многошагового рассуждения. Для короткого поста в соцсети или живого диалога персонажей это отставание почти не заметно. Для аналитической статьи или технической документации разница становится ощутимой.
Отдельные независимые тесты сравнивали GigaChat и YandexGPT сразу на нескольких жанрах текста, от научного до художественного, и результат по жанрам заметно отличался: на научном, научно-популярном и художественном текстах заявленный потенциал моделей проверяли отдельно, поскольку из коробки они справляются с жанрами неравномерно.
Универсального победителя нет: выбор зависит от жанра текста и от того, критична ли для вас доступность без VPN.
| Модель | Русский язык | Сложные задачи | Доступ из РФ |
|---|---|---|---|
| Claude Sonnet 4.6 | Аккуратный стиль, меньше воды | Сильная, 79,6% SWE-bench | Через VPN |
| GPT-5.4 | Хороший, иногда калька в оборотах | Сильная, терминальные задачи | Через VPN |
| Gemini 3.1 Pro | Средний, слабее в разговорной речи | Сильная на больших документах | Через VPN |
| GigaChat | Живая бытовая речь | Средняя, отставание на сложных задачах | Без VPN |
| YandexGPT | Живая бытовая речь | Средняя | Без VPN |
| DeepSeek V3.2 | Приемлемый, экономичный вариант | Средняя, сильна в коде | Через VPN |
Для маркетингового поста в соцсети или письма клиенту отечественные модели часто выигрывают именно за счёт естественности. Для технической статьи, аналитики или кода лучше подходят западные модели, даже с поправкой на менее живой русский стиль.
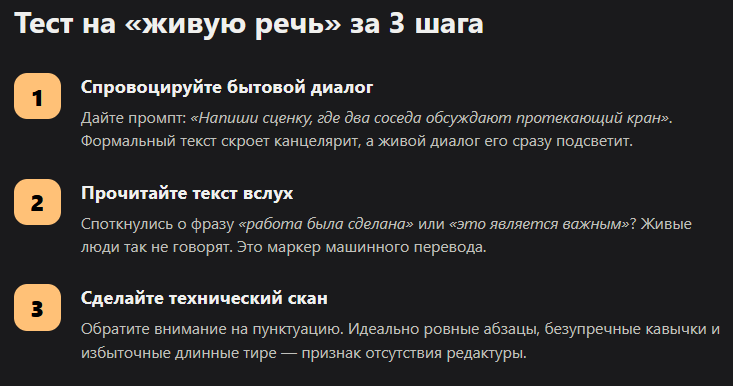
Попросите модель написать короткий текст с прямой речью, не формальный документ, а живой диалог, и разница между моделями станет заметна сразу.
Формальный текст прощает почти любой модели канцелярские обороты, но живой диалог их безжалостно подсвечивает. Дайте модели вводную вроде "напиши короткую сценку, где два соседа обсуждают протекающий кран" и посмотрите, насколько естественно звучат реплики.
Дополнительно стоит проверить сам текст на технические маркеры генерации: избыточные длинные тире там, где нормальный человек поставил бы запятую, идеально ровную структуру абзацев без единой шероховатости и слишком правильно расставленные кавычки в диалогах. Если все три признака совпали одновременно, перед вами почти наверняка неотредактированный вывод модели.
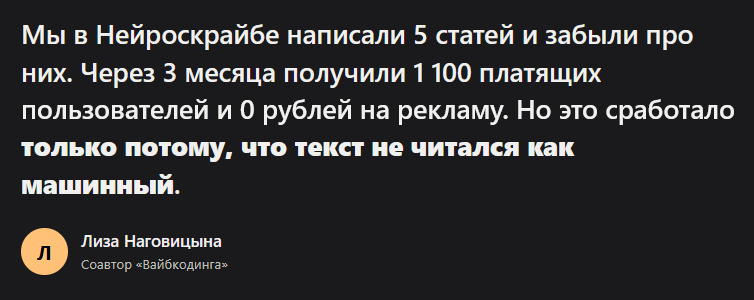
Лиза: «Мы в Нейроскрайбе написали пять статей и забыли про них, через три месяца получили 1 100 платящих пользователей и ноль рублей на рекламу. Но это сработало только потому что текст не читался как машинный, вот такие пироги.»
Какая нейросеть лучше пишет на русском языке?
Однозначного лидера нет. GigaChat и YandexGPT звучат живее в бытовой речи, Claude и GPT сильнее держат логику на сложных текстах. Выбор зависит от жанра.
Почему текст нейросети звучит неестественно даже без ошибок?
Потому что модель строит фразу по логике английского синтаксиса из-за преобладания английских данных в обучении, даже если все слова русские и грамматика формально верна.
GigaChat или Claude лучше для русского языка?
GigaChat естественнее в разговорной и бытовой речи. Claude сильнее на сложных многошаговых текстах, но местами звучит суше и правильнее, чем живой человек.
Как проверить текст на естественность речи без специальных сервисов?
Прочитайте вслух. Если в каком-то месте текст звучит как перевод методички, скорее всего это признак генерации, а не живой авторской речи.
Можно ли доверять автоматическим детекторам ИИ-текста?
Частично. Разные детекторы дают на одном и том же тексте сильно расходящиеся оценки, поэтому лучше опираться на собственное чтение вслух вместе с детектором, а не только на процент.
Что делать, если текст от нейросети звучит как калька с английского?
Переписать разговорные обороты вручную или задать модели роль редактора-стилиста с инструкцией внести неравномерность в стиль и убрать шаблонные связки.
Есть ли способ сравнить сразу несколько моделей на одном тексте?
Да, агрегаторы вроде NeuroScribe дают доступ к нескольким моделям под одной подпиской, что ускоряет такое сравнение без регистрации в каждом сервисе отдельно.
Если хотите быстрее разобраться, какая модель подойдёт под ваши задачи, загляните в каталог AI-инструментов на VibeCoderz или запишитесь на консультацию к Максиму.
Обновлено: октябрь 2026.
