Есть проблема, с которой сталкивается каждый, кто работает с AI-агентами больше одной сессии. Ты потратил час на то, чтобы объяснить агенту контекст: что за продукт, какая главная метрика, что сейчас в работе, какие решения уже приняли. Назавтра открываешь новую сессию — и снова «Привет! Чем займёмся?». Чистый лист. Ноль памяти.
Это не баг и не недосмотр. Агенты архитектурно не помнят ничего между сессиями. Контекст живёт только внутри одного разговора.
Obsidian Mind решает это радикально просто: Obsidian vault как постоянный слой памяти. Всё что важно — цели, проекты, решения, паттерны, ошибки, задачи — живёт в markdown-файлах на твоём диске. При каждом запуске агент автоматически загружает нужное. 3333+ звёзд, MIT, поддержка Claude Code, Codex и Gemini CLI.
Obsidian Mind — open-source vault с 5 lifecycle hooks и 18 slash-командами. Агент помнит цели, проекты, решения и ошибки между сессиями. ~2K токенов на старт. Работает с Claude Code, Codex CLI, Gemini CLI. MIT, 3333+ GitHub stars. В статье: архитектура, хуки, команды, структура vault, QMD, интеграция с Record a Skill, 4 сценария, установка.
Ссылки:
- github.com/breferrari/obsidian-mind — репозиторий (3333+★)
- dudarik.com: разбор Obsidian Mind — технический обзор
- ShardMind — менеджер для установки vault-шаблонов
- QMD (Query Markdown) — семантический поиск по vault
- OneBrain — альтернатива (AI OS подход, 30 скиллов)
- Obsidian-Memory (jodfie) — MCP-сервер подход, 13 tools
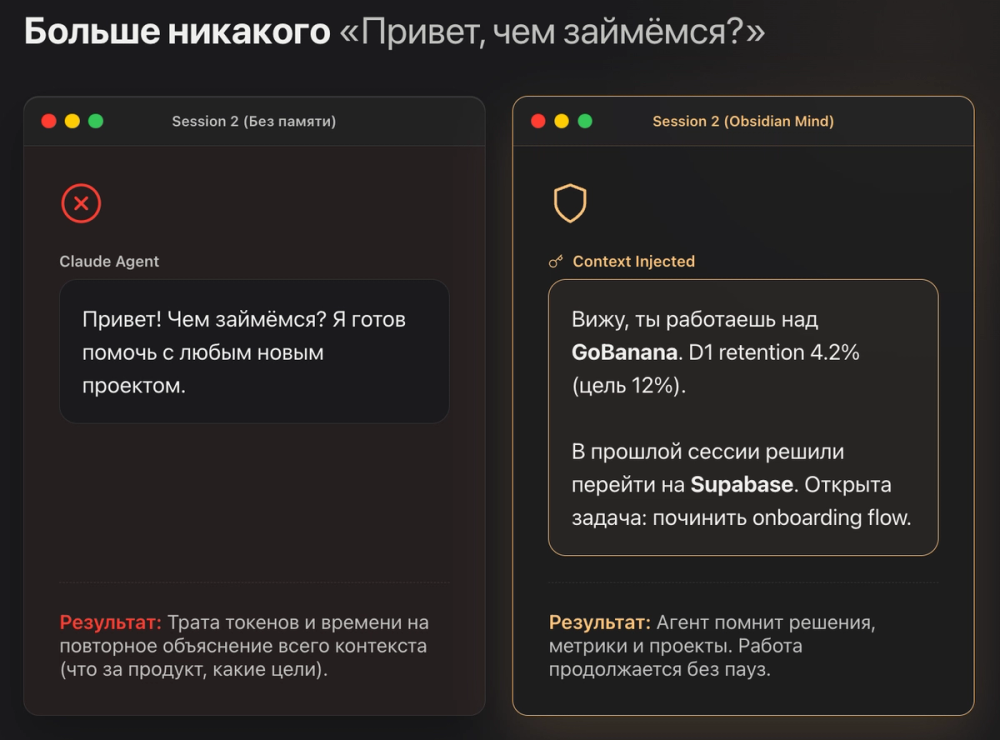
Зачем это нужно — проблема в одном скриншоте
До Obsidian Mind:
Сессия 1: «Я работаю над GoBanana, D1 retention 4.2%,
           нужно дотянуть до 12%. Переходим на Supabase.»

Сессия 2: «Привет! Чем займёмся?»  ← ноль контекста
После Obsidian Mind:
Сессия 2 (автоматически при запуске):
«Ты работаешь над GoBanana. D1 retention 4.2%, цель 10-12%.
 В прошлой сессии решили перейти с Firebase на Supabase.
 Открыта задача: починить onboarding flow.
 1:1 с Максимом завтра в 14:00 — brief ещё не готов.»
Разница не в удобстве — в количестве токенов, которые тратятся на введение в курс дела, и в качестве работы агента, который с первого слова понимает контекст.
Как устроена архитектура — просто о сложном
Ключевой принцип Obsidian Mind: код владеет средой, агент владеет контентом.
Это значит, что система делится на два чётко разграниченных слоя:
Хуки и скрипты — детерминированные, тестируемые TypeScript/Shell программы. Они классифицируют, валидируют, индексируют, инжектируют контекст. Не принимают суждений, не пишут контент.
Агент (Claude, Codex, Gemini) — пишет заметки, расставляет wikilinks, составляет briefs, принимает решения о том, что важно. Не занимается технической классификацией.
Vault — обычные markdown-файлы в Obsidian. Git-tracked (история изменений), просматриваемые в Obsidian UI, связанные wikilinks.
Между хуками и агентом — «маленькие стыковки»: хук инжектирует контекст в начале сессии, агент читает vault и пишет в него. Никто не делает работу другого.
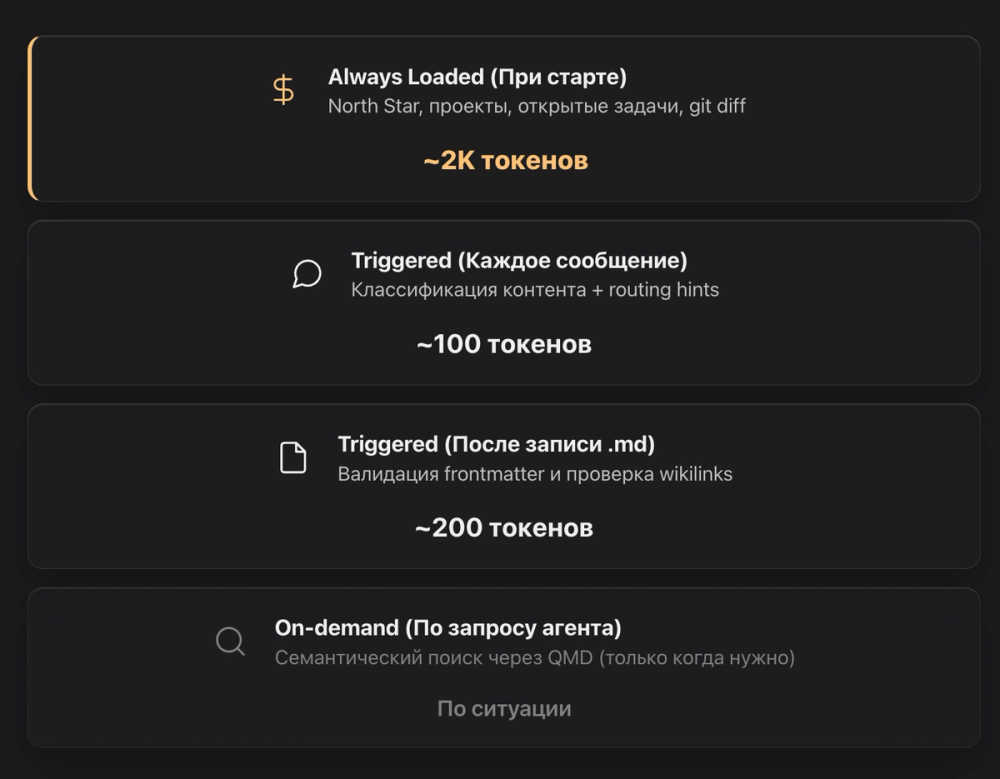
Token Efficiency — умная загрузка контекста
Obsidian Mind не сбрасывает весь vault в контекст при каждом запросе. Многоуровневая система:
| Уровень | Когда | Что грузится | Токенов |
|---|---|---|---|
| Always | При старте | North Star, активные проекты, git diff, открытые задачи, список файлов | ~2K |
| Triggered | Каждое сообщение | Классификация + routing hints | ~100 |
| Triggered | После записи .md | Валидация frontmatter + wikilinks | ~200 |
| On-demand | По запросу агента | Семантический поиск QMD | Прицельный |
| Rare | Полные чтения | Только когда нужен весь файл | Разный |
Vault может содержать 247 файлов — в контекст при старте попадают только ~2K токенов самого важного.
5 lifecycle hooks — сердце системы
Хуки — это скрипты, которые срабатывают на конкретные события в жизненном цикле агента. Вот что происходит в каждый момент.
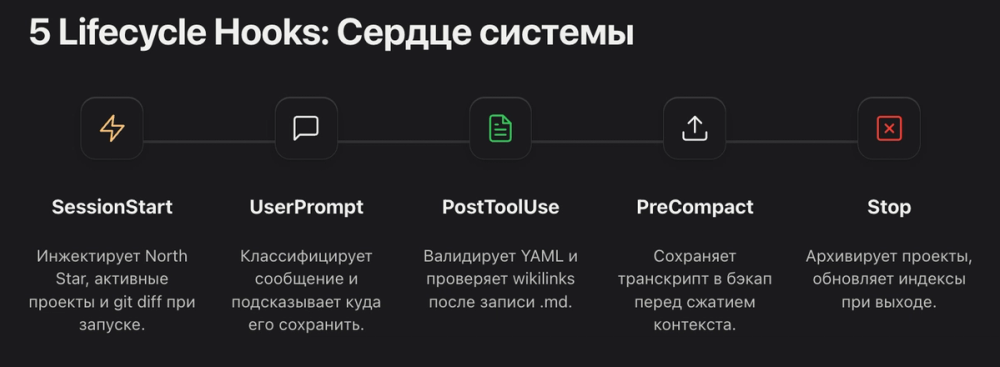
🚀 SessionStart — при каждом запуске
Это первое что видит агент. Хук автоматически:
- Переиндексирует vault через QMD
- Инжектирует в контекст всё необходимое
Что попадает в контекст — конкретный пример:
North Star: Запустить GoBanana на 50k MRR к декабрю.

Активные проекты:
- GoBanana: D1 retention 4.2%, цель 10-12%
- VibeCoderz: 10-15k визитов/мес (сейчас ~8k)
- Текст Завод: pre-launch, блокер — валидация качества статей

Последние изменения (git diff):
- brain/Key Decisions.md: «Переходим на Supabase для GoBanana»

Открытые задачи:
- [ ] Починить onboarding flow в GoBanana
- [ ] Написать 3 статьи для VibeCoderz
- [ ] Подготовить brief для 1:1 с Максимом (завтра 14:00)

Файлов в vault: 247
Агент с первого слова твоего сообщения знает, в каком ты контексте.
💬 UserPromptSubmit — при каждом сообщении
Ты пишешь: «слушай, я тут понял что нам надо переписать API на FastAPI».
Хук классифицирует это как decision с уверенностью 0.9 и инжектирует в контекст подсказку:
[routing hint: this looks like a decision — log to brain/Key Decisions.md
 with wikilinks to relevant project notes]
Агент понимает куда именно нужно сохранить это решение, и делает это правильно — с backlinks на связанные проекты.
Классификации контента: decision, incident, win, 1:1, architecture, person, project update.
✍️ PostToolUse — после каждой записи .md
Каждый раз когда агент создаёт или обновляет markdown-файл, хук автоматически:
- Валидирует YAML frontmatter
- Проверяет wikilinks (ссылаются ли они на реально существующие файлы)
- Флажит «голые» заметки без единой ссылки на другие файлы
Так vault остаётся структурированным, а не превращается в свалку несвязанных заметок.
💾 PreCompact — перед сжатием контекста
Когда контекст подходит к лимиту и агент собирается его сжать — хук сначала сохраняет транскрипт сессии в thinking/session-logs/. Ни одна важная мысль из разговора не теряется бесследно.
🏁 Stop — при завершении сессии
Перед выходом хук запускает чеклист:
- Архивирует завершённые проекты из
work/active/вwork/archive/ - Обновляет индексы
- Проверяет orphan-заметки (файлы без единой ссылки)
Структура vault — что куда хранится
obsidian-mind/
├── brain/              ← ПОСТОЯННАЯ ПАМЯТЬ (source of truth)
│   ├── North Star.md   ← Цели и фокус — читается КАЖДУЮ сессию
│   ├── Memories.md     ← Индекс тем памяти
│   ├── Key Decisions.md← Решения с обоснованием
│   ├── Patterns.md     ← Повторяющиеся паттерны в работе
│   ├── Gotchas.md      ← Что пошло не так и почему
│   └── Skills.md       ← Кастомные workflows и slash-команды
│
├── work/               ← РАБОЧИЕ ПРОЕКТЫ
│   ├── active/         ← Текущие (попадают в SessionStart)
│   └── archive/        ← Завершённые
│
├── org/                ← ЛЮДИ И КОММУНИКАЦИИ
│   ├── people/         ← Заметка на каждого человека
│   └── 1on1s/          ← Записи встреч с датами
│
├── perf/               ← ПЕРФОРМАНС-ТРЕКИНГ
│   ├── Brag Doc.md     ← Достижения и победы
│   └── competencies/   ← Карта компетенций
│
└── thinking/
    └── session-logs/   ← Бэкапы транскриптов (PreCompact)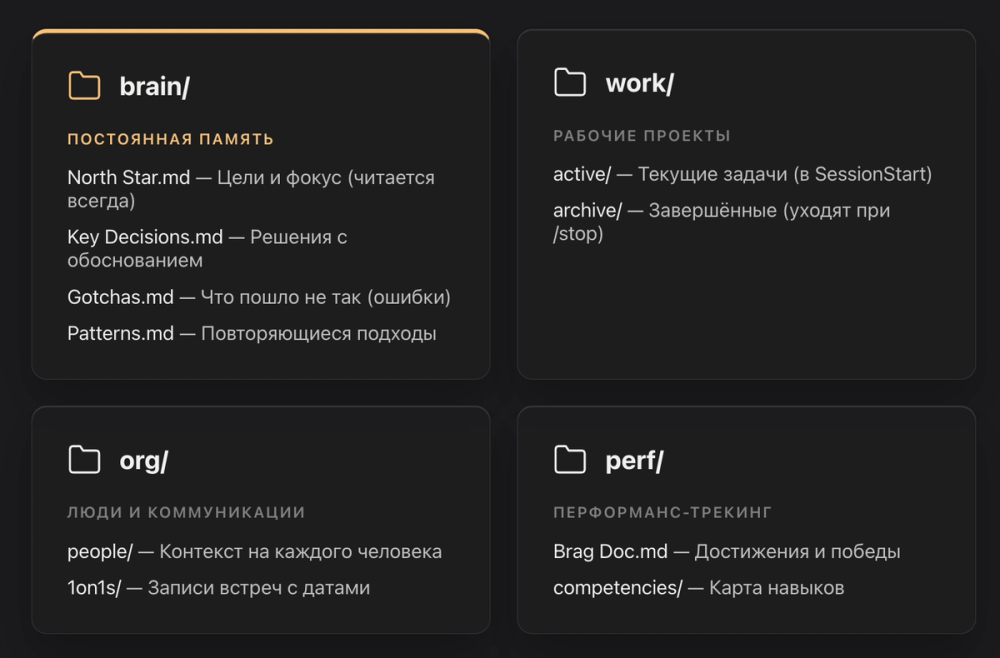
Как заметки связываются
Папки группируют по назначению, wikilinks — по смыслу. Заметка живёт в одной папке, но ссылается на многие другие:
# work/active/GoBanana Retention.md

Решили переключить onboarding flow на [[Supabase]] вместо Firebase.
См. [[brain/Key Decisions#GoBanana Backend Migration]].
Блокируемся на API-контракте с [[org/people/Максим Н.]].
Паттерн: [[brain/Patterns#Retention Drops After Deploy]]
Backlinks строятся автоматически. Заметка без единой ссылки флагится хуком PostToolUse — это сигнал что она «потерянная».
18 slash-команд — что можно вызвать прямо в чате
Все команды определены в .claude/commands/ и работают в Claude Code, Codex CLI и Gemini CLI.
Ежедневная работа:
| Команда | Что делает |
|---|---|
| /om-standup | Утренний запуск — контекст, вчерашние итоги, сегодняшние приоритеты |
| /om-dump | Свободный захват — говоришь как угодно, агент раскидывает по нужным местам |
| /om-wrap-up | Итог сессии — верификация заметок, индексов, ссылок |
| /om-humanize | Делает Claude-текст похожим на твой стиль (voice calibration) |
| /om-weekly | Недельный синтез — кросс-сессионные паттерны, alignment с целями, неучтённые победы |
Работа с людьми:
| Команда | Что делает |
|---|---|
| /om-capture-1on1 | Захват транскрипта 1:1 в структурированную заметку |
| /om-prep-1on1 | Подготовка к 1:1 — контекст человека, открытые вопросы, повестка |
| /om-meeting | Подготовка к встрече по теме |
| /om-intake | Обработка inbox встреч — классификация и роутинг |
| /om-peer-scan | Глубокий скан профиля коллеги для review-prep |
| /om-slack-scan | Скан Slack-каналов и DM для поиска evidence |
| /om-incident-capture | Захват инцидента из Slack/каналов в структурированную заметку |
Performance review:
| Команда | Что делает |
|---|---|
| /om-self-review | Self-assessment — проекты, компетенции, достижения |
| /om-review-peer | Peer review с доказательной базой из vault |
| /om-review-brief | Brief для менеджера или коллеги |
Обслуживание vault:
| Команда | Что делает |
|---|---|
| /om-vault-audit | Аудит индексов, ссылок, orphan-заметок, устаревшего контекста |
| /om-vault-upgrade | Импорт из существующего vault с авто-классификацией |
| /om-project-archive | Перенос завершённого проекта в archive/ |
QMD — когда нужен умный поиск
Без QMD поиск по vault — это grep. Работает, но ищет только по ключевым словам.
С QMD можно спросить: «какие решения принимали по бэкенду в июле?» — и получить релевантные заметки по смыслу, даже если слово «бэкенд» в них не встречается буквально.
npm install -g @tobilu/qmd
node --experimental-strip-types scripts/qmd-bootstrap.ts
Первая загрузка: ~328MB (embedding model). Дополнительно ~1.28GB для LLM reranking — опционально. Для небольшого vault (до 50-100 заметок) без QMD вполне комфортно. Для большого — QMD меняет качество поиска кардинально.
Brag Doc и performance review — встроенный трекинг достижений
Obsidian Mind — это не только рабочая память, но и доказательная база для performance review.
Каждый раз когда через /om-dump или вручную фиксируется победа — она попадает в perf/Brag Doc.md с wikilink на контекст:
## 2026-07-21
- [[GoBanana]]: Подняли D1 retention с 4.2% до 7.1%
  через новый onboarding flow → [[brain/Key Decisions#Onboarding Flow v2]]
- [[VibeCoderz]]: Достигли 12k визитов/мес — +40% к плану
Когда приходит review-сезон — /om-self-review собирает из vault полную картину: проекты, компетенции, конкретные цифры, решения, которые ты принял, инциденты, которые разрулил. С доказательствами, а не «ну я делал что-то важное, кажется».
Идеальное комбо: Obsidian Mind + Record a Skill
Если вы читали нашу статью про Claude Record a Skill — эти два инструмента созданы друг для друга.
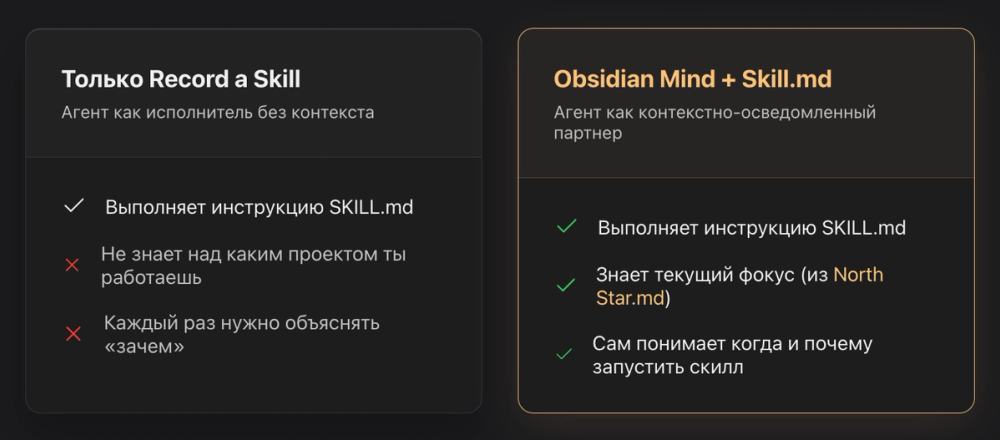
Record a Skill создаёт SKILL.md — файл с инструкциями для повторяемого workflow. Obsidian Mind хранит этот файл в vault и при каждой сессии агент знает о его существовании.
Разница:
| Без комбо | С комбо |
|---|---|
| Агент выполняет workflow из SKILL.md | Агент знает контекст: какой проект, какие решения, кто в команде |
| Каждый раз нужно объяснять зачем | Агент сам понимает когда и почему запустить скилл |
| Workflow без истории | Паттерны и ошибки — в Gotchas.md и Patterns.md |
Практический флоу:
# 1. Записываешь скилл в Claude Desktop
# Claude Desktop → Cowork → Record a Skill
# Claude генерирует SKILL.md

# 2. Сохраняешь в vault
cp ~/.claude/skills/weekly-seo-report/SKILL.md \
   ~/vault/brain/Skills.md

# 3. При следующем запуске агент знает:
# → Что ты работаешь над VibeCoderz
# → Что у тебя есть скилл weekly-seo-report
# → Что прошлая неделя закрылась с 12k визитов (Brag Doc)
# → Что новые темы в очереди (work/active/VibeCoderz Content Pipeline.md)
Четыре сценария — конкретно как это работает
Еженедельный отчёт по метрикам продукта
Проблема: каждая сессия с агентом начинается с объяснения «у нас GoBanana, D1 retention 4.2%, нужно 12%, переходим на Supabase».
Решение — заполнить brain/North Star.md:
## GoBanana
- Текущий MRR: ~40-45k руб/день
- Критическая метрика: D1 Retention (сейчас 4.2%, цель 10-12%)
- Активная инициатива: Новый onboarding flow
- Технический долг: Миграция Firebase → Supabase
- Стек: Python, Telegram API, ЮKassa, СБП
И brain/Key Decisions.md:
## 2026-07-20: Переход на Supabase
- Решили мигрировать с Firebase на Supabase
- Причина: real-time subscriptions для onboarding flow
- Ответственный: Максим
- Срок: до 15 августа
Результат: агент при запуске сразу знает что за продукт, какая главная метрика, что в работе и почему.
Контент-машина с памятью об ошибках
Агент помогает с контентом, но постоянно нужно напоминать какие темы уже опубликованы и какие технические детали важны.
work/active/VibeCoderz Content Pipeline.md:
## Статус: активный
- План: 2-3 статьи/день, 3-4 карусели/день
- Цель: 10-15k визитов/мес (сейчас ~8k)
- Следующие темы: Windsurf vs Devin, OpenCode review
- Опубликовано на этой неделе: «Claude Code MCP Setup Guide»brain/Gotchas.md:
## VibeCoderz: Sanity CMS
- При создании нового айтема ВСЕГДА проверять что slug уникален
- Карусели для Instagram: 1080x1080 (не 1920x1080)
- В пятницу трафик падает на 30% — не паниковать
Агент с первого дня не наступает на те же грабли.
Кросс-сессионное знание о SaaS-продукте
Проект живёт месяцами, а агент каждый раз начинает с нуля. Решение — brain/Patterns.md:
## SEO-контент: Работа с Ahrefs API
- Всегда снимать лимит на 1000 строк (default 100)
- Для русскоязычных ключей отдельный запрос с language=ru
- Кластеризация: информационные vs коммерческие vs навигационные
И work/active/Текст Завод — SaaS Launch.md:
## Этап: тестирование
- Партнёр: Саша Юркевич
- Текущий блокер: валидация качества статей
- Решение (2026-07-19): добавили pre-processing для кластеризации
Личный бренд с доказательной историей
perf/Brag Doc.md:
## 2026-07
- [[GoBanana]]: D1 retention +2.9% после A/B теста onboarding flow
- [[VibeCoderz]]: Достигли 12k визитов/мес (с 6k в июне)
- [[Текст Завод]]: Завершили MVP, 25 статей за 15 минут
- [[Личный бренд]]: +300 подписчиков в TG за неделю
При review с командой или инвесторами — /om-self-review собирает всё в структурированный отчёт с цифрами.
Лиза: «Вот такие пироги. Я поняла зачем это нужно когда на пятой сессии с агентом по VibeCoderz снова объясняла что такое Sanity и почему slug должен быть уникальным. Теперь агент знает это с первого запуска — и не нужно тратить токены на вводный инструктаж.»
Как меняется опыт с каждой сессией
| Сессия | Без Obsidian Mind | С Obsidian Mind |
|---|---|---|
| 1 | «Привет! Чем займёмся?» | «Ты работаешь над GoBanana (retention 4.2%), VibeCoderz (12k визитов) и Текст Завод. Вчера зафиксировали решение о Supabase.» |
| 2 | «Привет! Чем займёмся?» — снова | «На прошлой сессии записала скилл weekly-seo-report. Также: retention поднялся до 5.1%.» |
| 10 | «Привет! Чем займёмся?» — всё ещё | «За 10 сессий: 4 скилла, 3 ключевых решения, 2 паттерна, 1 готча. Retention: 4.2% → 8.7%.» |
Установка — три пути
Через ShardMind (рекомендуется)
npm install -g shardmind
mkdir my-vault && cd my-vault
shardmind install github:breferrari/obsidian-mind
Мастер установки спросит: имя, организация, назначение vault, какие агенты включить (Claude Code / Codex CLI / Gemini CLI), нужен ли QMD.
После установки:
- Открыть папку как Obsidian vault (Obsidian → Open folder as vault)
- Включить Obsidian CLI: Settings → General (требуется Obsidian 1.12+)
- Запустить агента:
claude,codexилиgemini - Заполнить
brain/North Star.mdсвоими целями - Начать работать — хуки подхватятся автоматически
Через git clone
git clone https://github.com/breferrari/obsidian-mind.git my-vault
cd my-vault
# Открыть в Obsidian, заполнить brain/North Star.md
Byte-эквивалентно ShardMind с настройками по умолчанию.
QMD (опционально, для семантического поиска)
npm install -g @tobilu/qmd
node --experimental-strip-types scripts/qmd-bootstrap.ts
Первая загрузка ~328MB. Стоит установить если vault растёт больше 50-100 заметок.
Требования: Node 22+ LTS, Obsidian 1.12+.
Честно про ограничения
Только локально. Vault на диске — не в облаке. Синхронизация между машинами — Obsidian Sync ($) или git auto-push. Для одной машины работает отлично, для нескольких нужно настроить.
Глубина поддержки агентов разная. Claude Code — полная, включая subagents и memory system. Codex CLI и Gemini CLI — хуки + команды, но не та же глубина. Для максимального эффекта — Claude Code.
Vault только растёт. Хуки валидируют структуру, но не удаляют устаревшее. Раз в месяц-два стоит делать /om-vault-audit и вручную чистить устаревшие заметки.
QMD не обязателен, но без него поиск деградирует. На большом vault grep по ключевым словам начинает пропускать релевантное.
~/.claude/ memory loader — Claude-специфичен. Для Codex и Gemini vault используется напрямую через AGENTS.md и settings.json — работает, но чуть иначе.
Альтернативы — экосистема памяти для AI-агентов
Obsidian Mind не единственный подход. Краткий обзор экосистемы:
| Проект | Звёзды | Подход |
|---|---|---|
| obsidian-mind (breferrari) | 3,333 | Vault-first, 5 хуков, 18 команд, perf-трекинг. Самый зрелый. |
| OneBrain (onebrain-ai) | ~500 | AI OS поверх агентов — 30 скиллов, 4-tier memory, калибровка под пользователя |
| Obsidian-Memory (jodfie) | ~400 | MCP-сервер + SQLite FTS5, 13 tools. Работает с Claude.ai через SSE |
| obsidian-cli-memory-bank | ~6 | CLI-first (obmem), минималистичный, memory compaction |
| obsidian-infinite-brain | ~50 | Typed knowledge graph: 16 типов нод, 10 типов связей, confidence decay |
Если нужен максимально зрелый и готовый к работе — Obsidian Mind. Если нужен MCP-сервер для Claude.ai (не только Claude Code) — Obsidian-Memory (jodfie). Если нужен typed knowledge graph с метаданными — obsidian-infinite-brain.
FAQ
Нужен ли Obsidian для работы Obsidian Mind?
Не обязательно для агента — агент работает с markdown-файлами напрямую. Но Obsidian нужен для Obsidian CLI (хук PostToolUse) и для визуального просмотра vault с wikilinks и графом связей. Рекомендуется установить.
Работает ли это без интернета?
Vault хранится локально. Хуки запускаются локально. Интернет нужен только для работы самого агента (Claude Code, Codex, Gemini подключаются к облачным API).
Можно ли использовать существующий Obsidian vault?
Да. Команда /om-vault-upgrade импортирует существующий vault с авто-классификацией заметок.
Что если агент напишет что-то не туда?
Vault git-tracked. Любое изменение отслеживается, можно откатить. Плюс хук PostToolUse валидирует каждый файл сразу после записи.
Сколько места занимает vault?
Markdown-файлы занимают минимум. QMD embedding model — ~328MB. Транскрипты сессий в thinking/session-logs/ постепенно накапливаются — периодически чистить.
Как лучше начать — с нуля или с заполненным vault?
Начни с нуля. Заполни только brain/North Star.md (твои цели) и дай агенту поработать несколько сессий. Vault наполняется органически. Не пытайся перенести всё сразу.
Репозиторий — github.com/breferrari/obsidian-mind. Установка через ShardMind — shardmind.io. QMD — github.com/tobi/qmd. Технический разбор — dudarik.com.
Смотрите страницу Claude Code на VibeCoderz и нашу статью про Record a Skill — вместе эти два инструмента дают агенту и память, и повторяемые workflows.
Вопросы по настройке persistent memory для агентных пайплайнов — к Максиму.
Обновлено: октябрь 2026. Источники: GitHub breferrari/obsidian-mind, dudarik.com, ShardMind, Obsidian Vault Hub.