
Текст из PDF в Word нейросеть переносит за несколько минут. Вы загружаете файл в Gemini, ChatGPT или Claude, просите собрать редактируемый документ и скачиваете .docx. Работает и со сканами, где слово мышкой не выделить, но таблицы и рукописные фрагменты после нее придется вычитать глазами. Ниже разберем, как проверить тип файла, какие промпты писать, чем отличаются сервисы и в каких случаях распознать текст PDF нейросетью без правок не получится.
В 2026 году три чата умеют превращать PDF в Word: Gemini, ChatGPT и Claude. Обычный PDF конвертируется почти без потерь, скан читается через распознавание, но таблицы и рукопись требуют проверки. Файл до 100 МБ у Gemini, 30 МБ у Claude, 512 МБ у ChatGPT. В статье: шаги, готовые промпты и таблица выбора.
Чем нейросеть для распознавания текста PDF отличается от обычного конвертера?
Обычный конвертер вытаскивает из файла готовые буквы. Нейросеть смотрит на страницу как человек и сама понимает, где заголовок, таблица и колонка, поэтому справляется и со сканами.
OCR, или оптическое распознавание символов, превращает картинку страницы в текст. Старые движки вроде Tesseract читают пиксели, а нейросети 2026 года учитывают контекст страницы целиком. В видео-тесте десяти нейросетей (февраль 2026) GPT-5.2, Claude Opus 4.6 и Gemini 3 Pro заметно обошли классический OCR на сложной форме с рукописью.
Разницу хорошо видно на привычных программах. В уроках по ABBYY FineReader схема такая: отсканировать страницу, разметить блоки текста, картинок и таблиц, затем запускать распознавание. Если бумага пожелтела или печать бледная, автор урока советует размечать блоки вручную. Нейросеть делает разметку сама, за один проход. А платить за лицензию не нужно: загрузка файла в чат есть и на бесплатных тарифах, хоть и с лимитами.
Как понять, что у вас скан, а не обычный PDF?
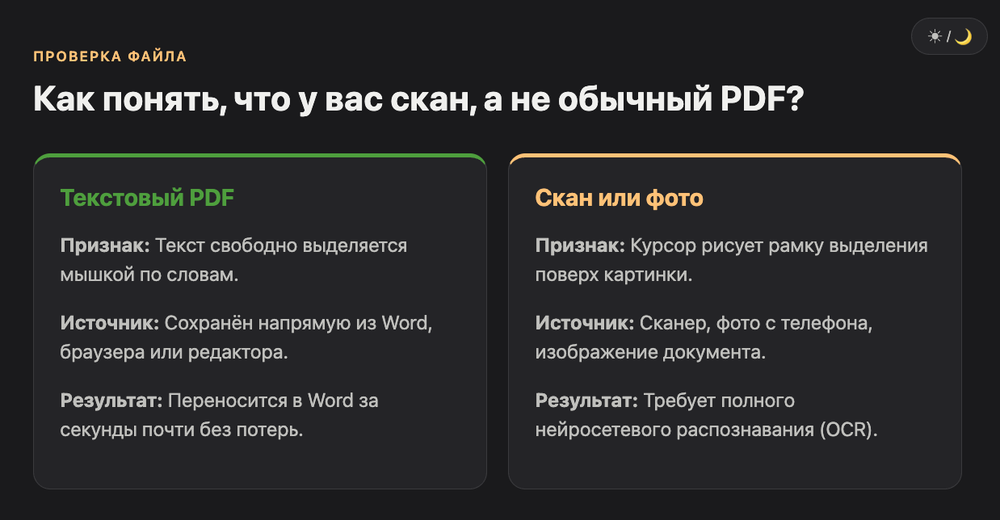
Попробуйте выделить слово курсором. Выделилось, значит внутри есть текстовый слой и конвертация пройдет легко. Не выделилось, значит страница хранится как картинка и нужно распознавание.
Текстовый PDF, сохраненный из Word или с сайта, содержит настоящие символы и переходит в Word почти без потерь. Скан или фото документа хранит только изображение страницы. Проверка занимает две секунды: если курсор рисует рамку поверх страницы вместо подсветки слов, перед вами картинка, и без распознавания текста не обойтись.
Есть и коварный третий случай: PDF, где текстовый слой поверх скана когда-то создала старая программа. Слова выделяются, но вместо «договор» выходит «дoгoвop», а строки склеены. Такой файл надежнее отдавать нейросети как картинки страниц.
У ChatGPT свой нюанс. По данным сервиса FileUploadGPT, на тарифах ниже Enterprise он берет из PDF только цифровой текст и отбрасывает изображения, так что чистый скан может вернуться пустым. Проверьте на своем файле. Если так и вышло, сохраните страницы в JPG или PNG и загрузите их как фотографии.
Как перевести PDF в Word нейросетью пошагово?
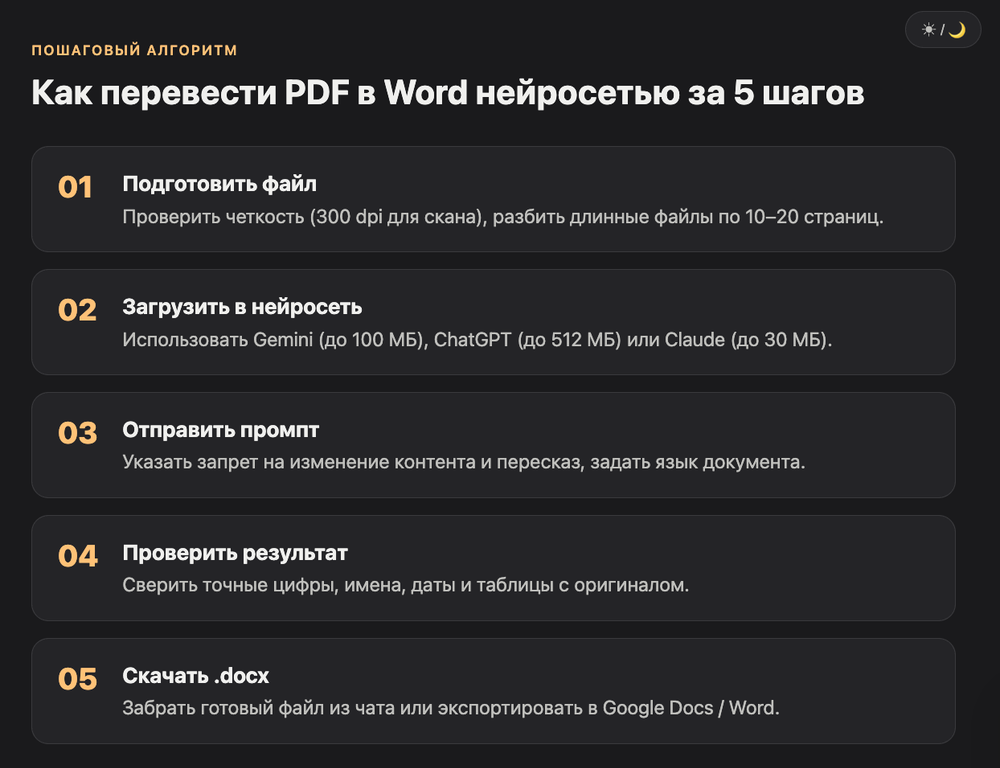
Загрузите файл в чат, попросите собрать редактируемый документ без изменения содержания, проверьте результат и скачайте .docx. Документ в десяток страниц занимает несколько минут.
В видеоинструкциях по Gemini и ChatGPT путь одинаковый: открыть чат, загрузить PDF, попросить редактируемый Word с форматированием, проверить текст и скачать файл. Google подтвердил создание .docx прямо в чате Gemini в апреле 2026 года, а Claude собирает такие файлы по текстовому описанию.
Шаг 1. Как подготовить PDF к загрузке?
Начните с проверки из прошлого раздела: выделяется ли текст. Если это скан, сделайте его четким. В уроке по FineReader автор ставит 300 dpi вместо стандартных 200: страница сканируется дольше, зато распознается лучше. Фото с телефона снимайте при ровном свете, без наклона и теней от руки. Снимок в формате HEIC сначала сохраните как JPG или PNG, иначе чат может его не принять. Если страниц много, разбейте файл на части по 10-20 страниц. Паспорта и медицинские справки в облачный чат лучше не загружать вовсе, об этом ниже.
Шаг 2. Куда загружать файл?
Подойдет любой из трех чатов. В Gemini нажмите плюс в строке запроса и выберите файл. За один раз принимается до 10 файлов размером до 100 МБ, как указано в справке Google. В ChatGPT файл можно перетащить в окно. Лимит составляет 512 МБ на файл, а на бесплатном тарифе действуют всего 3 загрузки в день, это прописано в FAQ OpenAI. В Claude потолок 30 МБ на файл. Для первого раза берите тот сервис, где вы уже вошли в аккаунт.
Шаг 3. Что написать в запросе?
Запомните одно правило: просите не менять содержание. Иначе нейросеть начнет пересказывать, сокращать и «улучшать» текст, и вместо копии документа вы получите вольный пересказ. Автор видео про ChatGPT формулирует так: конвертировать, не меняя контент. Отдельно назовите язык страницы. Автор сравнения OCR-моделей подставлял язык изображения в промпт, и нейросети после этого почти не выдумывали лишнего. Готовые формулировки лежат в следующем разделе. Вставьте одну из них вместе с файлом и отправьте.
Шаг 4. Как проверить результат?
Откройте оригинал и Word рядом и пройдите по трем местам: цифры, имена и таблицы. Нейросеть редко ломает абзацы обычного текста, зато может подставить похожий символ или выдумать лишнее. В февральском видео-тесте одна нейросеть увидела в форме галочку, которой на бумаге не было, а другая приняла пятно за поставленную отметку. Суммы, даты, номера счетов и фамилии сверяйте по оригиналу каждый раз, даже если остальной текст вышел идеально. Попросите нейросеть саму пометить сомнительные места знаком [?].
Шаг 5. Как скачать Word без потери форматирования?
В Gemini готовый .docx скачивается из чата или сохраняется на Диск. Claude создает Word-файлы через функцию «Upgraded file creation and analysis» в разделе Settings > Capabilities. По данным обзора eesel AI, у бесплатных и платных аккаунтов она обычно включена, но проверьте. Если нейросеть вернула только текст, скопируйте его в Word командой «вставить без форматирования», как советует автор одного из разобранных видео. Нужен просто текст без Word? Нейросеть PDF в текст превращает тем же запросом, в конце просто попросите вернуть простой текст. Заголовки и списки потом проставьте стилями Word.
Какие промпты для распознавания текста в PDF работают лучше всего?
Лучше всего работает короткий промпт из трех частей: что сделать, что не менять и в каком виде вернуть. Ниже три готовых варианта под обычный PDF, скан с таблицами и проверку результата.
Формулировка «преврати PDF в редактируемый документ Word и сохрани форматирование» встречается в видеоинструкциях по Gemini и ChatGPT как базовая. Такого запроса хватает для текстового PDF. Для скана с таблицами к нему добавляют язык страницы, запрет на изменение содержания и требование сохранить порядок колонок.
Базовый промпт для обычного PDF
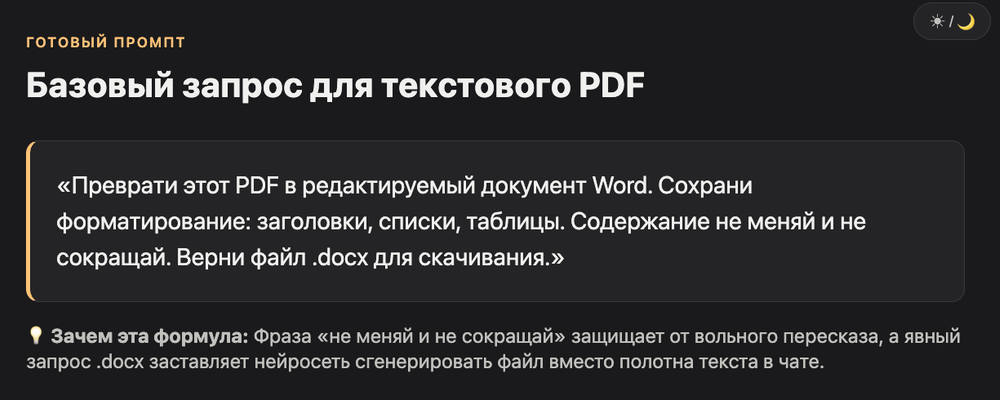
Подходит для PDF из Word или сайта, где текст выделяется. Просьба сохранить форматирование заставляет нейросеть вернуть заголовки, списки и абзацы, а не сплошное полотно.
Преврати этот PDF в редактируемый документ Word. Сохрани форматирование: заголовки, списки, таблицы. Содержание не меняй и не сокращай. Верни файл .docx для скачивания.Лайфхак: последняя фраза нужна, если нейросеть по умолчанию выдает текст прямо в окне.
Промпт для скана с таблицами
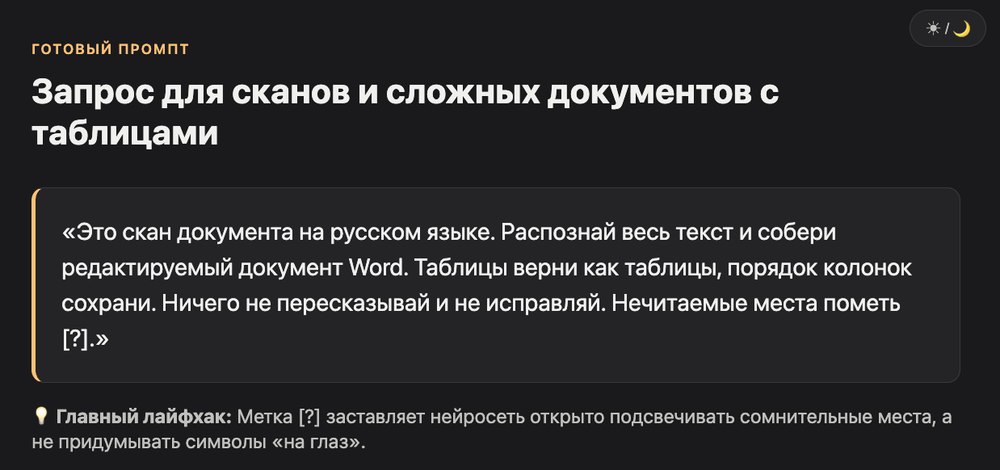
Для отсканированных страниц и фотографий документов. Язык называем прямо, а таблицы просим вернуть таблицами Word, иначе строки склеятся в абзац.
Это скан документа на русском языке. Распознай весь текст и собери редактируемый документ Word. Таблицы верни как таблицы, порядок колонок сохрани. Ничего не пересказывай и не исправляй. Нечитаемые места пометь [?].Лайфхак: для скана из многих страниц надежнее отправлять по 10-20 страниц и повторять промпт целиком в каждом запросе.
Промпт для проверки результата
Запускайте вторым сообщением, пока файл еще открыт в чате с нейросетью. Просьба к нейросети назвать сомнения снижает шанс, что ошибка пройдет молча.
Сравни свой текст с оригинальной страницей. Перечисли места, где ты сомневался: цифры, даты, фамилии, таблицы. Ничего не исправляй молча, покажи список.Порядок работы такой: базовый промпт или промпт для скана, затем проверка, затем ваша вычитка по списку сомнений. Список не отменяет глаз человека, но сужает круг поиска.
Когда нейросеть конвертирует PDF отлично, а когда результат придется править?
Чистые печатные страницы нейросеть переносит почти без ошибок. Рукопись, мелкие таблицы, сложные колонки и фото под углом почти всегда требуют вычитки, а числа проверяйте по оригиналу в любом случае.
Результат зависит прежде всего от качества страницы. Печатный текст и таблицы простой структуры распознаются уверенно, а рукопись, бледная печать и сноски в две колонки дают ошибки. Сверка чисел и фамилий обязательна для любого документа, даже если страница на экране выглядит безупречно.
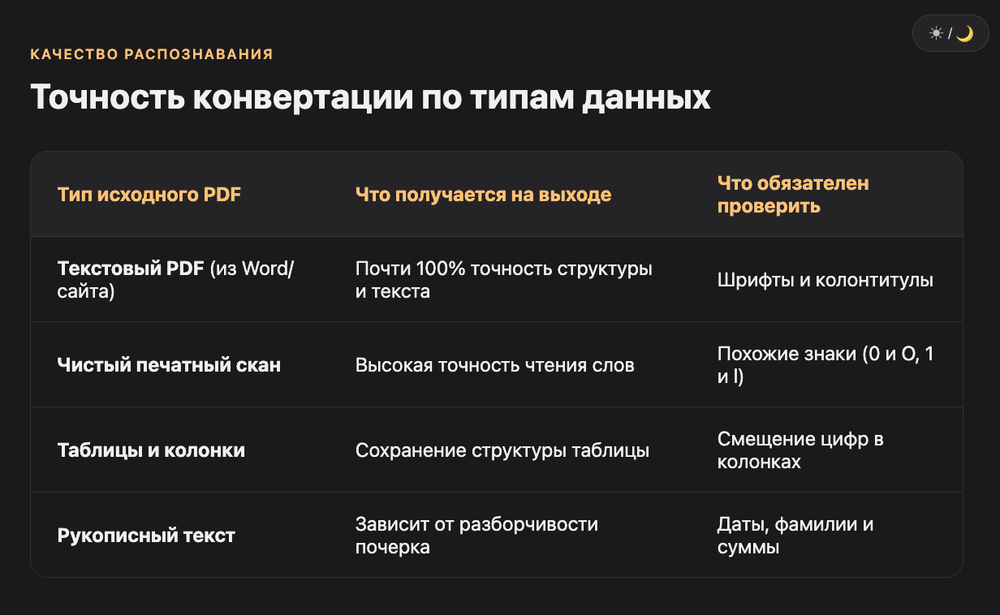
| Тип PDF | Что обычно получается | Что проверить |
|---|---|---|
| Текстовый PDF из Word или сайта | Текст и структура переносятся почти без потерь | Шрифты, колонтитулы, номера страниц |
| Чистый скан печатного текста | Читается хорошо | Похожие символы: 0 и O, 1 и l |
| Фото документа под углом или при плохом свете | Возможны пропуски и склеенные строки | Края страниц, подписи, мелкий шрифт |
| Таблица | Структура чаще сохраняется, цифры могут съехать | Каждую колонку с суммами |
| Рукописный текст | Читается лучше, чем старым OCR, но зависит от почерка | Имена, даты и числа |
| Две колонки, сноски, формулы | Порядок чтения иногда путается | Последовательность абзацев |
Что нейросеть делает лучше конвертера?
Она понимает структуру. Заголовки, списки, колонки и подписи к рисункам определяются по смыслу страницы, поэтому результат ближе к настоящему документу. Она читает то, что обычный конвертер пропускает: фото, низкий контраст, рукописные пометки. В видео-тесте Gemini 3 Pro лучше других прочитала блеклый участок формы, а GPT-5.2 справилась с рукописью. На снимке номерного знака при плохом свете Tesseract не нашел ничего. ChatGPT и Claude прочитали номер верно, это показал тест канала Kevin Wood Robotics на данных Roboflow.
Где результат придется править?
- Цифры и похожие символы. Ноль и буква O, единица и l, запятая и точка в суммах. Ошибка в одной цифре меняет смысл счета.
- Длинные документы. ChatGPT принимает до 2 млн токенов на файл, а по данным FileUploadGPT, лишнее молча отбрасывает без ошибки. Google в справке Gemini предупреждает, что при переполнении контекста модель может пропустить детали. Спросите у нейросети, как называется последний раздел, и станет ясно, дочитала ли она файл до конца.
- Оформление. Word собирается заново. Шрифты, отступы и колонтитулы отличаются от оригинала.
- Лимиты. На бесплатном ChatGPT всего 3 загрузки файлов в день. Создание файлов в Claude тратит лимит плана быстрее обычного диалога.
- Конфиденциальность. Паспорта, договоры и медицинские справки лучше не отправлять в облачный чат. Закройте персональные данные или запускайте модель у себя. Доступ к части сервисов зависит от региона, проверьте его заранее.
Gemini, ChatGPT или Claude что выбрать для конвертации PDF в Word?
Для сканов и длинных файлов начните с Gemini. Для разовой задачи хватит ChatGPT. Claude удобен, когда нужен готовый .docx. На сотнях страниц выгоднее API.
Gemini принимает файлы до 100 МБ, ChatGPT до 512 МБ при потолке 2 млн токенов текста, Claude до 30 МБ. Для сравнения на объеме: Mistral OCR 3 обрабатывает страницу примерно за 0,2 цента, это $2 за 1 000 страниц. Данные на сентябрь 2026, лимиты и цены меняются, сверяйтесь со справкой сервисов.
Как выглядит сравнение по лимитам и цене?
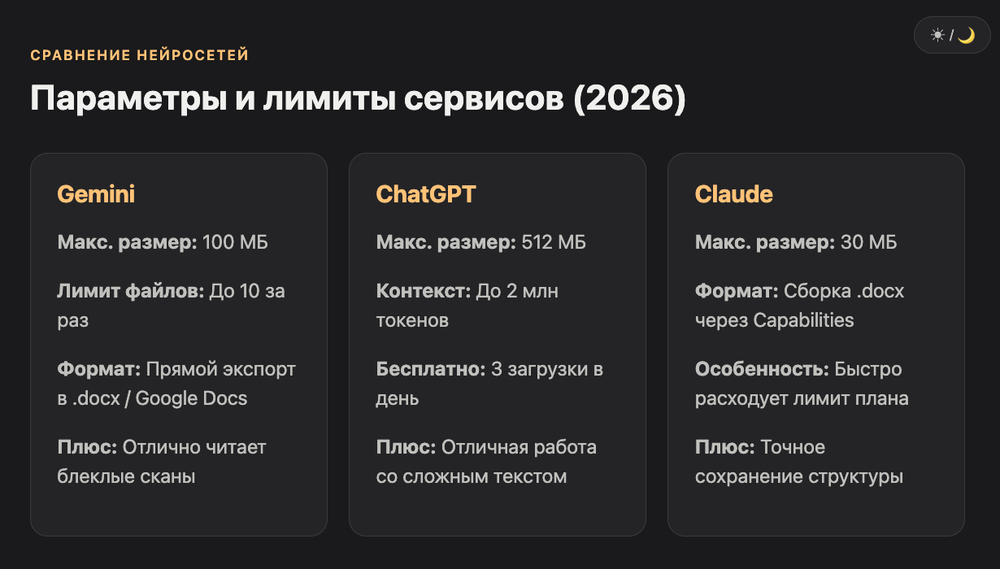
В таблице собраны лимиты и цены по справкам сервисов и независимым обзорам на сентябрь 2026.
| Сервис | Как получить Word | Лимиты на файл | Что учесть |
|---|---|---|---|
| Gemini | Создает .docx в чате или экспорт в Google Docs | До 100 МБ, до 10 файлов в запросе | Скользящие лимиты на загрузку, большие файлы могут читаться неполно |
| ChatGPT | Word-файл по запросу со ссылкой на скачивание | 512 МБ, 2 млн токенов текста, 20 МБ на картинку, на Free 3 загрузки в день | Скан-PDF лучше отправлять картинками, длинный файл обрезается без ошибки |
| Claude | Создает .docx в чате | 30 МБ на файл | Создание файлов быстрее расходует лимит плана |
| Mistral OCR 3 | Markdown с HTML-таблицами через Document AI или API, в Word отдельным шагом | $2 за 1 000 страниц, $1 в батч-режиме | Есть версия новее, OCR 4.1, за $4 за 1 000 страниц |
| ABBYY FineReader | Сохранение в Word из самой программы | Платная лицензия | Ручная разметка блоков на плохих страницах, на книгах процесс идет долго |
Как выбрать под свою задачу?
Итоговая карта выбора под типичные задачи.
| Задача | Что взять | Почему |
|---|---|---|
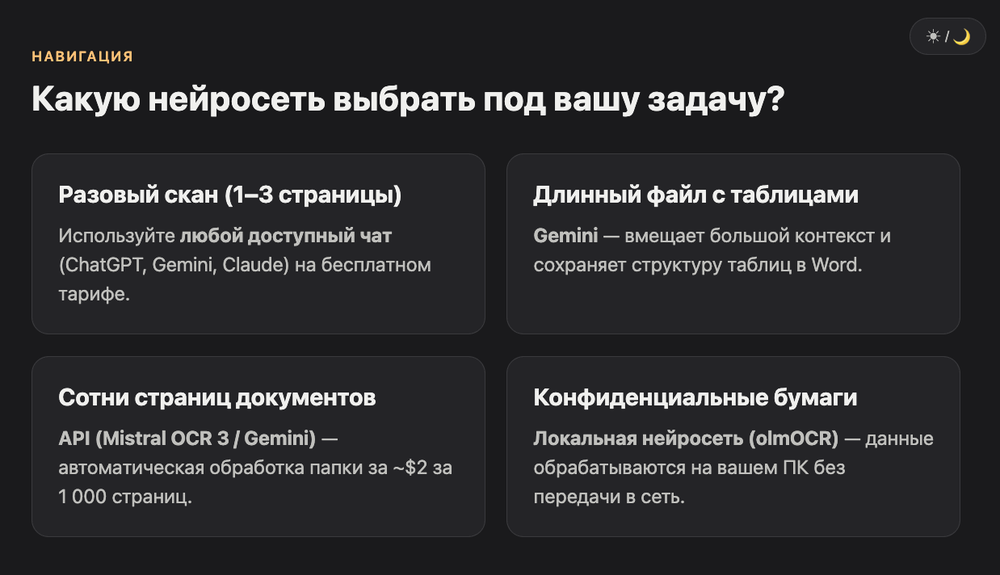
| Разовый скан на пару страниц | Любой из трех чатов | Хватит бесплатного тарифа, берите тот, где уже есть аккаунт |
| Длинный документ с таблицами | Gemini | По справке Google, контекст в 1 млн токенов вмещает до 1 500 страниц текста, но хвост файла проверьте |
| Готовый .docx одним запросом | Claude или Gemini | Оба создают Word-файл прямо в чате |
| Сотни страниц | API и скрипт | Mistral OCR 3 стоит $2 за 1 000 страниц |
| Конфиденциальные документы | Локальная нейросеть | Файл не покидает ваш компьютер |
Мы бы не искали лучший сервис навсегда. Возьмите самый неудобный свой документ, прогоните через два чата и сравните таблицы и числа. Победитель на вашем файле важнее любого рейтинга.
Что делать, если страниц сотни, а не десяток?
Когда файлов много, чат неудобен. Скрипт с вызовом API распознавания обрабатывает папку сам, а собрать его можно обычным текстом в Claude Code, даже без опыта программирования.
Mistral OCR 3 стоит $2 за 1 000 страниц, поэтому архив в 300 страниц обойдется примерно в $0,60. Gemini APIпринимает PDF до 50 МБ или 1 000 страниц, и каждая страница занимает около 258 токенов. Оба варианта подключаются скриптом, который складывает результат в папку.
Как автоматизировать пачку PDF?
Логика скрипта простая: взять файл из папки, отправить в API, получить текст, собрать .docx и переложить в папку «готово». Написать такой скрипт для распознавания PDF нейросетью можно попросить Claude Codeобычным русским текстом. Другие инструменты для подобной автоматизации собраны в каталоге AI-инструментов.
Лиза: «Раньше я вручную разбирала 15-20 видео ради одной единицы контента, уходило 4 часа. Написала скрипт в Google Таблицах: вставляю ссылки, дальше транскрибация и разбор по 15 критериям. Теперь 5,5 минут. Прикинь? Вот такие пироги.»
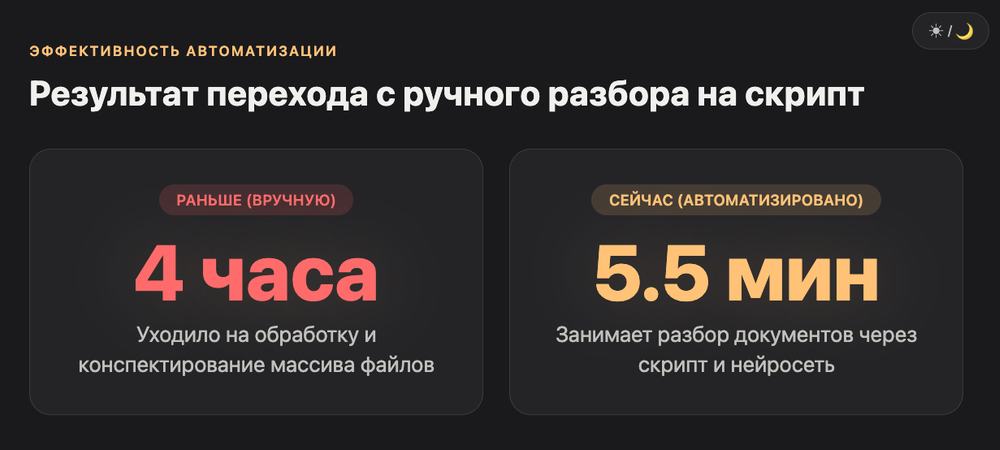
С PDF арифметика та же. Пока файлов два, хватит чата. Когда их сорок, вы платите временем, и скрипт быстро окупается.
А если документы нельзя отправлять в облако?
Тогда подойдут локальные нейросети. В сравнении OCR-моделей на вырезанных фрагментах манги на пяти языках, включая русский, лучшим оказался olmOCR. У него семь миллиардов параметров, около 20 секунд на одно распознавание и высокие требования к компьютеру. Нейросети поменьше работают быстрее и дают неплохой результат, а автор теста советует их тем, у кого слабое железо.
Частые вопросы про перевод PDF в Word нейросетью
Можно ли перевести PDF в Word нейросетью бесплатно?
Да, для разовых задач хватит бесплатных тарифов. В ChatGPT на Free доступно 3 загрузки файлов в день, по данным OpenAI, у Gemini и Claude тоже есть бесплатный доступ с лимитами. Когда файлов много, лимиты закончатся быстро, и придется выбирать платный тариф или API.
Нейросеть распознает русский текст со скана?
Да. Нейросети читают кириллицу: русский был в тесте OCR-моделей наряду с китайским, английским, японским и корейским. Ошибки чаще случаются на плохом свете, мелком шрифте и рукописи. Фамилии, суммы и даты после распознавания сверяйте с оригиналом.
Чем нейросеть лучше обычного конвертера PDF в Word?
На сканах и сложной верстке. Она понимает структуру страницы, а обычный конвертер работает только с готовым текстовым слоем. Зато для чистого PDF из Word классический конвертер быстрее и не выдумывает лишнего. Выбирайте по типу файла.
Сохранится ли форматирование при конвертации?
Структура сохраняется: заголовки, списки, таблицы. Точные шрифты, отступы и колонтитулы обычно отличаются, потому что Word собирается заново. Напишите в запросе «сохрани форматирование», как советуют авторы разобранных видео, и оставьте время на подгонку стилей.
Сколько страниц можно загрузить за один раз?
Зависит от сервиса. Gemini API принимает PDF до 50 МБ или 1 000 страниц, ChatGPT ограничивает не страницы, а 2 млн токенов текста, Claude принимает до 30 МБ. На практике надежнее отправлять по 10-20 страниц и склеивать результат в Word.
Как распознать рукописный текст в PDF?
Загрузите четкий скан, укажите язык и попросите пометить нечитаемые слова знаком [?]. В февральском видео-тесте GPT-5.2 прочитала весь рукописный текст в форме, но добавила лишнюю галочку. Имена, даты и числа проверяйте по оригиналу.
Почему ChatGPT вернул пустой ответ по моему скану?
Скорее всего, в PDF нет текстового слоя. По данным FileUploadGPT, тарифы ниже Enterprise берут из PDF только цифровой текст и отбрасывают картинки. Сохраните страницы как JPG или PNG, до 20 МБ каждая по правилам OpenAI, и загрузите их как изображения.
С чего начать прямо сейчас?
Возьмите один неудобный PDF и прогоните его через промпт для скана из раздела выше. Если результат устроил, остальную папку разберите скриптом. Обзоры инструментов, с которыми такие скрипты собирают без программистов, лежат в каталоге AI-инструментов, а разбор Claude Code поможет начать автоматизацию. Студентам, которые переводят в Word конспекты и методички, пригодится агент для студентов. Хотите настроить конвертацию под свои документы? Запишитесь на консультацию к Максиму.
Дата обновления: сентябрь 2026