
Перевести PDF нейросетью и сохранить верстку можно, но обычный чат-бот для этого не годится. ChatGPT и Gemini хорошо переводят вставленный текст, а файл ломают: колонки съезжают, таблицы превращаются в кашу, картинки исчезают. Нужен сервис, который разбирает документ, переводит и собирает его заново. Ниже разберем, какая нейросеть для перевода PDF справляется лучше, где рвется верстка и как подобрать инструмент под ваш файл.
Коротко: Чат-боты ломают верстку PDF, потому что работают с голым текстом. Для файлов подходят DeepL, Google Переводчик (10 МБ и 300 страниц), Яндекс Переводчик (5 МБ) и специализированные сервисы вроде DocTranslator. В статье: лимиты и цены на сентябрь 2026, разбор сканов, четыре шага проверки и карта выбора.
Цифры ниже взяты из официальных справок сервисов и из видеоразборов. Мы не прогоняли все сервисы через один файл, поэтому данные со слов авторов роликов помечены отдельно.
Почему нейросеть ломает верстку, когда переводит PDF?
Языковая модель видит в PDF россыпь текстовых обрывков без структуры. Слова она переводит хорошо, а собрать из них страницу с колонками и таблицами не умеет.
ChatGPT, Gemini и DeepSeek работают с голым текстом и не понимают, где в файле таблица, отступ или колонка. Внутри PDF одно предложение может лежать в нескольких несвязанных кусках. Если вставить текст в чат руками, перевод получится хорошим, а вот файл на выходе почти всегда теряет оформление.
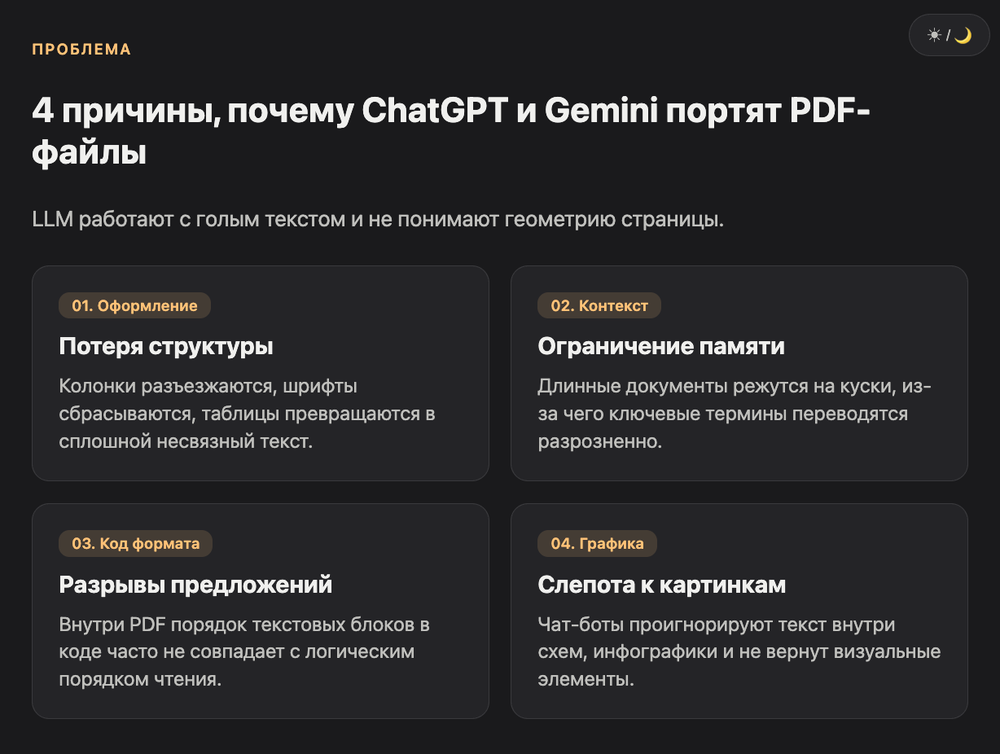
Проблем четыре. Оформление: колонки разъезжаются, шрифты меняются, от файла остается сплошной текст. Размер: у модели ограничен объем памяти, длинный документ режется на куски, и термин из начала к концу переводится по-разному.
Есть еще сам формат, где порядок фрагментов в коде не совпадает с порядком на странице. И картинки с текстом: инфографику или схему чат не прочитает и в итоговый файл, скорее всего, не вернет.
Как нейросеть переводит PDF и не теряет структуру файла?
Сервис разбирает структуру файла, переводит текст с учетом контекста всего документа и пересобирает страницы, подгоняя шрифты и блоки под длину нового языка.
Немецкий текст в среднем на 20-30% длиннее английского, поэтому сервисы для перевода PDF пересчитывают шрифты, интервалы и позиции блоков. Без пересчета текст не влезает на свои места, таблицы разъезжаются, а подписи наползают на картинки. Эту цифру приводит автор YouTube-разбора про перевод файлов.
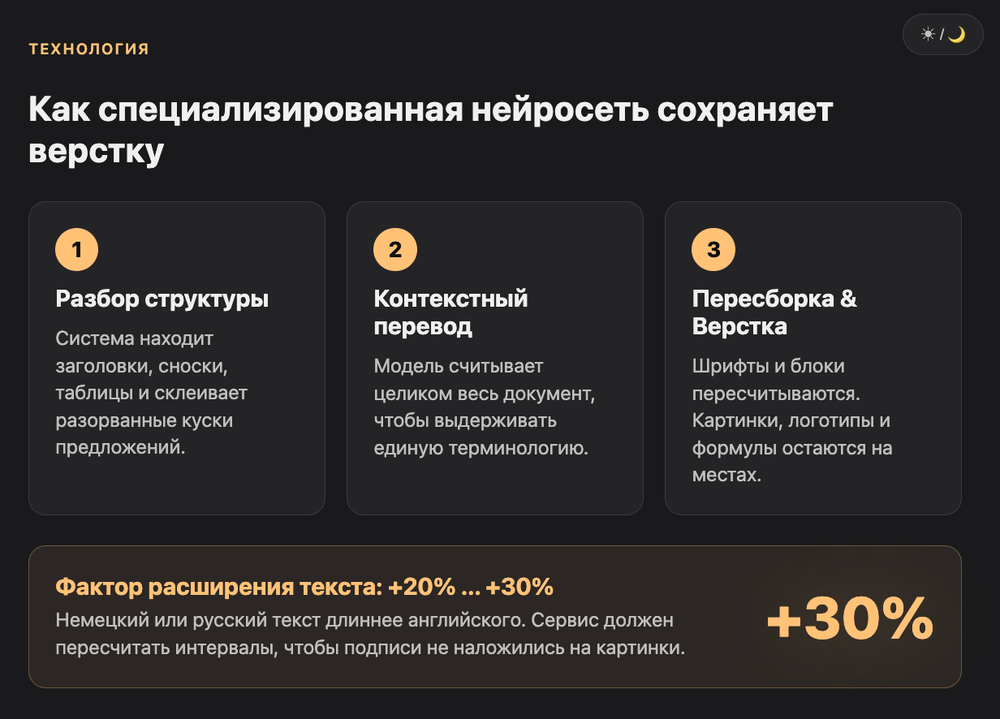
Как это устроено внутри:
Разбор -> система находит заголовки, сноски и подписи к таблицам, склеивает разорванные куски предложений.
Перевод -> модель читает весь документ, а не абзацы по одному, и термины держатся до последней страницы.
Пересборка -> страницы собираются заново, таблицы, логотипы и формулы остаются на местах.
Так работают и закрытые платформы, и открытые проекты. Идеального результата в один клик не дает никто. Даже автор разбора, у которого свой сервис, признает это прямо.
Какая нейросеть для перевода PDF подойдет под ваш файл?
Для простого PDF хватит Google, Яндекса или DeepL. Со сложной версткой пробуйте специализированные сервисы или открытый PDFMathTranslate. Главные отличия в лимитах и работе со сканами.
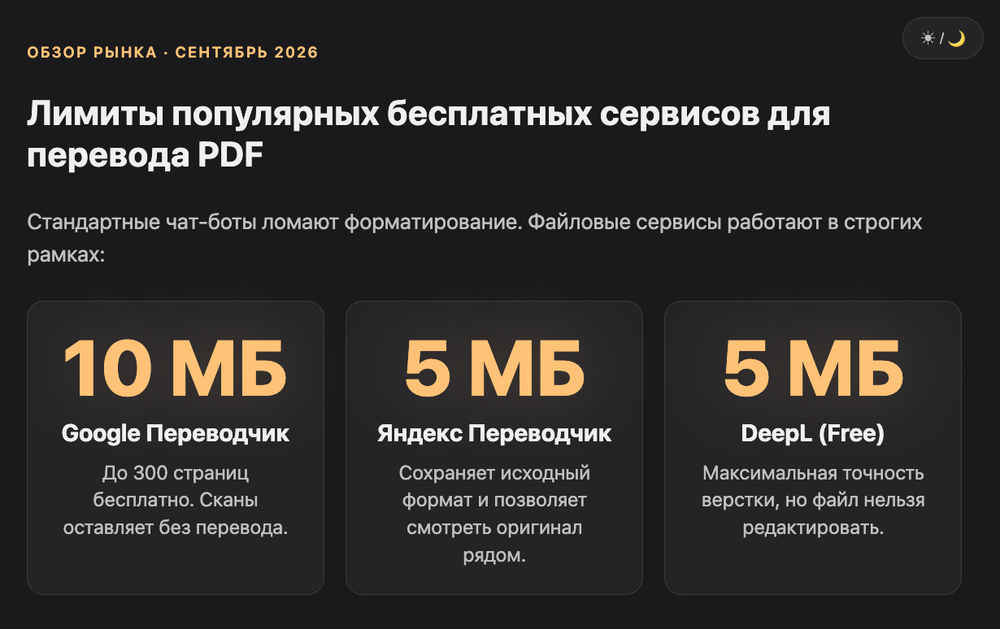
По справкам на сентябрь 2026 Google Переводчик принимает PDF до 10 МБ и 300 страниц, Яндекс Переводчик до 5 МБ, а DeepL от 5 МБ на бесплатном аккаунте до 100 МБ на старших тарифах. Лимит файла чаще ломает планы, чем качество перевода.
Что взять из привычных и бесплатных сервисов?
Начните с того, что уже под рукой. Google, Яндекс и DeepL принимают PDF прямо в браузере и возвращают файл. Разница в лимитах и в том, как они обращаются с оформлением.
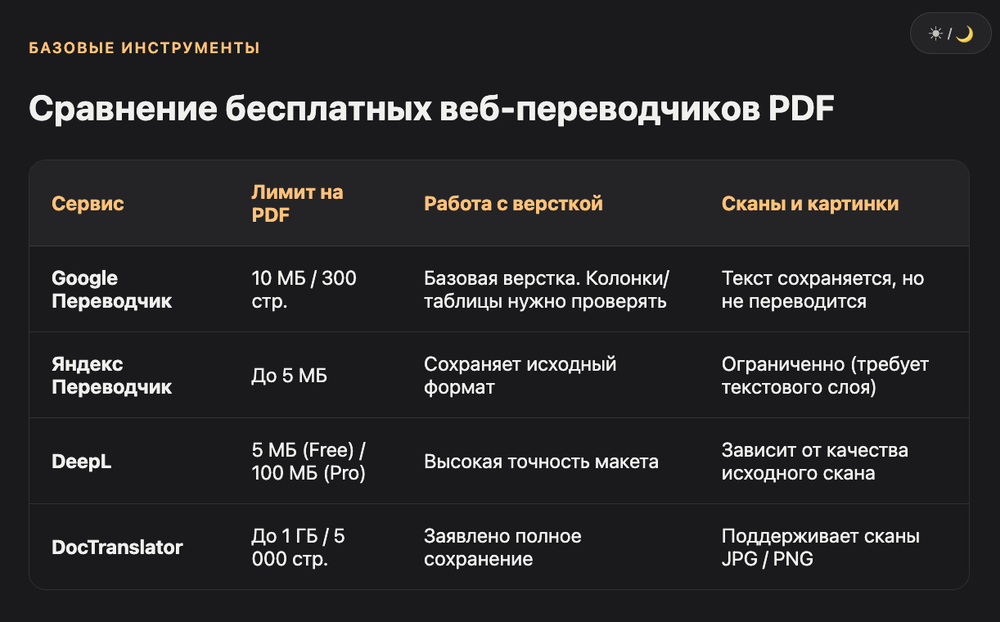
| Сервис | Лимит на PDF | Верстка | Сканы и картинки | Цена |
|---|---|---|---|---|
| Google Переводчик | 10 МБ, до 300 страниц | Простой текст норм, колонки и таблицы проверяйте глазами | Текст на сканах и в картинках попадает в файл, но не переводится | Бесплатно |
| Яндекс Переводчик | До 5 МБ | Файл сохраняется в исходном формате, оригинал можно смотреть рядом | В справке не указано | Бесплатно |
| DeepL | 5 МБ бесплатно, 10-30 МБ на Pro, до 100 МБ на старших тарифах | Заявлено сохранение форматирования, на качество влияют шрифты и крупные картинки | Качество скана влияет на результат | Бесплатный аккаунт и подписка Pro, на бесплатном результат нельзя редактировать |
| DocTranslator | По данным сервиса до 1 ГБ или 5 000 страниц | Заявлено сохранение макета | Заявлена работа со сканами JPG и PNG | Бесплатно для небольших документов, дальше платно |
Один нюанс для читателей из России. По данным Skillbox Media на март 2026, доступ к DeepL из РФ ограничен. Проверьте, открывается ли сервис, до того как строить на нем рабочий процесс.
Что делать со сложной версткой, каталогами и книгами?
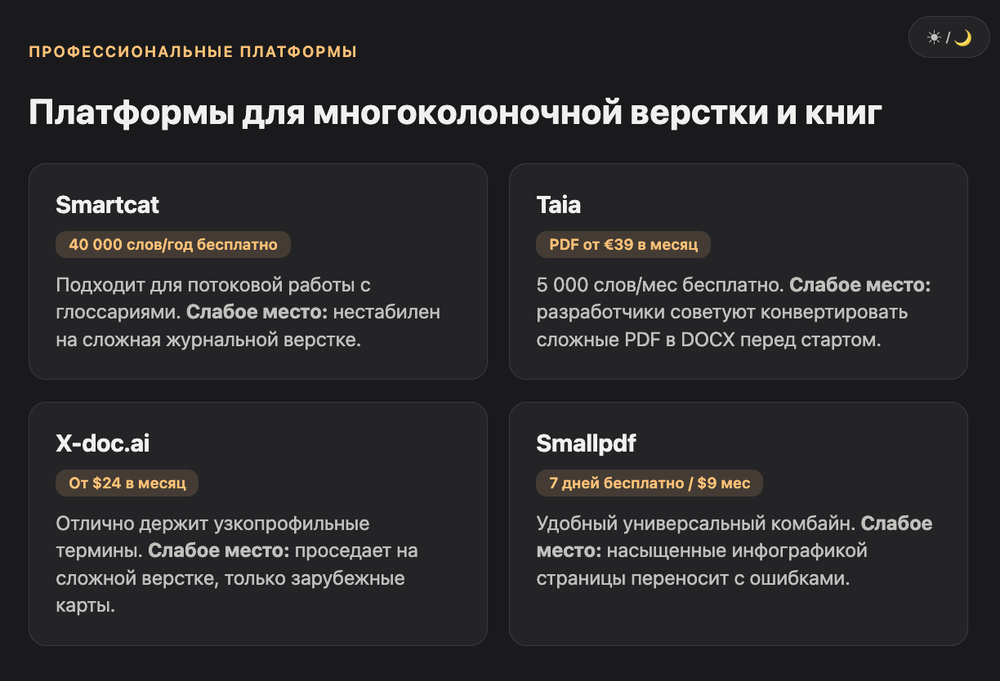
Каталоги, журналы и многоколоночные файлы ломаются у большинства сервисов. Тут выручают платформы под документы, но цены и условия у них разные. Данные в таблице взяты из видеоразбора и могут устареть, сверьте их на сайтах.
| Сервис | Условия по данным ролика | Слабое место |
|---|---|---|
| Smartcat | Бесплатно 40 000 слов в год, платно $249 и $549 в месяц, машинный перевод и OCR докупаются отдельно | Нестабилен на каталогах, журналах и многоколоночных файлах |
| Taia | Бесплатно 5 000 слов в месяц, платно от €9 до €39, PDF только с тарифа €39 | Сканы и сложная верстка переводятся ненадежно, разработчики советуют конвертировать в DOCX |
| X-doc.ai | $24 в месяц: 10 МБ на файл и 7 000 слов, $84: 30 МБ и 45 000 слов | Хорош на терминах, слабее на сложной верстке, оплата только зарубежной картой |
| Smallpdf | 7 дней полного доступа, потом Pro $9 в месяц или $48 в год | В ролике картинки и сложная верстка не переносились, на сайте заявлено обратное, проверяйте на своем файле |
Отдельно стоит российская «Симметрия». Автор ролика основал ее сам, поэтому воспринимайте его оценку как слова владельца. По описанию, файл разбирают на структуру, переводят моделями под тематику и собирают заново, а специалист подключается там, где автоматика не справляется. Цену на ваш файл сервис называет после загрузки. Мы его не тестировали.
Есть ли открытый вариант, который можно поставить самому?
Есть. PDFMathTranslate и его основа BabelDOC делают то же, что платные платформы: разбирают страницу, переводят и собирают заново. По описанию проекта на GitHub они сохраняют формулы, оглавление и аннотации и работают через Google, DeepL, Ollama и OpenAI.
Проект сделан для научных статей и распространяется под лицензией AGPL v3. Авторы прямо пишут, что качество не гарантируют и помощь с настройкой не оказывают. Новичку установку можно поручить ассистенту: Claude Code или Codex поставят и запустят программу по вашему описанию. По README проекта, у онлайн-версии BabelDOC есть бесплатная квота в 1000 страниц в месяц, условия уточняйте.
Что делать со сканами и картинками с текстом?
Скан хранит страницу как картинку без текстового слоя, поэтому сначала нужно распознавание текста, OCR. Обычный переводчик такие страницы пропускает или возвращает без перевода.
В справке Google указано, что текст в изображениях и на отсканированных страницах попадает в итоговый файл, но не переводится. DeepL предупреждает, что качество скана и крупные картинки влияют на результат. Поэтому для сканов берут сервис со встроенным OCR или прогоняют файл через распознавание заранее.
Проверить тип файла можно за пять секунд. Выделите мышкой одну строку или найдите слово через Ctrl+F. Если текст не выделяется и не ищется, перед вами скан.
Встроенный OCR заявляют DocTranslator, Smallpdf и Blue Translate, а часть платформ дают выбор: переводить надписи на картинках или оставить как есть. У Taia логика обратная, разработчики советуют превратить PDF в DOCX. По словам автора ролика, качественно сделать это со сложным файлом пока нельзя. Плохой скан переведется плохо в любом сервисе, потому что распознавание спотыкается на мелком шрифте и серых фонах.
Как перевести PDF нейросетью за четыре шага?
Определите тип файла, выберите сервис по лимитам, переведите две тестовые страницы и только потом весь документ. Пробный прогон стоит пары страниц, а показывает судьбу всей верстки.
Рабочий порядок такой: проверить тип и размер PDF, выбрать сервис, перевести две страницы с таблицей и картинкой, сверить результат с оригиналом. Тестовый прогон съедает малую часть лимита, зато заранее показывает, выживет ли верстка целого документа, и избавляет от платы за перевод, который придется переделывать.
Шаг 1. Как понять, какой у вас PDF?
Посмотрите на вес и число страниц. Проверьте, выделяется ли текст и есть ли в файле таблицы, колонки и картинки с надписями. Простой текст на 20 страниц и журнал с инфографикой требуют разных сервисов. Запишите три факта: размер в мегабайтах, число страниц и скан это или нет. С ними выбор из таблиц выше занимает минуту.
Шаг 2. Как выбрать сервис под файл?
Сверьте размер с лимитом: 5 МБ у Яндекса, 10 МБ у Google, 5 МБ на бесплатном DeepL. Файл тяжелее придется сжать, разрезать или отдать сервису с большим потолком. Для сложной верстки берите специализированный сервис, для простого текста хватит бесплатного. Если документ юридический или медицинский, сразу закладывайте вычитку человеком.
Шаг 3. Как проверить перевод на двух страницах?
Вырежьте из PDF две страницы: одну с таблицей, вторую с картинкой и подписью. Переведите только их и положите рядом с оригиналом. Смотрите на четыре вещи: не съехали ли колонки, влез ли текст в ячейки, остались ли картинки, читаются ли шрифты. Так лимитом вы заплатите за две страницы, а не за сотню.
Шаг 4. Как вычитать результат и не потерять термины?
Сверьте ключевые термины, цифры и имена с оригиналом. Задайте глоссарий, если сервис его поддерживает: у DeepL для этого есть отдельные настройки. Потом можно отдать чат-боту пары абзацев на проверку. Например, так:
Вот абзац на английском и его перевод на русский. Найди места, где термины или числа переведены неточно, и покажи список расхождений без переписывания текста.
Чат хорошо сверяет короткие фрагменты, поэтому для вычитки он подходит. Для сборки файла нет.
Что нейросети делают хорошо, а где пока ошибаются при переводе PDF?
Сервисы быстро переводят большие файлы и держат термины, но теряются на каталогах, сканах и юридически значимых бумагах. Вычитка человеком остается обязательной.
В демо на YouTube сервис Blue Translate перевел учебник на 1 320 страниц на хинди примерно за две минуты, а Google Переводчик обрабатывает PDF до 300 страниц бесплатно. Скорость перестала быть проблемой. Слабые места остались в верстке каталогов, качестве сканов и цене ошибки в важных документах.
Сильные стороны
Скорость и цена. Файл, над которым переводчик сидел бы неделю, сервис отдает за минуты, а на простых PDF Google и Яндекс не берут денег. Термины тоже под контролем: платформы с памятью переводов и глоссариями держат один вариант слова на весь документ, чего чат-бот на длинном файле не гарантирует.
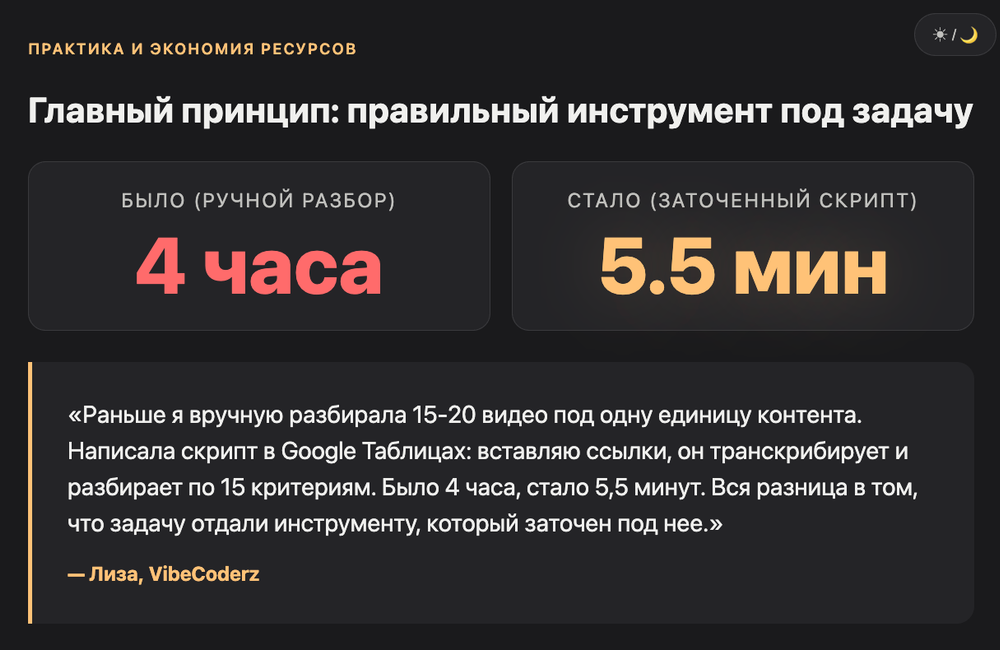
Узкий инструмент обгоняет универсальный чат, и это видно на любой рутинной задаче.
Лиза: «Раньше я вручную разбирала 15-20 видео под одну единицу контента. Написала скрипт в Google Таблицах: вставляю ссылки, он транскрибирует и разбирает по 15 критериям. Было 4 часа, стало 5,5 минут. Прикинь, вся разница в том, что задачу отдали инструменту, который заточен под нее.»
Слабые стороны
Сложная верстка: каталоги, журналы и комиксы разваливаются у многих сервисов. Платформы этого не скрывают, у Smartcat в справке есть раздел про ручную проверку верстки перед переводом. Со сканами потолок задает качество распознавания.
Юридическая сила у нейросети нулевая. Паспорт или договор для нотариуса и суда нужен в заверенном переводе. Еще файл уходит на чужой сервер: у DeepL, например, файлы подписчиков Pro удаляются сразу после перевода, а у остальных условия придется читать самому. И качество зависит от языковой пары, так что на редких языках проверяйте вдвойне.
Кому какой сервис выбрать для перевода PDF?
Для быстрого чтения хватит Google Переводчика, для делового документа подойдет DeepL, а для каталога, книги или скана нужен сервис с OCR. Официальные бумаги переводят люди.
Универсального сервиса для перевода PDF нет: автор одного из разборов сам признает, что ни один инструмент не возвращает идеальный сложный файл в один клик. Выбор определяют три параметра: размер, тип файла и цена ошибки. Чем выше цена ошибки, тем больше нужна человеческая вычитка.
| Ситуация | Что взять | Почему |
|---|---|---|
| Понять смысл простого PDF до 10 МБ | Google Переводчик | Бесплатно, без тарифов, до 300 страниц |
| Деловой документ на европейском языке | DeepL, если открывается | Глоссарии и правила стиля, файл в исходном оформлении |
| Оплата без зарубежных карт, файл до 5 МБ | Яндекс Переводчик | Работает в РФ, формат файла сохраняется |
| Книга или каталог со сложной версткой | DocTranslator или сервис с ручным контролем вроде «Симметрии» | Заявлены большие файлы и сохранение макета, проверьте на двух страницах |
| Научная статья с формулами | PDFMathTranslate или BabelDOC | Сохраняют формулы, оглавление и аннотации |
| Скан или фото страницы | Сервис со встроенным OCR | Сначала распознавание, потом перевод |
| Паспорт, диплом, договор для суда | Заверенный перевод человеком | У машинного перевода нет юридической силы |
| Поток однотипных договоров | Smartcat или Taia | Память переводов и глоссарии, но верстку проверяйте |
Если коротко, начните с бесплатного пробника на двух страницах. Верстка выжила, платить не за что. Развалилась, переходите к сервису дороже или к варианту с ручным контролем.
Что еще спрашивают про перевод PDF нейросетью?
Короткие ответы на вопросы, которые чаще всего задают, когда PDF нужно перевести без потери верстки: про сканы, приватность, бесплатные лимиты и вычитку.
Какая нейросеть лучше всего переводит PDF с сохранением форматирования?
Универсального лидера нет. На простых текстовых файлах справляются DeepL, Google и Яндекс, а на каталогах и книгах выигрывают специализированные сервисы вроде DocTranslator или «Симметрии». Проверьте выбранный вариант на двух страницах, прежде чем отдавать ему весь файл.
Почему ChatGPT при переводе PDF портит оформление?
Он работает с голым текстом и не видит структуру файла: где таблица, где колонка, где подпись. На выходе получается текст без картинок и отступов. Если вставить в чат сам текст, перевод выйдет хорошим, поэтому чат годится для вычитки, а не для сборки файла.
Можно ли перевести PDF нейросетью бесплатно?
Да, в пределах лимитов. Google Переводчик берет PDF до 10 МБ и 300 страниц, Яндекс Переводчик до 5 МБ, бесплатный аккаунт DeepL до 5 МБ, но без редактирования результата. У Taia бесплатно 5 000 слов в месяц, у Smartcat 40 000 слов в год.
Как перевести отсканированный PDF?
Нужен сервис с OCR: он сначала распознает текст на картинке, потом переводит. Google Переводчик на сканах текст не переводит. Сначала убедитесь, что страница действительно скан: текст не выделяется и не ищется. Чем чище скан, тем точнее итог.
Переведется ли текст внутри картинок и схем?
Не везде. Google оставляет надписи в изображениях без перевода. Часть специализированных сервисов распознает их и дает выбор: перевести надписи или не трогать. Если в файле много инфографики, проверьте эту опцию на пробной странице до оплаты.
Безопасно ли загружать договоры в онлайн-переводчик?
Зависит от сервиса. DeepL пишет, что файлы подписчиков Pro удаляются сразу после перевода. У X-doc.ai, по словам автора ролика, нулевое хранение данных, а Taia не использует данные клиентов для обучения ИИ. Для конфиденциальных бумаг читайте политику сервиса и не загружайте лишнего.
Нужна ли вычитка после перевода нейросетью?
Для важных документов да. Даже сервисы с заявленной точностью до 99% теряют мелочи вроде иконок и точного размера шрифта. Юридические, медицинские и официальные бумаги стоит отдать человеку, а нотариальный перевод нейросеть не заменит.
Глоссарий
Восемь терминов, которые встречаются при выборе сервиса для перевода: от OCR и текстового слоя до памяти переводов и постредактирования.
PDF это формат документа, где страница хранится как набор независимых объектов: фрагментов текста, картинок и линий.
Верстка это расположение текста, таблиц и картинок на странице.
Текстовый слой это невидимая часть PDF с настоящим текстом, у сканов его нет.
OCR это распознавание текста на изображении, после которого скан можно переводить.
Память переводов это база уже переведенных фраз, которую сервис подставляет в новые документы.
Глоссарий это список терминов с закрепленным переводом.
Постредактирование это правка машинного перевода человеком.
Скан это фотография или изображение страницы без текстового слоя.
Больше инструментов и обзоров собрано в каталоге AI-инструментов. Если хотите выстроить свой процесс перевода документов или собрать сервис под задачу, запишитесь на консультацию к Максиму.
Обновлено: сентябрь 2026.